¿Son mejores los asistentes de investigación con AI que la búsqueda por palabras clave para encontrar artículos relacionados?
2026-08-22
¿Cuándo supera la correspondencia semántica a la clasificación por palabras clave para artículos relacionados conceptualmente?
Los asistentes de investigación semántica con AI superan a la búsqueda tradicional por palabras clave cuando los artículos que necesita describen la misma idea con terminología diferente, mientras que los motores de palabras clave siguen siendo más sólidos cuando ya conoce las frases exactas, los autores o el grupo de citas al que desea dirigirse. En 2026, la respuesta práctica no es abandonar Google Scholar, sino combinar la clasificación léxica con la recuperación basada en significado, mediante herramientas como Elicit, SciSpace, Undermind y Jenova's Academic Research Assistant.
Factores clave que separan el descubrimiento conceptual eficaz de la coincidencia por palabras clave:
✅ Flexibilidad de vocabulario — si el sistema puede mostrar un artículo sobre «infarto de miocardio» cuando la consulta decía «ataque cardíaco» ✅ Señales de clasificación — puntuaciones léxicas ponderadas por citas frente a similitud de embeddings frente a un LLM que evalúa la relevancia ✅ Profundidad del índice — metadatos de título y resumen frente a coincidencias de texto completo en cientos de millones de trabajos ✅ Controles de precisión — Booleanos anidados, límites por campo, filtros de calidad de revistas y límites de exportación ✅ Tiempo hasta un conjunto útil — listas exploratorias instantáneas frente a búsquedas iterativas de varios minutos
Para comparar estos métodos de forma honesta, conviene tratar el desajuste de vocabulario, el sesgo de clasificación y el control de búsqueda como dimensiones independientes, en lugar de preguntar qué herramienta es universalmente mejor.
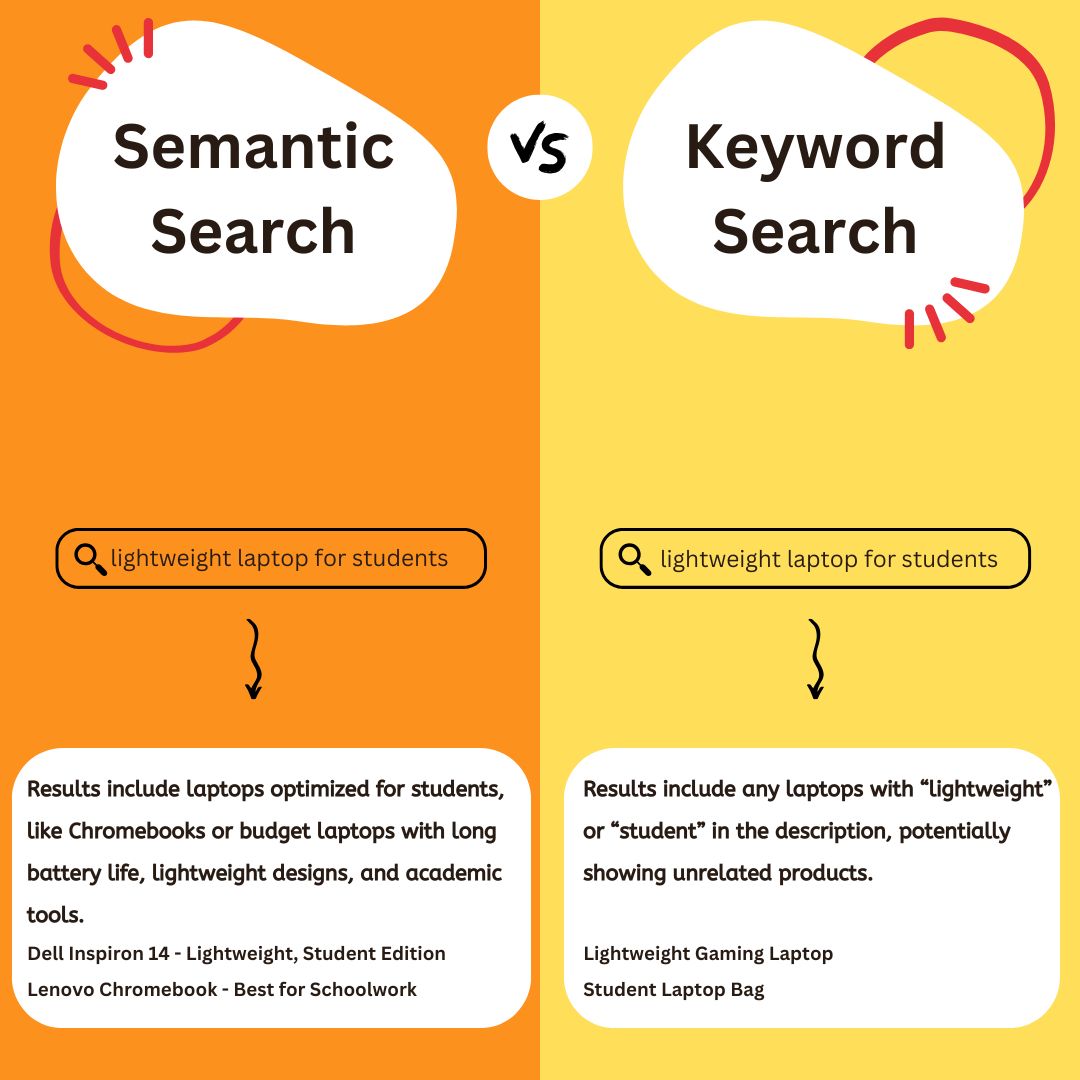
¿Por qué el desajuste de vocabulario sigue afectando a la búsqueda académica tradicional en 2026?
El desajuste de vocabulario sigue afectando a la búsqueda académica tradicional porque los autores, las disciplinas y los periodos históricos denominan de forma distinta el mismo fenómeno, y los motores léxicos solo recuperan documentos que comparten suficientes términos superficiales con la consulta. Un artículo de salud pública puede decir «actividad física», uno de cardiología «capacidad de ejercicio» y uno de sociología «movimiento durante el tiempo libre». Si busca solo una frase, los otros dos grupos pueden desaparecer de las primeras páginas de resultados.
Google Scholar sigue siendo el punto de partida predeterminado para la mayoría de los investigadores y continúa siendo la superficie única de búsqueda académica más amplia disponible, incluido el texto completo de editoriales y repositorios. Aaron Tay, bibliotecario académico de Singapore Management University, lo ha descrito como la navaja suiza de la búsqueda académica: la herramienta que conservaría si solo pudiera quedarse con una. Sin embargo, su clasificación sigue siendo léxica. Tras las coincidencias en el título, otorga mucho peso a los artículos muy citados, lo cual es excelente para encontrar trabajos seminales y débil para hallar artículos relacionados conceptualmente que emplean una redacción diferente o que aún no han acumulado citas.
El problema empeora cuando un término de consulta es común. Dado que Google Scholar busca en el texto completo, una búsqueda de una herramienta o un concepto con un nombre cotidiano puede generar miles de resultados incidentales. Tay señala que buscar «Elicit» resulta casi inútil en Google Scholar a menos que añada una solución alternativa de dominio, porque la palabra aparece constantemente en las secciones de métodos. Los sistemas semánticos reducen este modo de fallo al puntuar el significado en lugar de la coincidencia de cadenas, por lo que se han convertido en una capa complementaria y no en una novedad.
¿Qué debe evaluar al comparar la búsqueda por palabras clave y los asistentes semánticos con AI?
Debe evaluar la búsqueda por palabras clave y los asistentes semánticos con AI en seis dimensiones que este artículo denomina el Marco de recuperación ante desajustes: flexibilidad de vocabulario, transparencia de clasificación, cobertura del índice, control de precisión, señales de autoridad y tiempo hasta un conjunto útil. Una herramienta que gana en una dimensión suele perder en otra, por lo que una clasificación con un único «ganador» engaña más de lo que ayuda.
La flexibilidad de vocabulario pregunta si el motor puede recuperar un artículo cuyo resumen nunca repite sus términos de consulta. Los embeddings densos y los métodos híbridos como SPLADE, que Elicit utiliza como enfoque de embeddings dispersos aprendidos, están diseñados para esto. La transparencia de clasificación pregunta si puede explicar por qué apareció un artículo. Los sistemas Booleanos más BM25 son más fáciles de auditar; la búsqueda de vecinos más cercanos mediante embeddings y los reclasificadores LLM son más difíciles de reproducir.
La cobertura del índice no es lo mismo que el «número de artículos anunciado». OpenAlex informa de 517 millones de registros de trabajos y 66 millones de PDF de texto completo, mientras que Elicit afirma que busca, resume y extrae datos de más de 125 millones de artículos. Google Scholar no publica un recuento oficial comparable, pero se le considera ampliamente el mayor índice académico de búsqueda en texto completo. El control de precisión incluye Booleanos anidados, límites por campo, operadores de proximidad y vocabulario controlado, funciones en las que The Lens y OpenAlex superan a Google Scholar.
Las señales de autoridad incluyen los recuentos de citas, el nivel de la revista y las alertas de retractación. Google Scholar y, en menor medida, Undermind se inclinan hacia trabajos muy citados. Elicit y SciSpace generalmente clasifican por similitud semántica y no ponderan las citas, por lo que los artículos más nuevos o menos citados ascienden. El tiempo hasta un conjunto útil separa la búsqueda instantánea por palabras clave de las ejecuciones iterativas al estilo Undermind, que tardan al menos tres minutos. Puntúe cada dimensión frente a su tarea real —descubrimiento con muchos sinónimos, recuperación sistemática o una orientación de cinco minutos— antes de elegir un motor principal.
¿Cómo se comparan Google Scholar, Elicit, SciSpace, Undermind y Jenova en el descubrimiento conceptual?
Google Scholar es más sólido para la exploración amplia y ponderada por citas; Elicit y SciSpace destacan cuando las palabras clave no están claras; Undermind es más fuerte para búsquedas acotadas y de alta precisión; y Jenova's Academic Research Assistant sobresale cuando el descubrimiento, la síntesis y el trabajo con citas deben mantenerse en una conversación persistente. Ninguna de estas herramientas domina todas las celdas del Marco de recuperación ante desajustes.
| Función / dimensión | Google Scholar | Elicit / SciSpace | Undermind | Jenova's Academic Research Assistant | Lens.org / OpenAlex |
|---|---|---|---|---|---|
| Método de coincidencia | Léxico / por palabras clave, ponderado por citas | Semántico o híbrido (Elicit usa SPLADE) | Recuperación híbrida más evaluación de relevancia por LLM y búsqueda iterativa | Agente de investigación en lenguaje natural sobre fuentes académicas en vivo, incluido Google Scholar | Búsqueda estructurada de metadatos académicos con operadores avanzados |
| Recuperación con redacción diferente | Débil, salvo que añada sinónimos o use Artículos relacionados | Sólida para consultas basadas en significado | Sólida para encargos específicos en lenguaje natural | Sólida en la reformulación conversacional entre sesiones | Débil a moderada; depende de la construcción de la consulta |
| Sesgo de autoridad | Favorece los artículos muy citados tras las coincidencias de título | Escasa ponderación por citas; los artículos nuevos ascienden | Cierto sesgo hacia trabajos seminales mediante búsqueda de citas | Sigue las fuentes conectadas y el briefing que proporcione | Guiado por metadatos; diseñado más para análisis que para clasificación semántica |
| Funciones de precisión | Sin Booleanos anidados, límite de 256 caracteres y búsqueda por campo limitada | Filtros posteriores de calidad de revistas (p. ej., niveles Scimago en SciSpace) | Especificidad en lenguaje natural en lugar de Booleanos | Delimitación conversacional; no es un motor de sintaxis Boolean | Booleanos anidados, proximidad, búsqueda por campo y vocabulario controlado |
| Tiempo típico de consulta | Instantáneo | Lo bastante rápido para explorar | Al menos ~3 minutos por búsqueda | Interactivo; los turnos de seguimiento son inmediatos | Instantáneo o limitado por el ritmo de la API |
| Precios (a fecha de 2026) | Gratis | Elicit Pro, aproximadamente $49/mes; niveles de pago de SciSpace desde $12 hasta $160/mes | Nivel exploratorio gratuito; planes académicos de pago | Nivel gratuito con uso limitado; Plus desde $20/mes | Búsqueda web gratuita; la API de OpenAlex tiene un nivel gratuito |
| Mejor para | Artículos seminales, encadenamiento por citas y localización de texto completo | Palabras clave poco claras y consultas en forma de pregunta | Encontrar una clase específica de estudio con alta recuperación | Trabajo bibliográfico integral con memoria y apoyo para manuscritos | Búsquedas sistemáticas, reproducibles y de alto control |
Google Scholar
Google Scholar sigue siendo el generalista. Las páginas oficiales de ayuda confirman que los resultados normalmente se ordenan por relevancia, no por fecha, y que los investigadores pueden pasar por Artículos relacionados y Citado por una vez que tienen un artículo semilla. Estas dos funciones son lo más cercano que la búsqueda por palabras clave llega al descubrimiento conceptual, pero requieren una buena semilla. Sus debilidades están bien documentadas: no admite Booleanos anidados, búsqueda por campo solo en el resumen, tiene un límite de consulta de 256 caracteres, un techo de 1.000 resultados y no permite exportación masiva. Esta combinación explica por qué los bibliotecarios lo excluyen habitualmente como base de datos principal para revisiones sistemáticas.
Elicit y SciSpace
Elicit se presenta como AI para buscar, resumir, extraer y conversar con más de 125 millones de artículos, con más de 2 millones de usuarios de investigación. Tanto Elicit como SciSpace aceptan preguntas en lenguaje natural y clasifican por similitud semántica, por lo que recuperan artículos cuya redacción diverge de la consulta. La contrapartida es un sesgo de clasificación en la dirección opuesta a Google Scholar: pueden promover artículos semánticamente cercanos, pero de baja calidad o poco citados. SciSpace es por lo general más rápido y más adecuado para obtener información rápida que para una síntesis iterativa profunda. Los resultados también pueden no ser deterministas, por lo que la misma consulta quizá no devuelva dos veces el mismo conjunto.
Undermind
Undermind es el especialista. Combina la recuperación por palabras clave y la semántica, luego utiliza un modelo de frontera para evaluar si el título, el resumen y los metadatos disponibles responden realmente al encargo, e itera mediante búsqueda de citas. En una prueba frente al conjunto incluido de una revisión sistemática, recuperó 8 de 11 artículos de referencia entre los 10 primeros resultados (recall@10 del 72,7 %) y 9 de 11 antes de la posición 50 (recall@50 del 81,8 %). Esa calidad requiere tiempo y funciona mal con temas vagos. Además, ve principalmente el título y el resumen, junto con parte del texto completo de acceso abierto, por lo que pueden omitirse afirmaciones enterradas únicamente en métodos o resultados.
Jenova's Academic Research Assistant
Jenova's Academic Research Assistant es un socio de investigación consciente de la disciplina, no un índice independiente de artículos. Realiza descubrimiento bibliográfico en vivo en fuentes académicas y luego acompaña el proyecto mediante la síntesis, la preparación de manuscritos y la gestión de citas. La memoria persistente permite recordar que su término de trabajo es «fatiga cognitiva», mientras que la literatura también utiliza «agotamiento del ego» y «necesidad de recuperación», y mantener esos grupos de sinónimos vinculados al mismo proyecto entre sesiones.
La limitación honesta es arquitectónica. No incorpora un índice semántico propietario de 125 millones de artículos con tablas de extracción integradas en el sentido de Elicit, ni es un buscador iterativo de varios minutos al estilo Undermind con un punto de referencia publicado de recall@10. Su fortaleza es la orquestación: briefing en lenguaje natural, consulta académica en vivo, preguntas de seguimiento y apoyo a la redacción en un único hilo. Los investigadores que necesiten una traza de auditoría Boolean reproducible deben seguir ejecutando The Lens u OpenAlex en paralelo.
¿Cómo recupera la búsqueda semántica artículos que emplean una redacción diferente para la misma idea?
La búsqueda semántica recupera artículos redactados de forma diferente al representar la consulta y la colección de documentos en un espacio compartido de significado, y después recuperar los vecinos más cercanos en vez de exigir tokens coincidentes. Si la consulta es «¿cómo recuperan la atención las enfermeras de turno nocturno tras turnos consecutivos?», un motor léxico busca esas palabras. Un motor semántico puede recuperar estudios titulados en torno a la «alteración circadiana», el «sueño de recuperación» o la «fatiga ocupacional», incluso cuando «enfermeras» o «atención» no aparecen nunca en el título.
Semantic Scholar, el motor bibliográfico del Allen Institute for AI, fue una demostración pública temprana de esta idea: clasificar artículos científicos por el significado comprendido, en lugar de por la coincidencia de cadenas. Elicit y SciSpace aplican un principio similar a escala de aplicación web. Tay describe una prueba especialmente clara: pegue un párrafo periodístico que describa los hallazgos de un estudio, y un motor semántico puede mostrar el artículo de revista subyacente porque el embedding de la prosa periodística se sitúa cerca del embedding del artículo. La búsqueda por palabras clave casi nunca sobrevive a esa paráfrasis.
Existe un segundo mecanismo, más discreto: la expansión de consultas dentro del asistente. Un Agente conversacional puede generar conjuntos de sinónimos, conceptos relacionados al estilo MeSH, antónimos y variantes disciplinarias, y buscar explícitamente esas variantes. Eso no es búsqueda vectorial pura. Es comprensión semántica utilizada para construir una red léxica mejor. En la práctica, los flujos de trabajo de mayor recuperación hacen ambas cosas: usan embeddings para recuperar redacción desconocida y luego verifican con frases exactas, nombres de autores y enlaces de citas para que el conjunto siga siendo auditable.
Probarlo con un encargo real suele revelar rápidamente la diferencia. Pida a un motor de palabras clave «detección docente» y obtendrá sobre todo artículos que emplean ese término exacto de investigación educativa. Pida a un asistente semántico «cómo detectan e interpretan los docentes el pensamiento inesperado de los estudiantes en el momento», y también encontrará trabajos archivados bajo «visión profesional», «evaluación formativa» o «toma de decisiones en el momento». El segundo conjunto es el que el desajuste de vocabulario habría ocultado.
¿Cuándo debería seguir usando la búsqueda por palabras clave en lugar de un asistente semántico con AI?
Debería seguir usando la búsqueda por palabras clave cuando necesite recuperar un ítem conocido, encadenar citas a partir de un artículo semilla, buscar frases en texto completo o aplicar una estrategia Boolean reproducible para una revisión sistemática. La clasificación semántica es el instrumento equivocado cuando la tarea es «encontrar este título», «encontrar todo lo que cita este ensayo» o «documentar una cadena de búsqueda que un revisor pueda ejecutar de nuevo».
Google Scholar es el primer paso correcto para tres tareas cotidianas. Primero, la localización de ítems conocidos: escriba el título entre comillas, como recomiendan la ayuda de Google y la mayoría de las guías de bibliotecas. Segundo, la cartografía de autoridad: abra un artículo fundamental y recorra Citado por para ver qué hizo el campo después, o Artículos relacionados para expandirse desde una semilla. Tercero, la búsqueda de frases en texto completo: si el concepto es el nombre distintivo de un método, un conjunto de datos o una escala, la búsqueda léxica en texto completo detectará menciones que los índices semánticos de título y resumen no encuentran.
Para búsquedas sistemáticas o muy precisas, omita tanto Google Scholar como la mayoría de las aplicaciones semánticas como sistema de registro. The Lens y OpenAlex admiten Booleanos anidados, operadores de proximidad, búsqueda por campo y vocabulario controlado. OpenAlex es un catálogo abierto con 517 millones de trabajos, 5.800 millones de relaciones en grafo y un conjunto de datos de dominio público (CC0). Un informe bibliotecario de 2026 situó su cobertura en torno a 474 millones de publicaciones, con énfasis en el acceso abierto y la transparencia. Google Scholar no puede igualar esa auditabilidad: limita la visualización a 1.000 resultados y no ofrece acceso masivo.
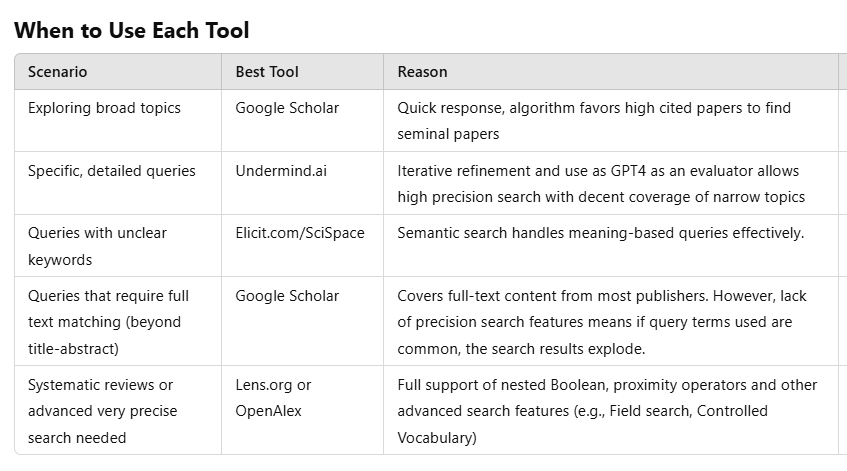
Utilice la tabla anterior como regla de enrutamiento, no como una prueba de lealtad. La orientación amplia y la localización de artículos seminales siguen correspondiendo a Google Scholar. La redacción poco clara va a Elicit o SciSpace. Una pregunta de existencia muy específica —«¿hay RCTs que utilicen un LLM como herramienta de cribado de títulos y resúmenes e informen precisión y recall?»— es un encargo para Undermind. Las búsquedas reproducibles y con muchos operadores pertenecen a The Lens u OpenAlex.
¿Cómo realizar una búsqueda bibliográfica que combine ambos enfoques?
Realice una búsqueda combinada empezando con un briefing conceptual, recuperando semánticamente candidatos con diversidad de sinónimos y, después, consolidando el conjunto con operadores léxicos, encadenamiento de citas y una base de datos de alto control. La secuencia importa. Si comienza en Google Scholar con una frase, hereda los puntos ciegos de esa frase. Si nunca abandona una lista clasificada semánticamente, hereda los problemas de calidad y reproducibilidad de esa lista.
Una secuencia práctica tiene este aspecto:
- Redacte la necesidad de información como la escucharía un colega, incluidas las poblaciones, los resultados y la redacción que ya sabe que es inestable.
- Ejecute ese briefing en un asistente semántico para recopilar artículos candidatos y el vocabulario que realmente utilizan.
- Construya una tabla de sinónimos a partir de esos títulos y resúmenes.
- Repita los términos ampliados en Google Scholar con comillas,
author:, límites de fecha y Citado por / Artículos relacionados. - Para todo lo que deba ser exhaustivo o auditable, reconstruya la estrategia en The Lens u OpenAlex con Booleanos anidados y límites por campo.
- Mantenga un registro continuo de inclusión para que las repeticiones semánticas no deterministas no cambien silenciosamente la base de evidencia.
En Jenova's Academic Research Assistant, el primer turno puede ser el briefing conceptual en lugar de una cadena de palabras clave:
«Necesito artículos empíricos sobre cómo los trabajadores remotos del conocimiento se recuperan de la fatiga cognitiva. Incluye estudios que puedan usar burnout, agotamiento del ego, necesidad de recuperación, rumiación fuera del horario laboral o desconexión psicológica en lugar de la palabra fatiga. Da preferencia a revistas de psicología ocupacional e HCI a partir de 2018 e indica el sinónimo que utiliza realmente cada artículo.»
Un seguimiento convierte después la tabla de sinónimos del asistente en una estrategia léxica que puede pegar en Google Scholar o The Lens:
«Convierte los grupos de sinónimos en tres consultas de Google Scholar y una cadena Boolean anidada adecuada para OpenAlex o The Lens. Separa las consultas restringidas al título de las consultas de texto completo.»
En Elicit o SciSpace, formule la pregunta en lenguaje natural en lugar de usar palabras clave: Tay señala que las consultas en lenguaje natural tienden a funcionar peor en Google Scholar y mejor en estas herramientas semánticas. En Undermind, añada restricciones hasta que el briefing solo pueda corresponder a un diseño de estudio específico. Una vez que exista el conjunto de candidatos, el Agente Deep Research de Jenova es el mejor instrumento para leer entre fuentes y producir una síntesis con citas, mientras que Jenova's Academic Research Assistant sigue siendo el mejor instrumento para mantenerse dentro del flujo de trabajo académico de descubrimiento, citas y apoyo al manuscrito.
Una advertencia se aplica a cada paso asistido por AI. Considere las listas clasificadas y los resúmenes generados como ayudas para la recuperación, no como un cribado terminado. Los diez primeros resultados semánticos omiten artículos. Las evaluaciones de relevancia de los LLM coinciden a menudo con las humanas, pero no siempre. Las afirmaciones del texto completo siguen requiriendo el PDF.
¿Qué dicen los bibliotecarios de investigación y los evaluadores de herramientas sobre el descubrimiento semántico con AI?
Los bibliotecarios de investigación y los evaluadores independientes suelen tratar los asistentes semánticos con AI como complementos de Google Scholar, no como sustitutos, y juzgan las herramientas por la calidad de búsqueda para un caso de uso declarado, no por categorías de marketing. La comparación publicada más útil en este ámbito procede de revisiones basadas en la práctica, no de puntos de referencia de proveedores.
«Si no supiera de antemano cuál sería mi caso de uso y solo pudiera elegir una herramienta de búsqueda académica, sería obvio elegir Google Scholar. Eso no es un argumento contra la búsqueda con AI. Es un argumento contra pretender que una sola función de clasificación es suficiente. Scholar sigue siendo el generalista. Las nuevas herramientas se ganan su lugar cuando la consulta es semánticamente incómoda o extremadamente específica.»
«El fallo que veo con más frecuencia es un desajuste entre el tipo de consulta y el motor. La gente escribe un tema amplio en un Agente iterativo y espera minutos para recibir un conjunto más limitado de lo necesario. O introduce un párrafo en lenguaje natural en un motor léxico y concluye que la literatura no existe. El desajuste de vocabulario suele ser un error de flujo de trabajo antes que una laguna de base de datos.»
«La clasificación semántica también cambia lo que significa “relevante”. Si no pondera las citas, verá antes artículos más nuevos y a veces más débiles. Si pondera las citas, seguirá redescubriendo el mismo canon. Los investigadores que quieren trabajos relacionados conceptualmente con una redacción diferente necesitan el primer comportamiento. Los investigadores que quieren los artículos que todos los demás esperarán que citen necesitan el segundo. Un proceso competente emplea ambos y deja por escrito el motivo.»
— Equipo de Producto de Jenova, sistemas de descubrimiento bibliográfico, 8 años diseñando flujos de trabajo de investigación académica
Este enfoque coincide con el registro público. Las guías universitarias ahora recopilan herramientas de búsqueda con AI utilizadas en revisiones de literatura, y las reseñas de productos distinguen la pasada iterativa más lenta de Undermind del análisis semántico más rápido de SciSpace. El consenso experto es metodológico, no tribal: elija el modelo de recuperación que corresponda al desajuste que intenta resolver.
¿Qué herramienta encaja en las revisiones sistemáticas frente a la cartografía exploratoria de la literatura?
Las revisiones sistemáticas necesitan infraestructura léxica de alto control; la cartografía exploratoria de la literatura necesita recuperación semántica e iteración rápida; la mayoría de los trabajos de tesis y subvenciones necesitan un enfoque híbrido con un protocolo escrito para cada etapa. Confundir estas tareas es la forma en que los equipos omiten estudios relacionados conceptualmente o producen un conjunto de evidencia imposible de replicar.
Para la cartografía exploratoria —«¿qué se ha escrito sobre esta idea, con cualquier nombre?»—, comience semánticamente. Elicit, SciSpace y un asistente de investigación conversacional están diseñados para esa pregunta. Google Scholar puede contribuir una vez que tenga artículos semilla, mediante Artículos relacionados y Citado por, y sigue siendo inigualable para localizar rápidamente PDF y enlaces de bibliotecas. Jenova's Academic Research Assistant encaja en esta etapa cuando también necesita que el mapa persista: decisiones de sinónimos guardadas, direcciones descartadas y formato de citas para la redacción final.
Para las revisiones sistemáticas o de alcance, no permita que una lista clasificada semánticamente se convierta en la búsqueda oficial. Utilice The Lens u OpenAlex como columna vertebral reproducible, documente cada operador y trate Elicit, Undermind o Jenova como ayudas complementarias para el descubrimiento de citas y el cribado. OpenAlex también ofrece una API, un lenguaje de consulta orientado a revisiones sistemáticas y una instantánea completa bajo licencia CC0, que es el diseño opuesto a una ordenación cerrada por relevancia. El límite de 1.000 resultados y la ausencia de acceso masivo de Google Scholar lo descalifican para la búsqueda primaria documentada, aunque siga siendo útil para comprobar si un estudio conocido se indexó siquiera.
Para las preguntas de existencia acotadas —«¿existe un artículo como este?»—, Undermind es el especialista, siempre que pueda esperar y que la evidencia de título y resumen sea suficiente. Para la producción de manuscritos una vez que existe el conjunto, la combinación de descubrimiento bibliográfico y gestión de citas de Jenova es más relevante que otra interfaz centrada solo en el descubrimiento, con la salvedad de que el metaanálisis con gran carga de extracción sigue correspondiendo a una herramienta de extracción especializada como Elicit.
La regla de decisión es lo bastante sencilla como para reutilizarla. Si la redacción varía y todavía no conoce la jerga del campo, utilice primero un asistente de investigación semántica con AI. Si debe defender la cadena de búsqueda, utilice infraestructura de palabras clave con operadores avanzados. Si debe hacer ambas cosas —que es la condición habitual para encontrar artículos relacionados conceptualmente con una redacción diferente—, ejecute recuperación semántica para descubrir el lenguaje y, después, control léxico para capturarlo y documentarlo.
Referencias
- Aaron Tay — Google Scholar frente a otras herramientas de búsqueda con AI (Undermind, Elicit, SciSpace)
- Google Scholar — Ayuda oficial de búsqueda
- Elicit — AI para investigación científica
- OpenAlex — Catálogo abierto del sistema global de investigación
- Paperguide — Comparación de precios y funciones de Elicit frente a SciSpace (2026)
- Undermind — Coinvestigador con AI para la literatura
- University of Alberta / JCHLA — Reseña de producto de Undermind.ai
- Paperpile — Cómo usar Google Scholar
- TUHH — OpenAlex como alternativa abierta para la investigación académica
- Semantic Scholar — Herramienta de investigación impulsada por AI
- UBC Wiki — Herramientas de búsqueda con AI utilizadas en revisiones de literatura y búsquedas exhaustivas
- SciSpace — Comparación entre Elicit y SciSpace
- The Lens — Versión 8.5 e integración con OpenAlex
- PMC / NIH — Funciones de OpenAlex y potencial para la síntesis de evidencia