Infraestructura de agentes de AI: una API frente al desarrollo desde cero (julio de 2026)
2026-07-24
Todos los equipos de ingeniería que lanzan funcionalidades de AI en 2026 llegan a la misma encrucijada: desarrollar la infraestructura de agentes desde cero o integrar una. Desarrollarla implica unir APIs de modelos, frameworks de orquestación, bases de datos vectoriales, almacenes de memoria y servidores de herramientas; una pila que consume trimestres de tiempo de ingeniería antes de la primera interacción de usuario. La Jenova Agent API es la alternativa: una infraestructura de agentes totalmente gestionada en la que la orquestación, la memoria, el almacenamiento, RAG y las herramientas funcionan tras una única integración.
- ✅ Sustituye toda la pila propia de agentes — enrutamiento de modelos, orquestación, memoria, RAG y herramientas — por una API
- ✅ Crea y lanza agentes personalizados de nivel de producción definidos por tus instrucciones, modelos, bases de conocimiento y herramientas
- ✅ Accede a modelos de OpenAI, Anthropic, Google, xAI, Qwen y más mediante una única credencial
- ✅ Funciona sobre una infraestructura probada en producción con más de 30.000 usuarios en más de 70 países
Para tomar con honestidad la decisión entre desarrollar o integrar, necesitas las cifras reales: lo que de verdad cuesta crear, operar y mantener una infraestructura de agentes desde cero en 2026.
Respuesta rápida: ¿qué es una infraestructura de agentes de AI?
Una infraestructura de agentes de AI es la capa técnica que permite que un agente funcione en producción: orquestación entre modelos y herramientas, memoria y contexto persistentes, recuperación sobre datos privados y los sistemas subyacentes de computación, escalado y fiabilidad. Desarrollarla desde cero implica asumir la responsabilidad de cinco o más sistemas distintos; una API de agentes gestionada ofrece todos ellos mediante una sola integración.
Capacidades clave de una infraestructura de agentes gestionada:
- Orquestación de agentes que coordina modelos, herramientas, memoria y recuperación en flujos de trabajo de varios pasos
- Enrutamiento multimodelo entre proveedores: sin dependencia de un proveedor ni gestión de claves por proveedor
- Memoria y contexto de conversación ilimitados integrados en cada sesión
- Almacenamiento relacional y vectorial totalmente gestionado con RAG integrado
- Integración de herramientas mediante herramientas nativas de la plataforma y cualquier servidor MCP remoto
El problema: lo que realmente cuesta desarrollar desde cero
La presión del mercado para lanzar agentes es intensa. El software empresarial está en camino de incluir AI agéntica en el 33 % de las aplicaciones, frente a menos del 1 % en 2024 (Datagrid), y el 67 % de los ejecutivos de alta dirección espera que los agentes de AI operen de forma independiente dentro de sus organizaciones en 2027 (VAST Data).
Sin embargo, desarrollar la infraestructura para respaldar uno resulta brutalmente caro y lento:
- Lógica de orquestación que se convierte en una segunda disciplina de ingeniería
- APIs de modelos sin estado y sin memoria entre llamadas
- Pipelines de RAG con modos de fallo documentados y recurrentes
- Capa de integración de herramientas para cada capacidad externa
- Infraestructura de producción que debe escalar, mantenerse fiable y superar revisiones de seguridad
- Un coste total del primer año que supera con creces cualquier estimación de prototipo
El presupuesto real: las llamadas a modelos son el 2 % de la historia
La demo del «agente de $100 al mes» oculta la estructura de costes real. Un desglose técnico detallado sitúa el coste realista del primer año de un agente de producción pequeño o mediano en **$270.000–$690.000**, y las llamadas a la API de modelos representan aproximadamente el 2 % del total (Particle41).
El resto se destina a aspectos que no aparecen en ningún vídeo de demostración:
$30.000–$80.000 — solo para la ingeniería y el refinamiento iniciales de prompts, con 200–400 horas de ingeniería valoradas en $150–200/hora (Particle41)
$1.000–$5.000/mes — alojamiento de bases de datos vectoriales, más otros $1.000–$2.000/mes para la generación de embeddings (Particle41)
$30.000–$60.000 — ingeniería de integración de datos para conectar el agente con apenas 4–5 sistemas existentes (Particle41)
$6.000–$10.000/mes por FTE — supervisión humana para revisar fallos, porque incluso un agente con una precisión del 95 % que gestiona 10.000 interacciones mensuales genera 500 casos que requieren revisión manual (Particle41)
Y no termina con el lanzamiento: el segundo año sigue costando entre $150.000 y $300.000 anuales para operación y refinamiento (Particle41). Incluso las estimaciones más limitadas, que solo consideran desarrollo, van de $20.000 a $60.000 para agentes de tareas simples (Biz4Group) y de $10.000 a más de $400.000 para sistemas multiagente (Azilen).
La orquestación se convierte en un producto propio
Un agente de producción no responde una sola vez: planifica, llama herramientas, recupera contexto, evalúa resultados intermedios y se recupera de errores en ejecuciones de varios pasos. Crear ese bucle de coordinación implica máquinas de estados, lógica de reintentos, gestión de tiempos de espera y límites de costes que no tienen nada que ver con tu producto real.
Los profesionales describen la diferencia con claridad: crear un agente lleva días; llevarlo a producción lleva seis meses, con bucles sin protección que disparan las facturas de API y pérdidas de estado que arruinan tareas de larga duración (
). Frameworks como LangGraph y CrewAI proporcionan abstracciones para esta capa (Speakeasy), pero las abstracciones no se ejecutan solas: sigues teniendo que alojar, escalar, proteger y mantener todo lo que hay debajo.Los pipelines de RAG son una obligación permanente, no un proyecto
Fundamentar un agente en tus datos privados implica asumir la ingesta, fragmentación, generación de embeddings, indexación, reclasificación y síntesis; además, los profesionales advierten de forma consistente que un pipeline de RAG «no solo es más difícil de lo que parece, sino que también requiere experiencia continua en LLMs, recuperación y MLOps especializado» (Vectara).
Un caso práctico documentado ilustra el problema: un proyecto interno de RAG «simple» que comenzó en enero ya había consumido, en marzo, a un ingeniero a tiempo completo depurando alucinaciones, a un ingeniero de datos a tiempo completo resolviendo problemas de ingesta y a un ingeniero de DevOps luchando con la infraestructura, mientras el presupuesto se triplicaba (Towards AI). El mismo relato documenta el ciclo de vida típico de ocho semanas: problemas de latencia, casos límite, una reescritura completa, nuevos problemas de alucinaciones, una migración de base de datos vectorial y otra reescritura.
La infraestructura heredada no fue diseñada para agentes
Las cargas de trabajo de los agentes exigen acceso continuo a datos en tiempo real, y la infraestructura de datos heredada, diseñada para cargas transaccionales, «no puede respaldar el razonamiento continuo y la toma de acciones requeridos por los agentes de AI autónomos» (VAST Data). La infraestructura de agentes de nivel empresarial requiere una base de datos unificada, almacenamiento de alto rendimiento, vectorización en tiempo real, orquestación inteligente y gobernanza de confianza cero: cinco capas de capacidad distintas antes de escribir lógica de producto.
40 % — proyectos de AI agéntica que fracasan debido a bases de infraestructura inadecuadas (Landbase)
Este es precisamente el problema que Jenova Agent API se diseñó para eliminar.
La solución: Jenova Agent API
La Jenova Agent API es un servicio de infraestructura de agentes totalmente gestionado: una integración que sustituye la pila propia de APIs de modelos, frameworks de orquestación, bases de datos vectoriales, almacenes de memoria y servidores de herramientas. Defines las instrucciones de tu agente, seleccionas un modelo, subes una base de conocimiento y configuras herramientas; la API gestiona la orquestación, la memoria, el almacenamiento y el escalado, para que lances agentes personalizados de nivel de producción en días en lugar de trimestres.
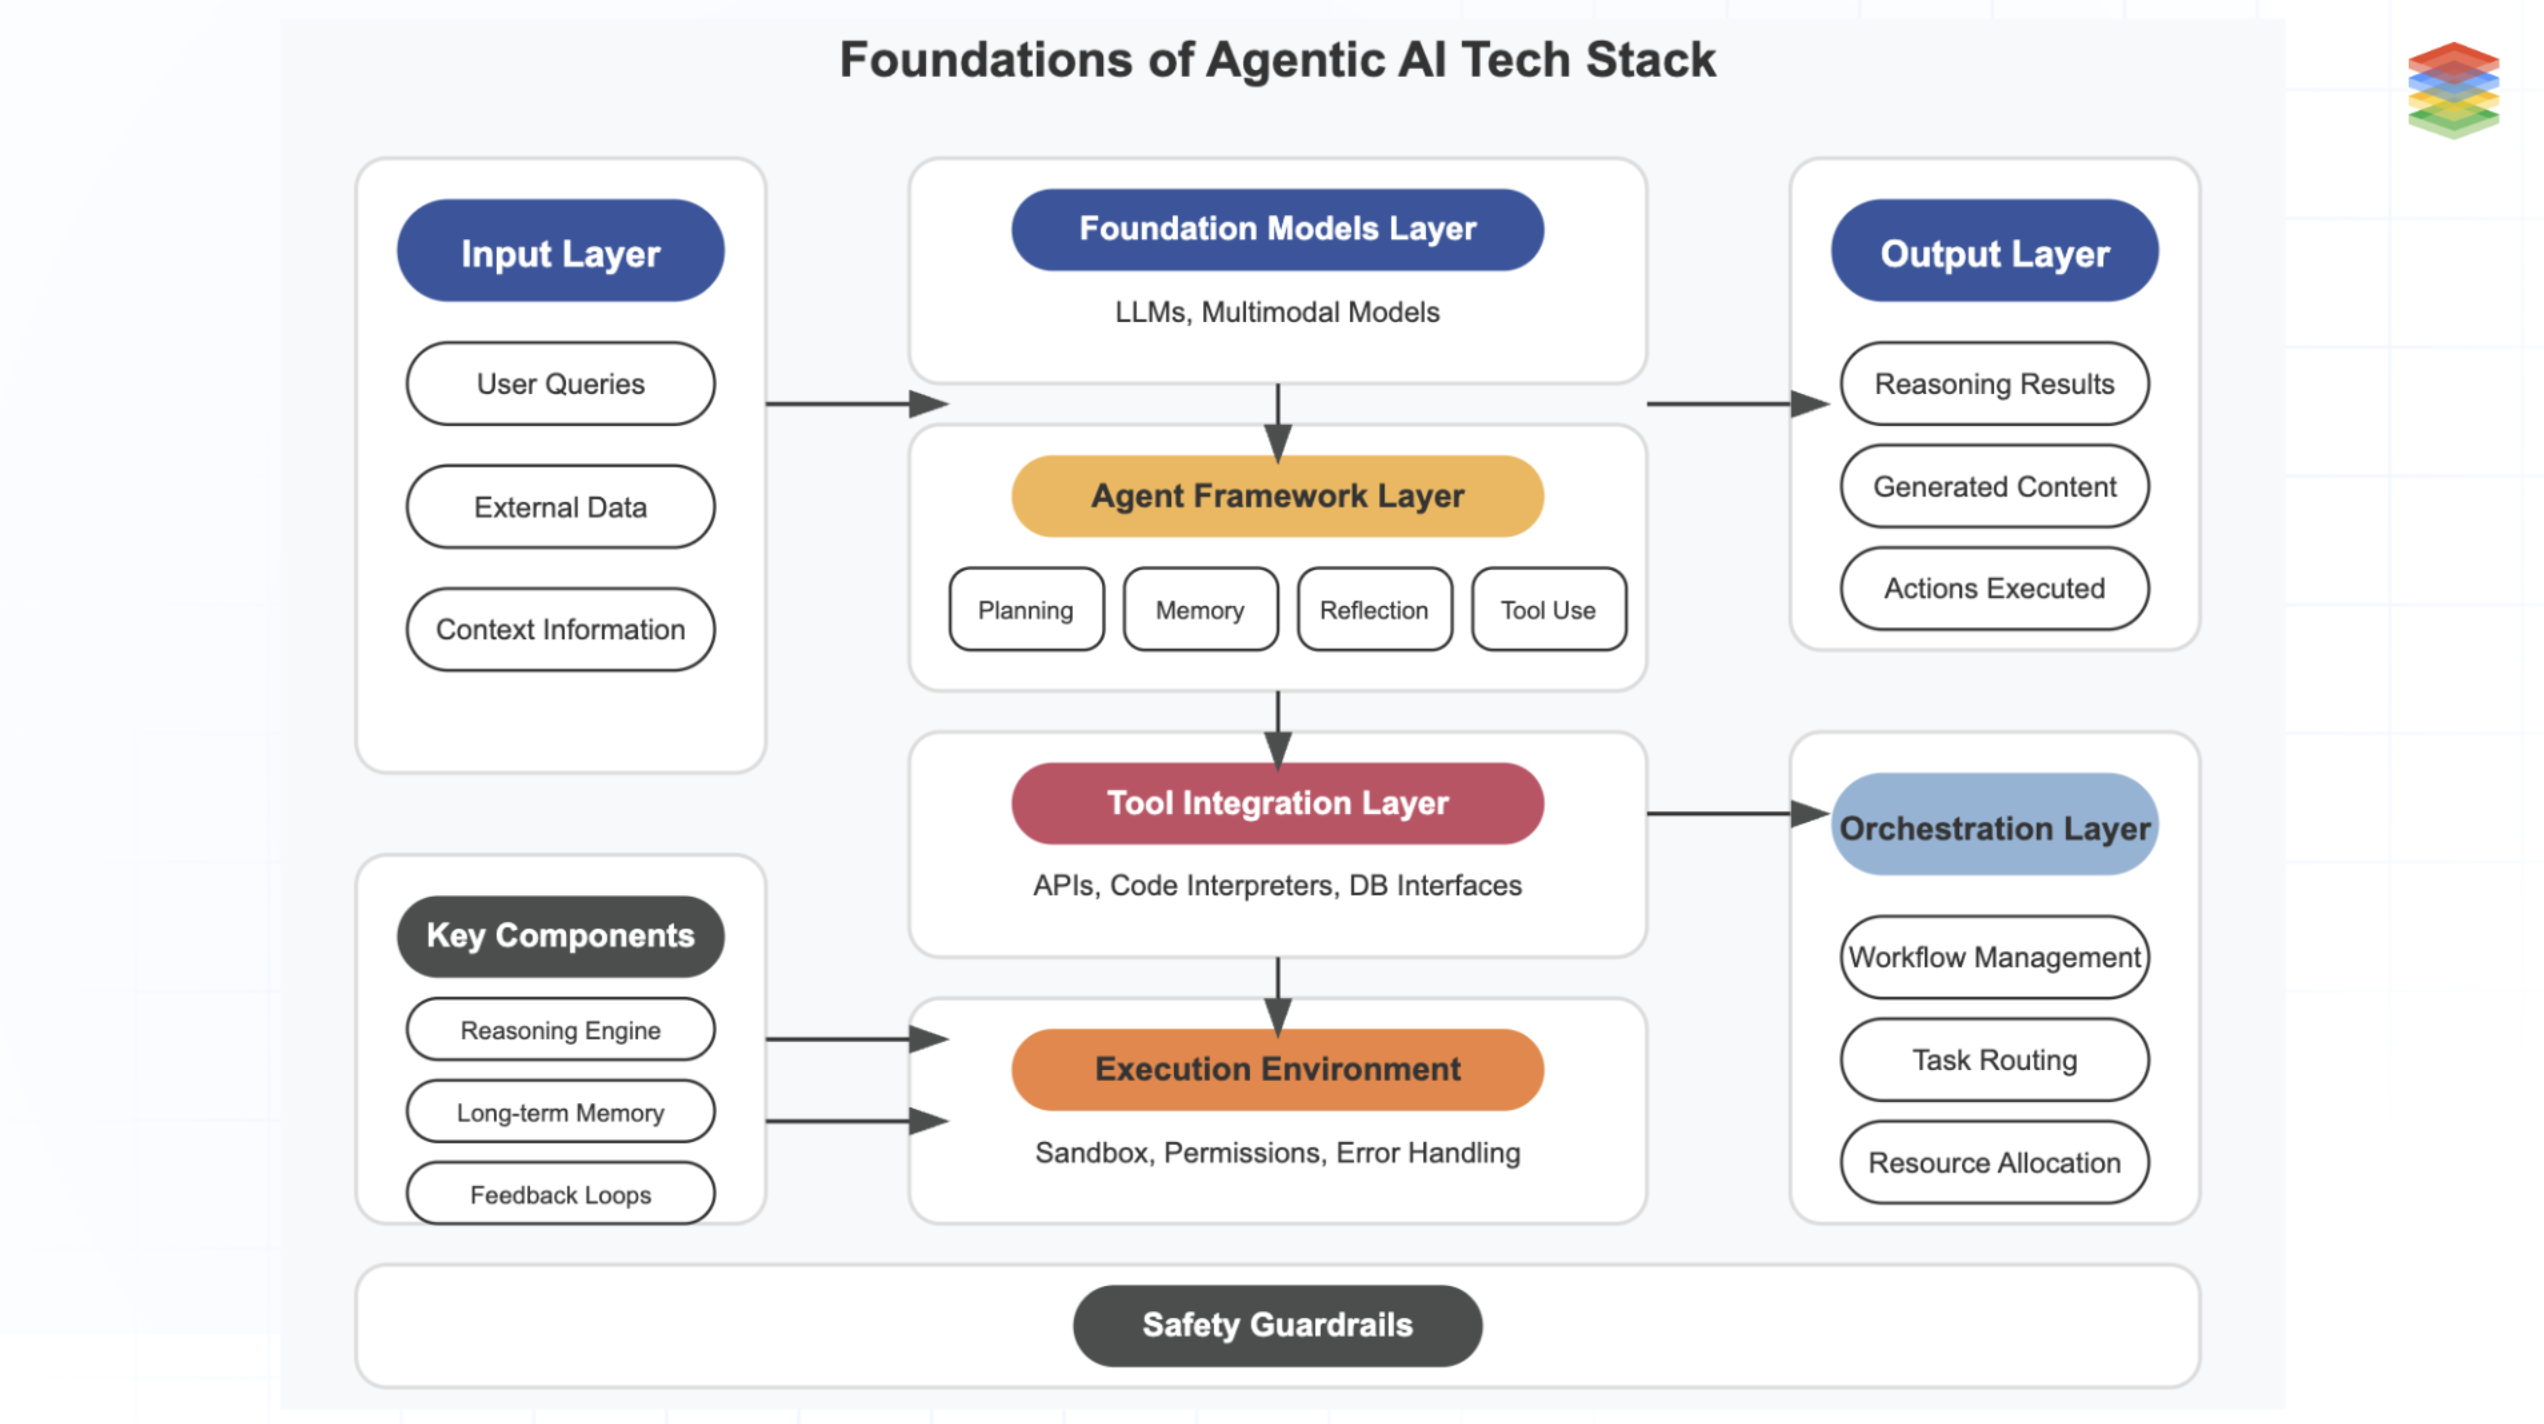
Cada capa del diagrama anterior — la planificación, memoria, reflexión y uso de herramientas del marco de agentes; las interfaces de API y bases de datos de la capa de integración de herramientas; el aislamiento y la gestión de errores del entorno de ejecución; la gestión de flujos de trabajo y el enrutamiento de tareas de la capa de orquestación — es infraestructura que la vía propia te obliga a construir. Jenova Agent API ejecuta todo ello.
| Infraestructura de agentes propia | Jenova Agent API |
|---|---|
| Grafos de orquestación personalizados, lógica de reintentos y esquemas de estado | Orquestación probada en producción que coordina modelos, herramientas, memoria y recuperación |
| SDKs, claves y límites de tasa independientes por proveedor de modelos | Cualquier modelo principal mediante una sola integración, sin dependencia de proveedor |
| Estado de sesión en Redis/Postgres más serialización personalizada | Memoria y contexto ilimitados integrados en cada sesión |
| Base de datos vectorial aprovisionada, pipelines de fragmentación y embeddings ($1.000–$5.000/mes) | Almacenamiento relacional y vectorial totalmente gestionado con RAG integrado |
| Adaptadores de herramientas escritos a mano, flujos de autenticación y código repetitivo para errores | Herramientas nativas de la plataforma y cualquier servidor MCP remoto, listas desde el primer momento |
| Servidores, contenedores, políticas de escalado y monitorización de disponibilidad | Infraestructura gestionada de nivel de producción con APIs estables |
Orquestación de agentes
El razonamiento de varios pasos, la invocación de herramientas, la recuperación y la síntesis de respuestas se ejecutan dentro de la plataforma, sin definiciones de grafos, esquemas de estado ni DAG de flujos de trabajo que crear y mantener. Tú defines qué debe lograr el agente; la infraestructura determina cómo, con la ejecución acotada y controlable que exige la fiabilidad en producción.
Usa cualquier modelo
Impulsa agentes con modelos de OpenAI, Anthropic, Google, xAI, Qwen y más mediante una credencial. Utiliza un modelo de vanguardia para razonamientos complejos y un modelo rentable para sesiones de gran volumen; cámbialos libremente para cada agente, sin gestionar claves por proveedor ni realizar trabajo de migración cuando se lancen nuevas generaciones de modelos. Tus capas de memoria y conocimiento sobreviven a cada cambio.
Memoria y contexto
La memoria y el contexto de conversación ilimitados están integrados en cada sesión. Mantén un identificador de sesión constante y tu agente recordará el historial, las preferencias y los proyectos de larga duración de cada usuario, sin almacenes de estado externos, código de serialización ni ingeniería de ventanas de contexto. La capa más propensa a fallos de la pila propia sencillamente deja de existir para ti.
Almacenamiento totalmente gestionado
Bases de datos relacionales y vectoriales gestionadas con RAG integrado. Sube documentos y bases de conocimiento; la plataforma gestiona la fragmentación, los embeddings, la indexación y la recuperación. No hay ninguna base de datos vectorial que aprovisionar, ajustar o escalar: desaparecen la partida de $1.000–$5.000/mes y el ingeniero que la mantiene.
Herramientas y MCP
Integraciones de herramientas ilimitadas con herramientas nativas de la plataforma y cualquier servidor MCP remoto, listas desde el primer momento: búsqueda, correo electrónico, calendarios, documentos y tus propias APIs internas. Sin código adaptador, sin infraestructura de flujos de autenticación y sin código repetitivo que mantener a medida que cambian las APIs de terceros.
Nivel de producción
Infraestructura totalmente gestionada con APIs estables, diseñada para tráfico de producción, sin servidores, contenedores ni políticas de escalado por tu parte. La plataforma está probada en producción con más de 30.000 usuarios en más de 70 países, por lo que tus agentes heredan una fiabilidad que tu equipo nunca tendrá que construir.
Una sola llamada ejecuta el agente completo:
bashcurl -X POST https://api.jenova.ai/v1/chat \
  -H "Authorization: Bearer YOUR_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "agent_id": "your-support-agent",
    "message": "Summarize this customer'\''s open issues and draft a reply.",
    "session_id": "user-4821-session"
  }'
La orquestación, la memoria, la recuperación y las llamadas a herramientas se ejecutan dentro de esa solicitud. Tu aplicación muestra la respuesta; la plataforma se encarga de todo lo que hay detrás.
Lo que puedes crear
La API está diseñada para desarrolladores que lanzan agentes personalizados con estado como funcionalidades dentro de sus propios productos. Cada uno de los siguientes ejemplos es una aplicación que puedes crear y lanzar: define las instrucciones y la base de conocimiento del agente, y la API gestionará la orquestación, la memoria y el escalado.
Un agente de soporte entrenado con tu producto
Crea un agente de soporte fundamentado en tu centro de ayuda, registro de cambios e historial de tickets. La memoria de sesión sigue todo el recorrido de soporte de cada cliente a través de las interacciones: se acabó el «¿puede repetir su número de cuenta?».
- Indexación y recuperación de documentos gestionadas de principio a fin
- Sistemas de tickets y CRM conectados mediante MCP
- Lánzalo en días en lugar de dedicar un trimestre a la gestión de estado
Un analista financiero integrado
Lanza un asesor de carteras dentro de tu panel fintech que recuerde las inversiones, la tolerancia al riesgo y los objetivos de cada cliente durante meses de conversaciones.
- Contexto de asesoramiento longitudinal mantenido automáticamente
- Datos de mercado y sistemas de cuentas conectados mediante MCP
- Cambio de modelo según la complejidad de la consulta para optimizar costes
Un tutor personalizado para tu plataforma de aprendizaje
Implementa un tutor adaptativo que haga seguimiento del progreso, las áreas débiles y las preferencias de cada estudiante en todas las sesiones, fundamentado en tu plan de estudios.
- Memoria por estudiante sin filas de base de datos por usuario que gestionar
- Las actualizaciones del plan de estudios se despliegan al cargarlo, sin rediseñar la recuperación
- Escala a miles de estudiantes simultáneos sobre infraestructura gestionada
Un asistente de comercio que conoce tu catálogo
Integra un asistente conversacional de compras que conozca tu catálogo, recuerde las preferencias y el historial de compras de cada cliente, y guíe el descubrimiento mediante el diálogo en lugar de filtros.
- Catálogo fundamentado mediante RAG gestionado: las actualizaciones se despliegan al instante
- Memoria de preferencias por comprador sin almacenes de estado externos
- Concurrencia de nivel de producción para picos de tráfico
Un agente de operaciones interno para tu propio equipo
Crea un agente de operaciones conectado a tu documentación interna, sistemas de tickets y sistemas de datos, que responda preguntas de empleados y ejecute flujos de trabajo rutinarios con todo el contexto organizativo.
- Base de conocimiento privada indexada automáticamente
- APIs internas conectadas mediante servidores MCP remotos
- Las nuevas capacidades se despliegan como configuración, no como código
Obtén tu clave de API y lanza tu primer agente en minutos.
Cómo funciona: de una clave de API a un agente de producción en cuatro pasos
Paso 1: obtén tu clave de API
Crea una cuenta y genera tu clave de API desde el panel de la plataforma. Una credencial cubre cada proveedor de modelos y cada agente que crees, sin gestión de claves por proveedor entre desarrollo, pruebas y producción.
Paso 2: crea o elige tu agente
Define un agente personalizado con tus propias instrucciones, modelo preferido, base de conocimiento y configuración de herramientas, o comienza con un agente preconfigurado y adáptalo. Crear el agente es configuración, no código: describes el comportamiento y la plataforma proporciona la orquestación, memoria y recuperación que lo sustentan.
Paso 3: añade créditos
Recarga los créditos de tu cuenta. El uso se descuenta de tu saldo en cada llamada, sin facturas independientes de infraestructura, bases de datos vectoriales ni almacenes de memoria ocultas en segundo plano.
Paso 4: realiza la llamada
Desde tu servidor, reenvía el mensaje del usuario con el ID de tu agente y un identificador de sesión. Reutiliza el ID de sesión y el agente continuará exactamente donde lo dejó con ese usuario:
bashcurl -X POST https://api.jenova.ai/v1/chat \
  -H "Authorization: Bearer YOUR_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "agent_id": "your-commerce-assistant",
    "message": "Show me trail running shoes like the pair I bought last spring.",
    "session_id": "shopper-9317"
  }'
json{
  "response": "Based on your purchase last spring — the ridge-trail model in size 10 — here are three current options with similar cushioning and grip...",
  "session_id": "shopper-9317"
}
No hay ningún almacén de memoria que configurar, pipeline de recuperación que mantener ni grafo de orquestación que depurar. Las especificaciones completas de los puntos de conexión, los esquemas de solicitudes y respuestas, y los detalles de integración están en la documentación de API.
Resultados y casos de uso
💼 Startup SaaS: un sprint en lugar de $270.000–$690.000
Situación: Una empresa SaaS B2B con 3.000 clientes quiere un agente de soporte integrado en la App que conozca su documentación y recuerde el historial de cada cuenta, con un equipo de ingeniería de tres personas.
Enfoque tradicional: La vía propia cuesta entre $270.000 y $690.000 durante el primer año (Particle41): selección de un framework de orquestación, aprovisionamiento de una base de datos vectorial, memoria por cuenta en Redis o Postgres, adaptadores de herramientas para el sistema de tickets y, después, alojamiento, escalado y monitorización; todo ello antes de la primera respuesta dirigida a un cliente.
Jenova Agent API: Define las instrucciones de soporte y las reglas de escalado, sube el centro de ayuda y conecta los tickets mediante MCP. La memoria de sesión persistente ofrece a cada cuenta un historial de soporte continuo desde el primer día.
- ✅ Días hasta producción en vez de meses
- ✅ Presupuesto de infraestructura de seis cifras redirigido a ingeniería de producto
- ✅ Sin sistema de memoria ni base de datos vectorial que aprovisionar o mantener
📊 Fintech: una funcionalidad de asesoramiento sin equipo de infraestructura
Situación: Una fintech quiere incorporar un analista de carteras de AI como funcionalidad prémium del panel. Sus dos ingenieros de infraestructura nunca han creado infraestructura de agentes.
Enfoque tradicional: Aprender un framework de orquestación, crear flujos de asesoramiento con estado, implementar persistencia de memoria para relaciones continuas con clientes y aprovisionar RAG para documentos financieros: la misma brecha de cuatro a seis meses hasta producción que los profesionales describen entre el prototipo y el lanzamiento (
).Jenova Agent API: Configura un agente analista financiero con instrucciones de dominio, conecta datos de mercado mediante MCP y deja que la memoria integrada mantenga el contexto de cartera en cada conversación de asesoramiento.
- ✅ Sin framework que aprender, alojar ni mantener
- ✅ Memoria longitudinal de clientes disponible desde el primer momento
- ✅ Cambio de modelos para optimizar costes sin cambios de código
📱 EdTech móvil: tutorías para 30.000 estudiantes simultáneos
Situación: Una App móvil educativa que atiende a 30.000 estudiantes necesita tutores personalizados en cuatro materias, cada uno con conocimiento del plan de estudios y seguimiento del progreso de cada estudiante.
Enfoque tradicional: Configuraciones de agentes por materia, persistencia de memoria por estudiante en bases de datos externas, almacenamiento vectorial para el plan de estudios e infraestructura que sostenga decenas de miles de sesiones simultáneas con estado sin perder contexto. Esta es precisamente la carga de trabajo en la que falla la infraestructura heredada (VAST Data).
Jenova Agent API: Crea un agente tutor por materia con instrucciones y materiales específicos del plan de estudios. La memoria de sesión conserva automáticamente el progreso de cada estudiante; RAG indexa el plan de estudios al cargarlo.
- ✅ Contexto de aprendizaje persistente y personalizado sin almacenes de estado externos
- ✅ Las actualizaciones del plan de estudios se despliegan sin rediseñar la recuperación
- ✅ Concurrencia de nivel de producción desde el primer día
🎯 Agencia de producto: cuatro clientes, una integración
Situación: Una agencia de desarrollo crea funcionalidades de AI para cuatro clientes: admisión sanitaria, revisión de documentos legales, descubrimiento comercial y búsqueda empresarial. La vía propia implica duplicar almacenes de memoria, pipelines de RAG y alojamiento para cada cliente.
Enfoque tradicional: Cuatro pilas de agentes independientes: cuatro pipelines de recuperación, cuatro configuraciones de escalado y cuatro obligaciones de mantenimiento. Dado que el 40 % de los proyectos agénticos fracasa por contar con bases inadecuadas (Landbase), replicar cuatro veces la capa de mayor riesgo es una apuesta a nivel de cartera.
Jenova Agent API: Una integración y una clave de API para los cuatro clientes. Agentes personalizados para cada proyecto — instrucciones de dominio, modelos, bases de conocimiento y herramientas — ejecutándose todos sobre el mismo servicio gestionado.
- ✅ Una única integración escala a proyectos ilimitados de clientes
- ✅ Selección de modelos por cliente sin gestión de proveedores por cliente
- ✅ Tiempo de ingeniería invertido en lógica de producto, no en replicar infraestructura
Preguntas frecuentes
¿Cuánto cuesta crear una infraestructura de agentes de AI desde cero?
Los análisis de ingeniería sitúan el coste realista del primer año de un agente de producción entre $270.000 y $690.000 al incluir infraestructura, ingeniería de prompts, pruebas, integración de datos, bases de datos vectoriales y supervisión humana; las llamadas a la API de modelos representan aproximadamente el 2 % del total (Particle41). La operación continua cuesta entre $150.000 y $300.000 anuales después de ese periodo.
¿Cómo funcionan los precios y créditos de Jenova Agent API?
El uso se basa en créditos: añades créditos a tu cuenta y cada llamada a la API descuenta de tu saldo. No existen costes independientes de infraestructura, bases de datos ni almacenes de memoria; la pila gestionada está incluida en el uso, lo que consolida en una sola factura lo que, de otro modo, serían cinco o seis facturas de proveedores. Consulta las tarifas actuales en la página de la plataforma.
¿Qué modelos puedo usar mediante la API?
Los agentes pueden funcionar con modelos de OpenAI, Anthropic, Google, xAI, Qwen y más mediante una sola integración. Seleccionas el modelo por agente y puedes cambiarlo libremente: no existe dependencia de proveedor ni trabajo de migración cuando se lanzan nuevas generaciones de modelos. La memoria y el conocimiento persisten entre cambios de modelo.
¿Qué dificultad tiene la integración frente a crearla con LangChain o APIs de modelos directas?
La integración sigue un flujo de cuatro pasos: obtener una clave de API, crear o elegir un agente, añadir créditos y realizar la primera llamada. Una solicitud POST ejecuta el agente completo, con orquestación, memoria, RAG y herramientas incluidas. Las APIs de modelos directas solo proporcionan inferencia, y frameworks como LangChain ofrecen abstracciones que aún debes alojar, escalar y mantener; Jenova Agent API es la infraestructura gestionada en sí misma. Los esquemas completos están en la documentación de API.
¿Puedo crear agentes personalizados con mis propios datos y herramientas?
Sí. Defines instrucciones personalizadas, subes una base de conocimiento privada — indexada automáticamente mediante RAG gestionado —, seleccionas el modelo y configuras herramientas, incluido cualquier servidor MCP remoto, que cubre la mayoría de las APIs internas. El agente funciona como una funcionalidad propietaria de tu producto, no como un asistente genérico.
¿Está preparada una API de agentes gestionada para tráfico real de producción?
Sí. La infraestructura está totalmente gestionada, con APIs estables diseñadas para tráfico de producción, sin servidores ni políticas de escalado por tu parte. La plataforma está probada en producción con más de 30.000 usuarios en más de 70 países, y el uso escala con tu saldo de créditos en lugar de con infraestructura que tengas que aprovisionar.
Conclusión
La vía de desarrollar una infraestructura de agentes de AI desde cero está bien documentada en 2026: entre $270.000 y $690.000 en costes del primer año, meses de ingeniería de orquestación y RAG, una base de datos vectorial y una capa de memoria que mantener para siempre, y una brecha hasta producción que acaba con el 40 % de los proyectos antes de que se lancen. La llamada al modelo nunca fue la parte difícil; lo difícil es todo lo que la rodea.
Jenova Agent API sustituye toda esa pila por una integración: agentes personalizados definidos por tus instrucciones, modelos, bases de conocimiento y herramientas, ejecutándose sobre infraestructura totalmente gestionada y de nivel de producción con orquestación, memoria, almacenamiento y herramientas MCP integradas. Define tu agente, realiza la llamada y lanza en días lo que la vía propia programa en trimestres. Empieza a crear con la documentación de API, obtén tu clave de API en la plataforma Jenova Agent API y explora la plataforma completa en Jenova.