Warum verändert dieselbe AI-Figur von Comic-Panel zu Comic-Panel Gesicht, Kleidung oder Frisur?
2026-08-13
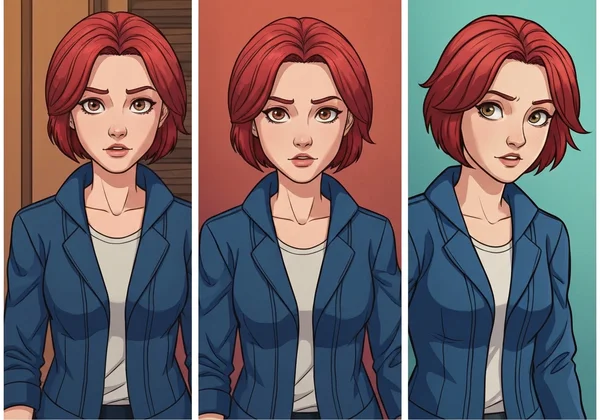
Was verursacht Identitätsdrift zwischen Panels wirklich – Prompt-Formulierung oder Modellarchitektur?
Figurendrift in AI-Comics ist eine architektonische Einschränkung und kein Prompting-Fehler: Text-zu-Bild-Modelle erzeugen jedes Panel als unabhängiges Sampling-Ereignis ohne Erinnerung an frühere Ausgaben. Eine Beschreibung wie „rothaariger Detektiv im Trenchcoat“ wird deshalb jedes Mal als statistisch plausible Person aufgelöst – nicht als dieselbe Person. Die zuverlässigsten Lösungen leiten die Identität über Referenzbilder und Assetsysteme statt über Text weiter: Tools wie ComicInk, LTX Studio, Figma Weave und Jenovas Comic Creator folgen diesem Prinzip aus unterschiedlichen Perspektiven.
Was driftresistente Workflows von anfälligen unterscheidet:
✅ Referenzgestützte Generierung – die Identität wird von einem Bild-Asset getragen und nicht in jedem Panel erneut beschrieben
✅ Entkopplung von Attributen – Gesicht, Haare, Kleidung und Hintergrund werden unabhängig voneinander fixiert, damit ein Szenenwechsel die Figur nicht neu zusammenwürfelt
✅ Trennung von Vorder- und Hintergrund – Studien zeigen, dass Hintergrunddetails abdriften, selbst wenn das Gesicht stabil bleibt (CharaConsist, ICCV 2025)
✅ Vokabulardisziplin – „brauner Trenchcoat“ muss immer „brauner Trenchcoat“ bleiben, niemals nur „Mantel“ oder „Jacke“
✅ Toleranz für Bewegung – Konsistenzmethoden verschlechtern sich deutlich, sobald eine Figur ihre Pose oder Aktion verändert
Um ein Tool oder einen Workflow ehrlich bewerten zu können, hilft es, zunächst die vier unterschiedlichen Fehlermuster hinter dem einzelnen Symptom „Meine Figur sieht anders aus“ zu verstehen.
Was sind die vier technischen Ursachen von Figurendrift?
Drift hat vier voneinander trennbare Ursachen, und jede erfordert eine andere Lösung. Sie als ein einziges Problem zu behandeln, ist der Grund, warum die meisten Kreativen endlos Prompt-Anpassungen ausprobieren, die nie vollständig funktionieren.
1. Kein Erinnerungsmechanismus. Jede Generierung ist ein unabhängiges Ereignis. Die technische Analyse von LTX Studio formuliert es eindeutig: Das Modell „kann sich nicht an zuvor generierte Figurenmerkmale erinnern“, weshalb jeder Render-Vorgang bei der Textbeschreibung neu beginnt. Ein Prompt ist eine Wahrscheinlichkeitsverteilung, keine Spezifikation – „grüne Augen, Mitte 30“ beschreibt Millionen gültiger Gesichter.
2. Verflechtung von Stil und Identität. Modelle haben Schwierigkeiten, wer die Figur ist davon zu trennen, wie das Bild aussieht. Ändert sich zwischen Panels die künstlerische Ausrichtung – etwa dramatische Beleuchtung oder eine weitere Kameraeinstellung –, verändert sich oft auch die Gesichtsgeometrie, weil das Modell diese Faktoren nicht als unabhängige Variablen gelernt hat.
3. Lücken bei Perspektive und 3D-Verständnis. Dieselbe Person aus einem neuen Blickwinkel zu rendern, verlangt implizites 3D-Verständnis, das dem Modell fehlt. Deshalb driften Seiten- und Rückansichten am stärksten ab und deshalb empfiehlt LTX für nachgelagerte Flexibilität ausdrücklich frontale Referenzen.
4. Streuung der Aufmerksamkeit. Das Modell verteilt seine begrenzte Aufmerksamkeit gleichzeitig auf Figur, Kleidung, Hintergrund und Stil. Steigt die erzählerische Komplexität, verliert die Figurendetaillierung diesen Wettbewerb.
🎯 Warum Kleidung stärker abdriftet als Gesichter
Die Garderobe ist der am wenigsten diskutierte Fehlermodus. Das ICCV-2025-Paper zu CharaConsist stellte fest, dass identitätsreferenzierende Methoden wie IP-Adapter und PhotoMaker „ausschließlich auf die Bewahrung der Gesichtsidentität fokussieren und keine Konsistenz anderer Attribute wie Kleidung oder Szenen gewährleisten können“. Tools zur Gesichtsstabilisierung können ein Gesicht konstant halten, während die Jacke ihre Farbe wechselt, der Kragen umgestaltet wird und Accessoires verschwinden – weil diese Systeme nie darauf trainiert wurden, genau diese Merkmale zu bewahren.
Wie viel Konsistenz können aktuelle Methoden tatsächlich erreichen?
Messbare Konsistenz ist real, aber unvollständig – keine Methode erreicht eine vollständige Identitätssperre, und die Zahlen zeigen genau, wo die jeweiligen Ansätze scheitern. Das CharaConsist-Team verglich vier führende Ansätze anhand der CLIP-Bildähnlichkeit, aufgeteilt in Vordergrund- (CLIP-I-fg) und Hintergrundkomponenten (CLIP-I-bg), sowie der Ähnlichkeit von Gesichts-Embeddings (ID Sim).
Die veröffentlichten Ergebnisse verorten CharaConsist bei 0.883 CLIP-I-fg und 0.916 CLIP-I-bg bei Aufgaben mit stabilem Hintergrund, gegenüber 0.876 und 0.895 für ConsiStory. Besonders bei der Hintergrundkonsistenz – einer Dimension, die die meisten Methoden vollständig ignorieren – wird der Abstand größer.
In einer im selben Paper beschriebenen Studie mit menschlichen Bewertungen bevorzugten die Evaluierenden CharaConsist gegenüber Vergleichsmethoden in 64 % der Fälle bei Kleidungskonsistenz und in 98 % der Fälle bei Hintergrundkonsistenz, während die Präferenz für Texttreue nur bei 57 % lag – ein messbarer Zielkonflikt zwischen fixierter Identität und der Befolgung des Prompts.
Dieser Zielkonflikt ist die zentrale Spannung der gesamten Kategorie. Jeder Konsistenzmechanismus beschränkt den Generator, und Beschränkung verringert die Reaktionsfähigkeit auf Prompts. Die Ablationsstudie des Papers zeigt selbst, dass FLUX.1 mit angewendetem CharaConsist beim CLIP-T-Wert für Textausrichtung niedriger abschneidet als das unveränderte Basismodell.
📊 Das Bewegungsproblem
Konsistenzmethoden bauen bei Bewegung ab. Die CharaConsist-Autoren benennen dies direkt: „Wenn die Vordergrundfigur großen Bewegungsvariationen unterliegt, werden Inkonsistenzen bei Identität und Kleidungsdetails sichtbar.“ Für Comics – ein Medium voller rennender, kämpfender, gestikulierender und reagierender Figuren – ist dies die härteste Einschränkung. Ein Panel mit sprechenden Köpfen bleibt deutlich stabiler als ein Action-Panel, und jeder Toolvergleich, der nur statische Porträts testet, überschätzt die reale Leistung.
Welche Ansätze gibt es und wie schneiden sie im Vergleich ab?
Es gibt vier unterschiedliche architektonische Ansätze. Sie tauschen entlang derselben drei Achsen gegeneinander ab: Einrichtungsaufwand, Konsistenzstärke und kreative Flexibilität.
| Dimension | Allgemeine Generatoren (Midjourney, DALL·E) | ComfyUI + IP-Adapter/ControlNet | Referenz-Asset-Plattformen (LTX, Figma Weave, ComicInk) | Jenova Comic Creator |
|---|---|---|---|---|
| Konsistenzmechanismus | Wiederverwendung von Seeds + Prompt-Wiederholung | Trainierte Adapter, LoRA, Gesichts-Embeddings | Gespeicherte Figuren-Assets werden pro Generierung wiederverwendet | Persistenter Gesprächsspeicher + gespeicherte Figurendefinitionen |
| Gesichtskonsistenz | Schwach – laut Nutzern der häufigste Fehler | Stark; IP-Adapter FaceID ist für Identität optimiert | Stark; Asset-gestützt | Stark bei definierten Figuren; abhängig vom gewählten Modell |
| Kleidungskonsistenz | Schwach | Schwach – dokumentierte Lücke bei identitätsreferenzierenden Methoden | Über Outfit-Varianten verwaltet (LTX: duplizieren und anpassen) | Durch explizite Charakterbögen im Sitzungsspeicher erhalten |
| Einrichtungsaufwand | Minimal | Hoch – Workflow-Aufbau, Modellgewichte, GPU | Mittel – zuerst Figurenbibliothek aufbauen | Niedrig – Einrichtung im Gespräch, keine technische Konfiguration |
| Flexibilität bei Pose/Aktion | Hoch, aber inkonsistent | Mittel; ControlNet ermöglicht Posensteuerung | Mittel; der Fokus auf frontale Referenzen begrenzt Winkel | Mittel; bei extremer Action nimmt die Drift zu |
| Lokale Hardware | Keine | 3–37 GB VRAM, abhängig vom Offload-Modus | Keine | Keine |
| Preise | Midjourney-/DALL·E-Abonnements | Kostenlose Software; Hardware- und Stromkosten | Figma Weave kostenloser Tarif + kostenpflichtige Pläne; ComicInk: kostenlose 4-Seiten-Testversion | Kostenloser Tarif; Plus 20 $/Monat bei 30× der kostenlosen Nutzung |
| Am besten geeignet für | Einzelne eindrucksvolle Bilder, Konzeptkunst | Technische Kreative mit Bedarf an maximaler Kontrolle | Teams, die eine wiederkehrende Besetzung standardisieren | Story-orientierte Kreative, die mehrpanelige Erzählungen im Gespräch erstellen |
Allgemeine Bildgeneratoren
Midjourney und DALL·E liefern die höchste ästhetische Qualität pro Bild, aber die schlechteste Konsistenz über mehrere Panels hinweg. Foren von Kreativen dokumentieren das Muster durchgehend: Nutzer berichten von „der Unfähigkeit, dieselben oder auch nur ähnliche Figuren durchgehend beizubehalten“. In der OpenAI-Entwickler-Community gibt es einen offenen Anfrage-Thread zu Figurenkonsistenz und Stilfixierung, der ausdrücklich die Bewahrung von „Gesichtsmerkmalen, Körperform, Hautton, Kleidung und Pose über Anfragen hinweg“ fordert. Seed-Wiederverwendung und die Verankerung an einem einzigen Quellbild helfen – Midjourney-Anwender berichten von stabilerer Kleidung, wenn sie bei einem Quellbild und einem festen Seed bleiben –, doch keiner der beiden Ansätze garantiert Identität.
ComfyUI-Adapter-Stacks
Das höchste technische Potenzial trifft auf die steilste Lernkurve. IP-Adapter bewahrt Erscheinung und Stil, während ControlNet die Struktur steuert; Praktiker kombinieren beide, weil keiner allein ausreicht. Das CharaConsist-Repository dokumentiert die Hardware-Realität klar: 37 GB VRAM für den Betrieb mit einer einzelnen GPU, sinkend auf 3 GB nur mit sequenziellem CPU-Offload und erheblichem Geschwindigkeitsverlust. Allein aufgrund der Hardwareanforderungen scheidet dieser Weg für die meisten Comic-Kreativen aus.
Referenz-Asset-Plattformen
Der pragmatische Mittelweg. Das Elements-System von LTX Studio speichert Figuren als persistente, tagbare Assets, die über @-Erwähnungen aufgerufen werden. Figma Weave verfolgt einen knotenbasierten Ansatz, bei dem „Konsistenz strukturell und nicht zufällig“ entsteht. ComicInk erzeugt zuerst Figurenreferenzbilder und hängt sie dann an jeden Seiten-Render an. Alle drei setzen auf dieselbe architektonische Idee: Hör auf, die Figur zu beschreiben – beginne, auf sie zu verweisen.
Wie verhindert man Drift in einem funktionierenden Comic konkret?
Die einzelne Änderung mit dem größten Hebel besteht darin, deine Figur von einer Beschreibung in ein Asset zu verwandeln, bevor du auch nur ein Panel generierst. Alles andere ist Verfeinerung.
Universelle Schritte vor der Produktion:
- Erstelle zuerst einen Charakterbogen. Fixiere Gesicht, Haare, Statur, Kleidung und Farbpalette in einem kanonischen Render, bevor das erste Panel existiert.
- Friere dein Vokabular ein. Die Empfehlung von LTX ist eindeutig: „‚Brauner Trenchcoat‘ sollte immer ‚brauner Trenchcoat‘ heißen, nicht in späteren Beschreibungen einfach ‚Mantel‘ oder ‚Jacke‘.“ Synonymdrift verursacht visuelle Drift.
- Nutze frontal ausgeleuchtete, neutral beleuchtete Referenzen. Gerichtete Schatten und seitliche Winkel prägen sich in die Referenz ein und kollidieren mit späteren Szenen.
- Erstelle Kleidungsversionen bewusst, statt Outfits neu zu beschreiben. LTX löst dies durch das Duplizieren einer Figur und das Bearbeiten ausschließlich der Kleidungsfelder. Dadurch bleibt die Gesichtsidentität über
@Sarah_casualund@Sarah_formalhinweg erhalten.
In Jenovas Comic Creator übernimmt der persistente Speicher der Sitzung die Verankerung: Du legst die Figur einmal im Gespräch fest, und der Agent trägt diese Definition weiter:
„Erstelle einen Charakterbogen für Mara Voss: 34 Jahre, markante Kieferlinie, kurz geschnittenes silbernes Haar, ausgewaschene olivgrüne Feldjacke mit eingerissenem linkem Ärmelbündchen, dunkelgraue Cargohose. Neutraler Gesichtsausdruck, Frontalansicht, weiches gleichmäßiges Studiolicht, flach-neutraler Hintergrund. Westlicher Comic-Tuschenstil.“
Verweise dann pro Panel auf die Figur, statt sie neu zu beschreiben:
„Panel 3: Mara Voss – derselbe Charakterbogen, dieselbe olivgrüne Feldjacke mit dem eingerissenen linken Ärmelbündchen – kauert hinter einem umgekippten Auto und blickt nach links. Gesicht, Haare und Kleidung müssen mit dem Charakterbogen identisch bleiben.“
In LTX Studio lautet der entsprechende Ablauf: Elements öffnen → Create New Element → Character → 5–12 Referenzbilder hochladen oder eines generieren → benennen → dann in jedem Shot-Prompt @CharacterName taggen. Aktualisierungen des gespeicherten Elements werden automatisch auf jede getaggte Erscheinung übertragen.
In ComfyUI baust du einen Graphen: Lade einen IP-Adapter-FaceID-Node für die Identität, hänge ControlNet für die Posenstruktur an und trainiere entweder ein LoRA auf deine Figur oder nutze über alle Render hinweg ein festes Referenzbild als Identitätsquelle.
⚠️ Was nicht funktioniert
„Konsistente Figur“ oder „dieselbe Person wie zuvor“ zu einem Prompt hinzuzufügen, bewirkt nichts. Für das Modell gibt es kein „zuvor“. Die Community-Dokumentation dieses Fehlers ist unverblümt: „Die meisten Menschen sagen der AI, was sie wollen“, statt eine Referenz bereitzustellen, an der sich das System festhalten kann. Text kann keinen fehlenden Erinnerungsmechanismus ausgleichen.
Warum driften Hintergründe ab, selbst wenn die Figur stabil bleibt?
Hintergründe driften ab, weil fast jede Konsistenzmethode ausschließlich das Vordergrundmotiv optimiert und die Umgebung in jedem Panel frei neu generiert wird. Die CharaConsist-Autoren benennen dies als zentrale Lücke früherer Arbeit: Bestehende trainingsfreie Methoden „können keine konsistenten Hintergrunddetails bewahren, was ihre Anwendbarkeit einschränkt“.
Die messbaren Kosten sind erheblich. In der Studie mit menschlichen Präferenzen zeigte die Hintergrundkonsistenz den größten Abstand aller Dimensionen: 98 % Präferenz für die Methode, die sie explizit behandelt, gegenüber 2 % und 0 % für die beiden Vergleichsmethoden. Das ist keine geringfügige Verbesserung; es zeigt, dass die Vergleichsmethoden Hintergrundbewahrung im Wesentlichen gar nicht versuchen.
Für Comics ist das wichtiger als für Einzelillustrationen. Ein zweiseitiges Gespräch in derselben Küche verlangt, dass diese Küche dieselbe Küche bleibt. Wenn die Schränke zwischen Panels ihre Farbe wechseln, empfinden Leser die Szene als diskontinuierlich, auch wenn sie nicht genau benennen können, weshalb.
Die technische Lösung in CharaConsist ist eine Vordergrund-Hintergrund-Maske, die aus Aufmerksamkeitsunterschieden abgeleitet wird. Sie ermöglicht eine „entkoppelte Steuerung von Vordergrund- und Hintergrundkonsistenz“: Du kannst eine Szene für eine fortlaufende Sequenz fixieren oder sie absichtlich für einen Ortswechsel freigeben. Die meisten Consumer-Tools stellen diese Steuerung nicht bereit. Der praktische Ausweg besteht deshalb darin, einen etablierenden Hintergrund separat zu erzeugen und ihn über die gesamte Sequenz hinweg als Bildreferenz wiederzuverwenden.
Welche Zielkonflikte sind zu erwarten, wenn du eine Figur festlegst?
Jeder Konsistenzgewinn kostet etwas. Die beiden häufigsten Kosten sind geringere Prompt-Reaktionsfähigkeit und weniger Szenenvielfalt. Wer das versteht, vermeidet den frustrierenden Kreislauf, die Einschränkungen zu verschärfen und sich dann zu fragen, warum das Modell Anweisungen nicht mehr befolgt.
Konsistenz gegenüber Prompt-Treue. Die CharaConsist-Ablationsstudie ist hier ungewöhnlich offen: Die Anwendung der Konsistenzmethode auf FLUX.1 senkte den CLIP-T-Wert für Textausrichtung gegenüber dem Basismodell. Die Präferenztests ergaben für Textausrichtung 57 % – den schwächsten Wert aller gemessenen Dimensionen. Eine starke Referenzverankerung zieht die Generierung zur Referenz und weg von deinen neuen Anweisungen.
Referenzbias gegenüber Winkelvielfalt. Frontale Referenzen maximieren die spätere Wiederverwendbarkeit, verzerren das Modell aber auch in Richtung frontaler Ausgaben. Ein echtes Dreiviertel- oder Aufsichtspanel aus einer frontal fixierten Figur zu erzeugen, bedeutet, gegen diesen Anker anzukämpfen.
Statische Genauigkeit gegenüber Action. Konsistenz-Benchmarks werden typischerweise mit relativ komponierten Szenen gemessen. Comics brauchen Bewegung, und genau dort verortet das CharaConsist-Paper ausdrücklich den Leistungsabfall.
Einrichtungsinvestition gegenüber Flexibilität. LoRA- und Adapter-Pipelines in ComfyUI bieten das höchste Potenzial, doch Praktiker betonen die praktische Belastung. Ein Workflow-Autor beschreibt den Vorteil, nicht „jede Figuren-Checkpoint-Datei speichern“ zu müssen – was nahelegt, dass die meisten Workflows genau das verlangen.
Was sagen Praktiker darüber, wo diese Technologie tatsächlich steht?
Der Konsens unter Menschen, die Produktionsworkflows für Comics entwickeln, lautet: Referenzverankerung hat den Großteil des Problems gelöst; die verbleibenden Fehler konzentrieren sich auf Bewegung und Kleidung.
„Das mentale Modell, das die meisten Menschen zu AI-Comics mitbringen, ist schon ab dem ersten Panel falsch. Sie halten den Prompt für ein Spezifikationsblatt, das das Modell liest und ausführt. Das ist er nicht – er ist eine Sampling-Beschränkung. Wenn du ‚rothaariger Detektiv‘ schreibst, verringerst du den Raum möglicher Gesichter von Milliarden auf Millionen, nicht auf eines. Jedes Panel ist eine neue Ziehung aus diesem eingegrenzten Raum. Sobald Kreative das verinnerlichen, schreiben sie nicht mehr Prompts um, sondern bauen Referenz-Assets auf – und das Problem löst sich weitgehend auf.“
„Was Menschen überrascht, ist, dass Gesichter der einfache Teil waren. Für die Gesichtsfixierung gibt es über mehrere Architekturen hinweg leistungsfähige, gut trainierte Lösungen. Kleidung ist der hartnäckige Teil, weil sie mehr Freiheitsgrade als ein Gesicht besitzt und es viel weniger Trainingssignale für ihre Bewahrung gibt. In unseren eigenen Tests behält eine Figur ihr Gesicht über eine Sequenz von zwölf Panels hinweg, während die Jacke unauffällig dreimal ihren Kragen verändert. Wir raten Kreativen, das Outfit als benannte Einheit mit festem Vokabular zu behandeln – konkret ein eingerissenes linkes Ärmelbündchen – statt als allgemeine Beschreibung. Markante, benennbare Details bleiben erhalten; generische Details nicht.“
„Die ehrliche Einschränkung, die niemand bewirbt, ist Action. Konsistenz-Benchmarks laufen mit relativ komponierten Einstellungen. Comics bestehen nicht aus komponierten Einstellungen – sie zeigen Menschen mitten im Schlag, im Sturz oder im Sprint. Genau dort verliert jede aktuelle Methode ihren Halt. Wenn du eine Kampfszene planst, kalkuliere Iterationen ein und erwäge, die Sequenz an einem einzigen weiten Establishing Panel zu verankern, statt zu erwarten, dass acht unabhängige Action-Panels zusammenpassen.“
— Jenova Product Team, 6 Jahre Erfahrung mit Workflows für mehrpanelige AI-Generierung
Welcher Ansatz passt zu deiner Situation?
Das passende Tool hängt von drei Variablen ab: deinem technischen Know-how, der benötigten Panelzahl und der Frage, ob Story-Generierung genauso wichtig ist wie Bildgenerierung.
Wähle einen allgemeinen Bildgenerator, wenn du nur wenige eindrucksvolle Bilder benötigst und visuelle Inkonsistenz akzeptieren kannst oder Konzeptkunst statt sequenzieller Erzählung produzierst. Midjourney bleibt die stärkste Option für reine Bildästhetik.
Wähle ComfyUI mit IP-Adapter und ControlNet, wenn du Zugriff auf eine GPU, technische Geduld und Bedarf an maximaler Kontrolle hast – insbesondere wenn du genug Material produzierst, um das Training eines Figuren-LoRA zu rechtfertigen. Die FaceID Plus V2 Workflows sind der aktuelle praktische Standard.
Wähle eine Referenz-Asset-Plattform, wenn du wiederholt mit einer festen Besetzung produzierst und zentrale Asset-Verwaltung möchtest. Figma Weave eignet sich für Teams, die Figurenstandards teilen; LTX Studio für video-nahe Arbeit; ComicInk für schnelle End-to-End-Comicerstellung.
Wähle Jenovas Comic Creator, wenn deine Engstelle die Story ebenso sehr wie die Kunst ist: Der Agent übernimmt Skript, Panel-Aufteilung und Generierung in einem Gesprächsfaden, während der Sitzungsspeicher Figurendefinitionen über lange Projekte hinweg weiterträgt. Das Tool ist unter jenova.ai/a/comic-creator verfügbar. Für vertikale Scroll-Formate übernimmt der Webtoon Creator Episodenstruktur und Scroll-Rhythmus; der Manga Creator deckt monochrome Panel-Konventionen ab. Auch hier gilt die ehrliche Einschränkung: Extreme Action-Posen und komplexe Panels mit mehreren Figuren erfordern weiterhin Iterationen, und die Plattform bietet nicht die Vordergrund-Hintergrund-Maskierungssteuerung, die Methoden auf Forschungsniveau bereitstellen. Der kostenlose Tarif enthält begrenzte Nutzung; Plus kostet 20 $ monatlich bei 30× diesem Umfang.
Welchen Weg du auch wählst: Das zugrunde liegende Prinzip ist identisch. Figurenkonsistenz ist ein Asset-Management-Problem im Kostüm des Prompt Engineerings. Erstelle zuerst die Referenz, benenne jedes markante Detail, verwende immer dieselben Wörter und akzeptiere, dass Action-Panels zusätzliche Versuche kosten werden.
Quellen
- CharaConsist: Fein abgestimmte Generierung konsistenter Figuren – ICCV-2025-Paper mit Benchmark-Daten und Studie zu menschlichen Präferenzen
- CharaConsist GitHub Repository – offizielle Implementierung und Hardwareanforderungen
- LTX Studio – So erstellst du eine konsistente AI-Figur, einschließlich der vier technischen Einschränkungen der AI-Generierung
- OpenAI Developer Community – Bedarf an Figurenkonsistenz und Stilfixierung in der Bildgenerierung
- ComicInk – Beste AI-Comicgeneratoren 2026, mit Vergleich von Generierungsansätzen
- Figma Weave – AI-Generator für konsistente Figuren, knotenbasierter Konsistenzansatz
- Medium – Wie ich Figurenkonsistenz in ComfyUI nach Versuchen mit ControlNet und IPAdapter gelöst habe
- RunComfy – IPAdapter FaceID Plus V2 Workflow für konsistente Figuren
- Medium – Umgang mit allen Faktoren der Figurenkonsistenz in Midjourney
- Community-Diskussion darüber, warum Frisur, Kieferlinie und Hautton bei der AI-Figurengenerierung abdriften