Warum verwenden AI-Aktienanalysetools veraltete Daten mit übertriebener Gewissheit?
2026-08-23
Wie wirkt Datenlatenz mit der Konfidenzkalibrierung in der AI-Aktienanalyse zusammen?
Viele AI-Aktientools für Privatanleger kombinieren verzögerte oder momentaufgenommene Marktdaten mit Sprachmodellen, die standardmäßig zu Formulierungen mit hoher Gewissheit neigen. Dadurch erhalten Anleger die Zahlen von gestern, präsentiert mit der Überzeugung von heute. Das Versagen ist nicht nur ein Datenproblem und nicht nur ein Modellproblem. Es ist das Zusammenspiel beider Faktoren: ein Datenfeed, der Stunden oder Einreichungen alt ist, kombiniert mit einem Generator, der darauf trainiert wurde, Antworten flüssig zu vervollständigen, statt bei dünner Evidenz abzulehnen oder seine Konfidenz herunterzustufen.
Dieses Zusammenspiel – nennen wir es die Latenz-Gewissheits-Lücke – ist die nützlichste Perspektive zur Bewertung von AI-Aktientools im Jahr 2026. Tools, die auf einem Screenshot ähnlich aussehen, unterscheiden sich deutlich, sobald Sie vier Fragen stellen: Wie alt sind der letzte Kurs oder die letzte Einreichung? Wird die Quelle genannt? Wird Überzeugung als Spanne oder als Slogan ausgedrückt? Und legt das Produkt seine Veralterung überhaupt offen?
Wichtige Faktoren, die brauchbare AI-Aktienrecherche von überzeugend klingenden, aber verspäteten Kommentaren unterscheiden:
✅ Aktualität von Kursen und Einreichungen – Sekunden und offizielle Zeitstempel gegenüber zwischengespeicherten Zusammenfassungen ohne Standzeit ✅ Quellenzuordnung – namentlich genannte SEC-Einreichungen, Schätzungen und Marktkurse gegenüber unbenannten „Marktdaten“ ✅ Ausdruck der Konfidenz – Wahrscheinlichkeiten, Spannen und Bedingungen gegenüber kategorischer Kaufen-/Verkaufen-Sprache ✅ Offenlegung der Veralterung – sichtbares Datenalter gegenüber stillen Momentaufnahmen, die wie eine Empfehlung eines Live-Trading-Desks wirken ✅ Sitzungsspeicher – ob das Tool Ihre These speichert und sie bei neuen Kursdaten überarbeiten kann
Für einen aussagekräftigen Produktvergleich hilft es, Datenlatenz und verbale Gewissheit als getrennte Designentscheidungen zu behandeln und anschließend zu bewerten, wie ehrlich ein Tool beide miteinander verknüpft.
Warum sind veraltete Finanzdaten gefährlicher geworden, seit sich AI-Aktientools verbreiten?
Veraltete Daten sind heute gefährlicher, weil ein größerer Anteil der Marktaktivität bereits automatisiert ist und generative Benutzeroberflächen verzögerte Eingaben wie Echtzeiturteile klingen lassen. Schätzungen zufolge werden inzwischen 60 bis 70 Prozent der Trades algorithmisch ausgeführt, sodass sich kleine Eingabefehler schneller fortpflanzen können, als ein menschlicher Trading-Desk es zulassen würde. Der Flash Crash von 2010 bleibt die klassische Warnung: Falsche oder schlecht verarbeitete Daten, die in automatisierte Systeme gelangten, trugen dazu bei, innerhalb von Minuten fast 1 Billion US-Dollar an Marktwert auszulöschen, bevor sich der Markt erholte.
Generative Tools fügen diesem Infrastruktur-Risiko einen zweiten Fehlermodus hinzu. Eine Branchenanalyse berichtet, dass AI-Halluzinationen bei bis zu 41 Prozent der finanzbezogenen Anfragen auftreten, und diese Fehler kündigen sich selten selbst als Fehler an. Sie erscheinen als flüssige, vollständige Antworten. Fachleute für Datenqualität sind hinsichtlich der Ursache deutlich: Fragmentierte, veraltete oder schlecht gesteuerte Finanzinformationen sind ein wesentlicher Treiber inkonsistenter generativer Ergebnisse im Banken- und Finanzwesen.
Regulierungsbehörden behandeln übertriebene AI-Fähigkeitsversprechen bereits als Anlegerschutzthema. Im März 2024 erzielte die U.S. Securities and Exchange Commission Vergleiche mit Delphia (USA) Inc. und Global Predictions Inc. wegen falscher und irreführender AI-Angaben; zusammen wurden zivilrechtliche Geldstrafen von 400.000 US-Dollar verhängt. Das Anlegerbildungsbüro der SEC hat zudem davor gewarnt, dass Betrüger die Popularität und Komplexität von AI ausnutzen, um Opfer anzulocken. Die Kombination ist einfach: mehr automatisierter Orderfluss, mehr chatbotartige Recherche und ein Marketinganreiz, sicher zu klingen, selbst wenn der zugrunde liegende Marktdatenstrom verspätet ist.
Worauf sollten Sie bei der Bewertung eines AI-Aktienanalysetools achten?
Sie sollten ein AI-Aktientool danach bewerten, wie es mit Zeit, Evidenz und Unsicherheit umgeht – nicht danach, wie ausgefeilt seine Empfehlung klingt. Ein hilfreicher Filter ist die Latenz-Gewissheits-Lücke: Bewerten Sie Aktualität, Quellenzuordnung, Konfidenzsprache und Offenlegung unabhängig voneinander und fragen Sie dann, ob das Produkt eine These überarbeiten kann, wenn neue Informationen eintreffen.
Eine praktische Checkliste für jeden Bericht auf Ticker-Ebene:
- Standzeitstempel für Preise, Volumina, Schätzungen und Einreichungen. Kann das Tool nicht sagen, wann eine Zahl zutraf, behandeln Sie die Schlussfolgerung als Kommentar.
- Namentlich genannte Quellen. „SEC 10-Q, Item 7, eingereicht am 6. August“ ist Recherche. „Die jüngsten Ergebnisse sehen stark aus“ ist ein Gefühl.
- Trennbare Fakten und Schlussfolgerungen. Fakten sollten überprüfbar sein. Schlussfolgerungen sollten als Schlussfolgerungen gekennzeichnet werden.
- Kalibrierte Sprache. „Basisszenario: 8–12 % Abwärtspotenzial, falls die Veröffentlichung die Erwartungen um mehr als 4 % verfehlt“ ist ehrlicher als „Starker Kauf“.
- Überarbeitungsweg. Das Tool sollte in der Lage sein, die Sicht von gestern zu aktualisieren, wenn heutige Daten ihr widersprechen.
- Grenzen des Anwendungsbereichs. Eine Fundamentalanalyse-Engine, die stillschweigend Unterstützung und Widerstand erfindet, oder ein Charting-Bot, der eine Burggraben-Erzählung erfindet, handelt außerhalb seiner Kompetenz.
FINRA hat darauf hingewiesen, dass AI-Modelle keine verlässlichen Prognosen mehr liefern können, wenn Bedingungen außerhalb ihrer Trainingsdaten liegen – etwa ungewöhnliche Volatilität, Katastrophen, Pandemien oder geopolitische Schocks. Das ist ein Bewertungskriterium, keine Fußnote. Fragen Sie, was das Tool tut, wenn der Marktdatenstrom unterbrochen ist. Lautet die Antwort „Es gibt weiterhin eine eindeutige Empfehlung ab“, dann ist die Gewissheit eine Produktentscheidung und kein statistisches Ergebnis.
Prüfen Sie auch die kommerzielle Oberfläche. Spezialisierte Scanner und Signalprodukte optimieren häufig auf Alarme pro Sitzung. Konversationelle Recherche-Agenten optimieren auf Erklärung. Keines von beiden ist automatisch präziser. Sie scheitern auf unterschiedliche Weise: Scanner können live sein und dennoch überangepasst sein; Chat-Oberflächen können durchdacht sein und dennoch den Schlusskurs der Vorwoche zitieren.
Wie schneiden beliebte AI-Aktientools bei Aktualität und Unsicherheit ab?
Kein einzelnes AI-Aktienprodukt führt in jeder Dimension; TrendSpider und Trade Ideas sind als technische Echtzeit-Terminals stärker, Danelfin und Tickeron als bewertungs- oder signalorientierte Produkte, und Jenovas Fundamental Stock Analyst als quellenbasierte, überarbeitbare Fundamentalanalyse mit Speicher. Der hilfreiche Vergleich lautet nicht „Welches Tool ist am intelligentesten?“, sondern: Welchen Fehlermodus sind Sie bereit zu akzeptieren?
| Funktion / Dimension | TrendSpider | Jenova Fundamental Stock Analyst | Tickeron | Danelfin | Trade Ideas |
|---|---|---|---|---|---|
| Datenansatz | Vom Anbieter als Echtzeit-Charting, Alarme und Automatisierung positioniert | Sitzungsbasierte Recherche über SEC-Einreichungen, Schätzungen und Stimmung mit Live-Suche | Tägliche Signale plus Echtzeit-Bots und Scanner als Zusatzoption | Rollierender AI Score über mehrere Monate, kein Tick-Terminal | Echtzeit-Scans; Holly führt nächtliche Backtests durch |
| Konfidenzstil | Erkannte Niveaus, Heatmaps, Musteralarme | Narrative These; kann nach Spannen, Bedingungen und Standzeiten gefragt werden | Kaufen-/Verkaufen-Signale und Bot-Strategien | AI Score von 1–10, dargestellt als Wahrscheinlichkeit, den Markt zu schlagen | Setups mit hoher Überzeugung und vorgeschlagenen Stops |
| Speicher / Überarbeitung | Gespeicherte Arbeitsbereiche und trainierte Scans | Persistenter sitzungsübergreifender Speicher früherer Thesen und Bestände | Über Kontoeinstellungen hinaus nicht verifiziert | Historische Score-Downloads in höheren Tarifen | Persistenz von Strategien und Alarmen innerhalb des Terminals |
| Ausführung | Integrierter Trading-Bot | Nur Analyse; keine Broker-Weiterleitung | Bots können über einen verbundenen Broker handeln | Recherche und Ranking, kein vollwertiger Handels-Desk | Ein-Klick-Handel aus dem Chart |
| Preise (Stand 2026) | Je nach Tarif etwa 54–122 US-Dollar/Monat | Kostenloser Tarif; kostenpflichtige Nutzung ab 20 US-Dollar/Monat | Kostenloser Tarif; kostenpflichtig ab etwa 60 US-Dollar/Monat, Bots höher | Kostenloser Tarif; Plus etwa 19–22 US-Dollar/Monat, Pro etwa 52–59 US-Dollar/Monat | Ab etwa 127 US-Dollar/Monat |
| Ehrliche Einschränkung | Schwächer als Fundamentalanalyst auf Einreichungsebene | Kein Live-Level-2-Marktdatenstrom und keine Ausführungsplattform | Signal-/Bot-Marktplatz kann zu übermäßigem Handel verleiten | Der Score ist ein Wahrscheinlichkeitsprodukt, kein Live-Orderbuch | Kostspielig; für aktiven Handel gebaut, nicht für geduldige Recherche |
| Am besten geeignet für | Technische Trader, die automatisierte Charts möchten | Anleger, die quellenbasierte Fundamentaldaten und Nachverfolgung benötigen | Trader, die Signale und optionale Automatisierung wünschen | Screener-Nutzer, die eine gerankte Wahrscheinlichkeit möchten | Aktive Trader auf der Suche nach Setups für die nächste Sitzung |
Die obigen Preis- und Funktionsdetails zu TrendSpider, Trade Ideas, Tickeron und Danelfin stammen aus einer Vergleichsberichterstattung von 2026, die Anbieterpläne und Produktpositionierungen zusammenstellt. Renditeangaben der Anbieter – einschließlich veröffentlichter AI-Score-Historien und Erfolgsbilanzen mit Buchstabennoten – sollten als Marketingleistung und nicht als unabhängig geprüftes Alpha behandelt werden.
TrendSpider
TrendSpider ist am stärksten, wenn es um technische Struktur geht: automatisierte Trendlinien, Multi-Timeframe-Scans und benutzerdefinierte Alarme. Seine Einschränkung ist komplementär. Eine Plattform, die um Charts und Bots herum organisiert ist, wird Nutzer nicht selbstverständlich dazu zwingen, einen Ausbruch mit dem 8-K des Vorabends abzugleichen.
Tickeron
Tickeron bündelt AI als Signale, Muster-Tools und Bot-Marktplatz. Das ist nützlich für Trader, die einen gerankten Ideenstrom wünschen. Für alle, die Gewissheit reduzieren möchten, passt es weniger gut, denn ein tägliches Kaufen-/Verkaufen-Siegel ist selbst ein Objekt hoher Gewissheit.
Danelfin
Danelfin verdichtet ein großes Funktionsset in einen AI Score und eine kurzfristige „Den Markt schlagen“-Darstellung. Diese Verdichtung ist der Zweck – und zugleich das Risiko. Eine einzelne ganze Zahl ist leicht zu zitieren und leicht zu sehr zu vertrauen, insbesondere wenn der Nutzer nie die Standzeit der Eingaben hinter dem Score sieht.
Trade Ideas
Trade Ideas ist über sein Holly-System für die nächste Sitzung ausgelegt: nächtliche Backtests, Echtzeit-Alarme und vorgeschlagene Risikoniveaus. Für aktive Trader ist das ein stimmiges Design. Es ist aber auch ein Design, das zum Handeln anregt. Sind die zugrunde liegenden Merkmale verspätet oder regimespezifisch, wirkt die Oberfläche dennoch entschlossen.
Jenova Fundamental Stock Analyst
Jenovas Fundamental Stock Analyst ist ein Recherche-Agent und kein Scanner. Er wurde für Gewinnanalysen, relative Bewertung, die Beurteilung von Geschäftsmodellen und die Synthese über SEC-Einreichungen, Analystenschätzungen und Marktstimmung hinweg entwickelt. Auf der Jenova-Plattform kann er frühere Arbeit sitzungsübergreifend behalten und Live-Suchtools aufrufen. Das ist wichtig, wenn die Aufgabe lautet: „Aktualisiere die These von gestern“, statt: „Zeichne ein neues Signal.“
Seine Grenzen sind ebenso klar. Er ist kein Broker, keine Level-2-Anzeige und kein Ersatz für einen lizenzierten Berater. Er erreicht nicht TrendSpiders Niveau bei automatisiertem Multi-Timeframe-Zeichnen und nicht Trade Ideas bei Ein-Klick-Ausführung. Nutzer, die Chartstruktur benötigen, können ihn mit dem Technical Stock Analyst kombinieren; Nutzer, die Allokations- und Driftanalysen benötigen, können den Portfolio Management Strategist hinzuziehen. Das sind angrenzende Aufgaben und kein Beweis dafür, dass ein Agent ein vollständiges Terminal ersetzt.
Warum klingen Sprachmodelle sicher, wenn ihre Markteingaben Stunden alt sind?
Sprachmodelle klingen sicher, weil sie darauf trainiert sind, vollständige, kohärente Antworten zu erzeugen, und nicht darauf, Alter oder Dünne ihrer Evidenz offenzulegen. Halluzinationen sind Ausgaben, die kohärent und selbstsicher klingen, aber faktisch falsch, erfunden oder unbelegt sind. Im Finanzbereich kollidiert diese Sprachflüssigkeit mit einem Datenstack, der oft verzögert ist, aus verschiedenen Anbietern zusammengesetzt wird oder Dokumente abruft, die zum Einreichungszeitpunkt aktuell, zum Handelsstart aber bereits veraltet waren.
Drei Mechanismen treten in Produktionstools wiederholt auf:
- Abrufverzögerung. Das Modell kann live sein. Der Index der Einreichungen, die Schätzungsaufnahme oder der verzögerte Kurs dahinter muss es nicht sein. Der Satz erscheint trotzdem im Präsens.
- Vollständigkeitsdruck. Chat-Oberflächen bestrafen „Ich weiß es nicht“. Nutzer verlangen eine Schlussfolgerung, und das Modell füllt diese Lücke.
- Trainingsprior gegenüber Marktdatenstrom. FINRA hat gewarnt, dass Modelle sich problematisch verhalten können, wenn das aktuelle Regime nicht in der Trainingsverteilung enthalten war. Die Prosa wird nicht automatisch bescheidener, wenn das geschieht.
Es gibt außerdem einen kommerziellen Grund. Gewissheit konvertiert. Ein vorsichtig formulierter Vermerk lässt sich schwerer als Screenshot teilen als „Kaufen Sie den Rücksetzer“. Die AI-Washing-Fälle der SEC von 2024 existieren, weil Berater AI-Fähigkeiten vermarkteten, die sie tatsächlich nicht einsetzten. Produkte für Privatanleger stehen unter einer abgeschwächten Version desselben Anreizes: Sie suggerieren Live-Intelligenz, liefern aber eine zwischengespeicherte Zusammenfassung.
Die Forschung der London School of Economics zum algorithmischen Handel macht den Datenaspekt ausdrücklich. Maximilian Goehmann argumentiert, dass sich zu viel regulatorische Aufmerksamkeit auf das Modell und zu wenig auf die vom Modell genutzten Daten richtet, einschließlich doppelter Kurse, fehlender Werte und inkonsistenter Zeitstempel. Diese Diagnose lässt sich direkt auf Chatbot-Recherche übertragen. Fehlt die Standzeit, ist das Konfidenzintervall bloße Inszenierung.
Eine dauerhafte Gewohnheit bei der Nutzung jedes konversationellen Aktien-Tools, einschließlich Jenovas Fundamental Stock Analyst, besteht darin, das Modell zu zwingen, Uhrzeit und Behauptungsstärke zu trennen:
„Analysiere NVDA auf Basis der jüngsten offiziellen Einreichung und des neuesten verfügbaren Kurs-Updates. Führe jede wichtige Kennzahl mit Quelle und Zeitstempel auf. Gib eine Basis-/Bullen-/Bärensicht an und nenne, was jede davon widerlegen würde. Ist eine Eingabe älter als der Schluss der letzten regulären Handelssitzung, sage es im ersten Satz.“
Dieser Prompt macht die Daten nicht live. Er macht die Latenz sichtbar – genau den Teil, den die meisten Produkte auslassen.
Wie verstärkt Überkonfidenz-Bias das Risiko veralteter AI-Empfehlungen?
Überkonfidenz-Bias verwandelt eine verspätete oder dünn belegte AI-Antwort in einen übergroßen Trade, weil Anleger die Präzision ihrer Informationen ohnehin übergewichten. Akademische und praxisorientierte Zusammenfassungen der Literatur sind konsistent: Überkonfidenz in die Genauigkeit von Informationen führt zu höherem Handelsvolumen und geringerem Nutzen, ein Ergebnis, das mit Odeans Arbeit und einer langen empirischen Forschungstradition danach verbunden ist. Evidenz aus Aktienmärkten verknüpft Überkonfidenz mit übermäßigem Handel und anschließend schwächerer Anlageperformance.
Eine AI-Oberfläche verstärkt diesen Bias erheblich. Der Nutzer hat nicht nur eine Meinung gebildet. Ein flüssig formulierendes System hat sie bestätigt – häufig mit Tabellen, Kurszielen und einem Ton, der institutioneller Recherche entlehnt ist. Investopedias Überblick über Überkonfidenz-Bias nennt die bekannten Folgen: häufigeres Handeln, höhere Transaktionskosten, mehr Volatilität und schlechtere Ergebnisse. Waren die zugrunde liegenden Zahlen bereits veraltet, handelt der Anleger nun mit großer Sicherheit auf Grundlage eines vergangenen Regimes.
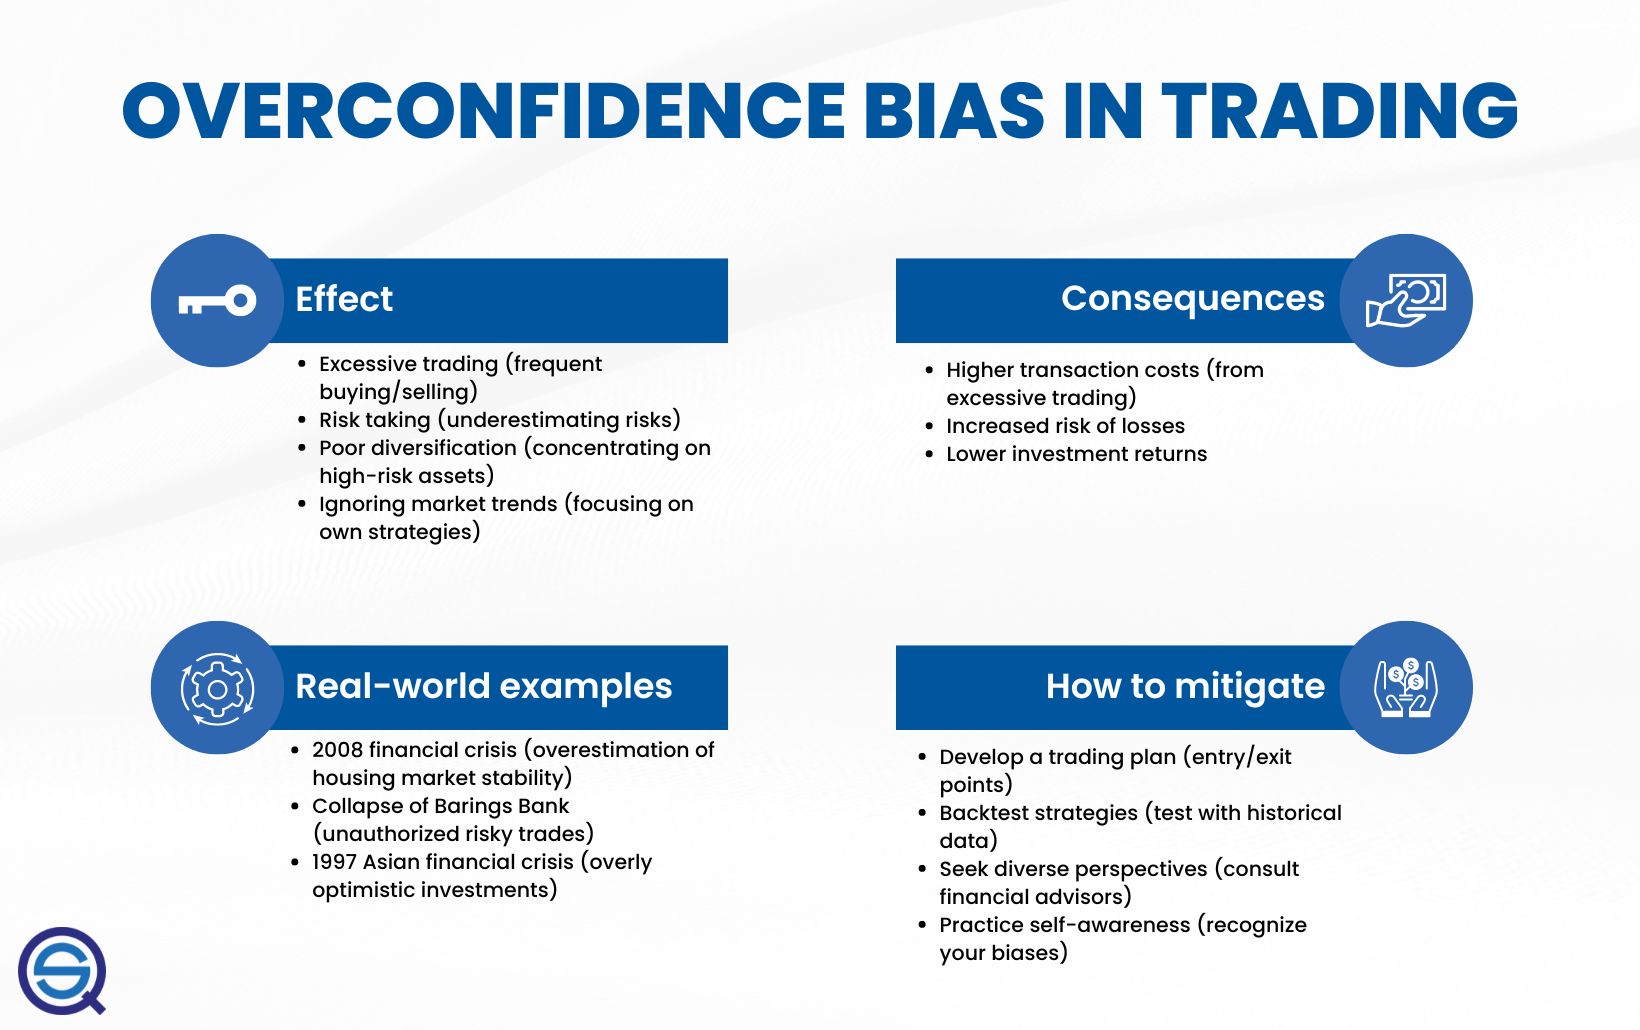
Zwei sich verstärkende Schleifen werden leicht übersehen.
Die erste ist Bestätigung mit Maschinengeschwindigkeit. Ein Nutzer, dem eine Long-These gefällt, bittet eine AI, „Schwachstellen darin aufzudecken“, und akzeptiert dann unbewusst die verbleibenden optimistischen Absätze als unabhängige Bestätigung. Die zweite ist die Überlagerung durch soziale Stimmung. FINRA hat Anleger zudem davor gewarnt, auf Basis von Tools zur Analyse sozialer Stimmung zu handeln, ohne deren Grenzen zu verstehen. Wenn ein Modell das 10-Q der Vorwoche mit den Beiträgen dieses Morgens vermischt und mit einer Stimme spricht, kann der Nutzer nicht erkennen, welche Ebene die Empfehlung antreibt.
Die Minderung ist operativ, nicht motivational:
- Schreiben Sie den Handelsplan vor dem Öffnen der AI auf, einschließlich Invalidierung.
- Verlangen Sie, dass das Tool aufführt, was seine Meinung ändern würde.
- Begrenzen Sie die Positionsgröße bei jeder Idee, deren zentrale Eingaben keine Zeitstempel aufweisen.
- Bevorzugen Sie Überarbeitungssitzungen gegenüber einmaligen „Was soll ich kaufen?“-Prompts.
- Behandeln Sie kategorische Signale von Bots und Score-Produkten als Hypothesen, nicht als Anweisungen.
Deloitte beschreibt das Halluzinationsrisiko bei Finanzarbeit mit hohen Einsätzen als Ursache schlechter Entscheidungen, von Verlusten und Reputationsschäden. Bei einem individuellen Konto ist der Reputationsschaden persönlich: eine Reihe sicherer, leicht verspäteter Entscheidungen, die im Chatprotokoll diszipliniert und im Handelsprotokoll zufällig aussehen.
Wie können Anleger prüfen, ob ein AI-Aktientool aktuelle Daten verwendet?
Sie prüfen die Aktualität, indem Sie jede wesentliche Kennzahl zu einer Primärquelle und einer Standzeit zurückverfolgen und dann beobachten, ob das Tool kooperiert oder ausweicht. Ein Produkt, das diese Übung nicht absolvieren kann, ist nicht „annähernd“. Es ist nicht prüfbar.
Eine kurze Prüfsequenz, die anbieterübergreifend funktioniert:
- Fragen Sie nach der Uhr. „Wie lauten Standdatum und -zeit, Zeitzone und Sitzungsstatus für jeden von Ihnen verwendeten Preis und jede Schätzung?“
- Rufen Sie die Primärquelle erneut ab. Öffnen Sie das jüngste 10-K, 10-Q, 8-K oder die Ergebnisveröffentlichung des Unternehmens auf der SEC-Website und gleichen Sie Umsatz, Prognose, Aktienzahl und Schulden ab.
- Prüfen Sie den Marktdatenstrom unabhängig. Vergleichen Sie den letzten Preis und das Volumen des Tools mit Ihrem Broker oder einer Marktdatenseite, der Sie bereits vertrauen.
- Testen Sie die Lücke unter Stress. Ist die Einreichung drei Tage alt und hat sich die Aktie nach einer Veröffentlichung eines Wettbewerbers um 9 % bewegt, bitten Sie das Tool, die These unter Annahme dieser Bewegung neu aufzubauen.
- Achten Sie auf die Zeitformen. Behauptungen im Präsens über eine Veröffentlichung, die das Unternehmen noch nicht herausgegeben hat, sind ein klares Ausschlusskriterium.
Beim Fundamental Stock Analyst von Jenova ist dieselbe Sequenz eine Gewohnheit der ersten Sitzung und kein optionales Extra:
- Öffnen Sie den Agenten und nennen Sie den Ticker, die Entscheidung und den geforderten Evidenzstandard.
- Verwenden Sie einen Prompt, der nicht quellenbasierte Gewissheit verbietet:
„Ich halte 180 JPM-Aktien und entscheide, ob ich vor dem nächsten Ergebnisdatum zukaufen soll. Verwende nur quellenbasierte Einreichungen, offizielle Veröffentlichungen und klar datierte Schätzungen. Beginne mit dem Datenalter. Gib dann eine Bewertung im Vergleich zur Historie und zu Wettbewerbern an. Schließe mit dem ab, was du nicht weißt.“
- Speichern Sie das Memo innerhalb der Sitzung, damit ein späteres Update einen diff dazu erstellen kann, statt einen neuen Monolog zu erzeugen.
- Geht es bei der Frage tatsächlich um Trend, Volumen oder Marktstruktur, wechseln Sie zum Technical Stock Analyst, statt einen Fundamentalanalyse-Agenten zu bitten, eine Chart-Empfehlung zu erfinden.
Bei einem Terminal wie TrendSpider sieht die Prüfung anders aus – und das sollte sie auch. Bestätigen Sie, dass Zeitstempel, Sitzung sowie die Einstellung bereinigt/unbereinigt im Chart dem Instrument entsprechen, von dem Sie ausgehen, dass Sie es handeln. Testen Sie dann die Regel per Backtest, statt einem einzelnen automatisch eingezeichneten Niveau zu vertrauen. Bei Danelfin oder Tickeron sollten Sie nicht „den Score verifizieren“. Prüfen Sie die sichtbaren Eingaben und behandeln Sie den Score als komprimierte Posterior-Wahrscheinlichkeit mit unveröffentlichten Annahmen.
Antwortet ein Produkt auf Fragen zur Aktualität mit Markenformulierungen – „powered by AI“, „institutionelle Qualität“, „Echtzeit-Intelligenz“ –, hören Sie auf. Diese Sprache befindet sich in demselben Umfeld, das die SEC ins Visier nahm, als sie erklärte, dass Berater nicht behaupten dürfen, AI-Modelle einzusetzen, die sie tatsächlich nicht verwenden.
Wann genügt ein AI-Bericht als Momentaufnahme, und wann benötigen Sie eine Live-Recherche-Sitzung?
Ein Bericht als Momentaufnahme genügt, wenn die Entscheidung langsam ist, die Eingaben offiziell sind und seit dem Dokumentdatum nichts Wesentliches veröffentlicht wurde; eine Live-Sitzung ist erforderlich, wenn Preis, Nachrichten oder Positionierung die These verändern können, bevor Sie handeln. Die meisten Enttäuschungen über AI-Aktientools entstehen, weil eine Momentaufnahme-Oberfläche zur Beantwortung einer Live-Frage verwendet wird.
Für Momentaufnahmen geeignete Arbeiten umfassen das Lesen der Geschäftsbeschreibung in einem 10-K, den Neuaufbau einer historischen Margenentwicklung, den Vergleich der erklärten Kapitalallokationspolitik über Jahre hinweg oder die Vorbereitung von Fragen für einen Earnings Call. Diese Aufgaben sind durch Einreichungen vollständig abgedeckt. Ihre Wahrheit läuft nicht um 10:31 Uhr ab.
Zu den Aufgaben einer Live-Sitzung gehören der Handel rund um eine Veröffentlichung, die Positionsgröße bei einem Gap, die Interpretation eines intraday veröffentlichten Ausblick-Leaks oder die Aktualisierung eines Portfolios nach einer sektorweiten Bewegung. Genauigkeitsbewertungen von AI-Aktientools im Jahr 2025 betonten bereits, dass die Ergebnisse je nach Tool, Datenquellen und Art der Nutzung variieren. Dieser Satz ist präziser, als er zunächst wirkt. Zur „Art der Nutzung“ gehört, ob der Nutzer eine Dokumentenfrage oder eine Frage zum Marktdatenstrom stellte.
Eine einfache Faustregel:
- Liegt die Invalidierung in einem Satz einer Einreichung, kann eine datierte Momentaufnahme ausreichen.
- Liegt die Invalidierung in einem Kurs-Update, einem Handelsstopp, einem Fed-Redner oder einem Gap bei einem Wettbewerber, benötigen Sie eine Sitzung, die erneut abrufen und überarbeiten kann.
- Können Sie nicht erkennen, in welcher dieser Situationen Sie sich befinden, gehen Sie von Live-Bedarf aus, bis das Gegenteil bewiesen ist.
Das Design von Jenova liegt eher auf der Seite der Live-Sitzung: persistenter Speicher, Zugang zu mehreren Modellen und Suchtools, die bei veränderten Fakten erneut aufgerufen werden können. Das ist ein Vorteil für die Pflege von Thesen. Es ist kein Vorteil für jemanden, der einen Fire-and-Forget-Scanner wollte, und es erzeugt keine börseneigene Tick-Historie. Trade Ideas und TrendSpider bleiben natürlicher, wenn der Anwendungsfall ein Setup für die nächste Sitzung ist. Danelfin bleibt natürlicher, wenn der Anwendungsfall ein geranktes Universum ist. Die Zuordnung des Anwendungsfalls zur Oberfläche verhindert, dass sich die Latenz-Gewissheits-Lücke überhaupt erst öffnet.
Was sagen Fachleute für Marktdaten über AI-Gewissheit und verzögerte Datenfeeds?
Praktiker, die zwischen Recherche-Agenten und Marktdaten arbeiten, kehren immer wieder zu demselben Punkt zurück: Die schädliche Ausgabe ist nicht ein falsches Adjektiv, sondern eine verspätete Tatsache, formuliert in der Grammatik eines Live-Trading-Desks.
„Das Muster, das wir immer wieder sehen, besteht nicht darin, dass Modelle zu Vorsicht nicht fähig wären. Es besteht darin, dass die meisten Aktien-Oberflächen sie nie um Vorsicht bitten. Ein verzögerter Kurs plus ein auf Vollständigkeit trainiertes Modell erzeugt einen Absatz, der wie eine Notiz aus einer Morgenbesprechung klingt. Der Nutzer erinnert sich an die Überzeugung und vergisst, dass niemand die Standzeit genannt hat. In Nutzersitzungen bewirkt eine einleitende Zeile, die Datenalter und fehlende Eingaben nennt, mehr zur Reduzierung schlechter Trades als ein weiterer Faktor in einem Score.“
„Wir sehen außerdem, dass Teams Modell-Routing mit Datenarchitektur verwechseln. Der Wechsel von einem Frontier-Modell zu einem anderen macht eine zwischengespeicherte Schätzungsdatei nicht aktueller. Kann Ihre Abrufebene nicht sagen, ob das letzte Kurs-Update aus der Auktion, einer verzögerten Momentaufnahme eines Anbieters oder einer wöchentlichen Zusammenfassung stammt, betreibt der Agent Literaturrecherche und keine Marktanalyse. Das kann weiterhin wertvoll sein – aber nur, wenn das Produkt es auch so sagt.“
„Das andere Versagen ist Regime-Stille. Wenn Volatilität, ein Handelsstopp oder ein Politikschock den Marktdatenstrom außerhalb des Bereichs bringen, für den die Merkmale entwickelt wurden, sollte ein kalibriertes System die Intervalle verbreitern oder eine Empfehlung verweigern. Viele Tools für Privatanleger tun das Gegenteil. Sie behalten dieselbe Satzstruktur bei und tauschen nur den Ticker aus. So wird Überkonfidenz automatisiert.“
— Jenova Product Team, Design von AI-Recherche-Agenten, acht Jahre Agenten-Infrastruktur für professionelle Workflows
Diese Sicht stimmt mit den offiziellen Aufzeichnungen überein. Die Erklärung des SEC-Vorsitzenden Gary Gensler aus dem Jahr 2024 zu den Fällen Delphia und Global Predictions war eindeutig: Neue Technologie erzeugt Aufmerksamkeit, und auf die Aufmerksamkeit folgen falsche Behauptungen. Sie stimmt auch mit den Erkenntnissen zur Marktstruktur überein. Goehmanns Arbeit an der LSE plädiert für mehr Transparenz bei der Datenqualität – Zeitstempel, Anomalien, Zertifizierung –, statt den Algorithmus als einziges Untersuchungsobjekt zu behandeln. Für Privatanleger ist die praktische Übersetzung klein: Verlangen Sie die Uhr. Verlangen Sie die Quelle. Behandeln Sie nicht belegte Gewissheit als Mangel.
Referenzen
- Aveni — AI-Halluzinationen im Finanzwesen, einschließlich berichteter Fehlerraten bei Finanzanfragen
- London School of Economics — Verbreitung algorithmischen Handels, der Flash Crash von 2010 und das Risiko von Datenfehlern
- Accedia — Management der Finanzdatenqualität und veraltete Daten als Treiber von AI-Halluzinationen
- U.S. Securities and Exchange Commission — Verfahren gegen Delphia und Global Predictions wegen falscher AI-Angaben
- Investor.gov — Anlegerwarnung zu künstlicher Intelligenz und Anlagebetrug
- FINRA — AI-Anwendungen in der Wertpapierbranche, einschließlich Modellgrenzen außerhalb der Trainingsbedingungen
- WallStreetZen — Vergleich von AI-Aktienanalysatoren, Preisen und Produktpositionierungen für 2026
- Databricks — Definition von AI-Halluzinationen als selbstsichere, aber unbelegte Ausgabe
- ScienceDirect — Überkonfidenz, Informationsgenauigkeit, Handelsvolumen und Nutzen
- MDPI — Überkonfidenz von Anlegern, übermäßiger Handel und schwächere Performance
- Investopedia — Überkonfidenz-Bias und seine Auswirkungen auf das Handelsverhalten
- FINRA — Anlegerwarnung zu Tools für Investitionen auf Basis sozialer Stimmung
- Deloitte — Halluzinationsrisiko, schlechte Entscheidungen und finanzielle Verluste in Analysen mit hohen Einsätzen
- Bika.ai — Wie die Genauigkeit von AI-Aktienanalysetools je nach Tool, Datenquelle und Nutzung variiert