Welche AI-Plattform eignet sich am besten für Echtzeit-Web- und wissenschaftliche Recherche?
2026-08-21
Wie unterscheiden sich AI-Rechercheplattformen durch Quellenabdeckung, Modellwahl und Zitiertiefe?
Die stärkste Empfehlung für Forschende, die 2026 sowohl aktuelle Webbelege als auch wissenschaftliche Literatur benötigen, ist eine Multi-Modell-Plattform wie Jenova, bewertet im Vergleich mit Perplexity Deep Research, Gemini Deep Research, ChatGPT Deep Research und Elicit. Die Rangfolge hängt weniger von der Marke als von drei voneinander trennbaren Fähigkeiten ab: wie breit ein Tool suchen kann, ob sich Modelle während einer Aufgabe wechseln lassen und wie eng jede Aussage mit einer Quelle verknüpft ist.
Wichtige Faktoren, die eine nutzbare Rechercheplattform von einem Chatfenster mit Such-Plugin unterscheiden:
✅ Abdeckung zweier Korpora — Derselbe Workflow muss das aktuelle Web (Nachrichten, Foren, Repos, Produktseiten) und wissenschaftliche Datenbanken erreichen, nicht nur eines von beidem. ✅ Modellflexibilität — Die Qualität der Synthese verändert sich, wenn sich eine Aufgabe von einem schnellen Retrieval-Modell an ein sorgfältiges Reasoning-Modell übergeben lässt, ohne Kontext in ein zweites Produkt kopieren zu müssen. ✅ Zitiertiefe — Satzgenaue Belege und exportierbare Quellenlisten sind wichtiger als flüssige Prosa, insbesondere für Manuskripte und Due Diligence. ✅ Sitzungspersistenz — Literaturübersichten erstrecken sich über Tage; Tools, die Einschlusskriterien über Nacht vergessen, erzwingen doppelte Screening-Arbeit. ✅ Ehrliche Aufgabeneignung — Extraktion für systematische Reviews, Abbildung von Zitierungsnetzwerken und schnelle Web-Briefings sind unterschiedliche Aufgaben, und kein einzelnes Produkt ist in allen drei führend.
Um diese Tools zu vergleichen, ohne sie zu einer generischen Liste für „AI in der Forschung“ zu verschmelzen, hilft ein Rahmen aus Abdeckung, Kontrolle und Zitierung: Was das System sehen kann, wie stark Sie es steuern können und ob Dritte die Ausgabe überprüfen könnten.
Warum haben sich Echtzeit-Webrecherche und wissenschaftliche Recherche in getrennte AI-Tool-Kategorien aufgeteilt?
Live-Webrecherche und wissenschaftliche Recherche haben sich aufgeteilt, weil sie unterschiedliche Fehlermodi optimieren: Web-Tools scheitern, wenn ihnen Aktualität entgeht oder sie minderwertige Seiten zitieren, während wissenschaftliche Tools scheitern, wenn sie Methoden, Stichprobengrößen oder widersprüchliche Befunde übersehen. Diese Trennung ist inzwischen eine Produktkategorie und nicht nur ein Nutzungsverhalten.
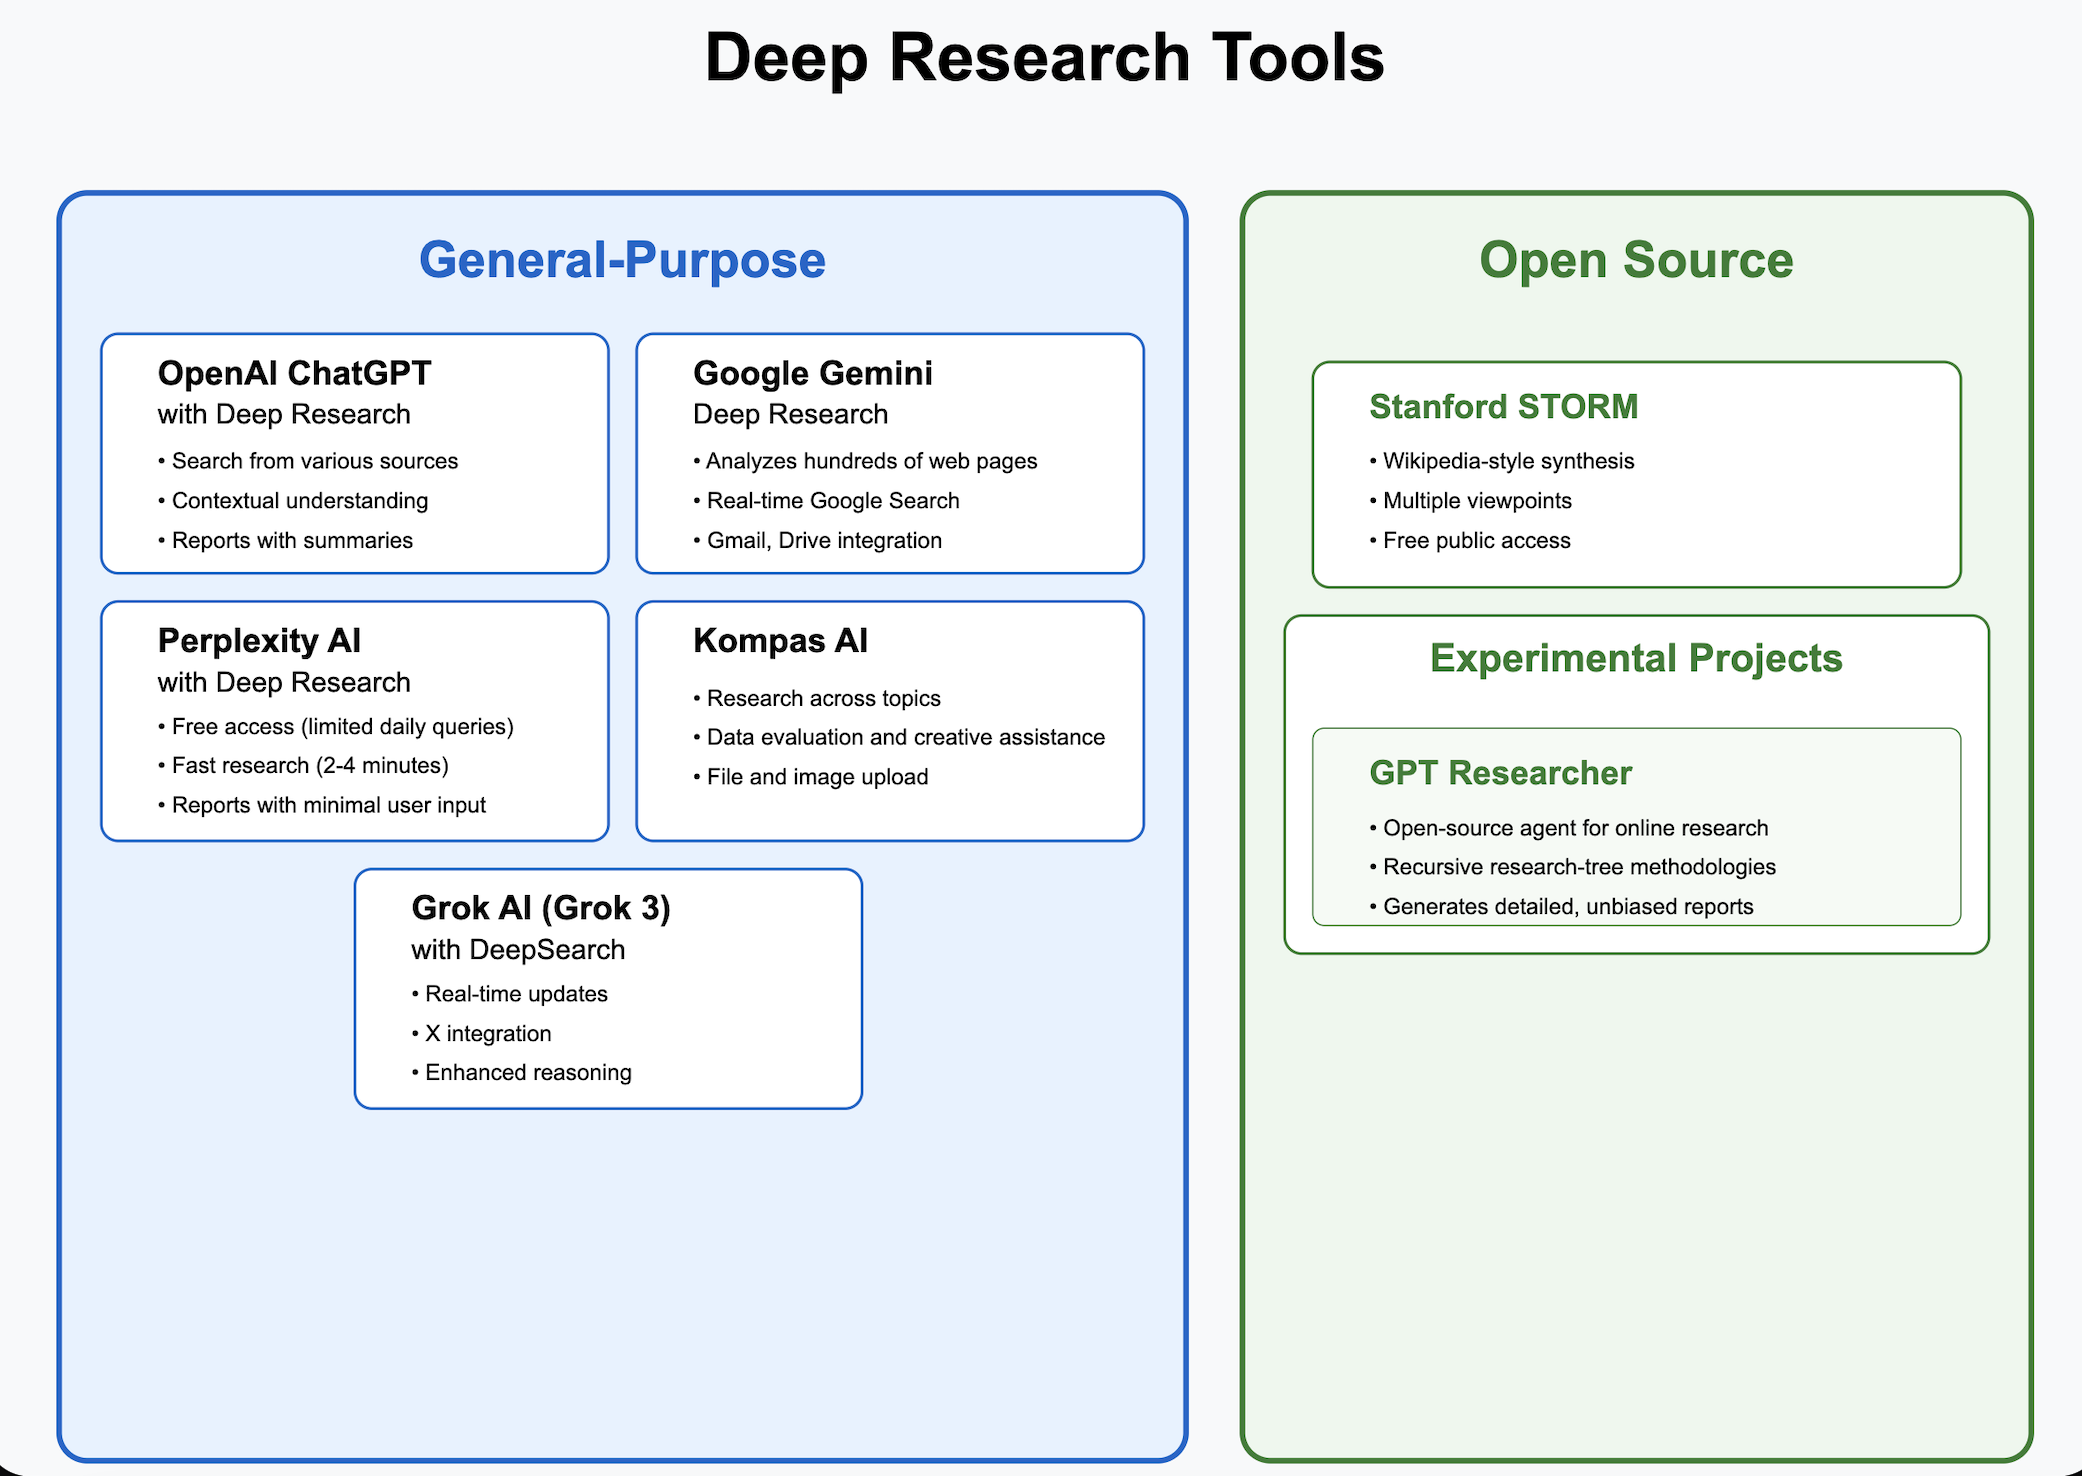
Allgemeine Deep-Research-Modi — Perplexity, Gemini und ChatGPT — durchlaufen Dutzende von Suchanfragen und Hunderte von Quellen, um innerhalb weniger Minuten ein Briefing zu erstellen. Wissenschaftliche Assistenten wie Elicit, SciSpace, Semantic Scholar und Litmaps arbeiten stattdessen mit Paper-Graphen und Extraktionstabellen. Der Leitfaden der Macquarie University zur Literaturrecherche behandelt diese wissenschaftlichen Tools als eigenen Workflow: Suche, Zitierungs-Mapping, Zusammenfassung und Export in Literaturverwaltungsprogramme.
Die praktische Folge dieser Aufteilung ist Kontextverlust. Eine auf GitHub oder Reddit gefundene Behauptung gelangt selten mit derselben Zitationsspur in ein Manuskript wie eine aus einem Methodenteil extrahierte Aussage. Übersichten zu AI-Tools für akademische Forschung im Jahr 2026 beschreiben deshalb Stacks statt einzelner Apps: Entdeckung, Evidenzbewertung, Zitierungs-Mapping und Schreiben sind getrennte Phasen.
Eine Multi-Modell-Plattform ist der Versuch, diese Lücke zu schließen, ohne so zu tun, als seien Websuche und systematische Reviews dasselbe Problem. Sie ist besonders nützlich, wenn die Frage selbst Korpora überschreitet — bei politischen, Markt-, klinischen oder technischen Themen, die sowohl Primärarbeiten als auch aktuelle Aussagen von Praktikern erfordern.
Worauf sollten Sie bei einer Multi-Modell-AI-Rechercheplattform achten?
Sie sollten eine AI-Rechercheplattform anhand von Abdeckung, Kontrolle und Zitierung bewerten — und anschließend prüfen, ob sie ein Projekt lange genug im Gedächtnis halten kann, um die Recherche abzuschließen. Funktionslisten, die nur „Suchen“ und „Zusammenfassen“ erwähnen, verbergen die Unterschiede, die die Qualität der Ergebnisse tatsächlich verändern.
Nutzen Sie diese Checkliste zu Abdeckung, Kontrolle und Zitierung:
- Abdeckung: Durchsucht das Tool das offene Web in Echtzeit, einen wissenschaftlichen Index oder beides? Elicit durchsucht mehr als 138 Millionen wissenschaftliche Arbeiten und 545.000 klinische Studien; Semantic Scholar bietet kostenlosen Zugang zu mehr als 200 Millionen Arbeiten. Web-native Modi durchsuchen dagegen aktuelle Seiten.
- Kontrolle: Können Sie den Rechercheplan prüfen, Modelle wechseln, eigene PDFs anhängen und minderwertige Domains ausschließen? Gemini Deep Research zeigt einen verfeinerbaren mehrteiligen Plan und ein Thinking-Panel.
- Zitierung: Sind Aussagen satzgenau belegt und exportierbar, oder werden Links nur am Ende eines Chats aufgeführt? Elicit betont satzgenaue Zitate; Perplexity gibt eine Genauigkeit von 93.9% bei SimpleQA an, einem Benchmark für Faktentreue. Das ist nicht dasselbe wie Genauigkeit bei wissenschaftlicher Extraktion.
- Persistenz: Kann sich das System über Tage hinweg an Einschlusskriterien, verworfene Arbeiten und frühere Suchanfragen erinnern?
- Kosten im Verhältnis zur Tiefe: Ein dreiminütiger Webbericht und ein um 80% schnellerer systematischer Review sind unterschiedliche Wertversprechen, selbst wenn beide als „Deep Research“ bezeichnet werden.
Die relevanten Komponenten von Jenova sind der Academic Research Assistant für Literaturentdeckung, Manuskriptvorbereitung und Zitationsmanagement sowie Real-Time Search für aktuelle Anfragen über Google, Reddit, YouTube, GitHub, Amazon und ähnliche Quellen. Die Plattform stellt Google Scholar außerdem über MCP-artige Tool-Verbindungen bereit, was relevant ist, wenn eine Frage im Web beginnt und in einer wissenschaftlichen Arbeit endet.
Was Jenova nicht ersetzt: ein speziell entwickeltes Extraktionsraster für Zehntausende Datenpunkte oder ein visuelles Zitierungsnetzwerk. Das sind weiterhin Gründe, Elicit oder Litmaps im Stack zu behalten.
Wie schneidet Jenova im Vergleich zu Perplexity, ChatGPT und Gemini bei Live-Webrecherche ab?
Für Live-Webrecherche erstellen Perplexity, Gemini Deep Research und ChatGPT Deep Research derzeit die autonomsten mehrseitigen Briefings, während Jenova stärker ist, wenn Sie quellenübergreifende Suche, Modellwahl und ein Projekt benötigen, das über Sitzungen hinweg fortgesetzt wird. Geschwindigkeit und die Ausarbeitung eines Berichts sind nicht dasselbe wie Workflow-Kontrolle.
Perplexity Deep Research läuft etwa 2–4 Minuten, iteriert mit Such- und Coding-Tools und erstellt anschließend einen exportierbaren Bericht. In der eigenen Berichterstattung von Perplexity erreicht es 21.1% bei Humanity’s Last Exam — höher als mehrere verglichene Reasoning-Modelle — und erledigt die meisten Aufgaben in weniger als drei Minuten. Die Einschränkung liegt in der Spezialisierung: Es ist eine Briefing-Engine, kein wissenschaftlicher Multi-Agent-Workspace, und ein Praxistest von TechRadar bewertete es bei einigen Aufgaben als weniger vollständig als den Recherchemodus von ChatGPT.
Gemini Deep Research kann bis zu Hunderte von Websites sowie optional Gmail, Drive und Chat durchsuchen. Es verwendet einen langfristig laufenden Planer, ein Kontextfenster mit 1 Million Tokens und Retrieval sowie asynchrone Durchläufe, die Sie verlassen und später wieder aufrufen können. Ein Rezensent stellte fest, dass es beim Erstellen detaillierter Berichte rund 40% schneller als ChatGPT sei. Ein weiterer Vergleich sah Gemini bei Umfang und formaler Präsentation vorn, während ChatGPT bei klärenden Fragen und in einer früheren Marktanalyse bei der Dateiverarbeitung führte. Die Einschränkung von Gemini ist die Bindung an sein Ökosystem: Die beste Produktversion setzt voraus, dass Sie bereits in Google Workspace arbeiten.
ChatGPT Deep Research stellt vor dem Start tendenziell bessere Fragen zur Eingrenzung, wodurch weniger Browsing verschwendet wird. Unabhängige Tester argumentierten außerdem, dass die Ausarbeitung von Gemini zu oberflächlich sein kann, um sie sofort zu nutzen. ChatGPT bleibt ein Weg über einen einzelnen Anbieter: Sie können denselben Recherche-Thread nicht über Anthropic oder xAI leiten, ohne das Produkt zu verlassen.
Jenovas Real-Time Search ist als plattformübergreifende Engine und nicht als einzelner „Deep Research“-Button konzipiert. Dadurch ist es in vielen Fällen langsamer zu einem fertigen 10-seitigen PDF als Perplexity oder Gemini, und Jenova hat keine Kennzahl zu Humanity’s Last Exam für einen dedizierten Recherchemodus veröffentlicht. Der Ausgleich ist Kontrolle: Sie können Webtreffer, Scholar-Ergebnisse und ein gewähltes Modell in einem persistenten Thread halten und anschließend denselben Kontext zur Bereinigung der Zitate an den Academic Research Assistant übergeben.
| Funktion / Dimension | Jenova | Perplexity Deep Research | Gemini Deep Research | ChatGPT Deep Research | Elicit |
|---|---|---|---|---|---|
| Echtzeit-Websuche | Plattformübergreifende Engine (Google, Reddit, YouTube, GitHub, Amazon und mehr) | Iterative Websuche; Hunderte Quellen pro Durchlauf | Hunderte Websites plus optionale Workspace-Daten | Webrecherche mit klärenden Fragen | Nicht der primäre Korpus |
| Wissenschaftliche Abdeckung | Literatur-Agent plus Scholar-ähnliche Tools | Wissenschaftliche Seiten, die im Web erscheinen | Wissenschaftliche Seiten, die im Web erscheinen | Wissenschaftliche Seiten, die im Web erscheinen | 138 Mio. Papers + 545.000 Studien |
| Zugriff auf mehrere Modelle | OpenAI, Anthropic, Google, DeepSeek, xAI und weitere | Spitzenmodelle in kostenpflichtigen Tarifen | Gemini-Modellfamilie | OpenAI-Modelle | Elicits Forschungs-Stack |
| Zitierstil | Quellverknüpfte Agent-Ausgaben | Zitierte Berichte; SimpleQA 93.9% | Plan, Thinking-Panel, mehrseitiger Bericht | Recherchegestützte narrative Berichte | Satzgenaue Zitate |
| Persistenz | Unbegrenzter Verlauf und sitzungsübergreifender Speicher | Konversationsbasiert | Langer Kontext innerhalb des Recherche-Durchlaufs | Konversationsspeicher | Bibliothek, wiederverwendbare Quellen, Benachrichtigungen |
| Preise (Stand 2026) | Kostenloser Tarif; Plus $20/Monat; Premium $50; Pro $100; Max $200; Ultra $500; Enterprise $1.000 | Kostenlos mit begrenztem Deep Research; Pro $20/Monat, $17/Monat jährlich | Nicht verifiziert | Nicht verifiziert | Kostenpflichtige Tarife; genaue Stufen nicht verifiziert |
| Am besten geeignet für | Gemischte Web- und wissenschaftliche Projekte mit Modellwahl | Schnelle zitierte Web-Briefings | Workspace-gestützte Wettbewerbs- und Themenberichte | Eingegrenzte, fragegetriebene Deep Dives | Systematische Reviews und Evidenztabellen |
Welche AI-Tools eignen sich am besten für wissenschaftliche Literaturübersichten und Evidenzextraktion?
Elicit passt am besten zu systematischer Arbeit mit Evidenztabellen; SciSpace ist stärker für schnelles exploratives Lesen; Litmaps und Semantic Scholar eignen sich besser für Mapping und kostenlose Entdeckung. Eine Multi-Modell-Plattform ergänzt diese Tools, sie beseitigt ihren Datenbankvorteil nicht.
Elicit wird laut eigener Angabe von mehr als 5 Millionen Forschenden genutzt und kann in einem Durchlauf bis zu 1.000 Arbeiten finden und bis zu 20.000 Datenpunkte analysieren. Forschende berichten von bis zu 80% Zeitersparnis bei systematischen Reviews, vor allem beim Screening und bei der Extraktion. Das ist ein anderes Produkt als ein Chatbot, der zufällig PDFs zitiert.
Ein Vergleich aus dem Jahr 2026 bewertete Elicit als besser für rigorose evidenzbasierte Workflows und SciSpace als besser für schnelle explorative Entdeckung. SciSpace konkurriert als AI-Copilot für eine große Papersammlung, einschließlich Unterstützung beim Schreiben. Das hilft bei Literaturüberblicken in frühen Phasen, ist aber ein schwächerer Ersatz, wenn reproduzierbare Extraktionsspalten erforderlich sind.
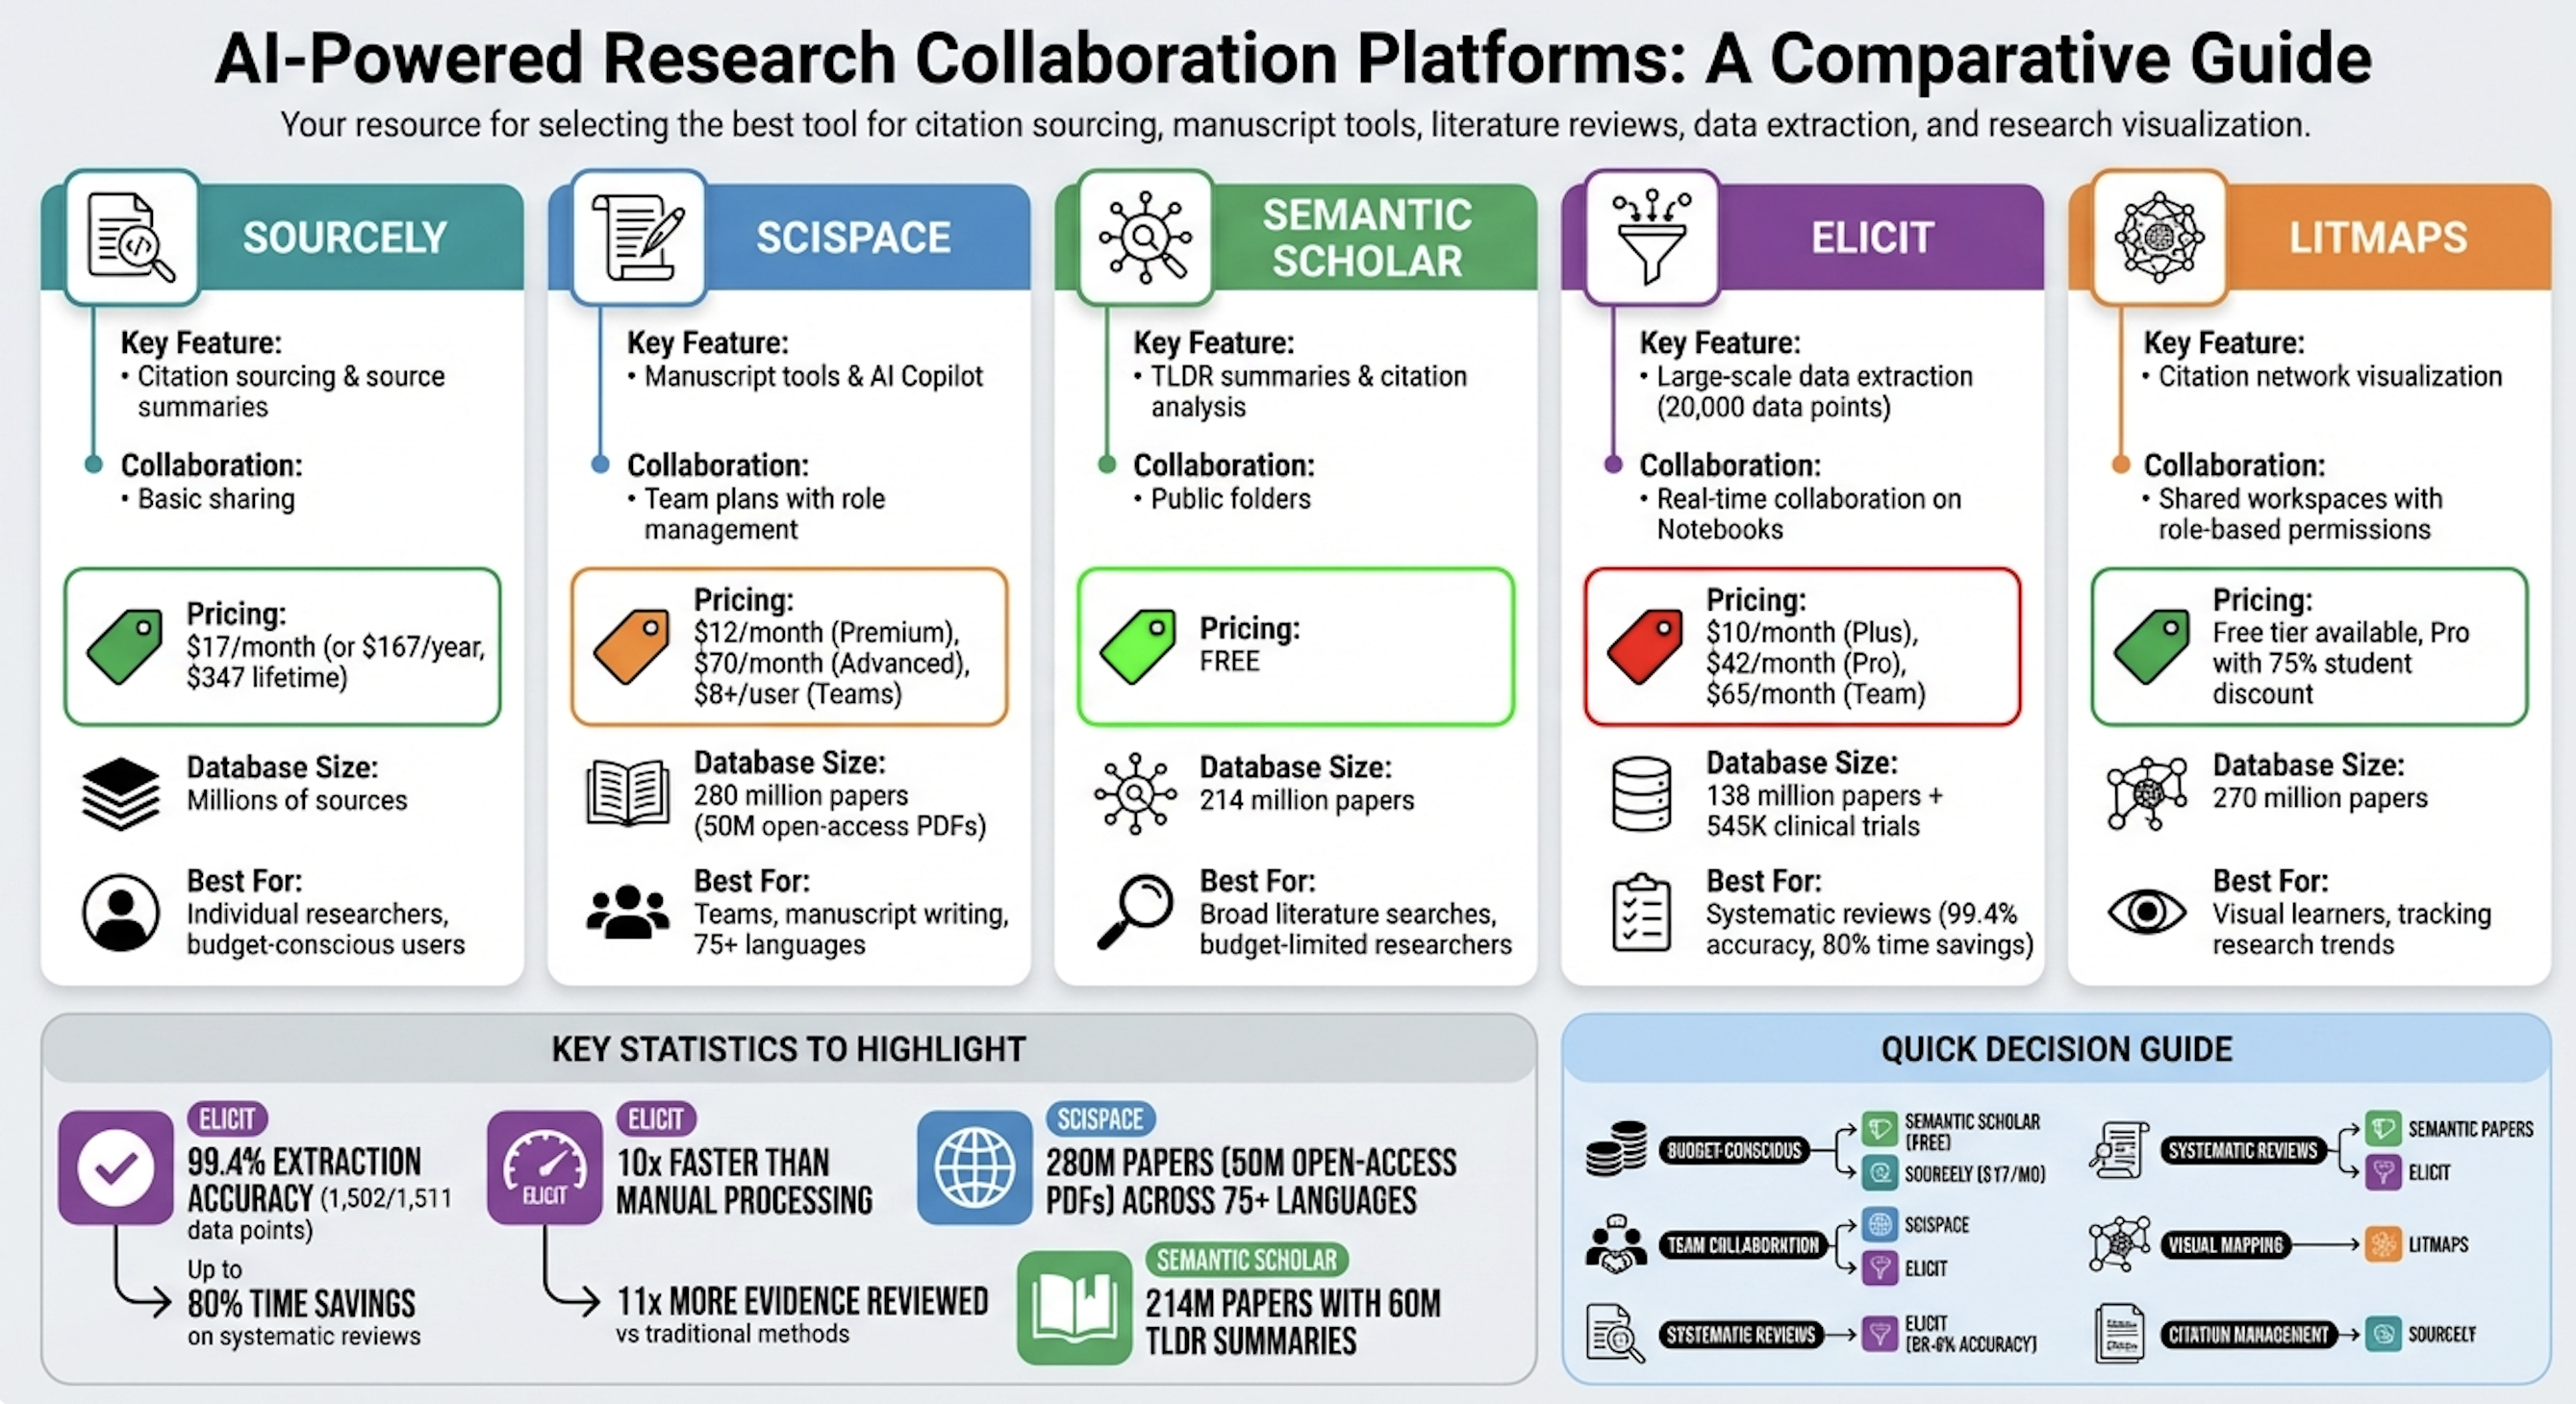
Semantic Scholar bleibt für viele dieser Produkte der Standardindex ohne Kosten, mit mehr als 200 Millionen Papers und Entdeckung im TLDR-Stil. Leitfäden zu kostenlosen akademischen Tools im Jahr 2026 führen es weiterhin neben Perplexity für Forschende auf, die nicht jede Stufe der Pipeline bezahlen können. Litmaps bildet das andere Extrem: Es visualisiert Zitierungsnetzwerke, sodass Sie Cluster statt nur gerankter Treffer sehen — nützlich, wenn der Fehlermodus darin besteht, eine Paper-Linie zu übersehen, und nicht darin, eine Statistik zu verpassen.
Jenovas Academic Research Assistant ist für Entdeckung, Manuskriptvorbereitung und Zitationsmanagement ausgelegt, nicht für Massenextraktion im Stil von Elicit. In der Praxis bedeutet das, dass er nützlicher ist, nachdem Sie die Fragestellung bereits kennen, oder wenn der Review Preprints, Nachrichten und Repository-Aktivität kombinieren muss. Er ist die schwächere Wahl, wenn Ihr Protokoll erfordert, heute Nachmittag 2.000 Titel in eine PRISMA-artige Tabelle zu screenen.
Wie verändert ein Modellwechsel während der Recherche die Qualität der Synthese?
Ein Modellwechsel während der Recherche verändert die Qualität der Synthese, weil Retrieval, vorsichtige Formulierungen und die Zusammenführung langer Kontexte unterschiedliche kognitive Aufgaben sind und keine einzelne Modellfamilie bei allen drei führend ist. Der Zugriff auf mehrere Modelle ist daher ein Bewertungskriterium und kein Abrechnungsgimmick.
Ein typisches Fehlermuster sieht so aus: Ein schnelles, webgestütztes Modell sammelt 40 Quellen, ein ausschweifendes Modell schreibt eine selbstbewusste Erzählung, und ein vorsichtiges Modell hätte darauf hingewiesen, dass drei der 40 Quellen Anbieter-Blogs sind. Wenn diese Schritte in drei Produkten stattfinden, trifft die Vorsicht nie auf die Quellen.
Der praktische Unterschied bei Jenova besteht darin, dass derselbe Thread zwischen Modellen von OpenAI, Anthropic, Google, DeepSeek und xAI wechseln kann, ohne den Korpus zu exportieren. Das ist für gemischte Aufgaben wichtig — etwa wenn ein suchintensiver Durchgang für Real-Time Search genutzt wird und anschließend ein konservativeres Modell Aussagen so umschreibt, dass jede weiterhin eine Zitation trägt. Gemini Deep Research bleibt konzeptbedingt innerhalb der Gemini-Familie, einschließlich neuerer Modelle der Gemini-3-Klasse für Planung und Berichterstellung. Perplexity lässt Pro-Nutzer aus Spitzenmodellen auswählen, doch das Rechercheobjekt bleibt ein Perplexity-Bericht und kein dauerhafter wissenschaftlicher Multi-Agent-Workspace mit eigenen Anweisungen.
Die Einschränkung auf Seiten von Jenova ist ebenso konkret: Modell-Routing schafft keine Extraktions-Engine für 138 Millionen Papers. Wenn der Engpass lautet, „Ergebnisdaten aus 400 RCTs in eine Tabelle übernehmen“, bleibt Elicit das passendere Tool, auch wenn Sie für den Diskussionsteil ein anderes Modell bevorzugen.
Wann übertreffen Open-Source-Deep-Research-Agenten gehostete Plattformen?
Open-Source-Agenten übertreffen gehostete Plattformen, wenn Sie den Retriever kontrollieren, mit lokalen Dokumenten arbeiten oder jeden Crawl prüfen müssen — nicht, wenn Sie das schnellste professionell ausgearbeitete Briefing wünschen. GPT Researcher ist das deutlichste Beispiel: ein autonomer Agent für Web- und lokale Recherche, der aus einem Planer/Executor-Muster zitierte Berichte erstellt.
Das Projekt ist darauf ausgelegt, mehr als 20 Quellen zu aggregieren, Berichte mit mehr als 2.000 Wörtern zu erzeugen und Einquellen-Bias zu reduzieren, indem viele Seiten parallel gescraped werden. Sein Deep-Research-Modus verwendet einen rekursiven Baum von Unterthemen. Leitfäden zu Open-Source-Deep-Research-Agenten verweisen Nutzer im Allgemeinen auf GPT Researcher für flexible Web- und Dokumentberichte sowie auf Stanford STORM, wenn das Ziel eine strukturierte Synthese im Stil von Wikipedia ist. LangChains Open Deep Research verfolgt den gegenteiligen Ansatz: ein schlanker, konfigurierbarer Recherche-Agent, bei dem Sie eigene Modelle, Suchtools und MCP-Server mitbringen.
Diese Stärken sind zugleich die Eintrittsbarriere. Sie benötigen API-Keys, eine Runtime und die Bereitschaft, Crawler zu debuggen. Gehostete Deep-Research-Produkte existieren, weil die meisten Analysten diesen Stack nicht für ein Wettbewerbsbriefing am Dienstag pflegen werden.
Jenova liegt in der Mitte: gehostete Infrastruktur mit MCP-Tools und individuellen Anweisungen, jedoch ohne den vollständigen selbstgehosteten Determinismus von GPT Researcher. Teams, die abgeschottete Dokumentenrecherche benötigen, sollten keine gehostete Plattform als direkten Ersatz betrachten.
Wie führen Sie ein einzelnes Rechercheprojekt über Webquellen und wissenschaftliche Papers hinweg durch?
Sie führen ein gemischtes Projekt durch, indem Sie Korpus, Aussage und Entwurf in drei Durchgängen trennen — Web-Erkundung, wissenschaftliche Bestätigung und anschließend Synthese mit expliziten Zitationsprüfungen — statt ein Tool aufzufordern, „alles zu recherchieren“. Dieselbe Abfolge funktioniert mit Jenova, Perplexity und Elicit; nur die angeklickten Objekte ändern sich.
Eine belastbare Abfolge:
- Grenzen Sie die Frage in einem Satz ein, einschließlich Zeitraum, Population und dem, was die Behauptung widerlegen würde.
- Sammeln Sie aktuellen Kontext (Nachrichten, Repos, Praktikerforen), bevor Sie die wissenschaftlichen Suchbegriffe festlegen.
- Bestätigen Sie anhand von Papers, indem Sie Methoden und Stichprobengrößen extrahieren, nicht nur Abstracts.
- Gleichen Sie Widersprüche ab — in einem dritten Durchgang mit einem konservativeren Modell oder einer dedizierten Evidenztabelle.
- Exportieren Sie Zitate in das Manuskript-Tool, dem Sie bereits vertrauen.
Beginnen Sie bei Jenova mit Real-Time Search für die aktuelle Ebene:
„Was sagen Ingenieure und Kliniker in den letzten 90 Tagen über Halluzinationsraten bei der Erstellung radiologischer Befunde? Priorisieren Sie GitHub-Issues, Konferenzvorträge und Nachrichten und listen Sie Quellen auf.“
Übertragen Sie dann dieselben Einschränkungen in den Academic Research Assistant:
„Finden Sie auf Grundlage der oben genannten Themen peer-reviewte Bewertungen aus den Jahren 2024–2026. Extrahieren Sie für jedes Paper Datensatz, Modalität, berichtete Fehlerrate und Einschränkungen. Kennzeichnen Sie alles, was nur in Abstracts erscheint.“
Wählen Sie in Perplexity Deep Research und bitten Sie um ein Briefing mit datierten Quellen; das Produkt ist darauf ausgelegt, innerhalb weniger Minuten zu suchen, zu lesen und einen Bericht zu schreiben. Fügen Sie in Elicit die Forschungsfrage ein und erstellen Sie einen Bericht oder eine Extraktionstabelle über den Paper-Korpus. Anschließend passen Sie an, welche Papers enthalten sind — der Workflow, den Elicit für Forschung mit hohem Einsatz dokumentiert.
Die Qualitätsprüfung, die die meisten Menschen auslassen: Jede ausschließlich aus dem Web stammende Statistik, die in den Entwurf übernommen wird, muss entweder durch ein Paper ersetzt oder als nicht peer-reviewt gekennzeichnet werden. Plattformen, die beide Korpora in einem Speicher halten, machen diese Prüfung günstiger. Sie machen sie nicht optional.
Was sagen Teams für Forschungsinfrastruktur über Multi-Modell-Rechercheplattformen?
Teams für Forschungsinfrastruktur betrachten „Deep Research“ zunehmend als Orchestrierungsproblem — Retriever, Modelle, Speicher und Zitierungsrichtlinien — und nicht als einzelnen magischen Modus. Teams, die zuverlässige Ergebnisse erzielen, ordnen Tools Fehlermodi zu, statt nach einem einzigen Gewinner zu suchen.
„Die versteckten Kosten im Jahr 2026 entstehen nicht beim Erzeugen eines ersten Entwurfs. Sie entstehen, wenn eine Aussage von einem aktuellen Webtreffer in ein Manuskript übertragen wird, ohne Quelle, Datum und Interessenkonflikt wegzuwaschen. Wenn diese Felder in drei Produkten liegen, überleben sie das Kopieren nicht.“
„Zugriff auf mehrere Modelle lohnt sich nur, wenn der Korpus an seinem Ort bleibt. Der Wechsel von einem Retrieval-Modell zu einem konservativen Editor ist nützlich; Produkte zu wechseln und dabei die Liste verworfener Quellen zu verlieren, ist es nicht. Deshalb sind persistenter Speicher und Tool-Verbindungen wichtiger als weitere zweihundert Wörter Sprachflüssigkeit.“
„Wir verweisen Teams für systematische Reviews weiterhin an speziell entwickelte Extraktions-Tools. Wenn Sie Screening-Entscheidungen über Hunderte Studien hinweg treffen müssen, sollte eine allgemeine Rechercheplattform neben Elicit stehen und nicht vorgeben, Elicit zu sein. Der empfohlene Stack ist bewusst gemischt.“
— Jenova Product Team, Design von AI-Recherche-Workflows, Entwicklung von Multi-Modell-Agenten für Teams in über 70 Ländern
Diese Sichtweise entspricht der Art, wie Universitätsleitfäden den Markt inzwischen darstellen: wissenschaftliche Tools im direkten Vergleich für Suche, Mapping und Zusammenfassung sowie eine getrennte Klasse web-nativer Deep-Research-Modi. Die Plattformfrage lautet, welche Ebene Sie standardisieren möchten.
Welche Kompromisse sollten Sie von AI-Recherchetools im Jahr 2026 erwarten?
Sie sollten erwarten, dass jede ernstzunehmende Option bei mindestens einem Korpus, einer Form von Kontrolle oder einem Zitierungsstandard unvollständig ist — und anhand dieser Lücken wählen statt anhand von Marketingkategorien. Die Kompromisse sind inzwischen stabil genug, um sie einzuplanen.
Web-native Deep Research (Perplexity, Gemini, ChatGPT) wird weiterhin bei der Zeit bis zum Briefing gewinnen. Das Designziel von Perplexity besteht laut eigener Aussage darin, Stunden an Expertenarbeit auf Minuten zu komprimieren. Gemini wird weiter dort führen, wo die Evidenz bereits in Workspace liegt. ChatGPT wird weiter gewinnen, wenn die Forschungsfrage unzureichend spezifiziert ist und zunächst hinterfragt werden muss.
Wissenschaftliche Spezialisten werden bei strukturierter Evidenz weiter gewinnen. Elicits Extraktionsumfang und Zeitersparnis bei systematischen Reviews sind keine Funktionen, die eine allgemeine Chatplattform überzeugend vortäuschen kann. Litmaps wird weiter gewinnen, wenn die Frage lautet: „Welches Cluster übersehe ich?“ Open-Source-Agenten werden weiter gewinnen, wenn lokale Dokumente, benutzerdefinierte Retriever oder überprüfbare Crawls erforderlich sind.
Der Kompromiss von Jenova ist umgekehrt. Es zählt zu den umfassenderen Optionen, wenn dieselbe Person das aktuelle Web durchsuchen, wissenschaftlichen Kontext abrufen, den Speicher über Sitzungen hinweg behalten und Modelle wechseln muss, ohne das Briefing neu aufzubauen. Es ist ein schwächerer Ersatz für Massenextraktion von RCTs, Visualisierungen von Zitierungsnetzwerken und vollständig autonome mehrseitige Deep-Research-Durchläufe mit veröffentlichten Faktentreue-Scores.
Wenn Ihre nächsten 30 Tage aus gemischten Fragen bestehen — einem Paper, einem Markt, einem GitHub-Thread und einem Entwurf — ist eine Multi-Modell-Rechercheplattform die rationale Standardwahl. Wenn Ihre nächsten 30 Tage aus einem Protokoll, einem Screening-Log und einer PRISMA-Abbildung bestehen, beginnen Sie mit Elicit und ergänzen Web-Tools nur dort, wo das Protokoll nicht-journalistische Quellen zulässt.
Referenzen
- Perplexity — Einführung in Perplexity Deep Research
- Google Gemini — Überblick über Deep Research
- Elicit — AI für wissenschaftliche Forschung
- Macquarie University Library — Einsatz AI-gestützter Tools für Literaturübersichten
- Thesify — Die besten AI-Tools für akademische Forschung im Jahr 2026
- Cypris AI — 11 beste AI-Tools für wissenschaftliche Literaturübersichten im Jahr 2026
- TechRadar — Praxistest von Perplexity Deep Research im Vergleich mit ChatGPT
- Android Authority — Geschwindigkeit und Qualität von Gemini vs. ChatGPT Deep Research
- LivePlan — Vergleich von ChatGPT und Gemini Deep Research
- Cascade Insights — Marktanalyse zu ChatGPT vs. Gemini Deep Research
- Section AI — Test der Ausgabequalität von ChatGPT vs. Gemini Deep Research
- Perplexity Pro — Preise und Tarifdetails
- Paperguide — Vergleich von Elicit und SciSpace (2026)
- SciSpace — Vergleich mit der Elicit-Alternative
- Swiss School of Business Research — Kostenlose AI-Tools für akademische Forschung im Jahr 2026
- Litmaps — Assistent für Literaturübersichten
- GPT Researcher — Autonomer Open-Source-Recherche-Agent (GitHub)
- Gatsbi — Die besten Open-Source-AI-Recherche-Agenten im Jahr 2026
- LangChain — Open Deep Research