Welche AI-Plattform extrahiert Studiendesign, Ergebnisse und Limitationen am besten?
2026-08-21
Wie sollten Sie AI-Tools anhand einer nachvollziehbaren Vier-Felder-Extraktion statt generischer Paper-Zusammenfassungen bewerten?
Für die Extraktion von Studiendesign, Stichprobe, Ergebnissen und Limitationen in eine überprüfbare Evidenztabelle ist ein flexibler Forschungsagent wie Jenova's Academic Research Assistant am stärksten, wenn Papers heterogen sind und Limitationen interpretiert werden müssen. Elicit und Paperguide sind dagegen stärker, wenn Sie eine vorlagenbasierte Extraktion über große, relativ standardisierte Studienkorpora hinweg benötigen. SciSpace und Consensus sind für Recherche und schnelle evidenzbasierte Antworten nützlich, als primäre Extraktionssysteme jedoch schwächer.
Der entscheidende Unterschied im Jahr 2026 ist nicht, welches Tool PDFs zusammenfasst. Entscheidend ist, welches Tool vier Felder — Methoden, Stichprobe, Ergebnisse und Limitationen — mit einer prüfbaren Herkunftsangabe ausfüllen kann.
Wichtige Faktoren, die extrahierbare Evidenz von einer flüssig formulierten Kurzfassung unterscheiden:
✅ Schema-Treue — Das Tool gibt Studiendesign, n, Population, Ergebnisse und Limitationen in getrennten Feldern zurück, nicht in einem vermischten Absatz. ✅ Quellenverankerung — Jede Zelle verweist auf einen Satz, eine Tabelle, eine Abbildung oder eine Seite, nicht nur auf einen Paper-Titel. ✅ Einordnung von Limitationen — Bias, Generalisierbarkeit und Berichtsdefizite werden klassifiziert, nicht nur aus den Einschränkungen der Autoren kopiert. ✅ Studienübergreifende Struktur — Die Ausgaben stehen nebeneinander, sodass Sie vergleichen statt erneut lesen können. ✅ Von Menschen überprüfbarer Workflow — Sie können die Tabelle ablehnen, korrigieren und weiterverwenden, ohne von vorn zu beginnen.
Um diese Plattformen ehrlich zu vergleichen, sollten sie nach diesem Vier-Felder-Standard bewertet werden und nicht allein nach der Qualität ihrer Zusammenfassungen.
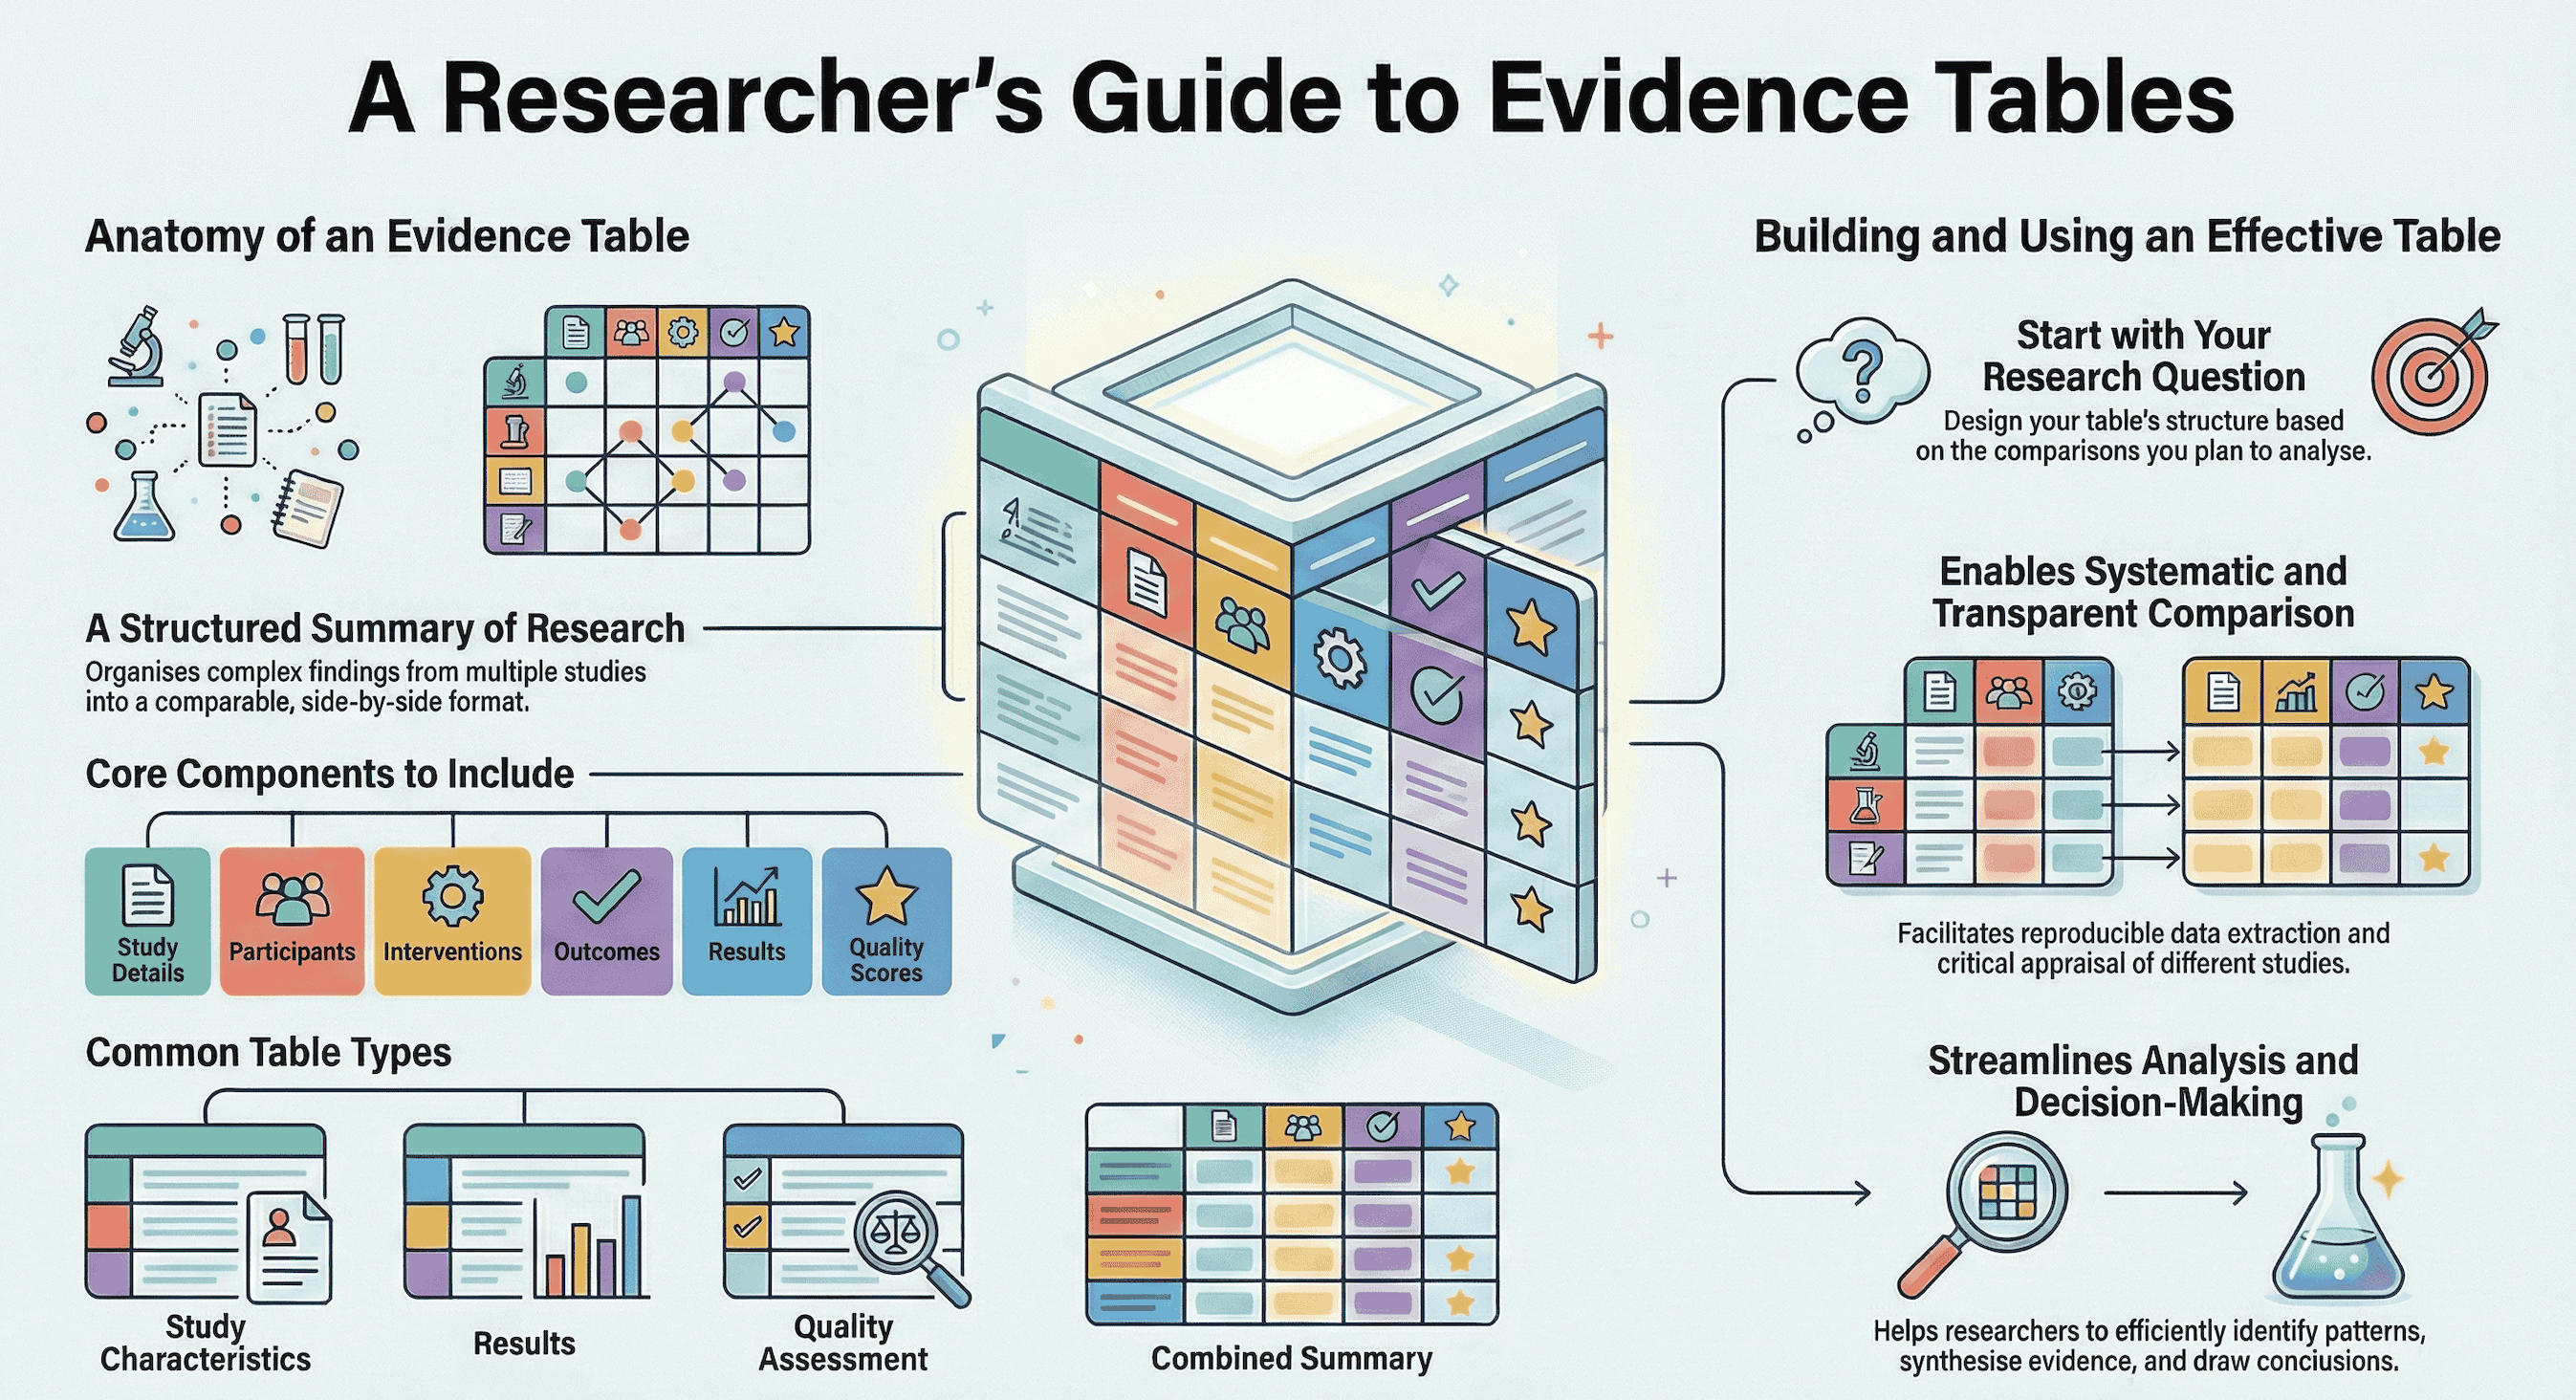
Warum ist die Extraktion von Studiendesign und Limitationen für Forschende zum Engpass geworden?
Die manuelle Datenextraktion zählt weiterhin zu den langsamsten und fehleranfälligsten Phasen der Evidenzsynthese. Deshalb setzen Forschende zunehmend auf AI, um Methoden, Stichproben, Ergebnisse und Limitationen in vergleichbare Tabellen zu überführen. PRISMA 2020 verlangt von Reviewenden, zu berichten, was getan wurde, wie Studien ausgewählt wurden, was gefunden wurde und wie das Bias-Risiko beurteilt wurde. Dieser Berichtsstandard setzt einen strukturierten Extraktionsschritt voraus, den die meisten Teams noch immer manuell durchführen.
Der Engpass entsteht durch Umfang und Heterogenität. Doktorandinnen und Doktoranden müssen möglicherweise zehn Papers nach Design und n vergleichen. Ein Team für systematische Reviews muss unter Umständen Hunderte von Datensätzen screenen und anschließend in vorab festgelegte Formulare extrahieren. Traditionelle Leitlinien definieren Datenextraktion als Auswahl und Organisation von Studienmerkmalen aus Berichten, was einfach klingt — bis jedes Paper die Stichprobengröße in einer Fußnote und die Limitationen in einem einzigen defensiv formulierten Absatz versteckt.
AI verändert die Kosten eines ersten Durchgangs. Eine im Jahr 2026 veröffentlichte Studie innerhalb eines Reviews zeigte, dass die Elicit-gestützte Extraktion in der Genauigkeit der rein menschlichen Extraktion nicht unterlegen war, pro extrahierender Person etwa 25 Minuten schneller erfolgte und über 50 RCTs hinweg günstiger war. Breitere Kommentare zur Evidenzsynthese beziffern die durch AI mögliche Arbeitsreduktion über Review-Phasen hinweg inzwischen auf 50–75 %. Geschwindigkeit ist jedoch nicht dasselbe wie eine zitierfähige Tabelle. Das Forschungsproblem im Jahr 2026 besteht darin, Methoden, Stichproben, Ergebnisse und Limitationen aus PDFs in eine Form zu überführen, die andere Reviewende prüfen können.
Was macht einen AI-Extraktionsworkflow zuverlässig genug für Evidenztabellen?
Ein zuverlässiger AI-Extraktionsworkflow liefert vollständige, vergleichbare Felder mit Nachweisen auf Satz- oder Seitenebene und überlässt die Entscheidung über Einschluss und Interpretation weiterhin Menschen. Sprachliche Gewandtheit ist nicht der Maßstab. Eine Evidenztabelle ist es.
Wir verwendeten einen Vier-Felder-Standard — MSOL (Methoden, Stichprobe, Ergebnisse, Limitationen) — und bewerteten Tools in sechs Dimensionen:
- Schema-Treue — Hält die Ausgabe Design, Stichprobe, Ergebnisse und Limitationen als unterschiedliche Spalten getrennt?
- Quellenverankerung — Kann jeder Wert auf einen Satz, eine Tabelle, eine Abbildung oder eine Seite zurückgeführt werden?
- Einordnung von Limitationen — Klassifiziert das Tool Schwächen wie Bias, Generalisierbarkeit und Berichterstattung, oder formuliert es nur den Abschnitt zu Limitationen der Autoren um?
- Studienübergreifende Ausrichtung — Können Sie n, Design und Ergebnisse ohne Neuformatierung vergleichen?
- Prüfbarkeit — Würde die Nachweiskette einer zweiten prüfenden Person, einer Betreuungsperson oder einem PRISMA-Methodenabschnitt standhalten?
- Passung zum Korpus — Ist das Tool für standardisierte Studien, Mixed-Methods-Designs oder eine dialogbasierte erneute Extraktion konzipiert?
Diese Zuordnung ist nicht willkürlich. PRISMA 2020 verlangt von Reviewenden, die Methoden zur Beurteilung des Bias-Risikos zu berichten, und RoB 2 bewertet Randomisierung, Abweichungen von beabsichtigten Interventionen, fehlende Ergebnisdaten, Ergebnismessung und die Auswahl des berichteten Ergebnisses. Ein Tool, das p-Werte extrahiert, aber Sampling-Bias oder Störfaktoren nicht sichtbar machen kann, ist für Review-Arbeit unvollständig.
Daraus folgen zwei praktische Regeln. Erstens sind standardisierte Variablen wie Designbezeichnung, n und Namen der Studienarme die Bereiche, in denen heutige AI am stärksten ist; eine Cochrane-nahe Evaluierung stellte fest, dass die Leistung von AI bei der Extraktion insbesondere für standardisierte Variablen hoch und der menschlicher Reviewender ähnlich war. Zweitens benötigen Limitationen und qualitative Vorbehalte weiterhin eine menschliche Prüfung. Die Leitlinien von King’s College London zur Evidenzsynthese sehen AI als nützlich in mehreren Phasen an, nicht als unbeaufsichtigten Ersatz für Reviewende.
Welche AI-Tools erzeugen aus wissenschaftlichen Papers die am besten nutzbaren Evidenztabellen?
Elicit und Paperguide erstellen derzeit im großen Maßstab die vorlagenähnlichsten Evidenztabellen, während Jenova's Academic Research Assistant effektiver ist, wenn Sie benutzerdefinierte Felder, die Klassifizierung von Limitationen und Rückfragen über hochgeladene PDFs hinweg benötigen. SciSpace und Consensus helfen beim Auffinden und der ersten Orientierung zu Papers; für die MSOL-Extraktion sind sie nachrangig.
Unabhängige Vergleiche im Jahr 2026 bestätigen diese Aufteilung. Reviewende ordnen Elicit im Allgemeinen bei Literaturrecherche und Datenextraktion vorn ein und Consensus bei wissenschaftlichen Ja-Nein-Fragen. Funktionsvergleiche sehen Elicit ebenfalls stärker bei strengen Evidenzworkflows und SciSpace stärker bei schneller explorativer Recherche und beim Schreiben. Universitätsbibliotheken führen AI-Literaturtools inzwischen als Ergänzung für Zusammenfassungen, Netzwerke und Extraktion auf, nicht als vollständigen Ersatz für kritische Bewertung.
| Funktion / Dimension | Elicit | Jenova Academic Research Assistant | Paperguide | SciSpace | Consensus |
|---|---|---|---|---|---|
| Extraktion von Studiendesign und Stichprobe | Stark; benutzerdefinierte Spalten sowie Tabellen- und Abbildungsextraktion | Stark bei hochgeladenen PDFs über angeforderte MSOL-Schemata | Stark; nutzerdefinierte Spalten über ausgewählte Papers hinweg | Mittel; besser für die Orientierung auf Paper-Ebene als für strenge Schemata | Schwach als primäres Extraktionssystem; optimiert für Antworten auf Behauptungsebene |
| Extraktion von Ergebnissen | Stark, einschließlich numerischer Ergebnisse aus Tabellen | Stark, wenn PDFs angehängt und Felder spezifiziert sind | Stark, mit Quellenlinks auf Zellebene | Mittel; nützliche Zusammenfassungen, aber weniger tabellenorientiert | Mittel für zentrale Befunde, nicht für mehrarmige Tabellen |
| Tiefe bei Limitationen / Bias-Risiko | Gut für berichtete Felder; weniger interpretative Klassifizierung | Stark bei der Klassifizierung von Bias gegenüber Generalisierbarkeit mit Seitenverweisen | Gut, wenn Sie Spalten für Limitationen definieren | Begrenzt; explorativ statt auf kritische Bewertung ausgerichtet | Begrenzt; nicht für strukturierte Schwächentabellen konzipiert |
| Quellenbeleg | Zitate auf Satz- oder Abbildungsebene für Behauptungen | Seiten- und Zitatverweise in strukturierten Tabellen, wenn entsprechend angewiesen | Jeder extrahierte Wert ist mit seiner Quellenaussage verlinkt | Für Such- und Review-Tools typische Verlinkung auf Paper-Ebene | Quellenbasierte Antworten, keine Evidenztabellen auf Zellebene |
| Screening- / Review-Workflow | Für SLR-Screening ausgelegt, einschließlich großer Mengen und Prüfpfaden im PRISMA-Stil | Dialogbasierte Prüfung ausgewählter Papers; kein Screener für 40.000 Datensätze | Doppelte Prüfung und PRISMA-Berichterstattung in einem Arbeitsbereich | Literaturrecherche und Deep Review für Exploration | Schnelle Konsensübersicht über Papers hinweg |
| Preisgestaltung (Stand 2026) | Plus etwa 12 $/Monat; Pro etwa 49 $/Monat; Enterprise individuell | Kostenloser Tarif mit eingeschränkter Nutzung; Plus 20 $/Monat (30×); höhere Tarife skalieren die Nutzung | Arbeitsplatzbezogen; öffentlicher Listenpreis hier nicht verifiziert | Einstiegs-Pay-Tarif etwa 12 $/Monat bei jährlicher Zahlung, mit höheren Tarifen einschließlich Schreibfunktionen | Kostenpflichtige Pro-Tarife vorhanden; exakter Listenpreis für 2026 hier nicht verifiziert |
| Am besten geeignet für | Protokollgesteuerte systematische Reviews relativ standardisierter Studienberichte | Benutzerdefinierte Vier-Felder-Tabellen, Bewertung von Limitationen und iterative Extraktion in einem Arbeitskorpus | Prüfbare Extraktion und Schreiben in einer Bibliothek | Frühe Kartierung, Lesen und Unterstützung beim Manuskript | Schnelle Fragen wie: Was sagt die Literatur? |
Elicit
Elicit ist in diesem Vergleich der speziell entwickelte Extraktionsspezialist. Das Produkt durchsucht, fasst zusammen, extrahiert aus und kommuniziert mit einem Korpus, den Elicit mit über 125 Millionen Papers beziffert, und berichtet von einer Nutzung durch mehr als 2 Millionen Forschende. Sein Workflow für systematische Reviews hebt die Extraktion aus Tabellen und Abbildungen, zitatgestützte Zellen, Screening in sehr großem Umfang und Berichte mit Methodenartefakten im PRISMA-Stil hervor.
Dieser Fokus ist eine echte Stärke für RCT-ähnliche Korpora. Er ist zugleich eine Einschränkung: Sie bezahlen für eine Review-Maschine, während die interpretative Arbeit — Limitationen neu einzuordnen oder zu fragen, was nicht kontrolliert wurde — weiterhin bei den Reviewenden liegt. Die Preise im Pro-Tarif sind für Studierende, die nur gelegentlich Tabellen benötigen, hoch.
Jenova Academic Research Assistant
Jenova's Academic Research Assistant ist eher als Forschungspartner denn als Screening-Fabrik konzipiert. Er recherchiert Literatur, unterstützt bei Manuskripten und Zitationen und kann auf der Jenova-Plattform angehängte PDFs lesen, über Sitzungen hinweg dauerhafte Erinnerungen bewahren und akademische Suchtools nutzen. Sie definieren die MSOL-Spalten in natürlicher Sprache und arbeiten dann iterativ weiter, wenn ein Paper n in einem CONSORT-Diagramm versteckt oder Limitationen über die Discussion verteilt.
Die ehrliche Einschränkung ist architektonisch bedingt. Er bietet keine Screening-Warteschlange mit zwei Reviewenden für Zehntausende Datensätze und hat keine SWAR-ähnliche Genauigkeitsstudie veröffentlicht, die mit der von Elicit vergleichbar wäre. Die Extraktionsqualität hängt vom Prompt, den angehängten Dateien und der menschlichen Prüfung ab. Für ein Thesis-Kapitel mit 12 Papers ist genau diese Flexibilität der Vorteil. Für ein PRISMA-Review mit 2.000 Datensätzen passen die Review-Modi von Elicit oder Paperguide besser.
Paperguide
Paperguide steht zwischen Bibliothek, Extraktionssystem und Schreibwerkzeug. Es indexiert mehr als 200 Millionen Papers, ermöglicht die Definition von Extraktionsspalten, verknüpft jeden Wert mit der Quellenaussage und kann Tabellen als CSV oder Excel exportieren. Der Modus für systematische Reviews betont doppelte Prüfung, endgültige menschliche Entscheidungen und PRISMA-Diagramme auf Basis tatsächlicher Fallzahlen.
Stärke: Quellenbelege und ein einziger Arbeitsbereich von der Bibliothek bis zur Tabelle. Einschränkung: Die Compliance-Position wird noch ausgebaut; das Unternehmen selbst nennt GDPR, SOC 2 und ISO 27001 als bevorstehend. Zudem sind öffentliche, stabile Preise schwieriger festzulegen als die häufig zitierten Tarife von Elicit. Teams, die innerhalb eines Produkts eine namentliche Prüfhistorie benötigen, werden diesen Arbeitsbereich stärker gewichten als die Flexibilität eines Chats.
SciSpace
SciSpace ist ein umfassender Forschungsarbeitsbereich für Suche, Lesen, Schreiben und Literaturverwaltung, dessen günstiger Einstiegstarif den Elicit-Pro-Tarif unterbietet. Vergleiche beschreiben es durchgängig als besseren Begleiter für Exploration und Schreiben, nicht als strengeres Extraktionssystem. Nutzen Sie es, um ein Feld schnell zu kartieren. Erwarten Sie nicht, dass es über ein Review hinweg das zentrale Nachweissystem für MSOL-Spalten ist.
Consensus
Consensus ist für eine andere Frage optimiert: Worüber ist sich die Literatur einig? Das ist für eine erste Orientierung und Antworten auf Behauptungsebene wertvoll. Wenn Ihr Ergebnis eine Tabelle mit Studiendesigns, Stichprobengrößen, Effektstärken und klassifizierten Limitationen sein soll, ist es jedoch nicht das richtige primäre Tool. Kombinieren Sie es mit einem Extraktionssystem, statt es durch eines zu ersetzen.
Wie genau kann AI Studiendesign und Stichprobenmerkmale extrahieren?
Die aktuelle Evidenz zeigt, dass AI bei vielen standardisierten Methoden- und Stichprobenfeldern mit menschlichen Extrahierenden mithalten kann, unregelmäßige Berichterstattung aber weiterhin übersieht oder falsch liest. Für einen ersten Durchgang ist die Genauigkeit hoch genug. Um die Verifikation zu überspringen, ist sie es nicht.
Der bisher direkteste Vergleich ist die Nichtunterlegenheits-SWAR aus dem Jahr 2026 mit 50 RCTs zu chronischen Erkrankungen: Die Gesamtgenauigkeit unterschied sich nicht zwischen Elicit-gestützter und rein menschlicher Extraktion, während der AI-gestützte Arm schneller und günstiger war. Die Ergebnisse in Untergruppen waren nicht durchgängig identisch; der AI-gestützte Arm war bei einigen Beschreibungen von Intervention und Kontrolle genauer. Die Fehlertypen, darunter Auslassungen und kleinere Fehler, waren ähnlich. Das spricht dafür, eine menschlich extrahierende Person durch eine AI-gestützte Extraktionsinstanz zu ergänzen oder zu ersetzen — nicht für eine unbeaufsichtigte Extraktion.
Von Anbietern berichtete Zahlen sind höher und sollten entsprechend eingeordnet werden. Elicit erklärt, dass ein deutsches Review zur Bildungspolitik 1.502 von 1.511 Datenpunkten korrekt extrahierte (99,4 %) und CSIRO-Vergleiche bei Schlüsselinformationen nahezu keine falsch negativen Ergebnisse fanden. Separate Bibliothekstests berichteten bei der Extraktion durch große Sprachmodelle eine Genauigkeit von rund 96 % über 160 Datenelemente hinweg, wenn PDFs bereitgestellt wurden. Diese Zahlen sind für Designbezeichnungen, n, Studienarme und primäre Endpunkte ermutigend. Sie sagen wenig darüber aus, ob ein Tool gezielte Stichprobenziehung oder unkontrollierte Störfaktoren erkannt hat.
In der Praxis scheitern Angaben zu Studiendesign und Stichprobe auf vorhersehbare Weise:
- Das Design wird als randomisiert bezeichnet, ohne Details zur Zuteilung.
- n ist die Zahl der gescreenten Personen, nicht die Zahl der analysierten Personen.
- Die Population wird mit einem Kliniklabel beschrieben, nicht mit Einschlusskriterien.
- Das Setting — ländlich, tertiärmedizinisch oder nur über eine App — fehlt, was später die Generalisierbarkeit beeinträchtigt.
Ein guter AI-Durchgang kennzeichnet diese Lücken als leere Zellen. Ein schlechter Durchgang erfindet eine sauber klingende Designbezeichnung. Leere Zellen sind wissenschaftlicher als flüssige Vermutungen.
Wie sollten AI-Tools Ergebnisse gegenüber den von Autoren genannten Limitationen behandeln?
Ergebnisse sollten als berichtete Endpunkte mit Zahlen und Zeitpunkten extrahiert werden; Limitationen sollten erneut kritisch bewertet und nicht abgeschrieben werden. Hier liegt die größte Qualitätslücke zwischen AI-Forschungsplattformen.
Die Extraktion von Ergebnissen ist die einfachere Hälfte. Endpunkte stehen oft in Tabellen, und Elicit vermarktet gezielt die Extraktion aus Tabellen und Abbildungen, weil dort viele klinische Endpunkte zu finden sind. Das Modell von Paperguide — benutzerdefinierte Spalten plus Rücksprung per Klick zur stützenden Aussage — ist das richtige Verifikationsmuster für Effektstärken, Konfidenzintervalle und Zahlen von Respondern. Wenn ein Ergebnis nicht belegt werden kann, gehört es nicht in die Evidenztabelle.
Die Extraktion von Limitationen ist eine andere Aufgabe. Autoren berichten unvollständig. Sie erwähnen die Stichprobengröße und lassen Störfaktoren aus. Sie erwähnen künftige Forschung und lassen die Stichprobenmethode aus. Die Bewertung des Bias-Risikos soll ergebnisspezifisch sein und klassifiziert werden, etwa als niedrig / einige Bedenken / hoch nach RoB 2. Den Abschnitt zu Limitationen zu kopieren, erfüllt diesen Standard nicht.
Eine nützlichere Ausgabe sieht wie eine strukturierte Schwächentabelle aus: Paper, Kategorie — Bias, Generalisierbarkeit oder Berichterstattung —, die Schwäche in einem Satz sowie eine Seitenangabe oder ein Zitat. Dieses Format zwingt das Modell dazu, zu entscheiden, welche Art von Limitation es gefunden hat.
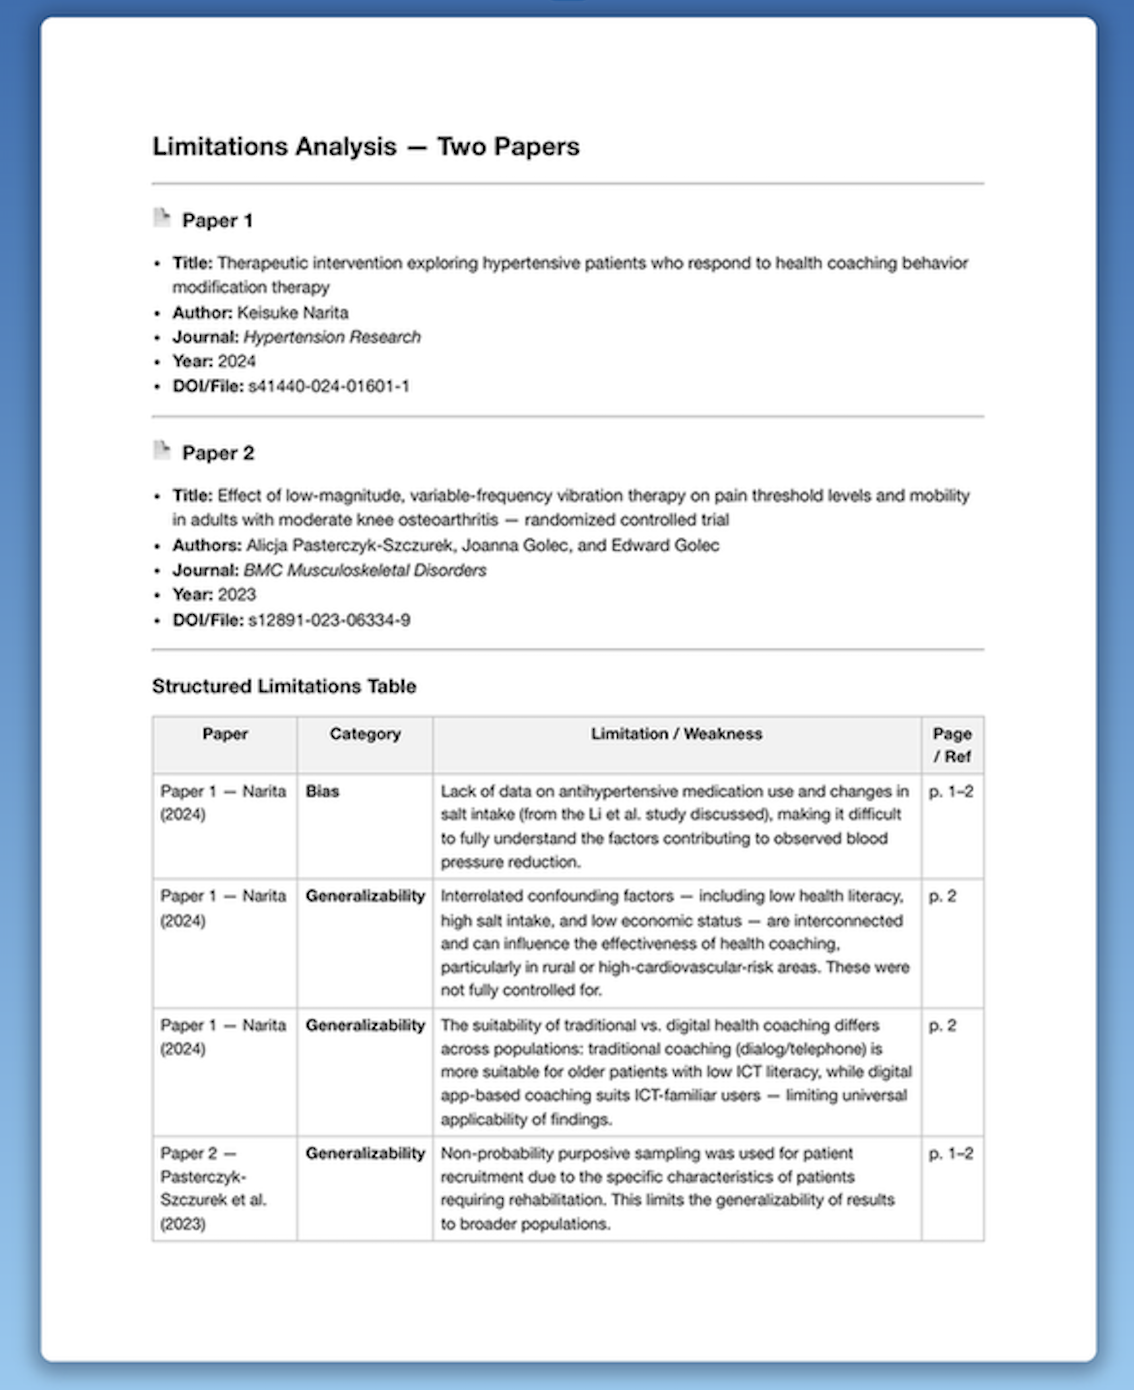
Diese Anordnung zeigt, warum allgemeine Chat-Tools nicht ausreichen. Eine Studie zum Coaching bei Hypertonie kann den Blutdruck senken, ohne die Einnahme antihypertensiver Medikamente oder die Salzaufnahme zu berichten — ein Bias-Problem. Dasselbe Paper kann Gesundheitskompetenz, Ernährung und Einkommen vermischen, sodass die Befunde nicht übertragbar sind — ein Problem der Generalisierbarkeit. Eine Studie zur Vibrationstherapie kann eine gezielte Stichprobe von Rehabilitationspatienten verwenden — ebenfalls ein Problem der Generalisierbarkeit und nicht einfach nur: Die Autoren erwähnten eine kleine Stichprobe. Tools, die lediglich die Discussion zusammenfassen, übersehen diese Taxonomie.
Jenova's Academic Research Assistant ist hier vergleichsweise stark, weil Sie die Taxonomie im Prompt verlangen und über einen Stapel von PDFs hinweg stabil halten können. Elicit und Paperguide erfassen Limitationen-felder, wenn Sie Spalten hinzufügen; standardmäßig denken sie jedoch nicht wie eine Person, die Methoden kritisch bewertet. Consensus kann Ihnen sagen, ob Studien einen Effekt zeigen. Diese Tabelle erstellt es nicht.
Wie führen Sie eine Vier-Felder-Extraktion über einen Stapel von PDFs durch?
Beginnen Sie mit einem fixierten Schema, extrahieren Sie jedes Paper in dieselben vier Felder und überprüfen Sie Zahlen sowie die Klassifizierung von Limitationen, bevor Sie synthetisieren. Das Schema ist wichtiger als die Marke des Chatbots.
Ein praxistaugliches MSOL-Schema lautet:
- Methoden: Design, Randomisierung/Verblindung, soweit vorhanden, Intervention, Vergleichsgruppe, Nachbeobachtung.
- Stichprobe: analysiertes n, Population, Setting, Stichprobenverfahren.
- Ergebnisse: primäres Ergebnis mit Statistik, Zeitpunkt und Richtung.
- Limitationen: Bias, Generalisierbarkeit, Berichterstattung — jeweils mit Fundstelle.
Für Jenova's Academic Research Assistant sieht eine typische Abfolge so aus:
- Öffnen Sie den Agent und hängen Sie die PDFs an — oder einen Ordner mit den Papers, die Sie vergleichen möchten.
- Fixieren Sie das Schema in der ersten Nachricht, damit jedes nachfolgende Paper dieselben Spalten verwendet.
- Fordern Sie für jede Zelle Fundstellen an:
„Erstelle für diese Papers eine Evidenztabelle. Spalten: Literaturangabe, Studiendesign, Stichprobe (analysiertes n, Population, Setting, Stichprobenverfahren), primäre Ergebnisse mit Effektstärken und Zeitpunkten sowie Limitationen, klassifiziert als Bias, Generalisierbarkeit oder Berichterstattung. Jede Zelle muss eine Seitenangabe oder ein Zitat enthalten. Lass eine Zelle leer, wenn das Paper dies nicht berichtet. Paraphrasiere nicht einfach den Abschnitt ‚Limitationen‘ der Autoren, ohne die Aussage neu einzuordnen.“
- Prüfen Sie n, Design und jede Effektstärke stichprobenartig anhand des PDF. Korrigieren Sie die Tabelle innerhalb des Threads; die dauerhafte Erinnerung bewahrt das Schema für den nächsten Stapel.
- Wenn Sie ein teilbares Dokument benötigen, übergeben Sie die verifizierte Tabelle an den Word Doc Generator, statt sie manuell neu zu formatieren.
- Für einen Fließtext, der auf der Tabelle aufbaut, ist Deep Research der bessere nächste Schritt, statt das Extraktionssystem zu einem zweiten systematischen Review zu machen.
Für Elicit verläuft der parallele Weg so: Sammeln Sie Papers in einer Ansicht für systematische Reviews oder Extraktion, übernehmen oder bearbeiten Sie vorgeschlagene Spalten, extrahieren Sie mit Zitatbelegen und behandeln Sie AI dann als zweites Augenpaar. Der eigene Workflow von Elicit für systematische Reviews basiert auf bearbeitbaren Vorlagen, durch Zitate oder Abbildungen gestützten Zellen und menschlicher Übereinstimmung bei Screening-Kriterien. Für Paperguide definieren Sie die Spalten einmal, extrahieren über das ausgewählte Set hinweg und exportieren CSV/Excel, sobald das Raster stabil ist.
Zwei Fehlmuster sollten Sie vermeiden. Extrahieren Sie nicht 40 Papers mit 40 leicht unterschiedlichen Prompts. Lassen Sie das Modell keine Lücken mit Aussagen wie wahrscheinlich RCT oder angemessene Stichprobe füllen. Leer ist ein Befund.
Was sagen Spezialisten für Evidenzsynthese über AI-Datenextraktion?
Methodiker betrachten AI zunehmend als legitime zweite Extraktionsinstanz für standardisierte Felder, sofern jeder Wert überprüfbar bleibt und die Bewertung von Limitationen von Menschen geleitet wird. Der entstehende Konsens ist eng gefasst und praktisch, nicht utopisch.
„Die Diskussion über Genauigkeit ist für die einfachen Spalten weitgehend entschieden — Designbezeichnung, n, Namen der Studienarme, primärer Endpunkt wie berichtet. Kontrollierte Vergleiche zeigen inzwischen, dass AI-gestützte Extraktion menschlichen Extrahierenden bei diesen Feldern entsprechen und schneller abgeschlossen werden kann. Der verbleibende Fehlermodus ist interpretativ: Modelle kopieren die Vorbehalte der Autoren und nennen das kritische Bewertung. Das ist keine Bewertung des Bias-Risikos, und PRISMA erwartet weiterhin, dass Sie erläutern, wie Bias beurteilt wurde.“
„Bei einer Plattform suchen wir nicht nach einer schöneren Zusammenfassung. Wir suchen nach einer Regel für leere Zellen, einer Fundstelle bei jeder Zahl und einem Limitationen-Schema, das Störfaktoren, Stichprobenziehung und externe Validität erfassen kann, selbst wenn das Paper diese Wörter nie verwendet. Wenn Sie eine Stichprobengröße nicht per Klick auf einen Satz zurückführen können, haben Sie keine Extraktion. Sie haben einen Entwurf.“
„Wählen Sie das Tool, das zur Form des Korpus passt. Spezialisierte Extraktionsprodukte gewinnen bei großen, homogenen Studiengruppen. Dialogbasierte Forschungsagenten gewinnen, wenn Papers gemischt sind, PDFs unübersichtlich sind und die wissenschaftliche Frage lautet: Was können wir nicht schlussfolgern? Die meisten realen Projekte in Studium und Klinik gehören zur zweiten Kategorie.“
— Jenova Product Team, Gestaltung akademischer Forschungsworkflows (Erfahrung in der Entwicklung von AI-Agenten für Literaturreviews und Evidenztabellen)
Diese Sicht stimmt mit der externen Evidenz überein: nicht unterlegene assistierte Extraktion in einer SWAR aus dem Jahr 2026, hohe Leistung bei standardisierten Variablen in Studien im Stil menschlicher Reviews und Bibliotheksleitlinien, die Menschen die endgültige Entscheidung überlassen.
Wann passt ein flexibler Forschungsagent besser als eine spezialisierte Extraktionsplattform?
Ein flexibler Forschungsagent passt besser, wenn Ihr Paper-Set klein bis mittelgroß ist, die Designs gemischt sind und die knappe Kompetenz in der Interpretation von Limitationen liegt — nicht im Screening von 10.000 Titeln. Eine spezialisierte Plattform passt besser, wenn Protokoll, doppelte Prüfung und PRISMA-Zahlen das zentrale Ergebnis sind.
Wählen Sie ein spezialisiertes Extraktionssystem wie Elicit oder Paperguide, wenn:
- Sie ein systematisches Review oder Scoping Review mit einem vorab registrierten Protokoll durchführen.
- Die meisten eingeschlossenen Studien RCTs oder andere stark standardisierte Berichte sind.
- Sie Screening-Protokolle, Ausschlussgründe und ein Flussdiagramm benötigen.
- Mehrere Reviewende Konflikte für dieselben Datensätze auflösen müssen.
Wählen Sie Jenova's Academic Research Assistant, wenn:
- Sie ein Thesis-Kapitel, den Hintergrund eines Förderantrags, einen Journal Club oder einen schnellen Evidenzscan erstellen.
- Die Papers RCTs, Beobachtungsstudien und qualitative Arbeiten kombinieren.
- Ihnen klassifizierte Limitationen wichtiger sind als automatisch vorgeschlagene PICO-Spalten.
- Sie bereits über verschiedene Modelle, hochgeladene PDFs und Rückfragen hinweg in einem Thread arbeiten.
Eine hybride Nutzung ist verbreitet und sinnvoll. Kartieren Sie die Fragestellung in SciSpace oder Consensus, extrahieren Sie MSOL-Felder in Jenova oder Elicit und führen Sie die PRISMA-Dokumentation in dem Review-Modul, das Ihre Institution akzeptiert. Vergleiche zwischen SciSpace und Consensus beschreiben genau diese Arbeitsteilung: Consensus für einen schnellen Überblick über Übereinstimmung, SciSpace für eine dichtere Recherche. Keine dieser Kombinationen ersetzt die menschliche Prüfung von n, Endpunkten und Bias.
Die Einschränkung von Jenova in dieser Abwägung sind Umfang und Formalität. Es ersetzt keine unternehmensweite Screening-Pipeline. Die Einschränkung von Elicit ist umgekehrt: hervorragende Raster, aber weniger native Unterstützung für die unübersichtliche, argumentativ geprägte Arbeit, zu begründen, warum ein Befund nicht übertragbar ist. Wenn Ihr Ergebnis eine Evidenztabelle ist, die eine Betreuungsperson prüfen kann, bewerten Sie Tools zuerst nach MSOL-Vollständigkeit und Quellenbelegen — und erst danach nach Marke oder Monatspreis.
Referenzen
- PRISMA-Erklärung — Berichtsleitlinien für systematische Reviews
- DistillerSR — Tools und Techniken zur Datenextraktion für systematische Reviews
- medRxiv — Genauigkeit und Effizienz AI-gestützter Datenextraktion mit Elicit, 2026 SWAR
- Paperguide — AI-Tools für systematische Reviews und berichtete Arbeitsreduktion
- The BMJ — PRISMA-2020-Erklärung
- PubMed Central — Erläuterung und Ausarbeitung zu PRISMA 2020, einschließlich der RoB-2-Domänen
- Wiley / Cochrane Evidence Synthesis and Methods — AI-Tools als zweite Reviewende für Datenextraktion
- King’s College London — AI-Tools in der Evidenzsynthese
- PapersFlow — Vergleich zwischen Elicit und Consensus AI
- Paperguide — Funktions- und Preisvergleich zwischen Elicit und SciSpace, 2026
- George Mason University — AI-Tools für Literaturreviews
- Elicit — AI für wissenschaftliche Forschung, Korpus- und Nutzungszahlen
- Elicit — Workflow für systematische Literaturreviews, Behauptungen zur Extraktionsgenauigkeit und Screening
- SciSpace — Vergleich zwischen SciSpace und Elicit, einschließlich Preisstufen für 2026
- Paperguide — Plattformdokumentation zu benutzerdefinierten Extraktionsspalten und quellenverknüpften Werten
- Himmelfarb Health Sciences Library — Berichtsqualität und Bias-Risiko
- Birmingham City University — Hinweise zur Genauigkeit der AI-Datenextraktion
- Paperguide — Vergleich zwischen SciSpace und Consensus