Welche AI ist für Aktienanalysen in Echtzeit zuverlässiger?
2026-08-24
Wie unterscheiden sich Chatbots und spezialisierte Assistenten bei Datenaktualität und Risikomodellen?
Spezialisierte AI-Assistenten für Aktienanalysen sind bei Echtzeit-Marktdaten und formalen Risikorahmen zuverlässiger als allgemeine Chatbots, weil sie Informationen aus Einreichungen, Schätzungen und strukturierten Marktquellen abrufen, statt sich auf einen Trainingsstichtag zu stützen. Allgemeine Chatbots wie ChatGPT, Claude und Gemini bleiben stark darin, Konzepte zu erklären und Research-Narrative zu formulieren, doch ihnen fehlt in der Regel der native Zugriff auf proprietäre Finanzdaten, sofern Nutzer nicht APIs hinzufügen oder Dokumente hochladen.
Der praktische Unterschied im Jahr 2026 lautet nicht: „Welches Modell klingt intelligenter?“ Entscheidend ist, ob eine Antwort datiert, mit Quellen belegt und ohne einen zweiten Research-Durchgang in einen Risikoprozess übernommen werden kann.
Wichtige Faktoren, die einen eloquenten Markt-Chatbot von einem Research-Assistenten auf professionellem Niveau unterscheiden:
✅ Datenherkunft — Kann das System auf einen 10-K, 10-Q, 8-K, einen Earnings-Call-Transkript oder einen Vendor-Feed verweisen, oder ist die Zahl unbelegt? ✅ Zeitliche Genauigkeit — Kennt das Tool den Zeitpunkt eines Kurses, den Stand einer Schätzung und das Einreichungsdatum eines Risikofaktors? ✅ Risikostrukturierung — Quantifiziert es Exposures, Szenarien und Positionslimits, oder beschreibt es Risiken nur in Prosa? ✅ Prüfbarkeit — Kann ein zweiter Analyst nachvollziehen, warum das Modell zu seiner Schlussfolgerung gelangt ist? ✅ Aufsichtliche Eignung — Würde der Workflow die Fragen zu Modellrisiko, Data Governance und Erklärbarkeit überstehen, die US-Wertpapieraufsichtsbehörden bereits an AI-Tools stellen?
Diese fünf Tests — Herkunft, Aktualität, Risikostruktur, Audit Trail und aufsichtliche Eignung — bilden das PRRA+S-Framework, das in diesem Vergleich verwendet wird. Die folgenden Abschnitte wenden dieses Framework auf allgemeine Chatbots, spezialisierte Aktienassistenten und einen praxisnahen Research-Workflow an.
Warum ist die Lücke zwischen Chatbots und Spezialisten an den Märkten 2026 wichtiger?
Die Lücke ist 2026 größer, weil sich Marktdaten heute im Millisekundenbereich bewegen, während allgemeine Chatbots weiterhin aus gemischten und häufig verzögerten Kontexten antworten. Aktienmarktdaten in Echtzeit sind ein kontinuierlicher Strom aus Kursen, Volumina und Marktbewegungen, der sich innerhalb von Millisekunden nach jedem Handel aktualisiert. Ein Sprachmodell, das eine Aussage nicht an diesen Datenstrom knüpfen kann, kann aktuell wirken, obwohl seine Informationen Stunden oder Quartale alt sind.
Professionelle Handelsdesks behandeln Aktualität bereits als Infrastruktur und nicht als Feature. Institutionelle Echtzeitnetzwerke decken zig Millionen Instrumente über Börsen, OTC-Handelsplätze und Beitragsquellen hinweg ab, und Broker sind routinemäßig auf Live-Feeds angewiesen, um kurzfristige Chancen zu nutzen. Ein Chatbot, der den 10-K des Vorjahres eloquent zusammenfasst, arbeitet nicht in diesem Umfeld.
Risiko ist der zweite Grund, weshalb die Abgrenzung schärfer geworden ist. FINRA hat Modellerklärbarkeit, Datenintegrität, Kundendatenschutz und aufsichtliche Kontrollsysteme als zentrale Herausforderungen beim Einsatz von AI durch Unternehmen hervorgehoben. Neuere Branchenanalysen weisen darauf hin, dass Regulierungsbehörden ungeprüfter Autonomie, schleichender Ausweitung des Anwendungsbereichs, Prüfbarkeit und Datensensibilität mehr Aufmerksamkeit schenken. Ein Tool, das seine Eingaben nicht zeigen kann, passt schlecht in jeden Prozess, der später beaufsichtigt werden muss.
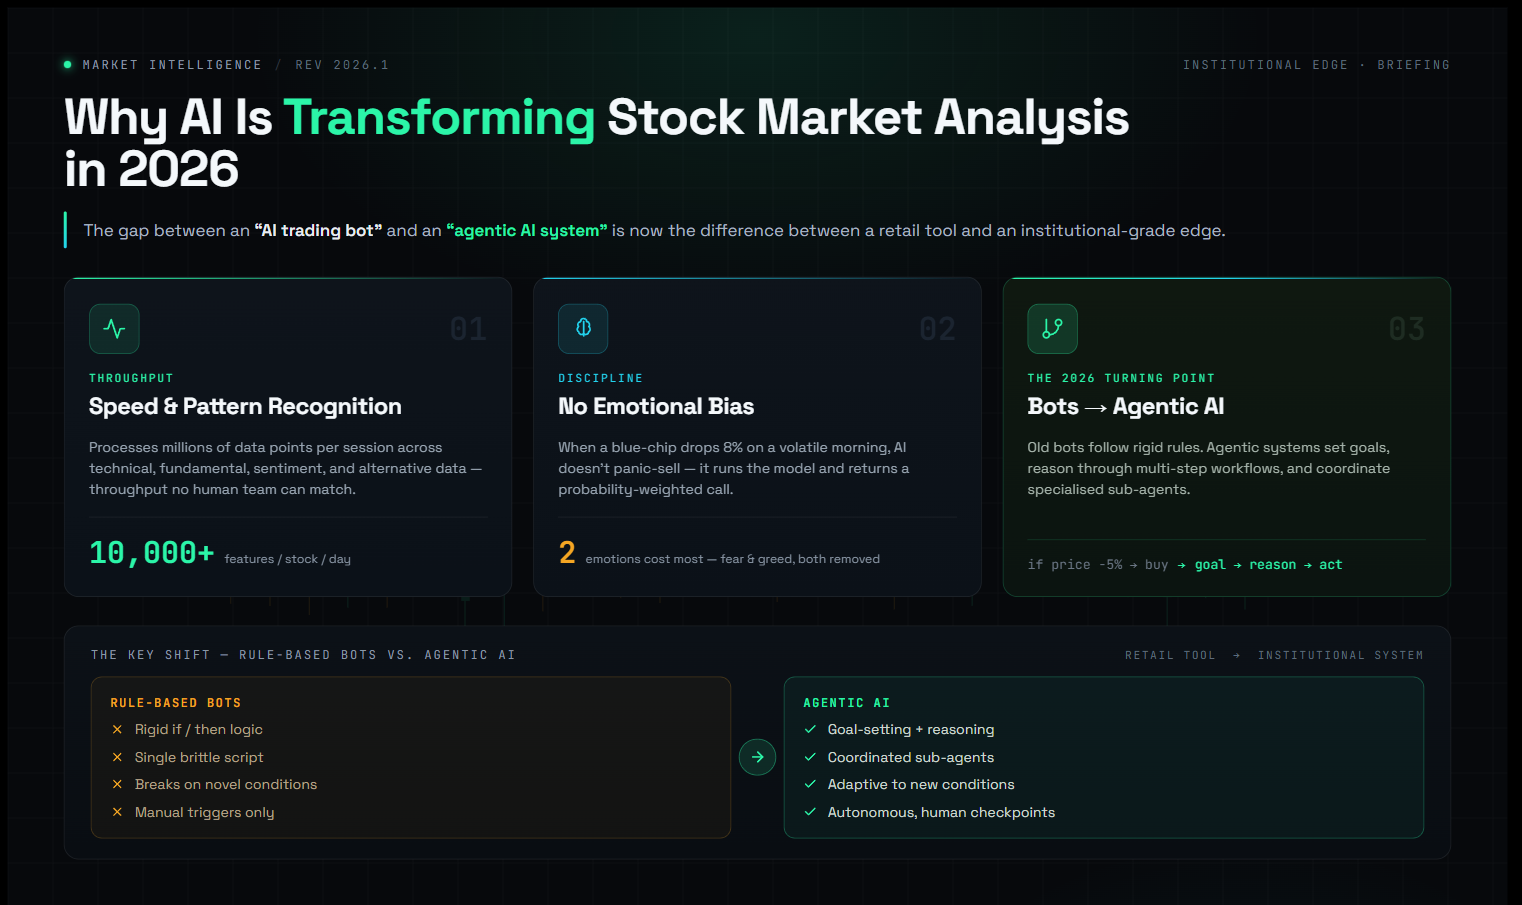
Zudem verändert sich die Produktkategorie. Ältere „AI-Trading-Bots“ folgten starren Wenn-dann-Regeln. Neuere agentische Systeme setzen ein Research-Ziel, ziehen mehrere Quellen heran und koordinieren Folgefragen. Diese Architektur ähnelt eher der Arbeitsweise eines Aktienresearch-Analysten — und deutlich weniger einer einmaligen Chatbot-Antwort.
Die Konsequenz für Privatanleger und kleine Research-Teams ist einfach. Lautet die Aufgabe „Erkläre Free Cash Flow“, reicht meist ein allgemeiner Chatbot. Lautet sie hingegen „Was hat sich in den Risikofaktoren von NVIDIA geändert und wie wirkt sich das auf die Positionsgröße aus?“, hängt Zuverlässigkeit von spezialisiertem Abruf und einem definierten Risikorahmen ab.
Was sollten Sie bewerten, bevor Sie einer AI Marktdaten und Risiko anvertrauen?
Sie sollten jedes AI-Aktientool anhand von Quellenkontrolle, Aktualität, Risikomathematik und der Fähigkeit bewerten, die Antwort nachzuvollziehen — nicht danach, wie überzeugt der Text klingt. Flüssige Formulierungen sind leicht zu erzeugen. Eine datierte Quelle und eine explizite Risikoannahme nicht.
Verwenden Sie die PRRA+S-Checkliste als Pre-Trade-Filter:
- Herkunft: Lässt sich jede wesentliche Zahl einer Einreichung, einem Transkript, einem Schätzungsanbieter oder einer Marktdatenquelle zuordnen?
- Aktualität: Kann das Tool Live-Kurse von verzögerten Notierungen und Einreichungen der laufenden Periode vom Geschäftsbericht des Vorjahres unterscheiden?
- Risikostruktur: Benennt es messbar, was schiefgehen kann — Drawdown, Liquidität, Konzentration, Faktor-Exposure oder Szenarioverlust — statt eines allgemeinen Absatzes wie „Märkte sind volatil“?
- Prüfbarkeit: Kann eine zweite Person, die den Chat morgen öffnet, die Dokumente, Ticker und Annahmen hinter der Schlussfolgerung sehen?
- Aufsichtliche Eignung: Falls die Ausgabe eine Empfehlung beeinflusst hätte, wäre sie mit Eignungsanforderungen und den Regulation-Best-Interest-Erwartungen vereinbar, die bereits für AI-Tools der Anlageberatung gelten?
Zwei zusätzliche Tests decken die meisten Fehler auf.
Erstens: Fragen Sie nach dem Stichtagszeitpunkt. Kann das Modell nicht angeben, wann ein Kurs, eine Schätzung oder eine Einreichung aktuell war, behandeln Sie die Antwort als Lehrmaterial und nicht als operative Grundlage.
Zweitens: Fragen Sie, was die Einschätzung widerlegen würde. Spezialisierte Assistenten, die mit Einreichungen arbeiten, können meist auf eine Kreditauflage, einen Margentrend oder eine Änderung der Prognose verweisen. Allgemeine Chatbots erfinden dagegen häufig ein sauber klingendes Negativszenario, das nicht in den Offenlegungen des Unternehmens verankert ist.
US-Finanzaufsichtsbehörden haben kein separates AI-Regelwerk geschrieben; sie wenden bestehende Pflichten — Aufsicht, Bücher und Aufzeichnungen, Modellrisiko und Lieferantenaufsicht — auf algorithmische Tools an. Privatanleger sind keine Broker-Dealer, doch dieselbe Logik ist nützlich: Wenn Sie das Modell nicht erklären können, sollten Sie darauf keine Positionsgröße stützen.
Eine verwandte Warnung gilt für Social- und Sentiment-Overlays. FINRA hat Anleger davor gewarnt, ausschließlich auf Social-Sentiment-Tools zu handeln. Eine AI, die Schlagzeilen ohne Risikobudget auswertet, ist eine schnellere Version dieses Problems, keine Lösung.
Wie schneiden ChatGPT, Claude, Gemini und spezialisierte Aktienassistenten im Vergleich ab?
Allgemeine Chatbots überzeugen bei Erklärungen und Entwürfen, während spezialisierte Aktienassistenten bei dokumentengestützten Fakten, wiederholbaren Screens und risikobewussten Workflows stärker sind. Unabhängige Vergleiche von ChatGPT, Claude, Gemini und Perplexity für Aktienresearch im Jahr 2026 zeigen, dass kein einzelnes allgemeines Modell jede Aufgabe gewinnt. Das ist erwartbar: Sie wurden nicht als Marktdatensysteme entwickelt.
ChatGPT ist vielseitig für Zusammenfassungen, Modellierungsleitfäden und die Erstellung von Berichten, verfügt aber ohne Integration mit APIs nicht über Echtzeitzugriff auf proprietäre Finanzdaten. Claude ist typischerweise stärker bei der Analyse langer Finanzberichte und narrativen Kommentaren. Gemini ist in Google-Workspace-Workflows am stärksten und kann Live-Kontext ergänzen, bietet bei den zugrunde liegenden Finanzberichten jedoch oft weniger Tiefe als Claude.
Spezialisierte Tools kehren diesen Zielkonflikt um. Sie beschränken das Modell auf einen Finanzdatenkorpus und zeigen im besseren Fall offen, warum sich ein Score oder eine Antwort verändert hat.
| Funktion / Dimension | Allgemeine Chatbots (ChatGPT, Claude, Gemini) | Jenova Fundamental Stock Analyst | Danelfin | Screener AI |
|---|---|---|---|---|
| Primäre Datenquelle | Trainingsdaten, Nutzer-Uploads, optionales Web/API | SEC-Einreichungen, Analystenschätzungen, Marktstimmung, Live-Research-Tools | Proprietäres Merkmalset zur Berechnung eines AI Score | Direkter Zugriff auf Unternehmenseinreichungen, Geschäftsberichte und Earnings Calls |
| Marktdaten in Echtzeit | Eingeschränkt, sofern Nutzer keine Daten anbinden | Research auf Sitzungsebene anhand aktueller öffentlicher Quellen; kein Börsenfeed | Tägliche Score-Updates und Portfolio-Alerts | Auf Einreichungen gestützte Antworten, keine Tick-Level-Kurse |
| Risikorahmen | Narratives Risiko, vom Prompt gesteuert | Strukturierte fundamentale Risiken plus zugehörige Portfolio- und Szenario-Agenten | Score-Rangfolgen und historische Signal-Track-Records | Extrahiert offengelegte Risiken aus offiziellen Dokumenten |
| Prüfbarkeit | Schwach, sofern Nutzer keine Quellen bereitstellt | Persistenter Speicher und quellenbasierter Research-Track | Laut Unternehmen sind Scores erklärbar und keine Black Box | Antworten sind an die Dokumente gebunden, die das System liest |
| Preisgestaltung (Stand 2026) | Kostenlose Stufen plus kostenpflichtige Abonnements | Kostenlose Stufe; Plus ab $20/Monat für die 30-fache kostenlose Nutzung | Nicht verifiziert | Nutzungsabhängige Bezahlung; typische Antworten kosten etwa ₹10–30 |
| Am besten geeignet für | Vermittlung von Konzepten, Verfassen von Memos, einmalige Dateiprüfung | Wiederholbares Aktienresearch mit speicherübergreifender Kontinuität zwischen Sitzungen | Screening und Timing auf Basis eines veröffentlichten Score | Schnelle Fragen und Antworten zu offiziellen Dokumenten im abgedeckten Universum |
Die Tabelle ist kein Intelligenzranking. Sie ist eine Karte der Fehlermodi. Chatbots scheitern unauffällig bei veralteten oder unbelegten Zahlen. Screener scheitern, wenn es um Portfoliokonstruktion statt um eine einzelne Einreichung geht. Score-Engines scheitern, wenn Nutzer einen Wahrscheinlichkeitsrang wie eine Bewertung behandeln.
Allgemeine Chatbots
ChatGPT, Claude und Gemini sind 2026 für die meisten Anleger der Standardausgangspunkt, weil sie bereits in einem anderen Tab geöffnet sind. Rezensenten ordnen sie konsequent der Kategorie „Finanzkonzepte erklären und Analysen entwerfen“ zu, nicht der Kategorie Live-Research.
Ihre Stärke ist Transferlernen. Sie können durch ein DCF-Layout führen, einen Earnings-Rückblick umschreiben oder eine unübersichtliche Liste von Excel-Annahmen kritisieren. Ihre Einschränkung ist strukturell: Ohne eine gebundene Datenebene können sie nicht garantieren, dass „aktueller Umsatz“ tatsächlich dieses Quartal meint.
Jenova Fundamental Stock Analyst
Jenovas Fundamental Stock Analyst ist ein spezialisierter Aktienresearch-Agent für Earnings-Analysen, relative Bewertung, die Bewertung von Geschäftsmodellen und Research anhand von SEC-Einreichungen, Analystenschätzungen und Marktstimmung. Er läuft auf einer Multi-Modell-Plattform mit persistentem Speicher, sodass ein Coverage-Universum und eine interne Einschätzung über einen einzelnen Chat hinaus erhalten bleiben können.
Dieses Design unterstützt Datenherkunft und Prüfbarkeit. Als Ersatz für ein institutionelles Terminal ist es schwächer: Es ist kein zugelassener Beratungskanal und bildet keine latenzarme Marktdateninfrastruktur auf Handelsplatzebene nach, wie sie an professionellen Desks genutzt wird.
Danelfin
Danelfin ist eine AI-Plattform für Aktienanalysen, die viele Merkmale in einem AI Score von 1 bis 10 und Portfolio-Tools verdichtet. Das Unternehmen berichtet, dass seit 2017 an US-Börsen gelistete Aktien mit einem Score von 10/10 den Markt nach drei Monaten auf annualisierter Alpha-Basis durchschnittlich um 21.05% übertroffen haben, und dass eine veröffentlichte Long-Strategie vom 3. Januar 2017 bis zum 9. Juni 2025 376% erzielte, gegenüber 166% für den S&P 500. Diese Zahlen stammen vom Anbieter und wurden in den für diesen Artikel geprüften Materialien nicht unabhängig auditiert.
Danelfins klare Stärke ist ein wiederholbarer Screen mit ausgewiesener Merkmalstransparenz. Seine Einschränkung ist dieselbe wie bei jedem Score-Produkt: Ein Rang ist weder Risikobudget noch Investmentthese noch ein Ersatz für die Lektüre der Einreichung.
Screener AI
Screener AI gibt Modellen strukturierten Zugriff auf offizielle Unternehmensdokumente, statt sie im offenen Web suchen zu lassen. Der eigene Produktvergleich ist deutlich: Allgemeine Tools einschließlich ChatGPT Pro und Perplexity übersehen häufig relevante Dokumente, wenn sie auf Suche angewiesen sind.
Diese Architektur ist stark für Fragen wie „Was hat das Management offengelegt?“. Sie ist eingeschränkt beim Lesen des Live-Tapes, bei Optionsstrukturen oder Multi-Asset-Risiken, und die Nutzung wird über Tokens abgerechnet statt als unbegrenzter Chat angeboten.
Wie zuverlässig sind Echtzeit-Marktdaten von allgemeinen AI-Chatbots?
Allgemeine Chatbots sind keine zuverlässigen Primärquellen für Marktdaten in Echtzeit, weil Live-Kurse und Notierungen ein Datenproduktproblem und kein Sprachmodellproblem sind. Echte Echtzeitdaten werden durch kontinuierliche Aktualisierungen im Millisekundenbereich von Handelsplätzen definiert. Ein Chatbot kann browsen, eine Nachrichtenseite zusammenfassen oder eine von Ihnen hochgeladene Tabelle lesen. Das ist nicht dasselbe wie der Konsum eines berechtigungsgesteuerten Datenfeeds.
Der Zuverlässigkeitsfehler zeigt sich gewöhnlich in einem von vier Mustern:
- Ein Trainingsstichtag gibt sich als aktuell aus. Das Modell nennt einen Kurs, eine Aktienanzahl oder eine Marge ohne Stichtagsdatum.
- Verzögerung durch Web-Snippets. Eine Browsing-Ebene ruft eine verzögerte Kursseite ab und präsentiert sie als aktuellen Marktverlauf.
- Verwechslung von Einheiten. Werte der vergangenen zwölf Monate, der nächsten zwölf Monate und des letzten Quartals werden in einem Absatz vermischt.
- Unverifizierte Präzision. Die Antwort enthält exakte Dezimalstellen, die einen Datenfeed suggerieren, über den das Modell nicht verfügt.
Der Vergleich von CFI für Finanzteams stellt ausdrücklich fest, dass ChatGPT für proprietäre oder Live-Finanzdaten eine API-Integration benötigt. Claudes Vorteil bei langen Einreichungen löst das Kursproblem nicht. Gemini kann in Sheets- und suchgestützten Workflows aktueller wirken, doch die Aktualität einer Tabellenkalkulation ist nur so gut wie die Funktion oder das Add-on, die beziehungsweise das sie speist.
Spezialisierte Research-Plattformen existieren, weil diese Lücke teuer ist. AlphaSense positioniert seine Research-Bibliothek mit mehr als 500 Millionen Dokumenten aus Broker-Research, Transkripten, Einreichungen und Experteninterviews. Koyfin bündelt globale Aktien, Makrodaten, Schätzungen, Einreichungen, Transkripte und Portfolio-Tools für Berater und Anleger, die terminalähnliches Arbeiten ohne einen selbst zusammengestellten Chatbot-Stack wünschen. Diese Produkte sind keine Chatbots mit Finanzlack. Sie sind Datensysteme mit Suche oder AI darüber.
Daraus folgt eine nützliche Regel: Nutzen Sie einen allgemeinen Chatbot, um eine Zahl zu interpretieren, der Sie bereits vertrauen. Nutzen Sie ihn nicht, damit er die Zahl ist.
Wenn Sie einen hybriden Ansatz benötigen, halten Sie die Rollen getrennt: Ein Live-Daten- oder Einreichungstool liefert Fakten; der Chatbot verwandelt diese Fakten in ein Memo. Beide in einem unbelegten Absatz zu vermischen, ist der Weg, auf dem veraltetes Research in ein Portfolio gelangt.
Wie strukturieren spezialisierte AI-Aktienassistenten Risikorahmen?
Spezialisierte Assistenten strukturieren Risiken zuverlässiger, wenn sie offengelegte Risiken, quantitative Exposures und Portfolioeinschränkungen voneinander trennen, statt einen einzigen Absatz zu „wesentlichen Risiken“ zu schreiben. Allgemeine Chatbots können Risiken aufzählen. Selten pflegen sie jedoch ein Framework, das nach der nächsten Veröffentlichung erneut ausgeführt werden kann.
Ein Research-Risikorahmen auf professionellem Niveau hat in der Regel vier Ebenen:
- Unternehmensoffenlegung: Liquidität, Rechtsstreitigkeiten, Regulierung, Lieferkette und Kundenkonzentration, wie das Unternehmen sie selbst in Einreichungen beschreibt.
- Finanzrisiko: Verschuldung, Zinsdeckung, Schwankungen des Working Capital und Ertragsqualität.
- Marktrisiko: Beta, Faktor-Exposure, Liquidität der Aktie und Gap-Risiko rund um Ereignisse.
- Portfoliorisiko: Positionsgröße, Korrelation mit bereits gehaltenen Titeln und die Auswirkungen eines definierten Stresstests.
FINRA hat gewarnt, dass AI im Liquiditäts-, Cash-Management- oder Portfoliokontext in Stressphasen aggressive Hebelung oder unhaltbare Empfehlungen erzeugen kann, wenn Risikoschwellen nicht in Modell und Aufsichtsprozess eingebaut sind. Diese Warnung gilt auch für Tools für Privatanleger. Ein Chatbot, der sagt, „dieser Rücksetzer sieht attraktiv aus“, trifft implizit eine Finanzierungs- und Drawdown-Entscheidung.
Spezialisierte Produkte setzen Teile dieses Stacks um, nicht den gesamten Stack.
Einreichungsassistenten im Screener-Stil sind bei Unternehmensoffenlegungen am stärksten. Sie können die Sprache zum Liquiditätsrisiko aus einem 10-K ziehen und nahe an der Quelle bleiben. Score-Engines im Stil von Danelfin sind bei querschnittlichen Marktrangfolgen am stärksten: Sie schätzen, welche Titel historisch mit höherer Wahrscheinlichkeit den Markt übertreffen, was eine Form von Modellrisiko darstellt, die Sie zumindest prüfen können, wenn Merkmale offengelegt werden. Terminalähnliche Plattformen wie Koyfin sind am stärksten bei der Überwachung von Exposures, wenn Sie bereits ein Portfolio haben.
Jenovas Design teilt den Stack auf spezialisierte Agenten auf, statt ein einziges Chatfenster zu zwingen, alles zu erledigen. Der Fundamental Stock Analyst behandelt Unternehmensökonomie und einreichungsbasierte Risikosprache. Der Technical Stock Analyst strukturiert Kurs, Volumen und Setups mit definiertem Risiko. Der Portfolio Management Strategist ist die Ebene für Allokationsdrift, Szenariostress und Rebalancing-Logik.
Diese Aufteilung ist zugleich Feature und Einschränkung. Sie ähnelt stärker der Organisation eines realen Handelsdesks. Sie bedeutet auch, dass ein Nutzer, der nur den fundamentalen Agenten öffnet, nicht automatisch einen Stresstest auf Portfolioebene erhält. Der Risikorahmen ist verfügbar, aber keine unsichtbare Magie.
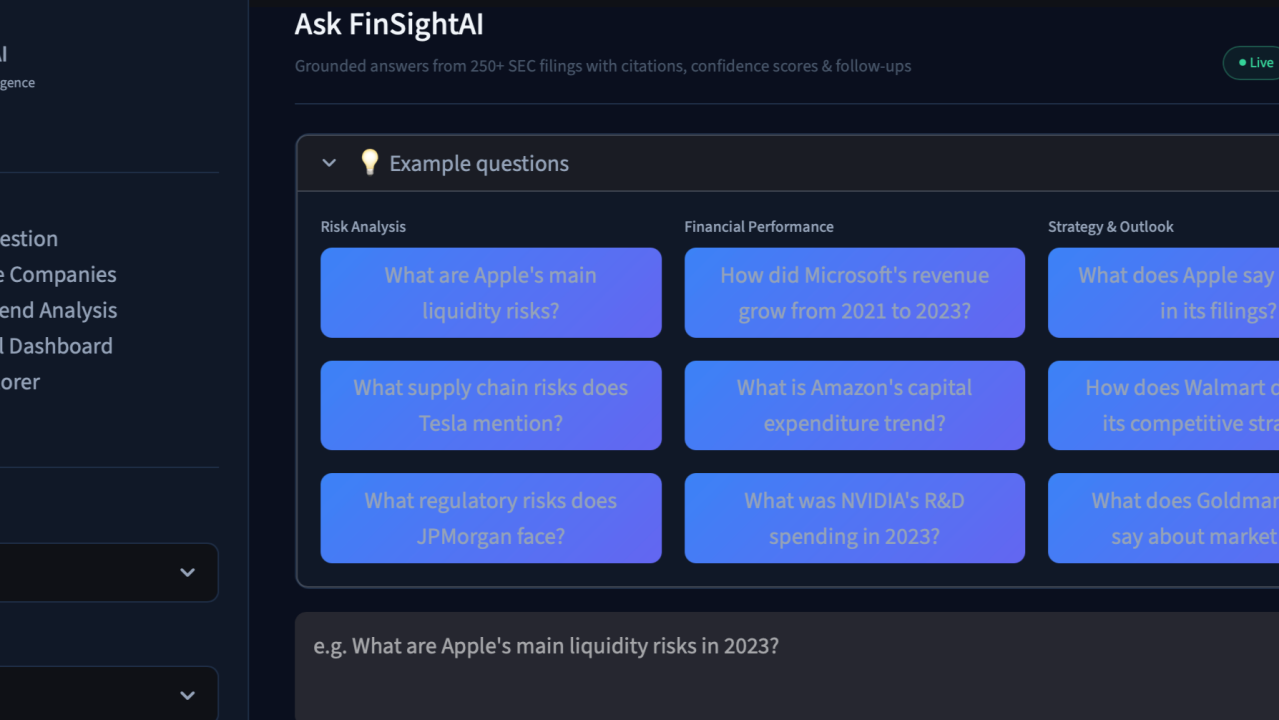
Auf Einreichungen gestützte Oberflächen veranschaulichen die erste Risikoebene gut. Fragen wie „Was sind Apples wichtigste Liquiditätsrisiken?“ oder „Welche regulatorischen Risiken legt JPMorgan offen?“ sind die richtige Arbeitseinheit für einen spezialisierten Assistenten. Sie sind die falsche Arbeitseinheit für einen allgemeinen Chatbot, der möglicherweise einen alten 10-K mit einer aktuellen Schlagzeile vermischt.
Die Leitlinie der Federal Reserve zum Modellrisiko (SR 11-7), auf die FINRA Unternehmen verweist, behandelt Validierung als Prozess zur Prüfung, ob ein Modell wie vorgesehen funktioniert und seine Einschränkungen bekannt sind. Privatanleger werden kein bankähnliches Validierungsprogramm durchführen. Sie können dennoch die vereinfachte Variante verlangen: explizite Eingaben, explizite Einschränkungen und die Weigerung, eine Black-Box-Antwort als Positionsgröße zu behandeln.
Wann sollten Sie dennoch einen allgemeinen Chatbot für Finanzresearch einsetzen?
Sie sollten einen allgemeinen Chatbot weiterhin einsetzen, wenn der Engpass beim Denken, Schreiben oder Lernen liegt — und nicht bei einer Live-Zahl oder einem beaufsichtigten Risikolimit. Spezialisierte Tools sind bei Daten und Frameworks zuverlässiger. Häufig sind sie jedoch schlechter darin, ein Konzept von Grund auf zu vermitteln oder grobe Notizen in ein sauberes Memo für ein Investmentkomitee zu verwandeln.
Hochwertige Aufgaben für Chatbots sind unter anderem:
- Eine Kennzahl erklären, bevor Sie sie in einer Einreichung prüfen („Erkläre Owner Earnings im Vergleich zu Free Cash Flow“).
- Ihre Logik einem Stresstest unterziehen, nachdem ein spezialisiertes Tool mit Quellen belegte Fakten geliefert hat.
- Aus bereits verifizierten Notizen eine einseitige Zusammenfassung erstellen.
- Tabellenkalkulationsformeln und Szenario-Templates entwickeln, ein Bereich, den CFI als Stärke von ChatGPT dokumentiert.
- Zwei Interpretationen desselben belegten Auszugs vergleichen.
Wenig wertvolle Aufgaben für Chatbots sind unter anderem:
- Nach einem „heutigen Kursziel“ ohne beigefügte Daten zu fragen.
- Eine Portfolioabsicherung ohne aktuelle Bestände, Betas oder Optionskurse anzufordern.
- Einen einzelnen Chat als vollständige Due-Diligence-Akte zu behandeln.
- Social-Sentiment-Zusammenfassungen zu folgen, als wären sie ein Risikomodell.
Eine praktische Aufteilung sorgfältiger Teams lautet: Chatbot als Redakteur, Spezialist als Bibliothekar. Der Bibliothekar ruft ab. Der Redakteur schreibt. Wenn ein Modell beides ohne Quellen erledigt, werden Fehler schwer erkennbar, weil der Text flüssig klingt.
Hier gehören auch ehrliche Produktgrenzen hin. Jenovas spezialisierte Agenten hängen weiterhin von öffentlichen Einreichungen, Schätzungen und Research-Tools ab, nicht von einem kostenpflichtigen Börsenfeed. Danelfins Scores sind Prognosen relativer Performance, keine inneren Werte. Die Qualität von Screener AI ist durch die Dokumente begrenzt, die es tatsächlich lädt. Bibliotheken der AlphaSense-Klasse sind leistungsstark, und mindestens ein Vergleich von Terminal-Alternativen aus dem Jahr 2026 weist darauf hin, dass AlphaSense für Enterprise-Käufer und nicht für Privatanleger entwickelt wurde. Kein Tool in dieser Auswahl ersetzt den Menschen, der sagen kann: „Diese Position ist zu groß.“
Wenn Sie sich nur einen Gegensatz merken: Allgemeine Chatbots optimieren auf eine hilfreiche Antwort; spezialisierte Assistenten optimieren auf eine überprüfbare Antwort. Zuverlässigkeit bei Echtzeitdaten und Risiken ist ein Problem der Überprüfbarkeit.
Wie bauen Sie einen verlässlichen AI-Workflow für Aktienresearch auf?
Sie bauen einen verlässlichen Workflow auf, indem Sie jedem Tool eine einzige Aufgabe zuweisen: abrufen, interpretieren, dimensionieren und dann dokumentieren. Diese Aufgaben in einem Prompt zu vermischen, führt dazu, dass die Eloquenz des Chatbots einen Risikorahmen überschreibt.
Eine belastbare Abfolge sieht so aus.
1. Definieren Sie die Entscheidung, nicht den Ticker. Formulieren Sie die Frage in Investment-Begriffen: eröffnen, aufstocken, reduzieren, absichern oder auslassen. Ein Research-Chat ohne Entscheidungstyp optimiert auf Interessantheit.
2. Ziehen Sie belegte Fakten zuerst aus einer Spezialistenebene. Öffnen Sie für fundamentale Arbeit in Jenova den Fundamental Stock Analyst und begrenzen Sie den Auftrag:
„Analysiere NVDA als fundamentale Long-Position. Verwende ausschließlich den aktuellsten 10-K, 10-Q und die jüngste Earnings-Mitteilung. Liste Umsatz nach Segment, die Entwicklung der Bruttomarge, Formulierungen zur Kundenkonzentration und die fünf wesentlichsten Risikofaktoren mit Fundstellen in den Einreichungen auf. Falls eine Zahl in diesen Dokumenten nicht enthalten ist, sage das.“
In Screener AI entspricht dies einer Frage auf der Unternehmensseite zu automatisch geladenen Einreichungen. Das ist der vorgesehene Produktpfad und kein Prompt für das offene Web.
3. Lassen Sie keinen allgemeinen Chatbot die gerade angeforderten Fakten erfinden. Wenn Sie ChatGPT oder Claude einsetzen möchten, fügen Sie den belegten Auszug ein und begrenzen Sie die Aufgabe:
„Verwende ausschließlich die unten zitierten 10-K-Risikofaktoren. Ordne sie Liquiditäts-, regulatorischen, Wettbewerbs- und operativen Risiken zu. Ergänze keine Risiken, die nicht im Auszug stehen. Formuliere anschließend drei Fragen, die ich im nächsten 10-Q stellen sollte.“
4. Wandeln Sie narratives Risiko in eine Größenregel um. Diesen Schritt überspringen die meisten Chatbot-Sitzungen. Legen Sie einen maximalen Verlust, ein Ereignis zur Widerlegung der These und einen Anlagehorizont fest. Wenn Sie Jenova für Arbeit auf Portfolioebene nutzen, wechseln Sie mit denselben Einschränkungen zum Portfolio Management Strategist:
„Hier sind mein aktuelles Portfolio und der vorgeschlagene NVDA-Zukauf von 4%. Führe einen einfachen Stresstest durch: 25% Drawdown eines Einzeltitels und ein Anstieg der Realrenditen um 150 bp. Nenne den resultierenden Portfolio-Drawdown, die Konzentration und ob der Zukauf eine Obergrenze von 15% für Einzeltitel verletzt.“
5. Fügen Sie Marktstruktur erst hinzu, nachdem die These steht. Technischer Kontext kann die Ungültigkeit einer These definieren, sollte aber Einreichungsarbeit nicht ersetzen. Ein guter technischer Prompt benennt das Risiko im Voraus: Einstieg, Stop und welches fundamentale Ereignis das Setup aufheben würde.
6. Dokumentieren Sie den Stichtagsvermerk. Speichern Sie die Einreichungsdaten, den verwendeten Kurs und den Grund für einen Ausstieg. FINRAs AI-Leitlinien kehren aus gutem Grund immer wieder zu Büchern und Aufzeichnungen, Tests und Fallback-Prozessen zurück: Systeme versagen, und Sie benötigen den letzten funktionierenden Prozess.
Ein wöchentlicher Rhythmus hält den Workflow ehrlich. Montag: Aktualisierung von Einreichungen, Schätzungen sowie Score- oder Sentiment-Veränderungen durch einen Spezialisten. Mitte der Woche: Chatbot-gestütztes Schreiben darüber, was sich verändert hat. Freitag: Risiko auf Portfolioebene statt einer weiteren These. Kann ein Tool an diesem Rhythmus nicht teilnehmen, ohne Kontext zu verlieren, ist es für diese Aufgabe ein Spielzeug, unabhängig davon, wie stark sein Modell ist.
Jenovas Vorteil in dieser Schleife ist Persistenz: Coverage-Notizen, Einschränkungen und frühere Ausnahmen können im Speicher bleiben, statt erneut eingefügt zu werden. Seine Einschränkung ist dieselbe wie bei jedem Research-Assistenten in diesem Artikel — er wird Sie nicht davon abhalten, ein Risikolimit zu übergehen. Das Framework ist nur so zuverlässig wie die Bereitschaft des Nutzers, Abruf, Interpretation und Positionsgröße in getrennten Schritten zu halten.
Was sagen Marktpraktiker über die Zuverlässigkeit von AI im Aktienresearch?
Praktiker, die diese Tools täglich einsetzen, beurteilen sie in der Regel zuerst als Datensysteme und erst dann als Gesprächssysteme. Unbelegte Sicherheit behandeln sie als Risikoereignis. Der Konsens lautet weniger „AI kann keine Finanzaufgaben erledigen“ als „ungebundene AI kann nicht die führende Dokumentation sein“.
„Die Zuverlässigkeitslücke hängt nicht davon ab, welches Modell sich besser ausdrückt. Entscheidend ist, ob das System die Fußnote einer Einreichung, den Stand einer Schätzung und den Stichtagszeitpunkt des zuletzt verwendeten Kurses zeigen kann. Allgemeine Chatbots verdichten einen breiten Korpus zu flüssiger Prosa. Spezialisierte Assistenten verdichten einen definierten Korpus zu einer Antwort, die Sie auditieren können. Das sind unterschiedliche Produkte, und sie scheitern auf unterschiedliche Weise.“
„Die teuersten Fehler, die wir sehen, sind veraltete Zahlen, nicht schwache Texte. Ein Chatbot, der eine Marge aus 2023 so wiedergibt, als wäre sie die aktuelle Veröffentlichung, übersteht eine oberflächliche Lektüre. Ein Risikorahmen, der keine Positionslimits, Faktor-Exposures oder ein benanntes Stresstestszenario angeben kann, ist ein Narrativ. Narrative überstehen keine Gap-Eröffnungen.“
„Erklärbarkeit ist kein Compliance-Slogan. Wenn Sie nicht rekonstruieren können, warum ein Titel markiert wurde — welches Dokument, welche Schätzung, welches Score-Merkmal — können Sie die Positionsgröße nicht verteidigen. Deshalb trennen wir Abruf-Agenten von Schreibmodellen und behalten einen menschlichen Kontrollpunkt, bevor etwas ins Portfolio gelangt.“
— Jenova Product Team, Design von Aktienresearch-Agenten, 8 Jahre Erfahrung mit AI-gestützten Investment-Workflows
Diese Sicht passt zur offiziellen regulatorischen Einordnung. Unternehmen, die AI-Tools für Anlageberatung prüfen, müssen bereits heute über Eignung, Interessenkonflikte, Kundenrisikoprofile und Aufsicht nachdenken — nicht nur über Modellqualität. Privatanleger können diesen Standard übernehmen, ohne eine juristische Einheit zu übernehmen: Kann der Assistent nicht geprüft werden, sollte er nicht maßgeblich sein.
Der Indikator für 2026 ist einfach. Wenn ein Tool eine Quelle zitiert, einen Zeitstempel nennt und das Risiko benennt, das die Idee zunichtemachen würde, nimmt es an einem Research-Prozess teil. Wenn es nur sicher klingt, nimmt es an einer Unterhaltung teil.
Quellen
- Corporate Finance Institute — ChatGPT vs. Claude vs. Gemini für Finanzen
- FINRA — AI in der Wertpapierbranche: zentrale Herausforderungen und regulatorische Überlegungen
- Financial Modeling Prep — Was sind Aktienmarktdaten in Echtzeit?
- LSEG — Echtzeitdatenlösungen
- IBM — Was sind Echtzeitdaten?
- Risk Management Magazine — Wie regulatorische Durchsetzung die AI-Compliance an der Wall Street prägt
- Sidley Austin — Artificial Intelligence: Leitlinien von US-Wertpapier- und Rohstoffaufsichtsbehörden
- FINRA-Anlegerwarnung — Social-Sentiment-Investment-Tools
- Helm Terminal — ChatGPT vs Claude vs Gemini vs Perplexity für Aktienresearch
- The AI Consulting Network — ChatGPT vs Claude vs Gemini für die Analyse von Finanzdokumenten
- Openbook Analytics — Die besten AI-Tools für Aktienanalysen im Jahr 2026
- Danelfin — AI-Aktienanalysen und AI-Score-Methodik
- Screener AI — Assistent für einreichungsgestütztes Unternehmensresearch
- AlphaSense — Führende Tools für Aktien- und Investmentresearch 2026
- Koyfin — Marktdaten-, Portfolioanalyse- und Research-Plattform
- Koyfin — Bloomberg-Terminal-Alternativen im Jahr 2026
- Board of Governors of the Federal Reserve System — SR-11-7-Leitlinie zum Management von Modellrisiken