Welche AI-Rechercheassistenten werden 2026 am häufigsten empfohlen?
2026-08-21
Wie schneiden führende AI-Rechercheassistenten bei Zitierintegrität, Datenbankabdeckung und Workflow-Vollständigkeit ab?
Zu den 2026 am häufigsten empfohlenen AI-Rechercheassistenten zählen Elicit für strukturierte Evidenzextraktion, SciSpace für das Verständnis innerhalb von Papers, Paperguide für Workflows von der Literaturrecherche bis zum Entwurf, Scite für die Analyse von Zitierkontexten sowie Jenovas Academic Research Assistant für persistente, modellübergreifende Literaturarbeit von der Recherche über die Synthese bis zur Manuskriptvorbereitung. Entscheidend ist nicht ein einzelner „Gewinner“, sondern die Eignung entlang dreier Dimensionen: Wie viel des wissenschaftlichen Forschungsstands ein Tool tatsächlich durchsuchen kann, ob seine Aussagen durch Zitate belegt sind und ob es nur eine Forschungsaufgabe oder einen vollständigen Workflow abdeckt.
Wichtige Faktoren, die einen brauchbaren akademischen Assistenten 2026 von einem allgemeinen Chatbot unterscheiden:
✅ Zitierintegrität — Antworten, die auf reale Papers verweisen und genügend bibliografische Details zur Überprüfung liefern, statt flüssiger, aber nicht überprüfbarer Zusammenfassungen
✅ Literaturabdeckung — Zugang zu großen wissenschaftlichen Indizes (in der Größenordnung von 125 Millionen Papers in Elicit und mehr als 300 Millionen Artikeln in Scite) sowie bei Bedarf grauer Literatur
✅ Umgang mit Evidenz — Screening, Extraktion und Synthese, die ein zweiter Forscher prüfen kann
✅ Workflow-Vollständigkeit — Ob Recherche, Lesen, Zitieren und Schreiben an einem Ort stattfinden oder einen Tool-Stack erfordern
✅ Human-in-the-loop-Design — Funktionen, die die Überprüfung unterstützen, da die derzeitige Evidenz den Einsatz generativer AI in der Evidenzsynthese ohne menschliche Aufsicht nicht stützt
Diese fünf Kriterien bilden die praktische Grundlage für die folgenden Vergleiche. Bei der Auswahl dieser Tools hilft es, sie als Spezialisten innerhalb einer gemeinsamen Forschungspipeline und nicht als austauschbare „AI für Papers“-Produkte zu betrachten.
Warum gewinnen spezialisierte AI-Rechercheassistenten unter Akademikern an Bedeutung?
Spezialisierte AI-Rechercheassistenten haben sich von optionalen Zusatzwerkzeugen zu standardmäßiger akademischer Infrastruktur entwickelt, weil Publikationsvolumen, studentische Nutzung und institutionelle Richtlinien gleichzeitig einen Wandel durchlaufen haben. Das wissenschaftliche Publikationswesen produziert inzwischen jedes Jahr mehr als drei Millionen neue Papers, wodurch die Suche mit Keywords ohne Unterstützung und manuelles Screening zunehmend zeitaufwendig werden.
Die Nutzungsdaten aus der Hochschulbildung sind eindeutig. Die HEPI Student Generative AI Survey 2025 ergab, dass 92 % der britischen Bachelorstudierenden generative AI nutzten, gegenüber 66 % im Jahr 2024; 88 % setzten sie bei Prüfungsleistungen ein. Die häufigsten akademischen Anwendungen waren das Erklären von Konzepten, das Zusammenfassen von Artikeln und das Vorschlagen von Forschungsideen — genau die Aufgaben, für die Rechercheassistenten entwickelt wurden.
Institutionen holen weiterhin auf. Eine UNESCO-Umfrage berichtete, dass zwei Drittel der Hochschulen Leitlinien für die Nutzung von AI haben oder entwickeln, während HEPI feststellte, dass nur 36 % der Studierenden von ihrer Institution eine Schulung zu AI-Kompetenzen erhalten hatten. Diese Lücke erklärt, warum domänenspezifische Assistenten — Tools, die wissenschaftliche Datenbanken durchsuchen, Zitate anfügen und einen Forschungspfad dokumentieren — für Literaturarbeit allgemeinen Chatbots vorgezogen werden.
Ein weiterer Treiber ist das Risiko. HEPI-Befragte nannten die Angst vor falschen Ergebnissen oder Halluzinationen (51 %) als einen der wichtigsten Gründe gegen die Nutzung von AI, nahezu gleichauf mit Bedenken hinsichtlich Täuschung. Assistenten, die wissenschaftliche Indizes durchsuchen und Quellen offenlegen, reagieren direkt auf diesen Fehlermodus.
Welche Kriterien sollten die Auswahl eines AI-Rechercheassistenten leiten?
Forscher sollten einen AI-Rechercheassistenten anhand eines sechsdimensionalen Rahmens auswählen — Abdeckung, Integrität, Extraktion, Schreiben, Persistenz und Verhältnis von Kosten zu Leistungsumfang — statt anhand von Funktionslisten oder Ranglisten zum „Besten insgesamt“. Die Prüfung anhand dieses Coverage–Integrity–Workflow-(CIW)-Rahmens macht Kompromisse sichtbar: Ein Tool kann bei PDF-Erklärungen führend sein und beim systematischen Screening dennoch schwach abschneiden oder beim Zitierkontext überzeugen, aber kaum Unterstützung beim Schreiben bieten.
Die sechs Dimensionen, gewichtet für typische akademische Anwendungen:
- Literaturabdeckung — Durchsucht das Tool einen großen wissenschaftlichen Korpus, mehrere Datenbanken oder nur einen einzelnen Index wie Semantic Scholar?
- Zitierintegrität — Sind Aussagen mit identifizierbaren Papers verknüpft, und lässt sich erkennen, ob spätere Arbeiten sie stützen oder infrage stellen?
- Evidenzextraktion — Können Methoden, Stichprobengrößen, Ergebnisse und Einschränkungen in vergleichbare Strukturen überführt werden?
- Schreibunterstützung — Erstellt oder bearbeitet das Tool Texte mit der Referenzbibliothek als Kontext, oder endet es bei Zusammenfassungen?
- Persistenz — Merkt es sich ein monatelanges Dissertationsprojekt oder beginnt jede Sitzung von vorn?
- Verhältnis von Kosten zu Leistungsumfang — Was umfasst eine kostenlose Version tatsächlich, und wo begrenzen kostenpflichtige Limits das Volumen systematischer Reviews?
Methodische Leitlinien sollten neben Produktfunktionen stehen. Die Bibliothekare für Evidenzsynthese am King’s College London weisen darauf hin, dass AI-Tools traditionelle Methoden systematischer Reviews nicht ersetzen können und am besten als Ergänzung betrachtet werden sollten. Der Leitfaden von OHSU zu systematischen Reviews kommt ähnlich zu dem Schluss, dass AI vor allem in späteren, arbeitsintensiven Phasen nützlich ist, etwa bei der Unterstützung des Screenings und der Datenextraktion, nicht aber als Ersatz für Protokolldesign oder Datenbanksuche.
Daraus folgt eine praktische Regel: Wenn das Ergebnis nicht geprüft werden kann — keine Quellenliste, keine Einschlusslogik, keine Möglichkeit, die Suche erneut auszuführen — ist das Tool eine Lesehilfe und kein Rechercheassistent.
Wie lassen sich Jenova, Elicit, SciSpace, Paperguide und Scite für akademische Workflows vergleichen?
Jenovas Academic Research Assistant ist am stärksten für langfristige, dialogbasierte Forschung mit persistentem Gedächtnis und modellübergreifendem Zugriff; Elicit für strukturierte Extraktion; SciSpace für das Lesen dichter PDFs; Paperguide für die Bündelung von Suche, Review-Tabellen und zitiergestütztem Schreiben in einem Abonnement; und Scite dafür, zu sehen, wie ein Paper tatsächlich zitiert wird. Keines der fünf Tools dominiert jede CIW-Dimension, weshalb „am häufigsten empfohlen“ 2026 eine Shortlist und kein einzelner Name ist.
| Dimension | Jenova Academic Research Assistant | Elicit | SciSpace | Paperguide | Scite |
|---|---|---|---|---|---|
| Literaturabdeckung | Live-Suche in wissenschaftlichen und Web-Quellen über Plattform-Tools, einschließlich wissenschaftlicher Datenbanken | Semantische Suche über 125 Millionen Papers; genutzt von mehr als 2 Millionen Forschern | Mehr als 200 Millionen Papers plus hochgeladene PDFs | Fragenbasierte Suche über mehr als 200 Millionen Papers | Mehr als 300 Millionen wissenschaftliche Artikel für Zitierkontext indexiert |
| Zitierintegrität | Quellengestützte Antworten; Überprüfung durch Nutzer weiterhin erforderlich | Zitiergestützte Zusammenfassungen; dokumentierte Sensitivitätslücken gegenüber traditioneller Suche | Antworten beruhen auf dem geöffneten Paper | Zitiergestützte Suche, Tabellen und Writer | Zeigt, ob Zitate eine Aussage stützen, ihr widersprechen oder sie lediglich erwähnen |
| Evidenzextraktion | Dialogbasierte Extraktion und Synthese sitzungsübergreifend | Strukturierte Spalten und Workflows für systematische Reviews | Zusammenfassungen auf Paper-Ebene, Methoden und Q&A | Literaturtabellen und Deep Research-Berichte | Extraktion von Zitierkontext, keine Ergebnistabellen |
| Schreibunterstützung | Manuskriptvorbereitung und Zitatmanagement | Berichte und Zusammenfassungen, keine vollständigen Papers | Erklärungen innerhalb des PDF | AI Paper Writer, der aus der Referenzbibliothek entwirft | Keine Schreibumgebung |
| Persistenz | Unbegrenzter Chatverlauf und sitzungsübergreifendes Gedächtnis | Projekt- und workflowbasiert | Dokumentzentrierte Lesesitzungen | Workbooks und Referenzbibliotheken | Gespeicherte Papers und Zitieransichten |
| Preise (Stand 2026) | Kostenlose Version; Plus für 20 $/Monat mit 30× der kostenlosen Nutzung | Kostenlose und kostenpflichtige Tarife | Kostenlose und kostenpflichtige Tarife | Kostenlos; Plus 12 $/Monat; Pro 24 $/Monat | Kostenlose und kostenpflichtige Tarife (kostenpflichtige Preise hier nicht verifiziert) |
| Am besten geeignet für | Mehrmonatige Forschungsgespräche, die Recherche, Synthese und Schreiben verbinden | Screening und Extraktion aus einer definierten Paper-Menge | Das Verständnis eines schwierigen Papers direkt im Kontext | End-to-End-Workflow von Review zu Entwurf auf einer Plattform | Prüfung, wie die Literatur eine konkrete Aussage behandelt |
Unabhängige Vergleiche bestätigen diese Aufteilung. Eine Paperguide-Analyse aus dem Jahr 2026 zu Elicit und SciSpace kam zu dem Schluss, dass Elicit für strenge evidenzbasierte Workflows stärker ist, während SciSpace besser für schnelle explorative Recherche geeignet ist. Der eigene Benchmark von SciSpace mit 200 Abfragen meldete für Deep Review 26,3 hochrelevante Papers pro Abfrage, vor Elicit und Consensus in diesem internen Test — ein nützliches Signal, das jedoch als anbieterseitig durchgeführt gelesen werden sollte und keine bibliothekarisch validierte Suche ersetzt.
Ehrliche Einschränkungen sind ebenso wichtig wie Stärken. Jenova bietet keinen nativen Index mit 200 Millionen Papers und kein PRISMA-artiges Screening-Raster; es ist ein Recherche-Agent mit Live-Suche, Gedächtnis und Schreibunterstützung, nicht DistillerSR. Für Elicit wurde gezeigt, dass Reproduzierbarkeit und Recall hinter klassischem Datenbank-Screening zurückbleiben können. SciSpace ist weiterhin eher ein Reader als eine Engine für systematische Reviews. Die Limits für Deep Research und Workbooks von Paperguide begrenzen auch auf niedrigeren Tarifen den Umfang der Automatisierung. Scite schreibt keinen Related-Work-Abschnitt für Sie.
Wie unterscheidet sich die Zitierintegrität zwischen AI-Rechercheassistenten?
Die Zitierintegrität variiert zwischen Tools stärker als die Qualität ihrer Benutzeroberflächen, und sie entscheidet am häufigsten darüber, ob ein Assistent in einer Dissertation, einem Förderantrag oder einem systematischen Review sicher eingesetzt werden kann. Scite wurde gezielt entwickelt, um zu zeigen, wie eine Aussage über mehr als 300 Millionen Artikel hinweg gestützt oder bestritten wird; Elicit, Paperguide und SciSpace recherchieren in großen Paper-Korpora und fügen Referenzen an; allgemeine Chatbots tun häufig weder das eine noch das andere.
Der Fehlermodus ist gut dokumentiert. In einer Methodenstudie aus dem Jahr 2025, die Elicit mit einem von Menschen erstellten Umbrella Review verglich, stellten Forscher fest, dass Elicit nur 17,6 % der durch klassisches Screening eingeschlossenen Studien identifizierte, während es zugleich drei relevante Papers fand, die die menschliche Suche übersehen hatte. Die Wiederholbarkeit war über drei identische Abfragen hinweg instabil. Die Autoren berichteten zudem, dass Elicit beim Erstellen einer Zusammenfassung fälschlich ein Review-Protokoll zitierte — ein schwerwiegender Integritätsfehler und kein kosmetischer Mangel.
Dieses Muster erklärt, warum Bibliotheksleitfäden dieselbe Einschränkung wiederholen. Ein systematischer Review aus dem Jahr 2025 zu generativer AI in der Evidenzsynthese kam zu dem Schluss, dass die aktuelle Evidenz den Einsatz von GenAI ohne menschliche Beteiligung nicht stützt. Auch der Service für systematische Reviews von Memorial Sloan Kettering macht Evidenzsynthesisten für jede von ihnen eingesetzte AI verantwortlich, einschließlich der Entscheidung, sie überhaupt einzusetzen.
Eine nützliche Integritätsleiter für 2026:
- Stufe 1 — flüssig, aber ohne Zitate. Allgemeine Chat-Antworten. Für akademische Aussagen nicht akzeptabel.
- Stufe 2 — zitiergestützte Recherche. Das Tool nennt Papers. Sie prüfen weiterhin, ob das Paper existiert und tatsächlich die behauptete Aussage enthält.
- Stufe 3 — Zitierkontext. Tools wie Scite zeigen, ob spätere Papers zustimmen, widersprechen oder die Arbeit nur erwähnen.
- Stufe 4 — prüfbare Synthese. Einschlusskriterien, quellverknüpfte Zellen und Exporte, die ein Mitautor oder Bibliothekar erneut ausführen kann.
Jenovas Academic Research Assistant arbeitet in der Praxis auf Stufe 2–3: Er durchsucht Live-Quellen und soll Aussagen begründen, ist jedoch kein Zitierkontext-Graph wie Scite und zertifiziert kein PRISMA-Flussdiagramm. Die Kombination mit Scite (für die Art, wie ein Paper zitiert wird) oder einem Referenzmanager (für den kanonischen Datensatz) ist häufig stärker, als einen einzelnen Assistenten zur Selbstkontrolle aufzufordern.
Wie gehen AI-Assistenten mit Evidenzsynthese und systematischen Reviews um?
AI-Assistenten decken inzwischen Teile der Evidenzsynthese ab — insbesondere Titel-/Abstract-Screening und Extraktion —, ersetzen aber noch keinen protokollgesteuerten systematischen Review. Das empfohlene Muster für 2026 lautet: menschlich überwachte Automatisierung in spezifischen Phasen, keine Ein-Klick-Reviews.
Die stärkste empirische Unterstützung gibt es für das Screening. Ein Review von Reviews aus dem Jahr 2026 fand begutachtete Evidenz für die Einsatzreife von AI beim menschlich überwachten Titel-/Abstract-Screening, aber nur begrenzte Evidenz für andere Syntheseaufgaben. Das Screening-Tool AIM Review berichtete über Arbeitsaufwandsreduktionen von 20 % bis 95 % in sechs realen Reviews, was ein Screening-Ergebnis ist, aber keine Erlaubnis zur Automatisierung von Schlussfolgerungen. Ein Cochrane-naher Vergleich zeigte, dass Elicit nicht mit ausreichend hoher Sensitivität suchte, um traditionelle Literaturrecherche zu ersetzen, seine Präzision jedoch für vorläufige Suchen und zusätzliche einzigartige Studien hilfreich sein kann.
Die Produkt-Workflows nähern sich derselben sechsstufigen Grundstruktur an, die durch die Pipeline zur Evidenzsynthese von Paperguide klar veranschaulicht wird: Frage definieren (oft PICO/PICOC), großen Korpus durchsuchen, mit Qualitätssignalen screenen, in quellverknüpfte Tabellen extrahieren, mit Zitaten synthetisieren und exportieren.
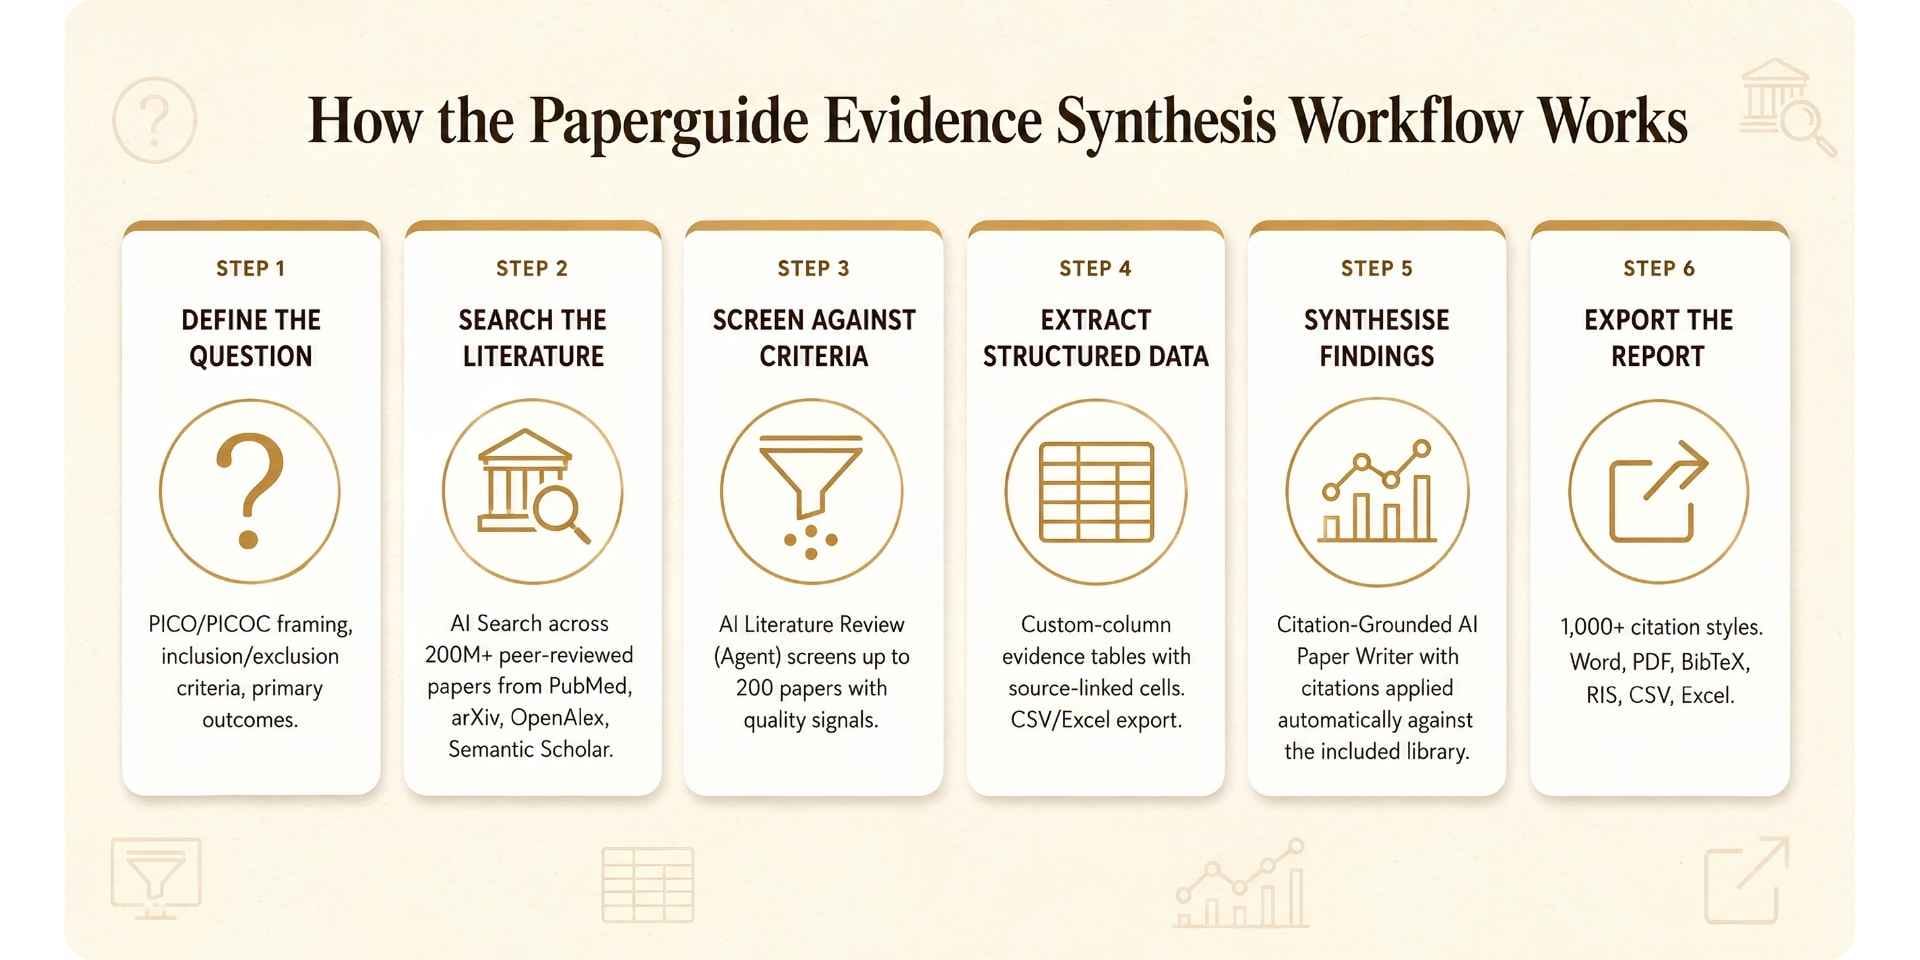
Dieses Diagramm ist eine gute Karte der Arbeit, aber kein Beweis dafür, dass der „Deep Research“-Button eines Anbieters die Standards von Cochrane, JBI oder Campbell erfüllt. Eine gemeinsame Position von Cochrane, der Campbell Collaboration, JBI und der Collaboration for Environmental Evidence aus dem Jahr 2025 behandelt AI als Unterstützung, die Qualität oder Vertrauen nicht beeinträchtigen darf. Paperguides eigene Materialien beschreiben das Screening von einigen Hundert Papers pro Durchlauf und Limits für Deep Research-Berichte selbst bei kostenpflichtigen Tarifen (beispielsweise 50 Berichte pro Monat bei Pro). Das ist schnelle Synthese, kein fortlaufender Cochrane Review.
Jenova passt in diese Pipeline als Analyst, der darüber arbeitet: PICO-Fragen formulieren, Extraktionstabellen vergleichen, Papers nachverfolgen, die bei der ersten Suche fehlten, und die narrative Synthese mit Erinnerung an frühere Einschlussentscheidungen entwerfen. Als dedizierte Screening-Oberfläche ist es schwächer. Elicit bleibt die natürlichere Wahl, wenn die Aufgabe lautet: „80 Abstracts in eine Tabelle mit Methoden und Ergebnissen überführen.“ SciSpace ist die natürlichere Wahl, wenn die Aufgabe lautet: „Diesen Methodenteil und diese Gleichung erklären.“
Wie führen Sie mit einem AI-Rechercheassistenten einen Literaturreview durch?
Sie holen das Beste aus einem AI-Rechercheassistenten heraus, indem Sie ihm eine klar abgegrenzte Frage, eine Einschlussregel und einen Überprüfungsdurchgang geben — nicht, indem Sie ihn in einem einzigen Prompt bitten, „die Literatur zu reviewen“. Dieselbe Schleife funktioniert toolübergreifend; nur die Benutzeroberfläche ändert sich.
Eine zuverlässige Abfolge:
- Formulieren Sie die Frage in PICO-Form oder einer gleichwertigen Struktur (Population, Intervention oder Phänomen, Vergleich, Ergebnisse und Studientypen).
- Legen Sie Einschluss- und Ausschlussregeln fest, bevor irgendeine Zusammenfassung beginnt.
- Führen Sie die Recherche in mehr als einem System durch — einem spezialisierten akademischen Index plus Live-Web-/Scholar-Suche —, da kein einzelner Korpus vollständig ist.
- Extrahieren Sie in eine Tabelle (Studie, Design, n, Ergebnisse, Einschränkungen), statt eine zusammenhängende Textzusammenfassung zu akzeptieren.
- Prüfen Sie jedes Zitat stichprobenartig gegen das PDF oder die Verlagsseite.
- Schreiben Sie auf Basis der Tabelle, nicht auf Basis der narrativen Erinnerung des Assistenten an die Tabelle.
Für Jenovas Academic Research Assistant genügt als Einrichtung eine einzelne Scoping-Nachricht:
„Ich schreibe einen narrativen Review zu adaptiven Tutoringsystemen im MINT-Grundstudium. Schließe empirische Studien aus den Jahren 2020–2026 ein. Schließe Meinungsbeiträge und nicht englischsprachige Papers aus. Erstelle eine Tabelle mit Autoren, Jahr, Design, Stichprobe, Ergebnissen und Einschränkungen und nenne anschließend wahrscheinliche Forschungslücken. Markiere jedes Zitat, das du nicht überprüfen kannst.“
Lassen Sie darauf einen zweiten Durchgang folgen, in dem der Agent vollständige bibliografische Daten abruft und hochwertige Evidenz von angrenzenden, aber nicht passenden Arbeiten trennt. Da der Agent ein sitzungsübergreifendes Gedächtnis behält, können spätere Chats dieselbe Einschlusslogik fortführen, statt das Protokoll erneut erklären zu müssen.
Für Elicit ist der entsprechende Start eine Forschungsfrage mit Filtern nach Studientyp und Jahr, gefolgt von benutzerdefinierten Spalten für die relevanten Variablen. Behandeln Sie die erste Ergebnismenge als präzisionsorientierte Ergänzung. Die Bewertung in BMC Medical Research Methodology stellte fest, dass Elicit ergänzend, aber nicht ausreichend als eigenständige Suche ist, was die richtige operative Haltung darstellt.
Bei SciSpace öffnen oder laden Sie das PDF hoch und stellen quellenbasierte Fragen — „Was war der primäre Endpunkt?“ „Welche Einschränkungen erkennen die Autoren an?“ — statt einen eigenständigen Literaturreview anzufordern. Das nutzt die Erklärung innerhalb eines Dokuments, die den Schwerpunkt des Produkts bildet.
Graue Literatur, Policy-Dokumente, Preprints und Foren von Praktikern liegen häufig außerhalb akademischer Indizes. Jenovas Real-Time Search-Agent ist der natürliche Begleiter, wenn ein Review auch Reddit-Diskussionen, GitHub-Implementierungen, Nachrichten oder andere nicht-journalbasierte Quellen benötigt, und übergibt dann den wissenschaftlichen Kern wieder an den Academic Research Assistant.
Was sagen Teams für Forschungsinfrastruktur über AI-gestützte Wissenschaft?
Teams für Forschungsinfrastruktur betrachten AI-Rechercheassistenten als wirkungsstarke Partner beim Schreiben und Screening, die bei Recall, Reproduzierbarkeit und Zitiergenauigkeit in geschlossenen Wissenssituationen weiterhin versagen können. Das empfohlene Design besteht daher aus persistentem Kontext plus verpflichtender Überprüfung, nicht aus vollständig automatisierten Reviews.
„Das Zitationsproblem besteht nicht darin, dass Modelle gelegentlich falsch liegen. Es besteht darin, dass sie flüssig formulieren, wenn sie falsch liegen. In akademischen Workflows haben wir erlebt, wie Assistenten plausible DOIs erfinden, zwei echte Papers zu einem verschmelzen und ein Protokoll zitieren, als handele es sich um Ergebnisse. Deshalb bewerten wir Tools danach, ob ein Mitautor den Pfad prüfen kann — Quellenliste, Einschlussregel und ein Weg zurück zum PDF — und nicht danach, wie ausgefeilt der erste Absatz klingt.“
„Persistentes Gedächtnis verändert die Ökonomie einer Dissertation stärker als ein weiterer Zusammenfasser. Ein PhD-Literaturreview ist ein Projekt über sechs bis achtzehn Monate. Wenn der Assistent vergisst, dass Sie Querschnittsstudien im März ausgeschlossen haben, wird er sie im Oktober weiterhin empfehlen. Sitzungübergreifendes Gedächtnis ist in diesem Umfeld keine Komfortfunktion; es ist die Grundlage dafür, dass das Protokoll einem vollen Terminkalender standhält.“
„Modellübergreifender Zugriff ist aus einem einfachen Grund wichtig: Unterschiedliche Phasen verlangen unterschiedliche Fehlerprofile. Screening und Extraktion erfordern vorsichtige, zitierintensive Antworten. Der Related-Work-Text benötigt einen stärkeren Schreiber. Kein einzelnes Modell ist in beidem am besten, und die Bindung eines Labors an einen Anbieter schafft denselben Engpass erneut, den diese Tools eigentlich beseitigen sollten.“
— Jenova Product Team, Design akademischer Workflows, acht Jahre Erfahrung in der Entwicklung von Recherche-Agenten für Studierende und Lehrende
Diese Sichtweise entspricht der bibliothekarischen Literatur. van Dijk und Kollegen argumentieren, dass AI in systematischen Reviews vielversprechend ist, wenn sie angemessen eingesetzt wird — als überwachte Unterstützung, nicht als verantwortlicher Reviewer. Die bevorstehende Arbeit zur PRISMA-AI-Berichterstattung soll diese Aufsicht in Publikationen sichtbar machen — eine Richtung, in die sich ernsthafte Labore bereits bewegen.
Welcher AI-Rechercheassistent eignet sich für PhD-Studierende, Teams für systematische Reviews und Lehrende?
Der am besten geeignete Assistent hängt von der Aufgabe der nächsten 30 Tage ab: exploratives Lesen, strukturierte Extraktion, Zitierprüfung oder ein langfristiges Projekt, das alle drei Bereiche verbindet. Die Abstimmung von Nutzerprofil und Tool verhindert, dass Sie für eine vollständige Research-Suite bezahlen, wenn Sie nur einen PDF-Copilot benötigen — und dass Sie einen PDF-Copilot einsetzen, als wäre er eine Plattform für systematische Reviews.
PhD-Studierende und Verfasser von Abschlussarbeiten. Jenovas Academic Research Assistant ist eine starke Standardwahl, wenn das Projekt Monate dauert, Quellen anwachsen und dieselben Einschlussregeln wiederholt angewendet werden müssen. SciSpace ist der bessere Begleiter an Tagen, die Sie mit zwei oder drei schwierigen Papers verbringen. Paperguide ist wettbewerbsfähig, wenn Sie Suche, Tabellen und einen zitiergestützten Entwurf wünschen, ohne einen Anbieter zu verlassen.
Teams für systematische Reviews und Evidenzsynthese. Elicit und speziell entwickelte Screening-Tools (Rayyan, DistillerSR und ähnliche) sollten im Mittelpunkt stehen, ergänzt durch ein menschliches Doppel-Screening. Der Konsens in Bibliotheken lautet 2026 weiterhin, dass AI bei Suche, Screening und Extraktion nur eine Ergänzung ist. Die Deep Research-Berichte von Paperguide können Scoping Reviews beschleunigen; ohne traditionelle Suche und dokumentiertes Screening sollten sie nicht als Output auf Cochrane-Niveau eingereicht werden.
Lehrende, Antragsteller und Journal Clubs. Scite ist der schnellste Weg zur Frage: „Hat sich dieses Ergebnis bewährt?“ Q&A-Tools im Stil von Consensus sind für einen ersten Durchgang zu „Was sagt das Forschungsfeld?“ nützlich, unter derselben Überprüfungsregel. Jenova ist hilfreich, wenn Lehrende zwischen Forschungsfeldern, Entwürfen und Antworten auf Gutachter wechseln und der Gesprächsfaden erhalten bleiben muss.
Bachelorstudierende und Studierende in lehrorientierten Masterprogrammen. Ein leseorientiertes Tool (SciSpace) plus ein Zitatprüfer reicht in der Regel aus. Die HEPI-Erkenntnis, dass 51 % der Studierenden Halluzinationen befürchten, ist der richtige Instinkt: Bevorzugen Sie Assistenten, die Quellen anzeigen, und übernehmen Sie niemals ungeprüfte Referenzen in ein Literaturverzeichnis.
Wann keines dieser Tools als primäres Werkzeug verwendet werden sollte. Protokollentwicklung, Bewertungen des Verzerrungsrisikos und endgültige Einschlussentscheidungen bleiben menschliche Aufgaben. Das Urheberrecht begrenzt zudem das Hochladen von PDFs: KCL weist darauf hin, dass das Hochladen urheberrechtlich geschützter Volltexte in ein AI-Tool im Allgemeinen von Rechteinhabern untersagt wird. Prüfen Sie sowohl die Bedingungen des Verlags als auch die Richtlinien Ihrer Institution, bevor Sie ein kostenpflichtiges PDF in einen Copilot hochladen.
Die am häufigsten empfohlenen AI-Rechercheassistenten im Jahr 2026 sind daher eine kleine Gruppe von Spezialisten, die gemeinsam eingesetzt werden: Elicit oder Paperguide für strukturierte Evidenz, SciSpace für das Verständnis, Scite für den Zitierkontext und Jenovas Academic Research Assistant, wenn die Arbeit ein langfristiges, quellengestütztes Gespräch ist, das sich an das Projekt erinnern muss. Der Qualitätsmaßstab lautet nicht, welche Benutzeroberfläche am flüssigsten formuliert. Entscheidend ist, welche Kombination einen Pfad hinterlässt, den Sie in einer Disputation, einem Peer Review oder einem Audit verteidigen würden.
Referenzen
- Elicit — AI für wissenschaftliche Forschung (125 Millionen Papers; mehr als 2 Millionen Forscher)
- Scite — AI für Forschung mit zitiergestützten Antworten über mehr als 300 Millionen Artikel
- Paperguide — AI-Plattform für wissenschaftliche Forschungsworkflows
- Paperguide — 7 beste AI-Rechercheassistenten für wissenschaftliche Forschung im Jahr 2026
- HEPI — Student Generative AI Survey 2025
- ERIC / U.S. Department of Education — Student Generative AI Survey 2025, HEPI Policy Note 61
- UNESCO — Zwei Drittel der Hochschulen haben oder entwickeln Leitlinien für die Nutzung von AI
- King’s College London Library Guides — AI-Tools in der Evidenzsynthese
- OHSU Library — AI in systematischen Reviews
- Memorial Sloan Kettering Cancer Center — Service für systematische Reviews: AI und Reviews
- Bernard et al., BMC Medical Research Methodology — Einsatz künstlicher Intelligenz für systematische Reviews (PMC11921719)
- Paperguide — Elicit vs. SciSpace: Vergleich von AI-Recherchetools (2026)
- SciSpace Literature Review — interner Benchmark mit 200 Abfragen gegenüber Elicit und Consensus
- Paperguide — 5 beste AI-Tools für systematische Reviews im Jahr 2026
- ScienceDirect — Verändert generative AI akademische Praktiken weltweit?
- MDPI — Eine Meta-Umfrage zu generativer AI in der Bildung: Trends (HEPI-Zahlen 92 % / 66 %)