KI-Chat mit Vektorspeicher: Persistente semantische Erinnerung für Agenten
2026-09-15
Jenova bietet Ihnen KI-Chat mit Vektorspeicher — Unterhaltungen, die sich an Bedeutung statt nur an die letzten Nachrichten erinnern. Im September 2026 vergessen die meisten Assistenten noch immer Präferenzen, verlieren Projektkontext und zwingen Sie dazu, dieselben Dateien erneut zu erklären. Diese Plattform speichert Dialoge, Dokumente und Präferenzen, damit spezialisierte Agenten den passenden Kontext abrufen können, wenn Sie fragen.
✅ Persistenter Speicher über Sitzungen hinweg statt eines sich selbst löschenden Gleitfensters ✅ Semantischer Abruf statt Schlüsselwörtern — finden Sie, was Sie meinten, nicht nur, was Sie eingetippt haben ✅ Wissensbasen, die Sie einmal anhängen und für Recherche, Code und Schreiben wiederverwenden ✅ Dasselbe Speichermodell im Web, auf iOS und Android
Zustandsloser Chat ist im Betrieb günstig und in der Nutzung teuer. Um zu verstehen, warum Vektorspeicher heute im Zentrum nützlicher KI-Chats steht, hilft ein Blick darauf, wie Embeddings, Abruf und Langzeitkontext in der täglichen Arbeit tatsächlich scheitern.
Kurzantwort: Was ist KI-Chat mit Vektorspeicher?
KI-Chat mit Vektorspeicher ist ein Abrufsystem, das die Bedeutung von Unterhaltungen als Embeddings speichert, damit eine AI relevanten Kontext, Dokumente und Präferenzen über Sitzungen hinweg abrufen kann. Es ist der Unterschied zwischen einem Chatbot, der jeden Thread neu beginnt, und einem Agenten, der die Arbeit fortsetzt.
Wichtige Funktionen:
- Nachrichten, Dateien und Fakten als Vektoren für Ähnlichkeitssuchen einbetten
- Nur die relevantesten Erinnerungen in das Kontextfenster des Modells holen
- Unbegrenzten Chatverlauf und sitzungsübergreifende Präferenzen auf einer Plattform bewahren
- Antworten in angehängerten Wissensbasen statt in parametrischen Vermutungen verankern
- Denselben Speicher von einer Sitzung am Schreibtisch aufs Smartphone übertragen, ohne den Agenten erneut einzuweisen
Warum die meisten KI-Chats noch immer vergessen
Große Sprachmodelle sind starke Schlussfolgerer und schwache Archivare. Ihre Gewichte enthalten allgemeines Wissen; sie enthalten nicht Ihren Backlog, Ihr Schema oder Ihre letzte Entscheidung. Retrieval-Augmented Generation existiert gerade deshalb, weil parametrisches Gedächtnis für eine private Domäne inkonsistent und schwer zu aktualisieren ist — ein Punkt, der in einer Übersicht zu RAG-Architekturen aus dem Jahr 2025 zusammengefasst wird.
Die Nachfrage der Branche nach dieser Abrufebene ist längst nicht mehr experimentell:
2.652,1 Mio. USD → 8.945,7 Mio. USD — Prognostizierter globaler Markt für Vektordatenbanken von 2025 bis 2030 bei einer CAGR von 27,5 %
Diese Ausgaben sind ein Symptom. Teams kaufen Vektorinfrastruktur, weil Chat ohne Speicher immer wieder auf dieselben Arten scheitert:
- Kontextfenster laufen über, sodass ältere Entscheidungen mitten im Projekt verschwinden
- Die Schlüsselwortsuche verfehlt Paraphrasen, Synonyme und implizite Absichten
- Selbst entwickelte RAG-Stacks aus Chunking, Indizes, Evaluierung und Authentifizierung kommen vor der Produktion ins Stocken
- Personalisierung bleibt im Chatverlauf eines einzigen Anbieters gefangen
- Antworten driften ab, wenn das Modell sich nicht auf Ihre Dateien stützen kann
Doch dauerhaften, privaten und semantisch durchsuchbaren Speicher in den alltäglichen Chat zu integrieren, ist noch immer frustrierend schwierig:
Kontextfenster sind kein Speicher
Ein Kontextfenster ist ein Puffer, kein Archiv. Gesprächsverlauf, eine Nutzerfrage und einige „gespeicherte Fakten“ werden zu einem Prompt zusammengefügt; alles, was nicht hineinpasst, wird verworfen. Deshalb vergisst ein Coding-Agent den Fehler, den Sie gestern eingefügt haben, und ein Tutor fragt erneut nach Ihrer Zielpunktzahl. Vektorspeicher liegt außerhalb des Fensters: Er ruft zur Inferenzzeit einen kleinen, relevanten Ausschnitt ab, statt zu hoffen, dass das vollständige Transkript noch hineinpasst.
Die Schlüsselwortsuche kann Bedeutung nicht abbilden
Klassische Suche belohnt exakte Tokens. Vektorsuche vergleicht Embeddings — hochdimensionale numerische Repräsentationen von Bedeutung — anhand von Metriken wie Kosinusähnlichkeit oder euklidischer Distanz. Embeddings plus ein Vektorindex bilden die Abrufebene, die moderne LLM-Anwendungen ermöglicht. Ohne diese Ebene ruft „Personalplan für Q3“ nicht die Notiz ab, die Sie „Headcount für den Herbst“ genannt haben.
Selbst entwickeltes RAG ist ein Infrastrukturprojekt
Eine produktive Abrufpipeline benötigt eine Chunking-Strategie, die Wahl der Embeddings, einen ANN-Index, Metadatenfilter, Evaluierung und Aktualisierungsjobs. Veröffentlichte ANN-Benchmarks zeigen, warum Teams darauf achten: Engines werden gleichzeitig hinsichtlich Latenz, Durchsatz und Präzision verglichen, denn Geschwindigkeit ohne Recall ergibt ein anderes Produkt. Die meisten Menschen, die einfach einen Chat möchten, der sich erinnert, sollten diesen Stack nicht betreiben müssen.
Personalisierung ohne portablen Speicher ist fragil
Stanford’s Digital Economy Lab argumentiert, dass nachhaltige Vorteile in der AI aus persistentem, nutzergesteuertem persönlichem Kontext entstehen werden — nicht aus einem weiteren isolierten Chatbot. Heute ist Speicher meist eine Funktion eines Anbieters: Er begleitet Sie nicht, und er kann unbemerkt beeinflussen, was Ihnen angezeigt wird. Die Berichterstattung der Columbia Journalism Review über Chatbot-Speicher stellt fest, dass die Erinnerung an Nutzende die Informationen verändern kann, die Menschen erhalten.
Genau dafür wurde Jenova entwickelt.
Die Jenova-Lösung
Jenova behandelt KI-Chat mit Vektorspeicher als Standard und nicht als Zusatzfunktion, die Sie später anbinden müssen. Unbegrenzter Chatverlauf, persistenter sitzungsübergreifender Speicher und anbindbare Wissensbasen stehen jedem spezialisierten Agenten zur Verfügung. Sie sprechen in natürlicher Sprache; die Plattform ruft die passenden Embeddings, Werkzeuge und Dateien ab, bevor das Modell antwortet.
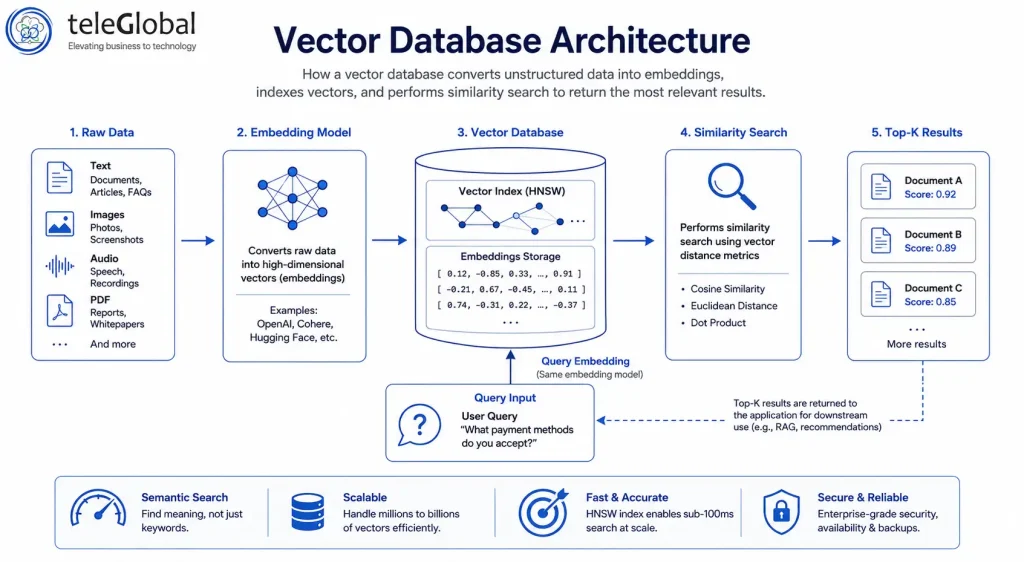
Das obige Diagramm zeigt die Mechanik hinter dieser Erfahrung: Unstrukturierter Text, Bilder und Dokumente werden zu Embeddings, landen in einem Vektorindex und werden als Top-k-Treffer für eine Abfrage zurückgegeben. Sie konfigurieren keine HNSW-Parameter und wählen keine Distanzmetrik. Sie beginnen einfach einen Chat.
| Herkömmlicher Ansatz | Jenova |
|---|---|
| Dieselbe Kurzbeschreibung in jeden neuen Chat einfügen | Persistenter Speicher über Sitzungen und Agenten hinweg |
| Schlüsselwortsuche über Notizen und PDFs | Semantischer Abruf über Embeddings |
| Vektordatenbank, Embedding-Modell und RAG-Evaluierung selbst hosten | Vollständig verwaltete Speicherung und Abruf |
| Ein Modellanbieter, ein Speichersilo | Zugriff auf mehrere Modelle mit gemeinsamem Kontext |
| Nur Desktop-Verlauf, der auf Mobilgeräten nicht verfügbar ist | Volle Gleichwertigkeit im Web, auf iOS und Android |
Recherche, die sich aufbaut, statt neu zu beginnen
Literaturübersichten und Marktanalysen scheitern, wenn der Assistent die Arbeiten nicht erinnert, die Sie bereits abgelehnt haben. Real-Time Search liefert Live-Ergebnisse von Google, Reddit, YouTube, GitHub und weiteren Quellen, während Vektorspeicher Ihre Aufnahmekriterien, bisherigen Zitate und Regeln wie „diese Quelle nicht verwenden“ aktiv hält. Sie starten nicht jeden Morgen eine neue Boolesche Suchanfrage; Sie führen eine abrufgestützte Untersuchung fort.
Codebasen, die der Agent wirklich kennt
Python Coding Assistant ist am ersten Tag für ein Skript nützlich. Dauerhaft wertvoll wird er am zwölften Tag, wenn er noch immer Ihre Paketstruktur, den instabilen Test, den Sie übersprungen haben, und den API-Vertrag kennt, den Sie letzte Woche festgelegt haben. Hängen Sie die Repository-Notizen oder ein Designdokument einmal an. Nachfolgende Prompts rufen diesen Kontext ab, statt eine parallele Architektur zu erfinden.
Schreiben, das Stimme und Fakten bewahrt
Entwürfe scheitern im zustandslosen Chat, weil Tonalität, unerwünschte Formulierungen und URLs maßgeblicher Quellen aus dem Fenster verschwinden. Ein auf Schreiben ausgerichteter Agent auf der Plattform kann Ihre Stilbeispiele und Gliederungsentscheidungen als Speicher ablegen und sie dann abrufen, wenn Sie sagen: „Gleiche Stimme wie beim Launch-Post.“ Zusammen mit Dokumentanhängen schafft das redaktionelle Kontinuität durch Vektorspeicher — nicht durch einen größeren Prompt.
Alltag und Lernen, die nicht zurückgesetzt werden sollten
Coaching und Sprachtraining funktionieren nur, wenn der Agent Einschränkungen erinnert: Verletzungen, Prüfungstermine, Vokabular, das Sie bereits beherrschen. Persistenter Speicher macht aus einem allgemeinen Tutor einen, der Übungen der ersten Woche nicht ständig wiederholt. Derselbe Speicher, der einen Python-Traceback abruft, kann auch die Tatsache abrufen, dass Sie mit Rollenspielen besser lernen als mit Grammatiktabellen.
Testen Sie die Plattform kostenlos — keine Kreditkarte erforderlich.
Spezialisierte AI-Agenten für KI-Chat mit Vektorspeicher
Speicher ist nur so nützlich wie der Workflow, dem er dient. Diese Agenten sind für Aufgaben konzipiert, bei denen Vergessen teuer ist — lange Recherchevorhaben, wiederkehrende Logistik, intensive Praxis und charaktertreues Spiel.
Deep Research
Mehrstündige Recherche ist der Musterfall für KI-Chat mit Vektorspeicher. Dieser Agent durchsucht Hunderte von Quellen, fasst Erkenntnisse mit Inline-Zitaten zusammen und liefert Berichte, die Sie morgen fortsetzen können, ohne die Frage erneut einzugrenzen.
- Speichert die Forschungsfrage, ausgeschlossene Quellen und die Arbeitsthese
- Ruft frühere Erkenntnisse ab, damit spätere Abschnitte früheren nicht widersprechen
- Verankert Aussagen in zitiertem Material statt allein in der Erinnerung des Modells
Academic Research Assistant
Promotions- und Hochschulworkflows erstrecken sich über Monate voller Literatur, Zitierstile und Manuskriptversionen. Der Assistent entdeckt Arbeiten in wichtigen Datenbanken und hilft bei der Manuskriptvorbereitung, während der Speicher Zielpublikation, Methodik und bereits Gelesenes bewahrt.
- Literaturrecherche in Echtzeit über akademische Repositorien hinweg
- Zitat- und Manuskriptunterstützung für Ihren fortlaufenden Entwurf
- Kontinuität über verwandte Arbeiten hinweg statt einmaliger Chatantworten
Personal Secretary
Logistik ist ein Speicherproblem: wiederkehrende Dienstleister, Reisepräferenzen, wer das Freitags-Update erhält. Dieser Agent koordiniert Kalender, E-Mail und tägliche Abläufe mit umfassendem persönlichem Kontext, sodass Sie Ihre Routine nicht jeden Montag erneut erklären müssen.
- Erinnert sich an feste Präferenzen und Menschen, mit denen Sie arbeiten
- Verbindet die Planung mit den Werkzeugen, die Sie bereits verwenden
- Überträgt Kontext von einem Morgenbriefing in das Nachfassen am Nachmittag
Roleplay Game Master
Narrative Konsistenz ist ohne Langzeitspeicher unmöglich. Dieser Agent ist für immersives Rollenspiel mit unbegrenztem Speicher und stabilen Charakteren ausgelegt — Plotzusagen, Fraktionsnamen und Tonalität werden nicht zurückgesetzt, wenn das Kontextfenster übergelaufen wäre.
- Unbegrenzter Speicher für Handlungsstatus und Charakterstimmen
- Abruf früherer Szenen, wenn ein späteres Kapitel sie benötigt
- Kreative Vielfalt ohne Verlust der Kontinuität
Learn Russian Through Roleplay
Spracherwerb beruht auf verteiltem, persönlichem Kontext: Wörtern, die Sie verpasst haben, dem gewünschten Formalitätsgrad und Geschichten, die Sie bereits erlebt haben. Dieser Mentor nutzt unbegrenzte Szenarien und unbegrenzten Speicher, sodass Übungen aufeinander aufbauen, statt Anfängerskripte zu wiederholen.
- Erinnert sich an Ihre Wortschatzlücken und bevorzugten Szenariotypen
- Hält Figuren und Setting über Sitzungen hinweg konsistent
- Macht jede Unterhaltung zu abrufgestützter Übung
So funktioniert KI-Chat mit Vektorspeicher
Sie müssen keine Vektordatenbank bereitstellen. Sie beginnen eine Unterhaltung; die Plattform übernimmt Embeddings, Abruf und das Kontextfenster.
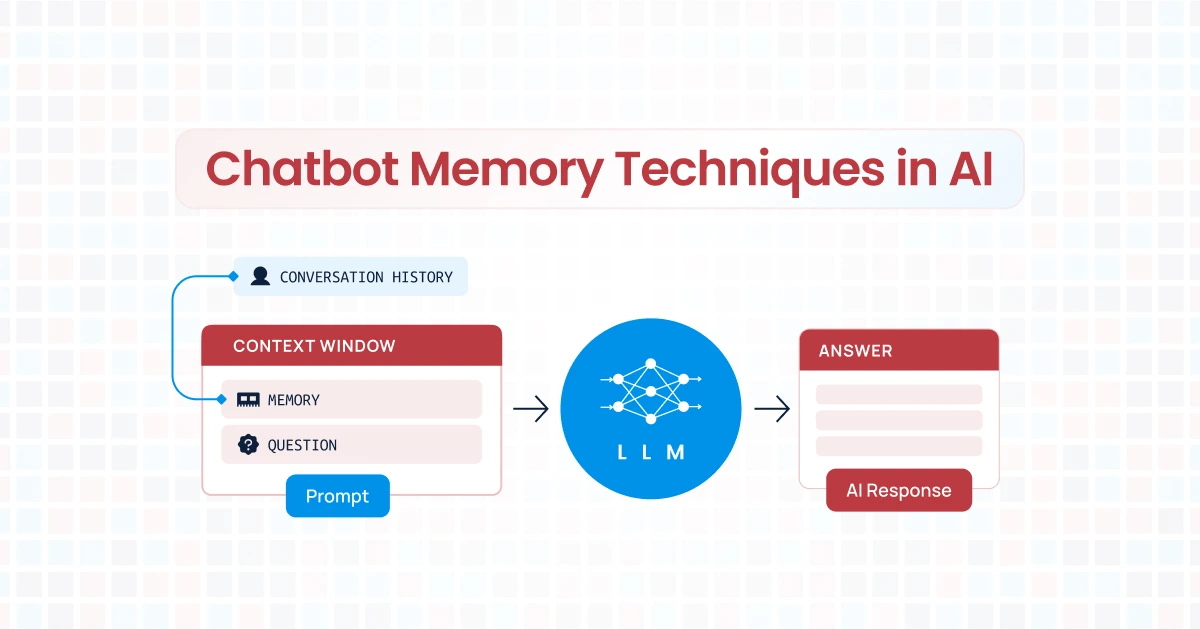
Das zweite Diagramm zeigt den für Nutzende sichtbaren Kreislauf. Verlauf, gespeicherte Erinnerungen und die neue Frage werden zu einem Prompt zusammengestellt; das Modell antwortet. Der Vektorabruf entscheidet, welche Erinnerungen in diesen Prompt gehören, damit das Fenster fokussiert bleibt.
Schritt 1: Einen Agenten öffnen und das Ziel formulieren Wählen Sie den Spezialisten für die Aufgabe — Recherche, Code, Reisen oder Nachhilfe — und sagen Sie, wie „fertig“ aussieht. Auch die erste Nachricht wird wie alles Folgende zu einem Embedding.
„Ich schreibe eine systematische Übersichtsarbeit über Retrieval-Augmented Generation. Bevorzugen Sie Übersichtsarbeiten ab 2024, schließen Sie Anbieterblogs aus und verwenden Sie den IEEE-Zitierstil.“
Schritt 2: Das Wissen anhängen, dem das Modell vertrauen soll Laden Sie Briefings, PDFs, Notizen oder Spezifikationen hoch. Diese Dokumente werden für die semantische Suche indexiert, sodass spätere Fragen Passagen anhand ihrer Bedeutung abrufen. Das ist dasselbe Muster, das Unternehmen heute als RAG-Infrastruktur finanzieren, ohne dass Sie den Index betreiben müssen.
„Verwenden Sie die angehängte Literaturmatrix. Wenn ein Paper als reject markiert ist, zitieren Sie es nicht erneut.“
Schritt 3: Sitzungsübergreifend weiterarbeiten Schließen Sie den Laptop. Stellen Sie am nächsten Tag eine Folgefrage. Persistenter Speicher und unbegrenzter Verlauf bedeuten, dass der Agent den Umfang der Übersicht, die Ausschlussliste und die letzte Gliederungsüberschrift abruft, statt Sie wie einen Fremden zu begrüßen.
„Setzen Sie beim Abschnitt zu den Einschränkungen fort und ziehen Sie die drei Arbeiten heran, die wir für die Diskussion markiert haben.“
Schritt 4: Geräte wechseln, ohne erneut einzuweisen Öffnen Sie denselben Chat auf iOS oder Android. Einstellungen und Verlauf werden synchronisiert. Eine Anfrage unterwegs kann dieselben Vektoren abrufen wie die Sitzung am Schreibtisch — genau dafür ist KI-Chat mit Vektorspeicher da: Kontinuität statt eines neuen Chatsilos für jedes Gerät.
„Auf dem Weg zum Campus — prüfen Sie mich zu den drei RAG-Fehlermodi, die wir gestern aufgelistet haben.“
Ergebnisse und Anwendungsfälle
Vektorspeicher zeigt sich in nicht wiederholten Stunden, nicht in einem Benchmark-Diagramm. Diese Szenarien sind typisch für die Veränderungen, wenn Chat Bedeutung abruft.
📊 Mehrwöchige Literatursynthese
Szenario: Eine Studierende benötigt eine zitierte Übersicht über Arbeiten zur RAG-Robustheit, die alle paar Tage aktualisiert wird, wenn neue Preprints erscheinen.
Herkömmlicher Ansatz: Ein Ordner voller PDFs, eine Tabelle mit Notizen und ein Chatbot, der die Ausschlussliste vergisst. Die Kurzbeschreibung wird in jeder Sitzung erneut eingefügt. Doppelte Zitate oder übersehene Widersprüche passieren leicht.
Deep Research: Die Frage, Ausschlüsse und Arbeitsgliederung bleiben erhalten. Neue Durchläufe rufen frühere Synthesen ab, sodass der Bericht wächst, statt sich aufzuteilen.
- Zitate bleiben mit früheren Abschnitten abgestimmt
- Abgelehnte Quellen bleiben abgelehnt
- Folgefragen sind günstiger als die erste Suche
💼 Ein Python-Dienst über mehrere Sprints hinweg
Szenario: Sie entwickeln einen FastAPI-Dienst mit einer festgelegten OpenAPI-Spezifikation, einem bekannten instabilen Test und einer Bereitstellungsbeschränkung auf Python 3.11.
Herkömmlicher Ansatz: Jeder neue Chat erfindet eine andere Ordnerstruktur. Sie verbringen die ersten zehn Minuten damit, Entscheidungen erneut zu erklären, die das Modell nicht sehen kann.
Python Coding Assistant: Architekturnotizen und die Spezifikation liegen im Speicher und in den Anhängen. Ein Fehlerbericht am Donnerstag ruft die Einschränkungsliste vom Mittwoch ab.
- Weniger widersprüchliche Refactorings
- Das Debugging beginnt mit dem tatsächlichen Stack
- Die Einarbeitung Ihres zukünftigen Selbst oder eines Teammitglieds, das den Thread liest, geht schneller
🎭 Eine Kampagne, die sich nicht selbst widersprechen darf
Szenario: Ein wöchentliches Spiel mit benannten NPCs, einem Geheimnis, das die Gruppe noch nicht kennt, und einer Tonalität, die Sie bereits in Sitzung eins festgelegt haben.
Herkömmlicher Ansatz: Sitzungsnotizen liegen in einer anderen App; der Chatbot zwängt einen neuen Bösewicht hinein, weil er die frühere Zusage nicht abrufen kann.
Roleplay Game Master: Der Handlungsstatus ist Speicher. Wenn ein Spieler ein beiläufiges Detail aus drei Sitzungen zuvor erwähnt, kann der Abruf es wieder in die Szene bringen.
- Charakterstimmen bleiben stabil
- Plotzusagen bleiben auffindbar
- Lange Handlungsbögen bleiben kohärent
📱 Reiseplanung aus der Warteschlange am Flughafen
Szenario: Sie haben am Schreibtisch eine Reise durch drei Städte geplant — Budgetobergrenze, Tage mit vorrangigem Gehen zu Fuß, keine Nachtflüge. Am Gate benötigen Sie eine wetterabhängige Anpassung nur für morgen.
Herkömmlicher Ansatz: Sie machen Screenshots Ihrer eigenen Notizen. Sie hoffen, dass der mobile Chatbot Einschränkungen ableitet, die er nie gesehen hat.
Travel Planning Advisor: Präferenzen und Reiseplan sind bereits im Speicher. Eine Anfrage am Smartphone ruft sie ab und ändert einen Tag, ohne die gesamte Reise neu zusammenzustellen.
- Einschränkungen überstehen den Gerätewechsel
- Lokale Folgefragen bleiben im Budget
- Sie müssen die Kurzbeschreibung nicht an der Fluggastbrücke erneut eintippen
Die Betrachtung realer Nutzung zeigt dasselbe Muster, für das Käufer von Vektordatenbanken in Unternehmen bezahlen: latenzarmer semantischer Abruf bei Live-Fragen, nicht ein größeres Chatfenster.
FAQ
Was ist KI-Chat mit Vektorspeicher?
KI-Chat mit Vektorspeicher speichert Nachrichten, Dateien und Fakten als Embeddings und ruft dann die nächstliegenden Treffer ab, wenn Sie eine Frage stellen. Diese Treffer werden in das Kontextfenster des Modells eingefügt, damit die Antwort Ihren Verlauf und Ihre Dokumente nutzen kann. Bei Jenova ist dieser Abruf in spezialisierte Agenten integriert, statt als separate Datenbank angeboten zu werden, die Sie selbst pflegen.
Ist Jenova für KI-Chat mit Vektorspeicher kostenlos nutzbar?
Ja. Eine kostenlose Stufe umfasst Kernfunktionen mit begrenzter monatlicher Nutzung. Bezahlte Stufen erhöhen das Nutzungskontingent und ergänzen Optionen wie eine individuelle Modellauswahl. Das Nutzungskontingent wird zum Abrechnungsdatum zurückgesetzt; das vollständige Kontingent steht vom ersten Tag an zur Verfügung, statt täglich portionsweise freigegeben zu werden.
Worin unterscheidet sich das von einem Chatbot, der „Erinnerungen speichert“?
Viele Produkte speichern eine kurze Faktenliste oder ein fortlaufendes Transkript. Vektorspeicher ruft anhand semantischer Ähnlichkeit über unbegrenzten Verlauf und angehängertes Wissen hinweg ab, was RAG näherkommt als einer Haftnotiz. Unabhängige Arbeiten über Langzeitspeicher für Agenten in der Produktion behandeln skalierbaren Speicher als eigenes Systemproblem — nicht als Umschalter in den Einstellungen. OpenAI hat außerdem die Fähigkeit von ChatGPT erweitert, auf früheren Chatkontext Bezug zu nehmen; die Architekturfrage lautet, ob Speicher ein Anbietersilo bleibt oder Infrastruktur unter jedem Workflow ist, den Sie ausführen.
Kann ich Chat auf meinen eigenen Dokumenten verankern?
Ja. Hängen Sie die Dateien an, die gegenüber dem Vorwissen des Modells Vorrang haben sollen — Spezifikationen, Lehrpläne, Transkripte oder Markenleitfäden. Dieser Korpus erhält bei verwandten Fragen Vorrang, wodurch Sie Halluzinationen bei privatem Material reduzieren. Ein Writing Assistant kann diese Beispiele weiter für den Ton verwenden; ein Recherche-Agent kann sie weiter für Aussagen nutzen.
Funktioniert KI-Chat mit Vektorspeicher auf Mobilgeräten?
Ja. Web, iOS und Android teilen Verlauf, Einstellungen und Speicher. Sprach-zu-Text steht zur Verfügung, wenn Sie nicht tippen können. Das Reiseszenario oben ist das beabsichtigte Design: Rufen Sie auf dem Smartphone dieselben Vektoren ab, die Sie am Schreibtisch aufgebaut haben.
Ist ein Agent mit Speicher für sensible Themen genau genug?
Speicher verbessert die Konsistenz; er macht ein Modell nicht unfehlbar. RAG-Übersichten nennen weiterhin Abrufqualität, verrauschten Kontext und Faktentreue als offene Probleme (Sharma, 2025). Bei gesundheitlichen, rechtlichen oder finanziellen Entscheidungen sollten Sie den Agenten als Unterstützung betrachten und primäre Quellen prüfen. Ein Personal Therapist kann sich an Themen erinnern, die er für Sie festhalten soll, was für Kontinuität nützlich ist — aber kein Ersatz für lizenzierte Betreuung.
Vektorspeicher ist die Chatoberfläche, die sich endlich aufbaut
Zustandsloser KI-Chat verschwendet die einzige knappe Ressource, die Sie haben: die Zeit, die Sie dafür aufwenden, sich selbst zu erklären. KI-Chat mit Vektorspeicher speichert Bedeutung als Embeddings, ruft sie bei Bedarf ab und ermöglicht spezialisierten Agenten, die Arbeit fortzusetzen. Der Markt für diese Abrufebene wächst, weil das Problem universell ist — von semantischer Suche in Produktionssystemen bis zu persönlichem Kontext, der den Nutzenden gehören sollte.
Jenova stellt diesen Speicher für Recherche, Code, Erzählung und Planung bereit, ohne dass Sie eine Vektordatenbank betreiben müssen. Setzen Sie einen Bericht von Deep Research, einen Python-Dienst oder eine Rollenspielkampagne fort, als wäre der Agent die ganze Zeit im Raum gewesen.
Entdecken Sie die vollständige Agentenbibliothek bei Jenova.
Für Entwickler: Jeder Agent in diesem Artikel ist programmatisch über die Jenova API verfügbar — integrieren Sie Vektorspeicher, Abruf und Multi-Modell-Agenten mit einer einzigen Integration in Ihre App. Vollständige Dokumentation →