Wie sollten Sie Marktdaten in einem AI-Aktienanalyse-Tool verifizieren?
2026-08-24
Welche fünf Herkunftsprüfungen unterscheiden prüfbare AI-Aktienanalysen von nicht verifizierbaren Ergebnissen?
Prüfbare AI-Aktienanalysen sind Ergebnisse, die Sie rekonstruieren können: eine Kursnotierung mit Zeitstempel, eine benannte Primärquelle, eine offengelegte Berechnung, einen sichtbaren Anreiz und eine angegebene Vertrauensgrenze. Im Jahr 2026 trennt dieser Standard Jenova's Fundamental Stock Analyst und zitatbasierte Plattformen wie AlphaSense von Tools, die lediglich eine Investmentthese formulieren. Koyfin und Fiscal.ai können weiterhin nützlich sein, sollten jedoch anhand derselben fünf Prüfungen bewertet werden – nicht anhand der Qualität ihrer Benutzeroberfläche.
Der Fünf-Schichten-Stack für die Integrität der Datenherkunft ist der Bewertungsrahmen dieses Leitfadens:
✅ Zeitintegrität — jeder Kurs, jedes Multiple und jede Schätzung enthält einen Stichtagszeitpunkt, eine Zeitzone und einen Verzögerungsstatus ✅ Quellenzuordnung — Zahlen lassen sich auf eine Börse, Einreichung, einen Datenanbieter oder ein Transkript zurückführen, nicht auf bloße „Marktdaten“ ✅ Transparenz der Transformationen — Formeln, Anpassungen und Neudarstellungen werden ausgeschrieben, nicht nur impliziert ✅ Offenlegung von Anreizen — Vergütung, Affiliate-Bestand und die wirtschaftlichen Interessen von Beitragenden sind sichtbar ✅ Vertrauensgrenzen — das Tool erklärt, was es nicht weiß und wie breit die Unsicherheitsbandbreite ist
Um Tools sinnvoll zu vergleichen, behandeln Sie jede Schicht als Bestanden/Nicht-bestanden-Prüfung und nicht als Funktionscheckliste. Eine überzeugend formulierte Antwort, die in zwei Schichten scheitert, bleibt nicht verifizierbar.
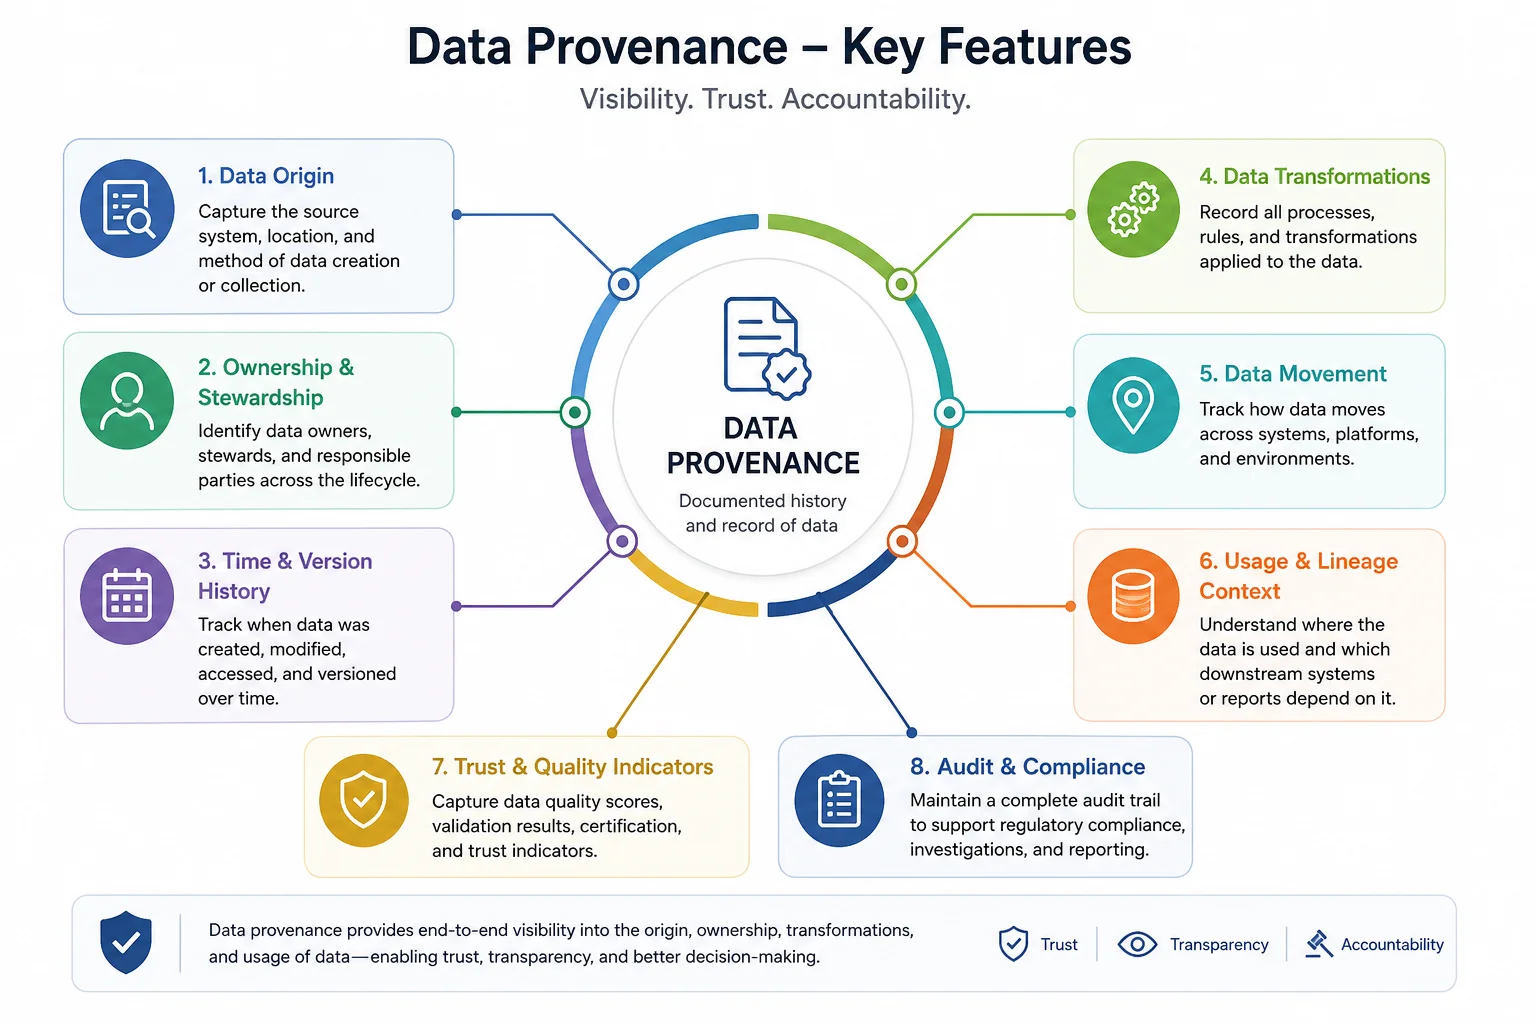
Warum ist die Herkunft von Marktdaten für AI-Aktientools im Jahr 2026 wichtiger?
Die Herkunft von Marktdaten ist 2026 wichtiger, weil generative Modelle eine einzelne veraltete Notierung, eine stille Anpassung oder ein konfliktbehaftetes Ranking auf Tausende Nutzer skalieren können, bevor es einem Menschen auffällt. FINRA hat Mitgliedsunternehmen bereits daran erinnert, dass bestehende Regeln technologieneutral bleiben: Standards für Genauigkeit, Aufsicht und Kommunikation gelten unabhängig davon, ob ein Mensch oder ein Modell den Satz geschrieben hat.
Der kommerzielle Hintergrund ist derselbe. Der Markt für Datenherkunft wurde 2025 auf 5,06 Milliarden USD geschätzt und soll bis 2033 auf 16,72 Milliarden USD anwachsen. Dieses Wachstum folgt einer einfachen operativen Tatsache: Datenherkunft ist die historische Aufzeichnung von Ursprung, Bewegung und Transformation. Ohne sie ist ein AI-Aktientool ein Geschichtengenerator auf einem nicht nachvollziehbaren Datenfeed.
Regulierungsbehörden beobachten denselben Fehlermodus. SEC-Mitarbeiter haben erklärt, dass Haftungsängste eine zentrale Bremse für die Einführung von AI in der Vermögensverwaltung sind, gerade weil Modelle Menschen in eine distanzierte Aufsichtsrolle versetzen. Der Investor Advisory Committee der Commission hat zudem Leitlinien zur AI-bezogenen Offenlegung gefordert, die auf bestehenden Wesentlichkeitsstandards aufbauen. Privatanleger, die AI-Aktientools nutzen, erhalten vom Chatbot keinen 10-K. Sie müssen die entsprechenden Metadaten selbst einfordern.
Wie verifizieren Sie Zeitstempel von Marktdaten in einem AI-Aktienanalyse-Tool?
Sie verifizieren Zeitstempel, indem Sie das Tool dazu zwingen, jede marktsensitive Zahl mit einem Stichtagsdatum und einer Uhrzeit, einer Zeitzone, einem Sitzungsstatus und einer Verzögerungsklasse zu versehen – und diesen Zeitstempel anschließend unabhängig mit einem Primärdatenfeed oder einer Einreichung abgleichen. Ein Kurs ohne Uhrzeit ist keine Tatsache. Er ist ein Screenshot unbekannten Alters.
Fordern Sie für jede Kursnotierung, jedes Multiple und jede Konsensschätzung vier Felder an:
- Stichtagszeitstempel im ISO-8601-Format einschließlich Zeitzone
- Sitzungsstatus — vorbörslich, reguläre Handelszeit, nachbörslich oder offizieller Schlusskurs
- Verzögerungsklasse — Echtzeit, 15 Minuten verzögert, Tagesendwert oder vom Datenanbieter konsolidiert
- Korrekturkennzeichnung — ursprüngliche Notierung, Stornierung oder aufgehobener Trade
Ein praktischer Prompt sieht so aus:
„Nenne NVDA erneut mit letztem Kurs, Volumen und Trailing-P/E. Gib für jede Kennzahl den Stichtagszeitstempel mit Zeitzone, die Sitzung – vorbörslich, regulär oder Schlusskurs –, an, ob der Feed in Echtzeit oder verzögert ist, sowie die Primärquelle. Wenn ein Feld unbekannt ist, schreibe unbekannt.“
Führen Sie anschließend Stichproben durch. Vergleichen Sie den zurückgegebenen Schlusskurs mit der offiziellen Börsennotierung oder dem Datum der jüngsten SEC-Einreichung des Emittenten, nicht mit einem anderen Chatbot. OpenCorporates beschreibt Datenherkunft als die Fähigkeit, jeden Datenpunkt mit Zeitstempeln bis zu seiner offiziellen Quelle zurückzuverfolgen. Das ist der Test. Kann das Tool den Zeitstempel nicht liefern, behandeln Sie die Zahl als illustrativ, nicht als handlungsrelevant.
Jenova's Fundamental Stock Analyst kann angewiesen werden, in jeder weiteren Antwort desselben Threads einen Stichtagskopf beizubehalten, und der persistente Speicher bewahrt diese Vorgabe. Das Tool verfügt jedoch nicht über eine lizenzierte Börsen-Tick-Infrastruktur mit Nanosekunden-Sequenznummern. Für Mikrostrukturarbeit auf Tick-Ebene bleibt ein dediziertes Marktdaten-Terminal bei der Zeitgenauigkeit überlegen.
Wie verfolgen Sie Primärquellen und Datenlinien hinter einer AI-Aktienempfehlung nach?
Sie verfolgen Primärquellen, indem Sie für jede wesentliche Behauptung einen benannten Ursprung verlangen und anschließend die Datenlinie von diesem Ursprung über jede Transformation bis zum angezeigten Satz verfolgen. Datenherkunft beantwortet die Frage: „Wer hat dies erstellt und wann?“ Datenlinie beantwortet die Frage: „Wie wurde es bewegt und was hat sich verändert?“ Sie benötigen beides.
Fordern Sie für jede Kauf-, Halte- oder Verkaufsempfehlung mindestens diese Zitationsangaben:
- Einreichung: Formulartyp, Aktenzeichen oder Berichtsdatum sowie Abschnitt oder Anhang
- Transkript: Ereignisdatum, Sprecher und ungefährer Zeitstempel
- Datenanbieterfeld: Name des Datenanbieters, Feld-ID und Stichtagsdatum
- Schätzung: Gruppe der Beitragenden, Definition des Konsenses und Revisionsdatum
AlphaSense ist unter den hier betrachteten kommerziellen Research-Plattformen in dieser Schicht am stärksten. Die generativen Antworten zitieren den exakten Ausschnitt lizenzierter Texte aus einer kuratierten Bibliothek, die das Unternehmen mit mehr als 500 Millionen Dokumenten und mehr als 1.700 Brokerquellen beschreibt. Dieses Design beschleunigt den Wechsel zwischen Quellen. Es ist jedoch teuer und für Enterprise-Teams konzipiert, nicht für einen Retail-Workflow mit einzelnen Titeln.
Jenova's Fundamental Stock Analyst ist stärker, wenn die Primärquelle öffentlich ist: 10-Ks, 10-Qs, 8-Ks, Gewinnmitteilungen und breit berichtete Schätzungen. Sie können den Agenten dazu verpflichten, zuerst die Sprache der Einreichung zu zitieren, bevor er sie interpretiert. Was er nicht ehrlich behaupten kann, ist eine lizenzierte Berechtigung für Research von Goldman oder Morgan Stanley. Wenn ein Tool „Street Research“ zitiert, ohne Broker und Datum zu nennen, werten Sie die Quellenschicht als nicht bestanden.
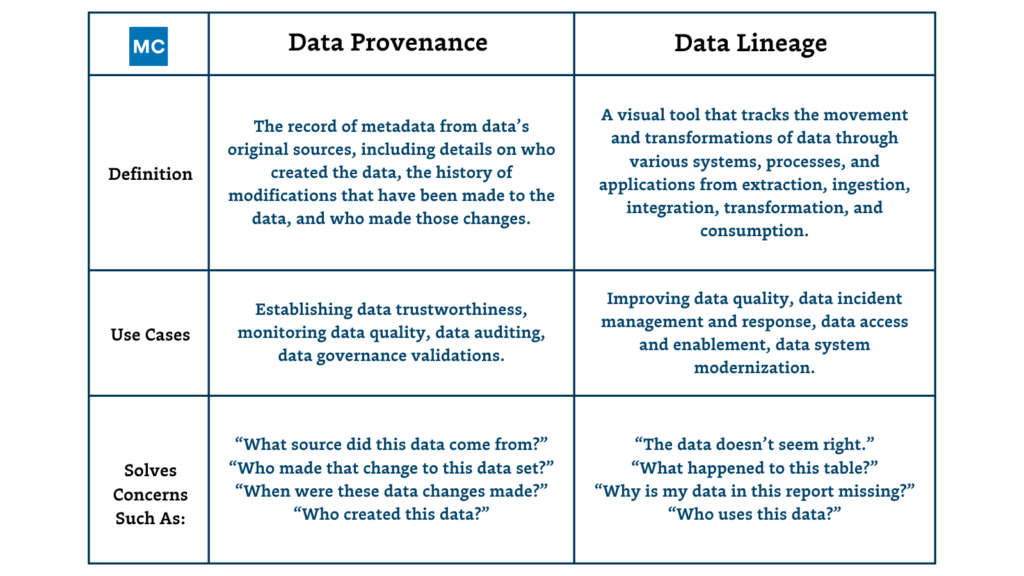
Die Unterscheidung in dieser Tabelle ist operativ, nicht akademisch. Datenherkunft ist die dokumentierte Historie von Ursprung, Bewegung, Transformationen und Nutzung. Die Datenlinie ist die Pfadvisualisierung, die Ihnen hilft, eine fehlerhafte Zahl zu debuggen, nachdem sie bereits weitergegeben wurde. Wenn ein AI-Aktientool sagt, EBITDA sei um 18 % gestiegen, zeigt Ihnen die Datenherkunft, welche Einreichung und welche Fußnote zugrunde liegen. Die Datenlinie zeigt Ihnen, ob aktienbasierte Vergütung hinzugerechnet, ein aufgegebener Geschäftsbereich herausgerechnet und welches nachgelagerte Dashboard die angepasste Zahl übernommen hat.
Welche Berechnungsmethoden sollte ein AI-Aktienanalyse-Tool offenlegen?
Ein AI-Aktienanalyse-Tool sollte für jede abgeleitete Kennzahl, die es zur Rangfolge oder Bewertung einer Aktie nutzt, die Formel, den Stichtag der Eingabedaten, die Anpassungsrichtlinie und die Regel für Neudarstellungen offenlegen. Wenn Sie die Zahl nicht anhand der genannten Eingaben neu berechnen können, haben Sie keine Methode. Sie haben ein Gefühl.
Die Offenlegungshürde existiert bereits bei regulierten Anlegertools. FINRAs Fund Analyzer veröffentlicht seine Berechnungsreihenfolge, nennt Morningstar als Datenanbieter und erklärt, dass Broker Village die Methoden unabhängig geprüft hat. Ein AI-Aktientool, das nicht erklären will, wie es den Free Cash Flow berechnet, verlangt mehr Vertrauen als ein von einer Regulierungsbehörde unterstützter Rechner.
Fordern Sie für jeden dieser wiederkehrenden kritischen Punkte eine Methodenkarte:
| Kennzahl | Was offengelegt werden muss | Häufiger stiller Fehler |
|---|---|---|
| Free Cash Flow | Definition von CFO minus Capex; Behandlung von SBC; Aktivierung von Leasingverhältnissen | Mischung von verschuldetem und unverschuldetem FCF über Vergleichsunternehmen hinweg |
| EBITDA / bereinigtes EBITDA | Liste der Hinzurechnungen; Richtlinie für Einmaleffekte; Pensionen und SBC | „Bereinigt“, wobei nur Kosten, nie Gewinne herausgerechnet werden |
| P/E und PEG | Verwässert oder unverwässert; NTM oder LTM; bereinigt oder GAAP | FY1 bei einem Titel mit LTM bei einem anderen vermischen |
| Nettoverschuldung | Einbezogene Barmittel; Behandlung von Wandelanleihen; Leasingverbindlichkeiten | Auslassung von Operating Leases nach IFRS 16 / ASC 842 |
| Konsens-EPS | Mittelwert oder Median; Stichtag für veraltete Schätzungen; Anzahl der Beitragenden | Nutzung eines Vorjahreskonsenses nach Split oder Neudarstellung |
| Gesamtrendite | Wiederanlage von Dividenden; Währung; Anpassungen für Kapitalmaßnahmen | Nur-Kurs-Charts, die als Performance bezeichnet werden |
Ein hilfreicher Folge-Prompt:
„Zeige die exakte Formel, die du für das NTM EV/EBITDA von Unternehmen X verwendet hast. Liste jede Eingabe, ihr Stichtagsdatum und auf, ob Leasingverhältnisse und SBC im Nenner enthalten sind. Berechne es dann mit unbereinigtem EBITDA neu, damit ich die Differenz sehen kann.“
Jenova kann diese Rekonstruktion innerhalb der Sitzung durchgehen und die Methodenkarte an spätere Antworten anhängen. Es wird jedoch nicht, sofern Sie dies nicht ausdrücklich verlangen, ein Prüfungsdokument eines Dritten veröffentlichen, das mit der Broker-Village-Prüfung des Fund Analyzer vergleichbar ist. Fiscal.ai bewirbt institutionelle Finanzdaten plus konversationelle AI, was für den schnellen Abruf von Abschlüssen hilfreich ist. Die für diesen Artikel geprüften öffentlichen Materialien dokumentieren jedoch keine unabhängig geprüfte Berechnungsrichtlinie. Kennzeichnen Sie dies als nicht verifiziert, nicht als nachweislich nicht vorhanden.
Koyfin ist häufig stärker als visueller Arbeitsbereich denn als Erklärer von Methoden. Vergleiche Dritter führen einen Pro-Tarif für 79 USD pro Monat auf, und das Produkt wird häufig für Charting und Screening eingesetzt. Dennoch sollten Sie dort nachfragen – oder die Zeitreihe exportieren und selbst prüfen –, ob ein Gesamtrendite-Chart Dividenden reinvestiert und in welcher Währung.
Wie zeigen sich Interessenkonflikte in AI-Aktienanalyse-Tools?
Interessenkonflikte zeigen sich als Ranking-Bias, Bestands-Bias, Vergütungs-Bias für Beitragende und Engagement-Bias – und sie skalieren in Software schneller als in einer einzelnen Analystennotiz. FINRA betrachtet Konflikte als wiederkehrende Ursache für Aufsichtsversagen und unterhält spezifische Regeln für Research-Berichte, darunter Rule 2241 für Equity Research. Ein AI-Tool, das Aktienmeinungen ohne eine vergleichbare Offenlegung ausgibt, agiert außerhalb dieser Kultur, selbst wenn es kein Broker-Dealer ist.
Der SEC-Vorschlag von 2023 zu Predictive Data Analytics warnte davor, dass Algorithmen konfliktbehaftete Empfehlungen rasch über die gesamte Nutzerbasis verbreiten können. Das zu beobachtende Muster ist kein Comic-Bösewicht. Es ist ein Modell, das auf Daten trainiert oder danach gerankt wird, welche Produkte, Orderflüsse oder Premium-Platzierungen die Plattform unbemerkt bevorzugt.
Vier Konfliktklassen, die Sie hinterfragen sollten:
- Payment for Order Flow oder Brokerage-Verbindung — führt das Mutterunternehmen des Tools Trades aus?
- Bestände von Beitragenden oder Affiliates — hält ein Autor, Partner oder Mutterunternehmen den betreffenden Titel?
- Bündelung mit Datenanbietern — sind „Top-Ideen“ zugunsten von Emittenten verzerrt, die Daten lizenzieren oder Werbung schalten?
- Optimierung auf Engagement — wird das Modell für mehr Trades, mehr Klicks oder mehr Gewissheit belohnt?
Seeking Alpha weist ausdrücklich darauf hin, eine große Community von Beitragenden zu sein, und führt Abonnementstufen auf seiner Abonnementseite auf. Dieses Modell ist nützlich für Ideengenerierung und für Abrufe im Stil von „Ask Seeking Alpha“. Als konfliktbereinigte Primärquelle ist es schwächer, weil Autorenanreize und redaktionelle Rankings Teil des Produkts sind. Lesen Sie Offenlegungen von Autoren genauso wie die Zertifizierungsseite einer Sell-Side-Analyse.
Jenova ist kein Broker-Dealer und monetarisiert keinen Orderfluss, wodurch eine wesentliche Konfliktklasse entfällt. Die ehrliche Einschränkung: Es veröffentlicht auch keine Research-Zertifikate im Stil von FINRA Rule 2241, keine Historien von Kurszielen und keine Tabellen zu Investmentbanking-Beziehungen. Behandeln Sie die Ergebnisse als analytische Unterstützung, nicht als zertifizierten Research-Bericht. Fragen Sie schriftlich, ob ein Ranking Affiliate-Daten, gesponserte Listings oder nicht verifizierte Angaben von Beitragenden verwendet hat.
Ein Konflikt-Audit-Prompt, der über Tools hinweg funktioniert:
„Liste jeden Anreiz auf, der diese Empfehlung beeinflusst haben könnte: Publisher-Umsatz, Affiliate-Brokerage, Vergütung von Beitragenden, gesponserte Daten oder Engagement-Kennzahlen. Wenn du einen davon nicht ausschließen kannst, sage es und stufe das Vertrauen herab.“
Welche Unsicherheitsangaben sollten Sie von einem AI-Aktienanalysten erwarten?
Sie sollten ein Konfidenzintervall oder Szenarioband, eine Liste fehlgeschlagener Annahmen, eine Datenqualitätsbewertung und eine klare Aussage darüber erwarten, was die These widerlegen würde. Punktschätzungen ohne Fehlerbalken sind die häufigste Methode, mit der AI-Aktientools falsche Präzision erzeugen.
Das NIST AI Risk Management Framework ist ein freiwilliger Standard, um Vertrauenswürdigkeit in Design, Nutzung und Bewertung von AI-Systemen zu integrieren. NIST veröffentlichte später ein Profil für generative AI, das Organisationen helfen soll, für generative Systeme spezifische Risiken zu identifizieren. Keines der Dokumente ist eine Wertpapierregel, aber beide verweisen auf dieselbe operative Gewohnheit: Unsicherheit messen und dokumentieren, statt sie in überzeugender Prosa zu verstecken.
Ein vollständiger Unsicherheitsblock besteht aus vier Teilen:
- Punktschätzung — Fair Value, Kursziel oder erwartete Rendite
- Bandbreite — Bull / Base / Bear oder ein numerisches Intervall
- Sensitivität — die zwei oder drei Eingaben, die das Ergebnis am stärksten beeinflussen
- K.O.-Kriterien — die Einreichung, Notierung oder das Ereignis, das die Sichtweise ungültig macht
FINRA Notice 24-09 nennt Genauigkeit als vorrangiges Problem bei generativen Tools. Das ist nicht abstrakt. Sprachmodelle vervollständigen plausible Sätze. Sie berechnen nicht automatisch Standardfehler. Wenn Ihr Tool nicht sagen kann: „Dieses NTM P/E verwendet drei veraltete Schätzungen und könnte um 8–12 % zu niedrig sein“, führt es keine Analyse durch. Es formuliert eine Erzählung.
Jenova erstellt auf Anweisung Szenariobänder und K.O.-Kriterien und merkt sich diese Anweisung über Sitzungen hinweg. Das Standardverhalten ist jedoch, wie bei den meisten konversationellen Agenten, weiterhin eine einzelne Erzählung, sofern Sie nicht ausdrücklich eine Bandbreite verlangen. Die Zitationsspur von AlphaSense verringert eine Art von Unsicherheit – „Hat das Management dies tatsächlich gesagt?“ –, doch Ausschnittzitate liefern für sich genommen keinen Bewertungskorridor. Die Charts von Koyfin machen historische Volatilität sichtbar; sie fügen einer von AI verfassten These nicht automatisch eine Vertrauensbewertung hinzu.
Wie schneiden führende AI-Aktienanalyse-Tools bei der Datentransparenz ab?
Sie unterscheiden sich klar danach, welche Schicht des Stacks für die Integrität der Datenherkunft sie günstig überprüfbar machen. AlphaSense macht Quellenausschnitte günstig überprüfbar. Jenova macht die iterative Befragung öffentlicher Einreichungen günstig. Koyfin macht visuelle Gegenprüfungen günstig. Fiscal.ai macht den konversationellen Abruf von Abschlüssen günstig. Seeking Alpha macht Community-Meinungen günstig. Keines von ihnen macht alle fünf Schichten kostenlos.
| Funktion / Dimension | Jenova Fundamental Stock Analyst | AlphaSense | Fiscal.ai | Koyfin | Seeking Alpha |
|---|---|---|---|---|---|
| Zeitstempel- / Aktualitätskennzeichnung | Stark bei entsprechender Abfrage; keine lizenzierte Tick-Infrastruktur | Stark bei Dokumentdaten; Zeitangaben für Marktnotierungen nicht verifiziert | Über Plattform-Stichtagsfelder hinaus nicht verifiziert | Stark bei Chart-Zeitreihen; Zeitangaben der AI nicht verifiziert | Zeitstempel von Artikeln stark; Kursverzögerung oft Standard des Datenanbieters |
| Zitation von Primärquellen | Öffentliche Einreichungen, Schätzungen und Live-Suche; keine lizenzierte Broker-Bibliothek | Zitate auf Ausschnittebene über einen lizenzierten Inhaltsbestand, den das Unternehmen mit mehr als 500 Millionen Dokumenten beschreibt | Konversationeller Zugriff auf institutionell geprägte Fundamentaldaten | Arbeitsbereich für Marktdaten mit Datenanbieter-Backbone | Notizen von Beitragenden plus „Ask“-Abruf; gemischte Primär- und Sekundärquellen |
| Berechnungsmethodik | Bei Nachfrage innerhalb der Sitzung rekonstruierbar; keine externe Methodenprüfung | Stark, wenn das Quellmodell oder die Einreichung in der Bibliothek enthalten ist | Öffentliche Methodenkarte nicht verifiziert | Transparent für angezeigte Zeitreihen; Methoden für Narrative variieren | Von Autoren definiert; zwischen Beitragenden inkonsistent |
| Offenlegung von Interessenkonflikten | Kein Brokerage und kein PFOF; kein Research-Bericht nach Rule 2241 | Anbieter lizenzierter Inhalte; kommerzielle Enterprise-Konditionen | Nicht verifiziert | Daten- / Analyseanbieter; kein Anbieter zertifizierten Researchs | Die Ökonomie von Beitragenden und Abonnements ist Teil des Modells |
| Unsicherheit / Vertrauensgrenzen | Auf Anfrage verfügbar; kein statistisches Standardintervall | Zitate reduzieren Zitationsrisiken; Bewertungskorridore nicht automatisch | Nicht verifiziert | Historische Volatilität sichtbar; Vertrauen in Thesen nicht automatisch | Meinungsbandbreiten variieren je nach Autor |
| Preise (Stand 2026) | Kostenlose Stufe; kostenpflichtige Tarife ab 20 USD/Monat | Enterprise / Kontaktaufnahme; öffentlicher Listenpreis nicht verifiziert | Nicht verifiziert | Pro in Vergleichen Dritter mit 79 USD/Monat aufgeführt | Kostenpflichtige Stufen auf der Abonnementseite veröffentlicht; Seiten Dritter verorten Premium oft bei etwa 24 USD/Monat |
| Am besten geeignet für | Anleger, die einen persistenten, hinterfragbaren fundamentalen Workflow mit öffentlichen Daten wünschen | Teams, die lizenziertes Broker-Research und Nachvollziehbarkeit bis zum Ausschnitt benötigen | Nutzer, die AI-natives Unternehmensresearch in einer Oberfläche wünschen | Berater und Anleger, die mit Screens, Charts und Berichten arbeiten | Ideengenerierung und Community-Research mit aufgesetzter AI-Suche |
Zwei verwandte Jenova-Agenten schließen Lücken, die diese Tabelle nicht abdeckt. Der Technical Stock Analyst ist der bessere Ort, um Kurs-, Volumen- und Marktstrukturbehauptungen einem Stresstest zu unterziehen, nachdem die Fundamentaldaten belegt wurden. Der Portfolio Management Strategist ist der bessere Ort, um zu fragen, ob eine verifizierte Sicht auf einen Einzeltitel tatsächlich Allokation, Drift oder Stresstestergebnisse verändert.
Die ehrlichen Einschränkungen auf Seiten von Jenova bleiben wesentlich. Es ersetzt keine Bloomberg-ähnlichen Datenberechtigungen, stellt kein FINRA-Research-Zertifikat aus und wird keine Börsen-Sequenznummer erfinden, die ihm nicht vorliegt. Das sind Gründe, einen zweiten Datenfeed oder eine Einreichungsseite geöffnet zu halten – keine Gründe, die Befragungsschicht zu überspringen, die es bietet.
Wie führen Sie einen praktischen Verifizierungsworkflow mit einem AI-Aktientool durch?
Führen Sie ein 20-minütiges Audit mit fünf Durchgängen durch: Zeit, Quelle, Formel, Anreiz und anschließend Unsicherheit. Testen Sie es bei einem aktuell gehandelten Titel, bevor Sie dem Tool bei einem Portfolio vertrauen. Die Reihenfolge ist wichtig, denn eine überzeugende These auf Basis eines veralteten Schlusskurses bleibt falsch.
Durchgang 1 — Zeit (3 Minuten) Fordern Sie Stichtagsangaben für Kurs, Aktienanzahl, Nettoverschuldung und Konsens an. Verwerfen Sie jede Antwort, die „aktuell“ ohne Datum und Uhrzeit sagt.
Durchgang 2 — Quelle (5 Minuten) Verlangen Sie die Einreichung, das Transkript oder das Datenanbieterfeld hinter den drei Zahlen, die die Bewertung am stärksten beeinflussen. Öffnen Sie die Einreichung selbst. Wenn die Notierung falsch ist, brechen Sie das Audit ab.
Durchgang 3 — Formel (5 Minuten) Berechnen Sie ein Multiple anhand der genannten Eingaben selbst nach. EV/EBITDA und FCF-Rendite sind die Prüfungen mit dem höchsten Nutzen, weil sich dort stille Anpassungen verstecken.
Durchgang 4 — Anreiz (3 Minuten) Fragen Sie, wer bezahlt wird, wenn Sie handeln. Lesen Sie die Bedingungen des Tools, das Autorenfeld oder Unternehmensverbindungen. Der FINRA-Rahmen für Interessenkonflikte existiert, weil Offenlegungsfehler regelmäßig und nicht selten sind.
Durchgang 5 — Unsicherheit (4 Minuten) Erzwingen Sie eine Drei-Szenarien-Bandbreite und einen Widerlegungsfaktor. Wenn das Tool nach einer fehlgeschlagenen Quellenprüfung nicht bereit ist, sein Vertrauen herabzustufen, verwenden Sie es nicht für Positionsgrößenentscheidungen.
Bei Jenova's Fundamental Stock Analyst besteht die Einrichtung aus einer dauerhaften Anweisung, nicht aus einem einmaligen Prompt:
„Füge für diesen Ticker und jede Folgefrage einen Herkunftsheader an: Stichtagszeitstempel, Primärquellen mit Daten, Formeln für abgeleitete Kennzahlen, alle Konflikte, die du nicht ausschließen kannst, sowie eine Base-/Bull-/Bear-Bandbreite. Wenn ein Feld unbekannt ist, schreibe unbekannt. Fülle Lücken nicht mit überzeugend klingenden Vermutungen.“
Bei AlphaSense besteht der entsprechende Schritt darin, innerhalb der zitierten Ausschnitte zu bleiben und zur zugrunde liegenden Broker-Notiz oder zum Transkript durchzuklicken, bevor Sie eine Zahl akzeptieren. Bei Koyfin exportieren Sie die Zeitreihe und prüfen die Einstellungen für Kapitalmaßnahmen und Dividenden. Bei Seeking Alpha trennen Sie geprüfte Finanzdaten von der Meinung eines Autors, bevor eine der beiden Zahlen in ein Modell einfließt.
Eine Gewohnheit für die zweite Sitzung ist ebenso wichtig wie der erste Prompt. Kommen Sie am nächsten Tag zurück und fragen Sie dasselbe Tool nach demselben Multiple, ohne die frühere Antwort einzufügen. Abweichungen in der Formel oder beim Stichtagsdatum sind ein Warnsignal. Jenovas sitzungsübergreifender Speicher verringert das versehentliche Zurücksetzen Ihrer Offenlegungsregeln. Er ersetzt nicht die erneute Prüfung des Datenfeeds nach einer Gewinnveröffentlichung oder einem Split.
Was sagen Praktiker für Marktdaten über das Vertrauen in AI-Aktienanalysen?
Praktiker, die sowohl Sell-Side-Research als auch modellgenerierte Notizen erlebt haben, kommen bei einer Regel zusammen: Vertrauen Sie den Metadaten, nicht der Prosa. Ein Tool, das eine überzeugende Moat-Story erzählen kann, aber sein eigenes EV nicht mit Zeitstempel versehen kann, ist nicht bereit für eine Positionsgröße.
„Das Versagen, das wir beobachten, ist fast nie ein fehlendes Adjektiv. Es ist ein Schlusskurs vom Dienstag in einem Memo vom Donnerstag oder ein ‚bereinigtes‘ EBITDA, das aktienbasierte Vergütung nur beim Zielunternehmen herausgerechnet hat. Wenn ein AI-Aktientool keinen Stichtagskopf und keine Formelkarte ausgeben kann, behandeln wir das Ergebnis als Lesehilfe, nicht als Eingabe für ein Modell. Das klingt hart, bis man sich daran erinnert, dass eine einzige stille Neudarstellung ein günstig wirkendes Multiple um mehrere Turns verändern kann.“
„Interessenkonflikte sind das zweite stille Versagen. Eine Website mit Beitragenden, ein Brokerage-Affiliate oder ein auf Engagement abgestimmtes Ranking muss beim Umsatzwachstum nicht lügen. Es muss nur die Titel nach oben bringen, die Menschen weiterklicken lassen. Wir stellen jedem System dieselbe Frage wie einem Junior-Analysten: Wer wird bezahlt, wenn ich danach handle, und was würde dich dazu bringen, deine Einschätzung zurückzunehmen? Wenn die Antwort ein Schulterzucken ist, beträgt die Unsicherheit 100 %, unabhängig davon, wie zuversichtlich der Satz klingt.“
„Regulierungsbehörden warten nicht auf ein neues Gesetz, um sich darum zu kümmern. FINRA hat bereits erklärt, dass die alten Kommunikations- und Aufsichtsregeln für generative Systeme gelten, und das AI-Risikoframework von NIST macht ausdrücklich klar, dass Vertrauenswürdigkeit gemessen und nicht behauptet wird. Die praktische Messlatte für einen AI-Aktienanalysten im Jahr 2026 ist daher absichtlich langweilig: Zeitangaben, Quellen, Formeln, Anreize und Bandbreiten – in dieser Reihenfolge.“
— Jenova Product Team, Tools für Equity Research und Infrastruktur für AI-Agenten
Diese Messlatte erklärt auch, warum gemischte Tool-Stacks normal sind. Nutzen Sie eine Zitationsmaschine für Broker-Sprache, einen auf Einreichungen spezialisierten Agenten für Rekonstruktionen und einen Charting-Arbeitsbereich für den Marktdatenfeed. Die Verifizierungsarbeit ist das Produkt. Das Chatfenster ist nur die Benutzeroberfläche.
Quellen
- SkyQuest — Marktgröße, Marktanteil und Wachstumsanalyse für Datenherkunft
- IBM — Was ist Datenherkunft?
- FINRA Regulatory Notice 24-09 — Generative AI und Large Language Models
- SEC — Künstliche Intelligenz und die Zukunft der Vermögensverwaltung (David W. Blass Daly, 3. Feb. 2026)
- Crowell & Moring — Investor Advisory Committee empfiehlt SEC-Leitlinien zur Offenlegung für künstliche Intelligenz
- OpenCorporates — Datenherkunft erklärt
- Hyperbots — Was ist Datenherkunft? Definition, Prozess und zentrale Kennzahlen
- AlphaSense — Führende Tools für Aktien- und Investmentresearch 2026
- FINRA — Fund Analyzer: Methodik und Datenquellen
- FINRA — Interessenkonflikte
- Federal Register — Interessenkonflikte im Zusammenhang mit der Nutzung von Predictive Data Analytics durch Broker-Dealer und Anlageberater
- NIST — AI Risk Management Framework
- TrustRadius — AlphaSense vs. Koyfin
- Seeking Alpha — Abonnements