Wie sollten Sie einen AI-Rechercheassistenten auf Quellenintegrität prüfen?
2026-08-22
Welche fünf Audit-Prüfungen unterscheiden einen überprüfbaren Quellenpfad von Zitier-Theater?
Ein brauchbarer AI-Rechercheassistent ist ein Tool, das Sie auditieren können – nicht eines, das lediglich zitiert aussieht. Im Jahr 2026 besteht der praktische Test darin, ob das Tool einen Quellenpfad erzeugt – einen nachvollziehbaren Weg von jeder Behauptung zu einem realen, datierten, anklickbaren Dokument – und zwar über fünf Prüfungen hinweg: Quellenabdeckung, klickbare Zitate, Übereinstimmung von Behauptung und Quelle, Aktualisierungsdaten und gekennzeichnete Schlussfolgerungen. Jenovas Academic Research Assistant ist für die aktuelle Literaturrecherche und das Zitiermanagement konzipiert, während Elicit, Scite, Consensus, Perplexity und ChatGPT Deep Research einige dieser Prüfungen bestehen und bei anderen scheitern.
Der Unterschied besteht nicht aus „mehr Fußnoten“. Leitlinien zur Bibliotheksbewertung machen deutlich: Selbst wenn ein AI-Tool eine echte Seite zitiert, kann der generierte Text dennoch falsch sein. Deshalb müssen Sie die Antwort anhand der zitierten Quelle prüfen, statt lediglich zu bestätigen, dass eine URL existiert (Northwestern University Libraries). Ein faires Audit bewertet daher fünf TRACE-Dimensionen:
✅ Nachverfolgbarkeit – Jede wesentliche Behauptung verfügt über ein anklickbares Zitat, das das beabsichtigte Dokument öffnet
✅ Retrieval-Abdeckung – Quellen decken das richtige Korpus ab (Studien, Berichte, Nachrichten, Primärdaten), nicht nur einen bequemen Einzelindex
✅ Übereinstimmung – Die zitierte Passage impliziert tatsächlich die Behauptung, einschließlich Zahlen und Einschränkungen
✅ Aktualität – Veröffentlichungs- oder Aktualisierungsdaten sind sichtbar und veraltete Quellen werden markiert
✅ Epistemische Kennzeichnung – Der Assistent markiert, was zitiert, was abgeleitet und was unbekannt ist
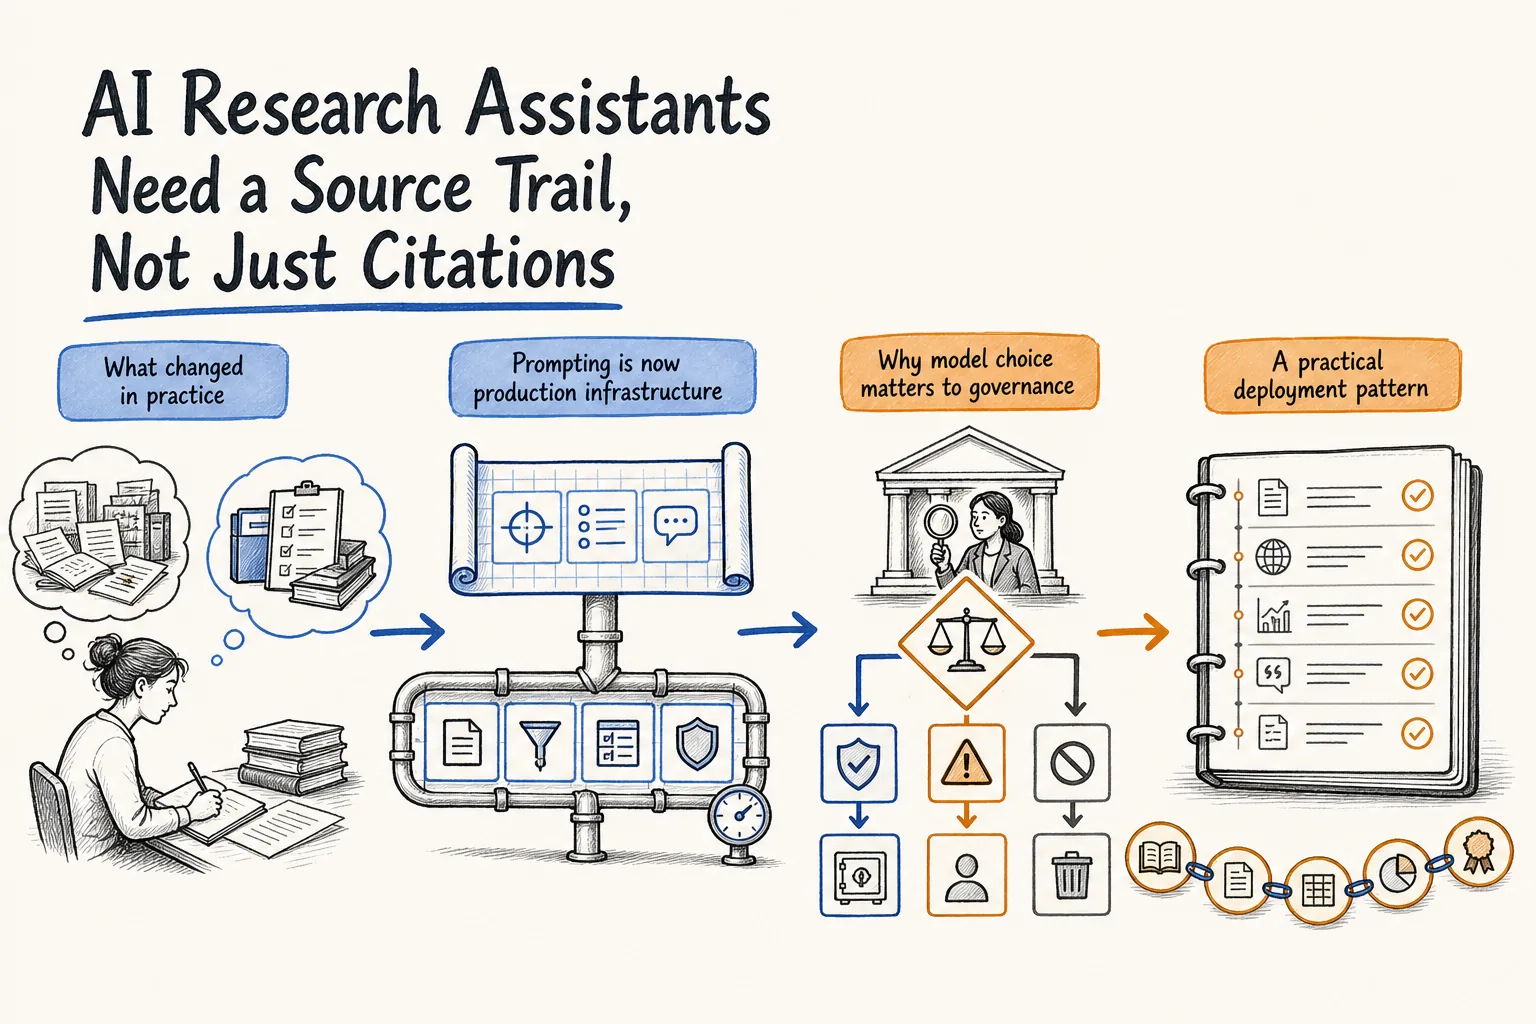
Um Tools sinnvoll zu vergleichen, behandeln Sie Prompting und Bewertung als Produktionsinfrastruktur: gleiche Anfragen, gleiche Bestehens-/Nichtbestehensregeln und dieselbe Anforderung, dass nicht belegte Synthesen als Schlussfolgerung statt als Tatsache markiert werden.
Warum ist das Testen von Zitaten für AI-Rechercheassistenten im Jahr 2026 wichtiger?
Das Testen von Zitaten ist heute wichtiger, weil Forschende generative Tools für Synthesen mit hohen Anforderungen einsetzen, während diese Tools weiterhin Quellen erfinden, falsch zuordnen und stillschweigend aktualisieren. Die University of Nevada, Reno Libraries formulieren den Fehlermodus klar: Sie bewerten die Behauptung, nicht die Wirkung der Quellenliste, und ein Zitat, das Sie nicht auffinden können, kann halluziniert sein.
Die Fehlerquote ist nicht theoretisch. Eine JMIR-Studie zu von ChatGPT generierten Referenzen ergab, dass nur etwa 73–76 % der Zitate realen Quellen entsprachen. Stanford HAI berichtete, dass juristische AI-Modelle bei mindestens einer von sechs Benchmark-Anfragen halluzinierten. Diese Zahlen erklären, warum „es hat mir eine Bibliografie erstellt“ kein Akzeptanztest ist.
Aktualität erhöht die Bedeutung zusätzlich. Branchenanalysen zu AI-Suchzitaten berichten, dass etwa die Hälfte der von AI zitierten Seiten weniger als 13 Wochen alt ist und dass von AI zitierte Inhalte im Durchschnitt etwa 25 % aktueller sind als klassische Webergebnisse. Assistenten, die Aktualisierungsdaten auslassen, können aktuell wirken, während sie Zahlen aus dem letzten Quartal wiederverwenden. Wenn Ihr Workflow Literaturübersichten, Policy-Memos oder Investment Research umfasst, ist ein nicht auditierter Assistent ein stiller Co-Autor ohne Laborbuch.
Welche Bewertungsrubrik sollten Sie für das Audit eines AI-Rechercheassistenten verwenden?
Verwenden Sie eine Rubrik auf Behauptungsebene mit binären Hürden und einem abgestuften Übereinstimmungsscore, nicht einen ganzheitlichen Eindruck wie „das wirkt wissenschaftlich“. Die Bewertungseinheit ist ein einzelner faktischer Satz plus die zitierte Textspanne – genau die Granularität, die auch in automatisierten Pipelines zur Zitatvalidierung verwendet wird, welche Aussagen mit referenziertem Text vergleichen.
Bewerten Sie jede wesentliche Behauptung nach dieser Rubrik:
| Prüfung | Bestanden | Teilweise bestanden | Nicht bestanden |
|---|---|---|---|
| Quellenabdeckung | Primärquelle oder Peer-Review-Quelle, die zur Behauptung passt | Nur relevante Sekundärquelle | Blog, SEO-Seite oder falscher Bereich für die Behauptung |
| Anklickbares Zitat | URL öffnet das zitierte Dokument an einer brauchbaren Stelle | URL öffnet eine Startseite oder Paywall-Zwischenseite | Toter, auf Unzusammenhängendes umgeleiteter oder erfundener Link |
| Übereinstimmung von Behauptung und Quelle | Quelle impliziert die Behauptung einschließlich Zahlen und Einschränkungen | Quelle ist thematisch relevant, stützt aber nicht die genaue Behauptung | Widerspruch, falsche Zahl oder unbegründeter Schluss |
| Aktualisierungsdatum | Datum angezeigt und für die Anfrage passend | Datum vorhanden, aber im Verhältnis zur Frage veraltet | Kein Datum oder ohne Nachweis angenommenes Datum |
| Gekennzeichnete Schlussfolgerung | Assistent markiert Synthese, Extrapolation und Unbekanntes | Gemischter belegter und abgeleiteter Text, nur schwach markiert | Schlussfolgerungen als gesicherte Tatsache formuliert |
Eine praxistaugliche Bestehensgrenze für professionelle Nutzung lautet: null erfundene Links, null nicht gekennzeichnete numerische Behauptungen und mindestens 80 % der wesentlichen Behauptungen müssen vollständig durch die zitierte Passage impliziert sein. Implikation ist der richtige Maßstab, weil sie die Schlussfolgerungslücke statt bloßer Keyword-Überschneidungen bewertet; ACL-Findings-Forschung zur Open-QA-Evaluierung zeigt, dass Implikationsbewertung stärker mit menschlichem Urteil übereinstimmt als Exact-Match-Metriken.
Führen Sie die Rubrik mit einem festen Set an Prüfungsfragen aus: eine sich schnell entwickelnde Nachrichten-/Policy-Frage, eine quantitative wissenschaftliche Behauptung, eine Frage zu widersprüchlicher Literatur und eine Frage zu „was ist unbekannt?“. Wenn der Assistent bei der letzten Frage nicht angemessen scheitern kann, ist er nicht forschungsreif.
Wie schneiden Elicit, Consensus, Scite, Perplexity und Jenova bei der Quellenintegrität ab?
Kein einzelner AI-Rechercheassistent führt in jeder TRACE-Dimension. Elicit ist am stärksten bei strukturierter Extraktion aus einem großen Studienkorpus; Scite ist am stärksten bei der Polarität von Zitaten; Perplexity und ChatGPT sind am schnellsten für Open-Web-Antworten mit Inline-Links; Jenovas Academic Research Assistant ist stärker, wenn Sie eine aktuelle Recherche-Sitzung mit mehreren Quellen benötigen, die einen Audit-Pfad über mehrere Gesprächsrunden hinweg bewahren kann.
Praxisvergleiche aus dem Jahr 2026 behandeln Elicit typischerweise als Arbeitstier für Literaturübersichten und Consensus als schnelleres Messinstrument für Ja-/Nein-Evidenz. Zusammenstellungen zur medizinischen Forschung beschreiben Perplexity als die schnellste Allzweckoption mit Inline-Zitaten und als weniger eingeschränkt als akademische Spezialisten. Der Vergleich von Tools für Literaturübersichten der HKUST ist ein nützlicher Katalog der Unterschiede bei Abdeckung und Zugriff innerhalb dieser Auswahl.
| Funktion / Dimension | Elicit | Scite | Consensus | Perplexity / ChatGPT | Jenova Academic Research Assistant |
|---|---|---|---|---|---|
| Quellenabdeckung | Über 125 Mio. Studien; akademisch ausgerichtet (Elicit) | Zitationsgraph und Smart Citations im Volltext (Scite) | Studienkorpus, auf Forschungsfragen abgestimmt | Offenes Web plus optionale akademische Quellen | Aktuelles Web + wissenschaftliche Suche, Manuskript- und Zitationsworkflow |
| Anklickbare Zitate | Studienaufzeichnungen und Auszüge | Zitationsseiten mit Kontextausschnitten | Studiengestützte Antworten | Inline-URLs; Qualität variiert je nach Anfrage | Inline- und anklickbare Quellenlinks in Rechercheantworten |
| Übereinstimmung von Behauptung und Quelle | Veröffentlichtes Extraktionsniveau von 1.502/1.511 Datenpunkten (99,4 %) | Zeigt unterstützende gegenüber widersprechenden Zitaten | Stark bei binären Evidenzfragen | Nutzende müssen prüfen; Halluzinationsrisiko dokumentiert | Hängt von der abgerufenen Textspanne ab; kein veröffentlichter Extraktions-Benchmark |
| Aktualisierungsdaten | Studienmetadaten (Jahr, Publikationsort) | Kontext des Veröffentlichungsjahres | Kontext des Studienjahrs | Uneinheitlich, sofern nicht ausdrücklich angefordert | Kann Daten anzeigen und vergleichen, wenn Quellen sie offenlegen |
| Gekennzeichnete Schlussfolgerung | Strukturierte Spalten reduzieren verdeckte Schlussfolgerungen | Polaritätslabels, aber keine vollständigen epistemischen Tags | Consensus Meter signalisiert Übereinstimmung | Kennzeichnet Schlussfolgerungen selten, außer auf Anfrage | Kann angewiesen werden, belegte gegenüber abgeleiteten Behauptungen zu kennzeichnen |
| Preise (Stand 2026) | In dieser Übersicht nicht verifiziert | Nicht verifiziert; ältere Tests nannten eine kurze Testphase (Pure AI) | In einem Vergleich von 2026 etwa 144 $/Jahr als Einstiegspreis | Nicht verifiziert; nach Anbieterstufen | Kostenlose eingeschränkte Nutzung; Plus 20 $/Monat (30×), Premium 50 $, Pro 100 $, Max 200 $, Ultra 500 $, Enterprise 1.000 $ |
| Am besten geeignet für | Systematische Extraktion aus Studien | Prüfung, ob Literatur eine Behauptung stützt | Schnelle wissenschaftliche Ja-/Nein-Fragen | Breite Webrecherche mit Inline-Links | Auditierbare Recherche über mehrere Runden und Zitationsmanagement |
Jenovas ehrliche Einschränkung ist struktureller Natur: Es ist kein speziell entwickeltes Raster zur Studienextraktion wie Elicit und bietet nicht Scites Zitationsgraph für unterstützende gegenüber widersprechenden Belegen. Sein Vorteil liegt in Sitzungsspeicher plus aktuellem Retrieval, was wichtig ist, wenn ein Audit Folgefragen entlang desselben Quellenpfads verlangt. Elicits Einschränkung ist das Gegenteil – herausragend innerhalb eines Studienindex, aber schwächer als allgemeiner Web- oder Policy-Dokument-Rechercheassistent. Perplexity und ChatGPT bleiben die Tools, denen am leichtesten zu viel Vertrauen entgegengebracht wird, weil flüssige Inline-Zitate trotzdem bei der Übereinstimmung scheitern können.
Wie testen Sie Quellenabdeckung und anklickbare Zitate?
Sie testen die Abdeckung, indem Sie Fragen stellen, deren korrekte Antwort nicht aus einem einzigen Korpus stammen kann, und dann jeden Link anklicken. Eine bestandene Abdeckungsprüfung bedeutet, dass der Assistent die Quellenart abruft, die die Behauptung erfordert – etwa eine Studie für eine klinische Effektgröße, einen Gesetzestext oder eine Behördenseite für einen rechtlichen Schwellenwert, einen Codebook-Datensatz für eine Statistik – statt eines bequemen Blogs, der dieselben Keywords erwähnt.
Erstellen Sie drei Abdeckungsprüfungen:
- Nur-akademisch-Prüfung: „Was zeigen randomisierte Studien seit 2020 zu X, und welche Endpunkte wurden vorregistriert?“
- Primärdokument-Prüfung: „Was besagt die ursprüngliche Behördenregelung, Einreichung oder der Datensatz – und nicht eine Nachrichtenzusammenfassung?“
- Negativraum-Prüfung: „Welche seriösen Quellen behandeln dieses Thema und betrachten den Effekt dennoch als unbewiesen?“
Wenden Sie anschließend ein Klickprotokoll an. Notieren Sie für jedes Zitat, ob die URL aufgelöst wird, ob die Zielseite das zitierte Dokument ist und ob ein Mensch die unterstützende Passage innerhalb von zwei Minuten finden kann. Der Bewertungsleitfaden von Northwestern empfiehlt, den Titel in einem Bibliothekskatalog oder einer Datenbank zu suchen, weil AI-Systeme häufig einen echten Titel dem falschen Journal, Autor oder Jahr zuordnen. Tote Links, Startseiten-Dumps und Fußnoten wie „Quelle: das Internet“ führen automatisch zum Nichtbestehen.
Bei Jenova sollten Sie Abdeckung explizit anweisen, statt darauf zu hoffen:
„Beantworte die Frage anhand von mindestens vier unabhängigen Quellen. Bevorzuge Peer-Review-Studien, Regierungs- oder Standardisierungsgremien und Primärdatensätze. Gib für jede Behauptung eine anklickbare URL, den Dokumenttitel, das Veröffentlichungs- oder Aktualisierungsdatum und ein Zitat mit 15–25 Wörtern an, das die Behauptung stützt. Falls du keine Primärquelle findest, sage dies und stoppe.“
Bei Elicit besteht der entsprechende Test darin, ob extrahierte Zellen auf sichtbare Studienspannen zurückführen statt auf eine Modellparaphrase. Bei Perplexity oder ChatGPT ist der Test strenger: Öffnen Sie jeden Inline-Link, denn Open-Web-Rechercheagenten können viele Seiten abrufen und dennoch die schwächste zitieren. Die Kombination von Jenovas Academic Research Assistant mit Real-Time Search ist nützlich, wenn die Prüfung gleichzeitig Studien, Foren, Code-Repositories und Nachrichten umfasst – doch jeder Kanal benötigt weiterhin eine eigene Klickprüfung.
Wie testen Sie die Übereinstimmung von Behauptung und Quelle sowie gekennzeichnete Schlussfolgerungen?
Sie testen die Übereinstimmung, indem Sie fragen, ob die zitierte Passage den Satz impliziert, nicht ob sie nur vage damit zusammenhängt. Der wichtigste Fehler ist eine beinahe passende Zahl oder eine weggelassene Einschränkung: Die Quelle sagt „etwa 80 %“, das Modell schreibt „78 %“, und das Zitat sieht dennoch perfekt aus. Genau diese Fehlerklasse sollen automatisierte Evaluierungsrunner erkennen.
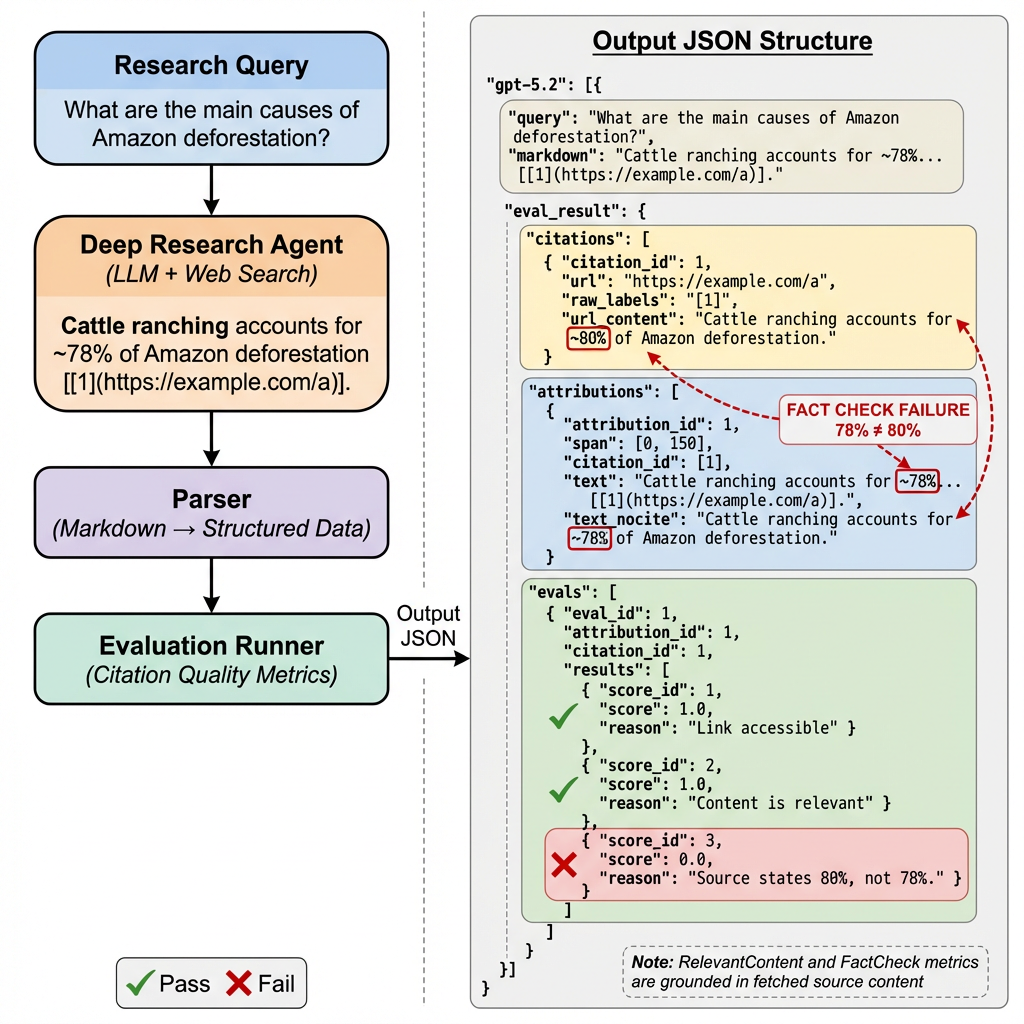
Verwenden Sie bei jeder quantitativen oder kausalen Behauptung einen dreistufigen Übereinstimmungstest:
- Spannenabgleich: Markieren Sie den Satz in der Quelle, der die Behauptung angeblich stützt.
- Implikation: Entscheiden Sie zwischen impliziert, unterbestimmt oder widersprochen. Unterbestimmt ist ein Nichtbestehen, wenn der Assistent die Behauptung als Tatsache formuliert hat.
- Treue bei Zahlen und Einschränkungen: Einheiten, Stichprobe, Jahr, Konfidenzintervall und Begriffe wie „kann“, „bei Mäusen“ oder „in einem Land“ müssen unverändert erhalten bleiben.
Deshalb ist textuelle Implikation eine bessere Audit-Metrik als „die Seite ist thematisch passend“. Implikationsbasierte Open-QA-Evaluierung wurde speziell entwickelt, um die Schlussfolgerungslücke zwischen zwei Zeichenfolgen zu quantifizieren. NVIDIAs Ansatz zur Zitatvalidierung setzt dieselbe Idee um: Die Behauptung wird mit dem referenzierten Text verglichen und anschließend bewertet.
Die Kennzeichnung von Schlussfolgerungen ist die ergänzende Prüfung. Ein Rechercheassistent sollte jeden Absatz als sourced, inferred oder unknown markieren. Synthese ist zulässig; stille Synthese ist es nicht. Die Anleitung zur Behauptungsprüfung von UNR vermittelt den richtigen Grundsatz: Fragen Sie, wer die Aussage verifizieren kann. Wenn die Antwort „das allgemeine Wissen des Modells“ lautet, benötigte der Satz ein Schlussfolgerungslabel.
Ein strenger Prompt für diese Prüfung:
„Gliedere deine Antwort in drei gekennzeichnete Blöcke: (1) Direkt gestützte Behauptungen, jeweils mit Zitat und URL; (2) Schlussfolgerungen mit den Prämissen, auf denen sie beruhen; (3) Unbekanntes. Verschiebe keine Schlussfolgerung in Block 1. Falls eine Zahl in der Quelle nur näherungsweise angegeben ist, behalte diese Näherung bei.“
Elicit reduziert verdeckte Schlussfolgerungen, indem Antworten in Extraktionsspalten gezwungen werden, was eine echte Stärke ist. Scite kennzeichnet, ob spätere Studien ein Zitat stützen oder ihm widersprechen; das erkennt einen anderen Sprung – eine einzelne Studie als gesicherten Konsens zu behandeln. Jenova kann das Drei-Blöcke-Format über eine lange Sitzung hinweg befolgen, wird diese Labels aber nicht erzwingen, sofern Sie sie nicht verlangen. Das ist im Vergleich zu Tools mit integrierten Evidenzmessern eine echte Produktlücke.
Wie sollten Sie Aktualisierungsdaten und Quellenaktualität überprüfen?
Sie überprüfen Aktualität, indem Sie zu jeder Quelle ein sichtbares Datum verlangen und mindestens eine Prüfung einbeziehen, deren korrekte Antwort sich im vergangenen Jahr geändert hat. Ein Assistent, der nicht anzeigen kann, wann eine Seite oder Studie veröffentlicht wurde, ist für Fragen zu Preisen, Regulierungen, Modellveröffentlichungen, Epidemiologie oder Marktstrukturen nicht geeignet.
Forschung zur Inhaltsaktualität in der AI-Suche zeigt, dass Aktualität beeinflusst, ob Systeme eine Seite für eine aktuelle Frage abrufen. Arbeiten zur Nachverfolgung von AI-Zitaten warnen ebenfalls, dass Suchmaschinen Quellen kontinuierlich neu bewerten, sodass ein gestern noch sauberer Bericht unbemerkt veralten kann. Ihr Audit sollte deshalb drei Daten und nicht nur eines erfassen:
- Quelldatum – Zeitstempel der Veröffentlichung oder letzten Aktualisierung auf der Seite oder in der Studie
- Evidenzdatum – Jahr, in dem die zugrunde liegenden Daten erhoben wurden
- Antwortdatum – Zeitpunkt, zu dem der Assistent die Quelle abgerufen hat
Ein häufiger Fehler ist das Zitieren einer Übersicht aus 2019 für eine „aktuelle“ Prävalenzzahl oder das Zitieren eines Live-Dashboards, ohne den Abrufzeitstempel zu erfassen. Akademische Spezialisten wie Elicit und Consensus zeigen üblicherweise das Veröffentlichungsjahr an, weil sie auf Studienmetadaten basieren. Open-Web-Tools tun dies oft nicht, sofern sie nicht dazu angewiesen werden. Jenova kann Daten ausgeben, wenn das abgerufene Dokument sie offenlegt, kann jedoch keinen vertrauenswürdigen Zeitstempel für eine undatierte Seite erfinden – und sollte dies auch sagen.
Beispiele für Aktualitätsprüfungen:
„Wie lautet die aktuelle Zahl mit Stand 2026? Gib das Aktualisierungsdatum der Quelle an. Wenn die beste Quelle älter als 18 Monate ist, kennzeichne die Antwort als historisch, nicht als aktuell.“
„Vergleiche die neueste Quelle, die du finden kannst, mit der am häufigsten zitierten älteren Quelle. Was hat sich geändert und was nicht?“
Wenn der Assistent eine überarbeitete HTML-Seite nicht von einem unveränderten PDF-Nachdruck unterscheiden kann, bewerten Sie Aktualität als nicht bestanden, selbst wenn die URL funktioniert.
Wie führen Sie ein wiederholbares TRACE-Audit mit einem einzigen Prompt durch?
Ein wiederholbares Audit führen Sie durch, indem Sie das Set der Prüfungsfragen fixieren, den Bewertungsbogen fixieren und jedes Tool zwingen, dieselben maschinenprüfbaren Felder auszugeben. Das Ziel ist ein Transkript, das ein anderer Forschender erneut bewerten könnte, ohne Ihnen bei der Arbeit zugesehen zu haben.
Verwenden Sie diese Abfolge für Jenovas Academic Research Assistant und wiederholen Sie sie anschließend mit mindestens einem Spezialisten (Elicit oder Scite) und einem Generalisten (Perplexity oder ChatGPT):
- Legen Sie Rolle und Ausgabeanforderungen vor der Frage fest.
- Stellen Sie je eine Prüfung aus jeder Klasse: quantitativ, widersprüchlich, Primärdokument und unbekannt.
- Verlangen Sie zu jedem Zitat Titel, URL, Datum, Zitat und Behauptungslabel.
- Klicken Sie jeden Link an und bewerten Sie TRACE, bevor Sie Folgefragen stellen.
- Fordern Sie erst danach eine Überarbeitung fehlgeschlagener Behauptungen an.
Ausgangsvertrag:
„Du wirst auditiert. Gib für jede wesentliche Behauptung aus: Behauptungstext; Label (
sourced/inferred/unknown); Quellentitel; anklickbare URL; Veröffentlichungs- oder Aktualisierungsdatum; unterstützendes Zitat ≤25 Wörter. Wenn die Übereinstimmung nicht vollständig ist, stufe das Label aufinferredoderunknownherab. Zitiere keine Quellen, die du nicht abgerufen hast. Beende die Antwort mit einem Abdeckungshinweis, der verwendete und fehlende Quellentypen aufführt.“
Bei Elicit lautet das parallele Verfahren: Stellen Sie dieselbe Frage als Research Report und prüfen Sie dann Extraktionszellen stichprobenartig gegen die PDF-Textspanne. Bei Scite führen Sie die Kernbehauptung als Zitationskontext-Anfrage aus und zählen unterstützende gegenüber widersprechenden Studien, bevor Sie einen nach Konsens klingenden Satz akzeptieren. Auch beim ChatGPT Deep Research erfordert OpenAIs eigener Recherche-Workflow, dass Sie Quellen prüfen; das Produktmerkmal ist Retrieval plus Struktur, kein Ersatz für die Implikationsprüfung.
Führen Sie ein einfaches Protokoll – Behauptung, URL, Datum, TRACE-Scores, Notizen. Zehn Behauptungen über vier Prüfungen reichen aus, um ein Muster zu erkennen. Wenn mehr als zwei numerische Behauptungen bei der Übereinstimmung scheitern, verwenden Sie das Tool nicht mehr für Ergebnisse, die von anderen zitiert werden.
Was sagen Praktiker der Forschungsintegrität über das Testen von AI-Zitaten?
Die Praxis der Forschungsintegrität hat sich auf eine klare Regel geeinigt: Behandeln Sie AI-Zitate als nicht verifizierte Behauptungen, bis ein Mensch oder eine automatisierte Implikationsprüfung die Quelle geöffnet hat. Die nützliche Debatte dreht sich nicht mehr darum, ob Modelle halluzinieren, sondern darum, welche Fehler Sie instrumentieren können.
„Das Feld optimiert weiterhin für schönere Bibliografien. Das ist die falsche Einheit. Ein Zitat ist ein Verweis, kein Beweis. Wenn die zitierte Passage den Satz nicht impliziert – insbesondere die Zahl, die Population und das Jahr –, ist das Zitat dekorativ. Wir haben erlebt, wie Fehler vom Typ ‚78 % statt 80 %‘ jede kosmetische Prüfung bestanden: echte URL, relevanter Titel, selbstsicherer Ton. Das sind die Fehler, die es in Manuskripte schaffen.“
„Gekennzeichnete Schlussfolgerungen sind die günstigste Kontrolle, die die meisten Teams auslassen. Sobald ein Assistent Retrieval mit Weltwissen vermischen darf, wird er Vermutungen als Erkenntnisse waschen. Erzwingen Sie drei Kategorien – belegt, abgeleitet, unbekannt – und Ihre Halluzinationsrate wird sichtbar. Teams, die sich weigern, eine Kategorie für Unbekanntes zu zeigen, sagen Ihnen, dass sie Unsicherheit nicht darstellen können.“
„Abdeckungstests sind auch eine Governance-Entscheidung. Ein Assistent nur für Studien wird rigoros wirken und dennoch das Behördenmemo übersehen, das die Regel im letzten Monat geändert hat. Ein Assistent nur für das Web wird aktuell wirken und dennoch die Studie übersehen, die das Ergebnis tatsächlich gemessen hat. Die Modellauswahl ist hier wichtig, weil manche Modelle Einschränkungen formulieren, manche komprimieren und manche weglassen. Das Audit muss der Behauptung folgen, nicht der Marke.“
— Jenova Product Team, Bewertung von Rechercheagenten, 6 Jahre Aufbau von Retrieval- und Zitationsworkflows für akademische und professionelle Nutzende
Diese Position entspricht der Bibliothekspraxis. Northwestern dokumentiert Fälle, in denen ein Modell einen echten Enzyklopädieartikel zitierte und dennoch Namen und Daten falsch angab. UNR rät Forschenden, zu fragen, wer die Behauptung überprüfen kann. Beide stellen TRACE in Prosaform dar.
Wann ist ein AI-Rechercheassistent gut genug für echte Forschung?
Ein AI-Rechercheassistent ist gut genug, wenn er ein TRACE-Audit für Ihre tatsächlichen Fragetypen besteht und fehlgeschlagene Behauptungen entweder anhand der Quelle korrigiert oder zu gekennzeichneten Schlussfolgerungen herabstuft. Er ist nicht gut genug, wenn er flüssige, linkreiche Antworten erzeugt, die bei einer Klick- und Implikationsprüfung zusammenbrechen.
Verwenden Sie diese Entscheidungsregel:
- Verwenden Sie einen Spezialisten für Extraktion wie Elicit, wenn die Aufgabe das Screening oder die Datenextraktion aus einer bekannten Studienmenge umfasst und Sie die Zellen dennoch stichprobenartig überprüfen werden.
- Verwenden Sie Scite, wenn die Frage lautet, ob die Literatur eine bestimmte Behauptung stützt, erwähnt oder ihr widerspricht.
- Verwenden Sie Consensus, wenn Sie eine schnelle Einschätzung der Evidenzrichtung zu einer eingegrenzten wissenschaftlichen Frage benötigen.
- Verwenden Sie Perplexity oder ChatGPT für eine breite Erstorientierung und überprüfen Sie anschließend jede Zahl erneut, bevor sie in ein Manuskript aufgenommen wird.
- Verwenden Sie Jenovas Academic Research Assistant, wenn die Arbeit mehrere Gesprächsrunden umfasst – Literaturrecherche, Manuskriptsprache und Zitationsmanagement in einem auditierbaren Verlauf – und Sie bereit sind, TRACE-Felder im Prompt zu verlangen.
Verwenden Sie keines dieser Tools als unbeaufsichtigte letzte Meile. Die JMIR-Ergebnisse zur Zitationsgenauigkeit und die Halluzinationsraten von Stanford HAI sind ein ausreichender Grund, Menschen im Prozess zu halten. Das beste Setup im Jahr 2026 ist nicht ein einzelnes „vertrauenswürdiges“ Modell. Es ist ein Quellenpfad, den Sie wiederholen können: anklickbare Links, datierte Dokumente, implizierte Behauptungen und eine sichtbare Grenze zwischen Evidenz und Schlussfolgerung.
Referenzen
- Northwestern University Libraries — Bewertung von AI-generierten Inhalten
- University of Nevada, Reno Libraries — AI- und Quellenbewertung
- JMIR — Bewertung der Leistung großer Sprachmodelle und der Zuverlässigkeit generierter Zitate
- Stanford HAI — AI vor Gericht: Juristische Modelle halluzinieren bei einer von sechs oder mehr Benchmark-Anfragen
- AuthorityTech — SEO-Inhaltsaktualität im Jahr 2026
- Chris Long / Ahrefs-Diskussion — Aktualität und Sichtbarkeit in der AI-Suche
- ACL Findings — Präzise und differenzierte Open-QA-Evaluierung durch textuelle Implikation
- NVIDIA Developer — Automatische Zitatvalidierung mit NVIDIA NIM
- Elicit — AI für wissenschaftliche Forschung, Abdeckung und Extraktionsgenauigkeit
- Scite — Smart Citations für wissenschaftliche Literatur
- The Drive AI — Elicit vs. Consensus vs. Semantic Scholar
- iatroX — Beste AI-Tools für medizinische Forschung 2026
- HKUST Library — Vergleich neuer AI-Tools für Literaturübersichten
- Omid Saffari — Beste AI-Recherchetools 2026: Elicit vs. Consensus
- Pure AI — Zitat erforderlich: Sieben AI-Recherchetools im Test
- SEOptimer — Inhaltsaktualität in SEO und AI-Suche
- OtterlyAI — AI-Suchmaschinenzitate und Quellen nachverfolgen
- Firecrawl — Websuche und Deep Research für AI-Agenten
- OpenAI Academy — Recherche mit ChatGPT: Search und Deep Research