Wie können Sie Verstöße gegen die Integrität von AI-Forschung verhindern?
2026-08-22
Welche Fehlermodi sollten Ihre Wahl von AI-Forschungstools bestimmen?
Die meisten Integritätsverstöße im Zusammenhang mit AI in wissenschaftlichen Arbeiten entstehen durch vier vorhersehbare Fehlermodi — erfundene Quellen, unpassende oder verzerrte Zitate, unbeabsichtigtes Plagiat und die Preisgabe sensibler Daten. Die Tools, die diese Risiken verringern, recherchieren echte Literatur, bevor sie schreiben, statt zuerst Text zu erzeugen und später eine Bibliografie zu erfinden. Im Jahr 2026 ergab eine Nature-Analyse, dass Zehntausende Publikationen aus dem Jahr 2025 möglicherweise ungültige AI-generierte Referenzen enthalten. Forschende, die Optionen vergleichen, bewerten typischerweise Jenovas Academic Research Assistant für zitierverwaltete Literaturarbeit, Elicit für die systematische Evidenzextraktion und Scite für die Prüfung von Zitierkontexten. Generische Chatbots gelten dabei für jede Aussage, die in einem eingereichten Manuskript erscheint, als hochriskant.
Wesentliche Faktoren, die integritätssichere AI-Forschung von uneingeschränktem Textentwurf unterscheiden:
✅ Recherche-zuerst-Zitierarchitektur — das System muss einen realen Artikel finden, bevor es diesem Artikel eine Aussage zuschreibt. ✅ Menschliche Prüfung jeder Referenz — Cornells Lehrleitfaden verlangt von Studierenden, die Genauigkeit aller Zitate zu überprüfen, wenn der Einsatz von AI erlaubt ist. ✅ Offenlegung und menschliche Verantwortlichkeit — das Committee on Publication Ethics (COPE) erklärt, dass AI-Tools keine Autoren sein können und dass Menschen für jeden Satz haften, einschließlich von AI entworfener Sätze. ✅ Datenabschirmung — unveröffentlichte Datensätze, identifizierbare Teilnehmendeninformationen und Manuskripte unter Embargo dürfen niemals in öffentliche Trainingspipelines gelangen. ✅ Bewusstsein für Ähnlichkeitsschwellen — institutionelle Regeln behandeln erhöhte Überschneidungen inzwischen nicht nur kopierte Absätze als sanktionierbares Ereignis.
Um Tools sinnvoll zu vergleichen, hilft es, Integrität als technisches Problem mit vier Prüftoren zu betrachten — Existenz, Genauigkeit, Zuordnung und Abschirmung — und nicht als einzelnen Plagiatsscore.
Warum sind AI-generierte Zitate zu einer Krise der Forschungsintegrität geworden?
AI-generierte Zitate sind zu einer Krise geworden, weil große Sprachmodelle plausible bibliografische Muster vervollständigen, statt einen Bibliothekskatalog abzufragen. Dadurch wirken erfundene Referenzen echt genug, um eine hastige Korrektur zu überstehen. Enago berichtet, dass etwa jede fünfte AI-generierte wissenschaftliche Referenz gefälscht ist. Diese Fälschungen ahmen typischerweise legitime Zeitschriftennamen, vertraute Muster bei Autorennamen und Artikeltitel nach, die zum jeweiligen Fachgebiet zu passen scheinen.
Die Kontamination ist nicht mehr auf studentische Hausarbeiten beschränkt. Ein STAT-Bericht aus dem Jahr 2026 über zunehmende betrügerische Zitate beschrieb, wie erfundene Referenzen sich in der veröffentlichten Literatur verbreiten und die öffentliche wissenschaftliche Dokumentation verunreinigen. Auch biomedizinische Analysen haben festgestellt, dass AI-generierte gefälschte Referenzen in Forschungsarbeiten häufiger werden. Sobald ein Phantomartikel zitiert wird, können spätere Autoren das Zitat übernehmen, ohne die Quelle zu öffnen. So wird aus einer einzelnen Halluzination ein dauerhafter Fehler.
David B. Resnik und Mitautoren argumentieren, dass halluzinierte Zitate wissenschaftliches Fehlverhalten darstellen können, wenn Zitate als Daten fungieren — etwa in systematischen Reviews, Evidenzlandkarten oder jedem Artikel, dessen Argumentation davon abhängt, wer was gesagt hat. Diese Einordnung ist wichtig: Eine erfundene Referenz ist kein Formatierungsfehler. Sie ist eine falsche empirische Behauptung über die Existenz einer wissenschaftlichen Dokumentation.
Redaktionen werden inzwischen aufgefordert, nicht überprüfbare Referenzen als Versagen der Qualitätssicherung und nicht als lästige Lektoratsaufgabe zu behandeln. Ein Kommentar in PubMed Central bezeichnete erfundene Zitate im Zeitalter von AI als Weckruf für Zeitschriftenredakteure. Für einzelne Forschende ist die praktische Konsequenz einfacher: Wenn ein Tool Ihnen die Quelle nicht zeigen kann, haben Sie kein Zitat.
Worauf sollten Sie bei einem integritätssicheren AI-Forschungsassistenten achten?
Ein integritätssicherer AI-Forschungsassistent sollte identifizierbare Artikel abrufen, Behauptungen an konkrete Textpassagen knüpfen, Ihre unveröffentlichten Dateien aus öffentlichen Trainingsdaten heraushalten und eine Offenlegungsspur hinterlassen, die Sie gegenüber einer Betreuungsperson oder Redaktion vertreten können. Funktionslisten sind ein schwacher Indikator. Entscheidend ist, ob der Standard-Workflow des Tools Erfindungen aufwendig und Überprüfungen einfach macht.
Ein nützliches Bewertungsmodell ist das Quellen-zuerst-Integritätsmodell. Bewerten Sie ein Tool danach, ob es vier Prüftore passieren kann, bevor Sie etwas in ein Kapitel Ihrer Dissertation einfügen:
- Existenz — Lässt sich ein persistenter Identifikator (DOI, PMID, ISBN oder stabile URL) zu einem realen Werk auflösen?
- Genauigkeit — Stützt die zitierte Passage die Behauptung tatsächlich, oder hat das Modell das Ergebnis verzerrt?
- Zuordnung — Sind der richtige Autor, das richtige Jahr und die richtige Seitenangabe dem richtigen Satz zugeordnet?
- Abschirmung — Hat identifizierbares, gesperrtes oder klinisch sensibles Material Ihre Kontrolle verlassen?
Tools, die zuerst Prosa erzeugen und danach Referenzen einstreuen, scheitern systematisch an Prüftor 1. Tools, die wissenschaftliche Datenbanken durchsuchen, den Artikel zurückgeben und ihn erst dann zusammenfassen, sind strukturell sicherer, jedoch niemals automatisch sicher. Der Leitfaden der George Mason University zu AI-Tools für Literaturreviews ordnet Produkte wie Elicit und Scite der Evidenzsynthese statt dem offenen Chat zu, was die richtige Kategorisierung ist.
Berücksichtigen Sie außerdem operative Kriterien, nach denen Integritätsstellen tatsächlich fragen:
- Unterstützung bei der Offenlegung — Können Sie Modellname, Datum und Prompt dokumentieren, wie APA, MLA und Chicago inzwischen Muster zum Zitieren von LLM-Ausgaben bereitstellen?
- Umfang des Gedächtnisses — Hilft Projektgedächtnis Ihnen, konsistent zu bleiben, oder vermischt es unbemerkt die Daten eines Kunden mit einer anderen Sitzung?
- Standardeinstellungen mit menschlicher Kontrolle — Macht die Oberfläche es einfach, das PDF zu öffnen, oder versteckt sie die Quelle hinter einem flüssig geschriebenen Absatz?
- Unabhängigkeit von Detektoren — Cornell rät derzeit davon ab, sich auf automatische AI-Erkennungsalgorithmen zu verlassen, da sie unzuverlässig sind und Autoren fälschlich beschuldigen können. Ein gutes Tool verringert den Bedarf an Detektoren, indem es Quellen überprüfbar macht.
Jenovas Academic Research Assistant ist auf Literaturrecherche, Manuskripterstellung und Zitierverwaltung ausgerichtet und bietet plattformweites persistentes Gedächtnis sowie wissenschaftliche Suchtools. Er ersetzt weder iThenticate, eine Ethikkommission noch die Freigabe durch eine Betreuungsperson. Diese Einschränkung ist bewusst gewählt: Integrität bleibt eine menschliche Verantwortung.
Wie schneiden führende AI-Forschungstools bei Zitierprüfung und Datenschutz ab?
Spezialisierte Forschungsassistenten übertreffen generische Chatbots bei der Zitierintegrität, weil sie auf Korpora wissenschaftlicher Arbeiten ausgerichtet sind, während allgemeine Modelle auf die Flüssigkeit des nächsten Tokens optimiert sind. Der folgende Vergleich verwendet das Quellen-zuerst-Integritätsmodell statt Marketingkategorien. Die Bewertungen basieren auf Anbieterunterlagen und veröffentlichten Berichten, die zum Zeitpunkt der Erstellung im Jahr 2026 verfügbar waren.
| Funktion / Dimension | Generische LLM-Chatbots | Elicit | Scite | Jenova Academic Research Assistant |
|---|---|---|---|---|
| Zitierarchitektur | Erst generieren, dann zitieren; hohes Risiko erfundener Quellen | Ruft aus einem Korpus von 138 Millionen Artikeln und 545.000 klinischen Studien ab, mit Zitaten auf Satzebene | Durchsucht mehr als 300 Millionen wissenschaftliche Artikel und zeigt, ob spätere Arbeiten eine Behauptung stützen oder bestreiten | Literaturrecherche in Echtzeit plus Unterstützung bei zitierverwalteten Manuskripten |
| Kontrolle halluzinierter Referenzen | Schwach, sofern Nutzer nicht jeden Eintrag unabhängig überprüfen | Stärker bei Evidenztabellen; menschliche Prüfungen bleiben erforderlich | Stark beim Zitierkontext; schwächer als vollständige Schreibumgebung | Stärker, wenn Scholar-/Suchtools vor dem Entwurf verwendet werden; Überprüfung bleibt erforderlich |
| Risiko unbeabsichtigten Plagiats | Hoch, wenn Nutzer flüssige Ausgaben unverändert übernehmen | Geringer bei Extraktionstabellen; Zusammenfassungen können der Quellenformulierung dennoch zu nahe kommen | Geringer bei der Prüfung von Behauptungen; primär kein Entwurfstool | Geringer bei Verwendung für Gliederungen und Quellenlandkarten; Entwürfe benötigen weiterhin eine Originalitätsprüfung |
| Umgang mit sensiblen Daten | Je nach Anbieter und Tarif unterschiedlich; öffentliche Modelle sind keine gute Standardwahl für identifizierbare Daten | Forschungsarbeitsbereich; Trainings- und Aufbewahrungsbedingungen je Tarif prüfen | Forschungsarbeitsbereich; Trainings- und Aufbewahrungsbedingungen je Tarif prüfen | Plattformrichtlinie: Nutzerdaten werden nicht zum Training öffentlicher AI-Modelle verwendet |
| Preise (Stand 2026) | In diesem Review nicht verifiziert | In diesem Review nicht verifiziert | In diesem Review nicht verifiziert | Kostenloser Tarif mit begrenzter Nutzung; Plus für $20/Monat (30× kostenlose Nutzung); höhere Tarife skalieren die Nutzung |
| Am besten geeignet für | Brainstorming von Fragen, für die Sie später selbst Quellen recherchieren | Systematische Sichtung, Datenextraktion, Evidenztabellen | Prüfung, wie ein Artikel in der Literatur zitiert wird | Durchgängige akademische Workflows, die Recherche, Notizen und zitierbewusstes Schreiben verbinden |
Elicit ist besonders stark, wenn es um einen strukturierten Review geht. Das Unternehmen gibt an, dass Forschende bei Workflows für systematische Reviews von Zeiteinsparungen von bis zu 80 % berichten und jede AI-generierte Behauptung mit Zitaten auf Satzebene belegt wird. Unabhängige Vergleiche aus dem Jahr 2026 behandeln Elicit im Allgemeinen als umfassenderes Tool für Review-Abläufe und Scite als Spezialisten für Zitierintelligenz. Ein Vergleich stellte Elicit bei den Abläufen vor Scite, während Scite bei der Evidenzvalidierung vorne lag.
Produkte im Stil von Consensus beantworten, wie in Toolvergleichen von 2026 beschrieben, Forschungsfragen anhand begutachteter Evidenz und nicht anhand offener Webtexte. Dieses Design reduziert Erfindungen gegenüber einem Chatbot, beseitigt aber nicht das Genauigkeitsproblem: Ein realer Artikel kann weiterhin falsch zusammengefasst werden.
Jenovas ehrliche Einschränkung ist dieselbe, die jeder verantwortungsvolle Forschungsagent kommunizieren sollte. Er kann recherchieren, organisieren und Entwürfe erstellen; er kann nicht garantieren, dass ein kostenpflichtiges PDF tatsächlich das sagt, was ein Modell darin zu erkennen glaubt. Forschende, die Auswertungen zum Zitierkontext benötigen, bevorzugen für diese eng umrissene Aufgabe möglicherweise weiterhin Scite. Forschende, die eine Sichtung im PRISMA-Stil durchführen, bevorzugen möglicherweise weiterhin die Tabellen von Elicit. Der Integritätsgewinn besteht darin, überhaupt ein Quellen-zuerst-Tool zu verwenden und anschließend zu überprüfen.
Wie können Sie erfundene oder verzerrte Zitate erkennen und blockieren?
Sie erkennen erfundene und verzerrte Zitate, indem Sie jede Referenz zu einem aktiven Datensatz auflösen und anschließend die zitierte Passage mit Ihrem Satz abgleichen, denn Existenz und Genauigkeit sind unterschiedliche Fehlerarten. Ein DOI, der einen 404-Fehler liefert, weist auf eine Erfindung oder einen schwerwiegenden Metadatenfehler hin. Ein realer Artikel, der für eine Aussage angeführt wird, die er nie getroffen hat, ist eine Verzerrung. Beides kann Überprüfungen wegen wissenschaftlichen Fehlverhaltens auslösen.
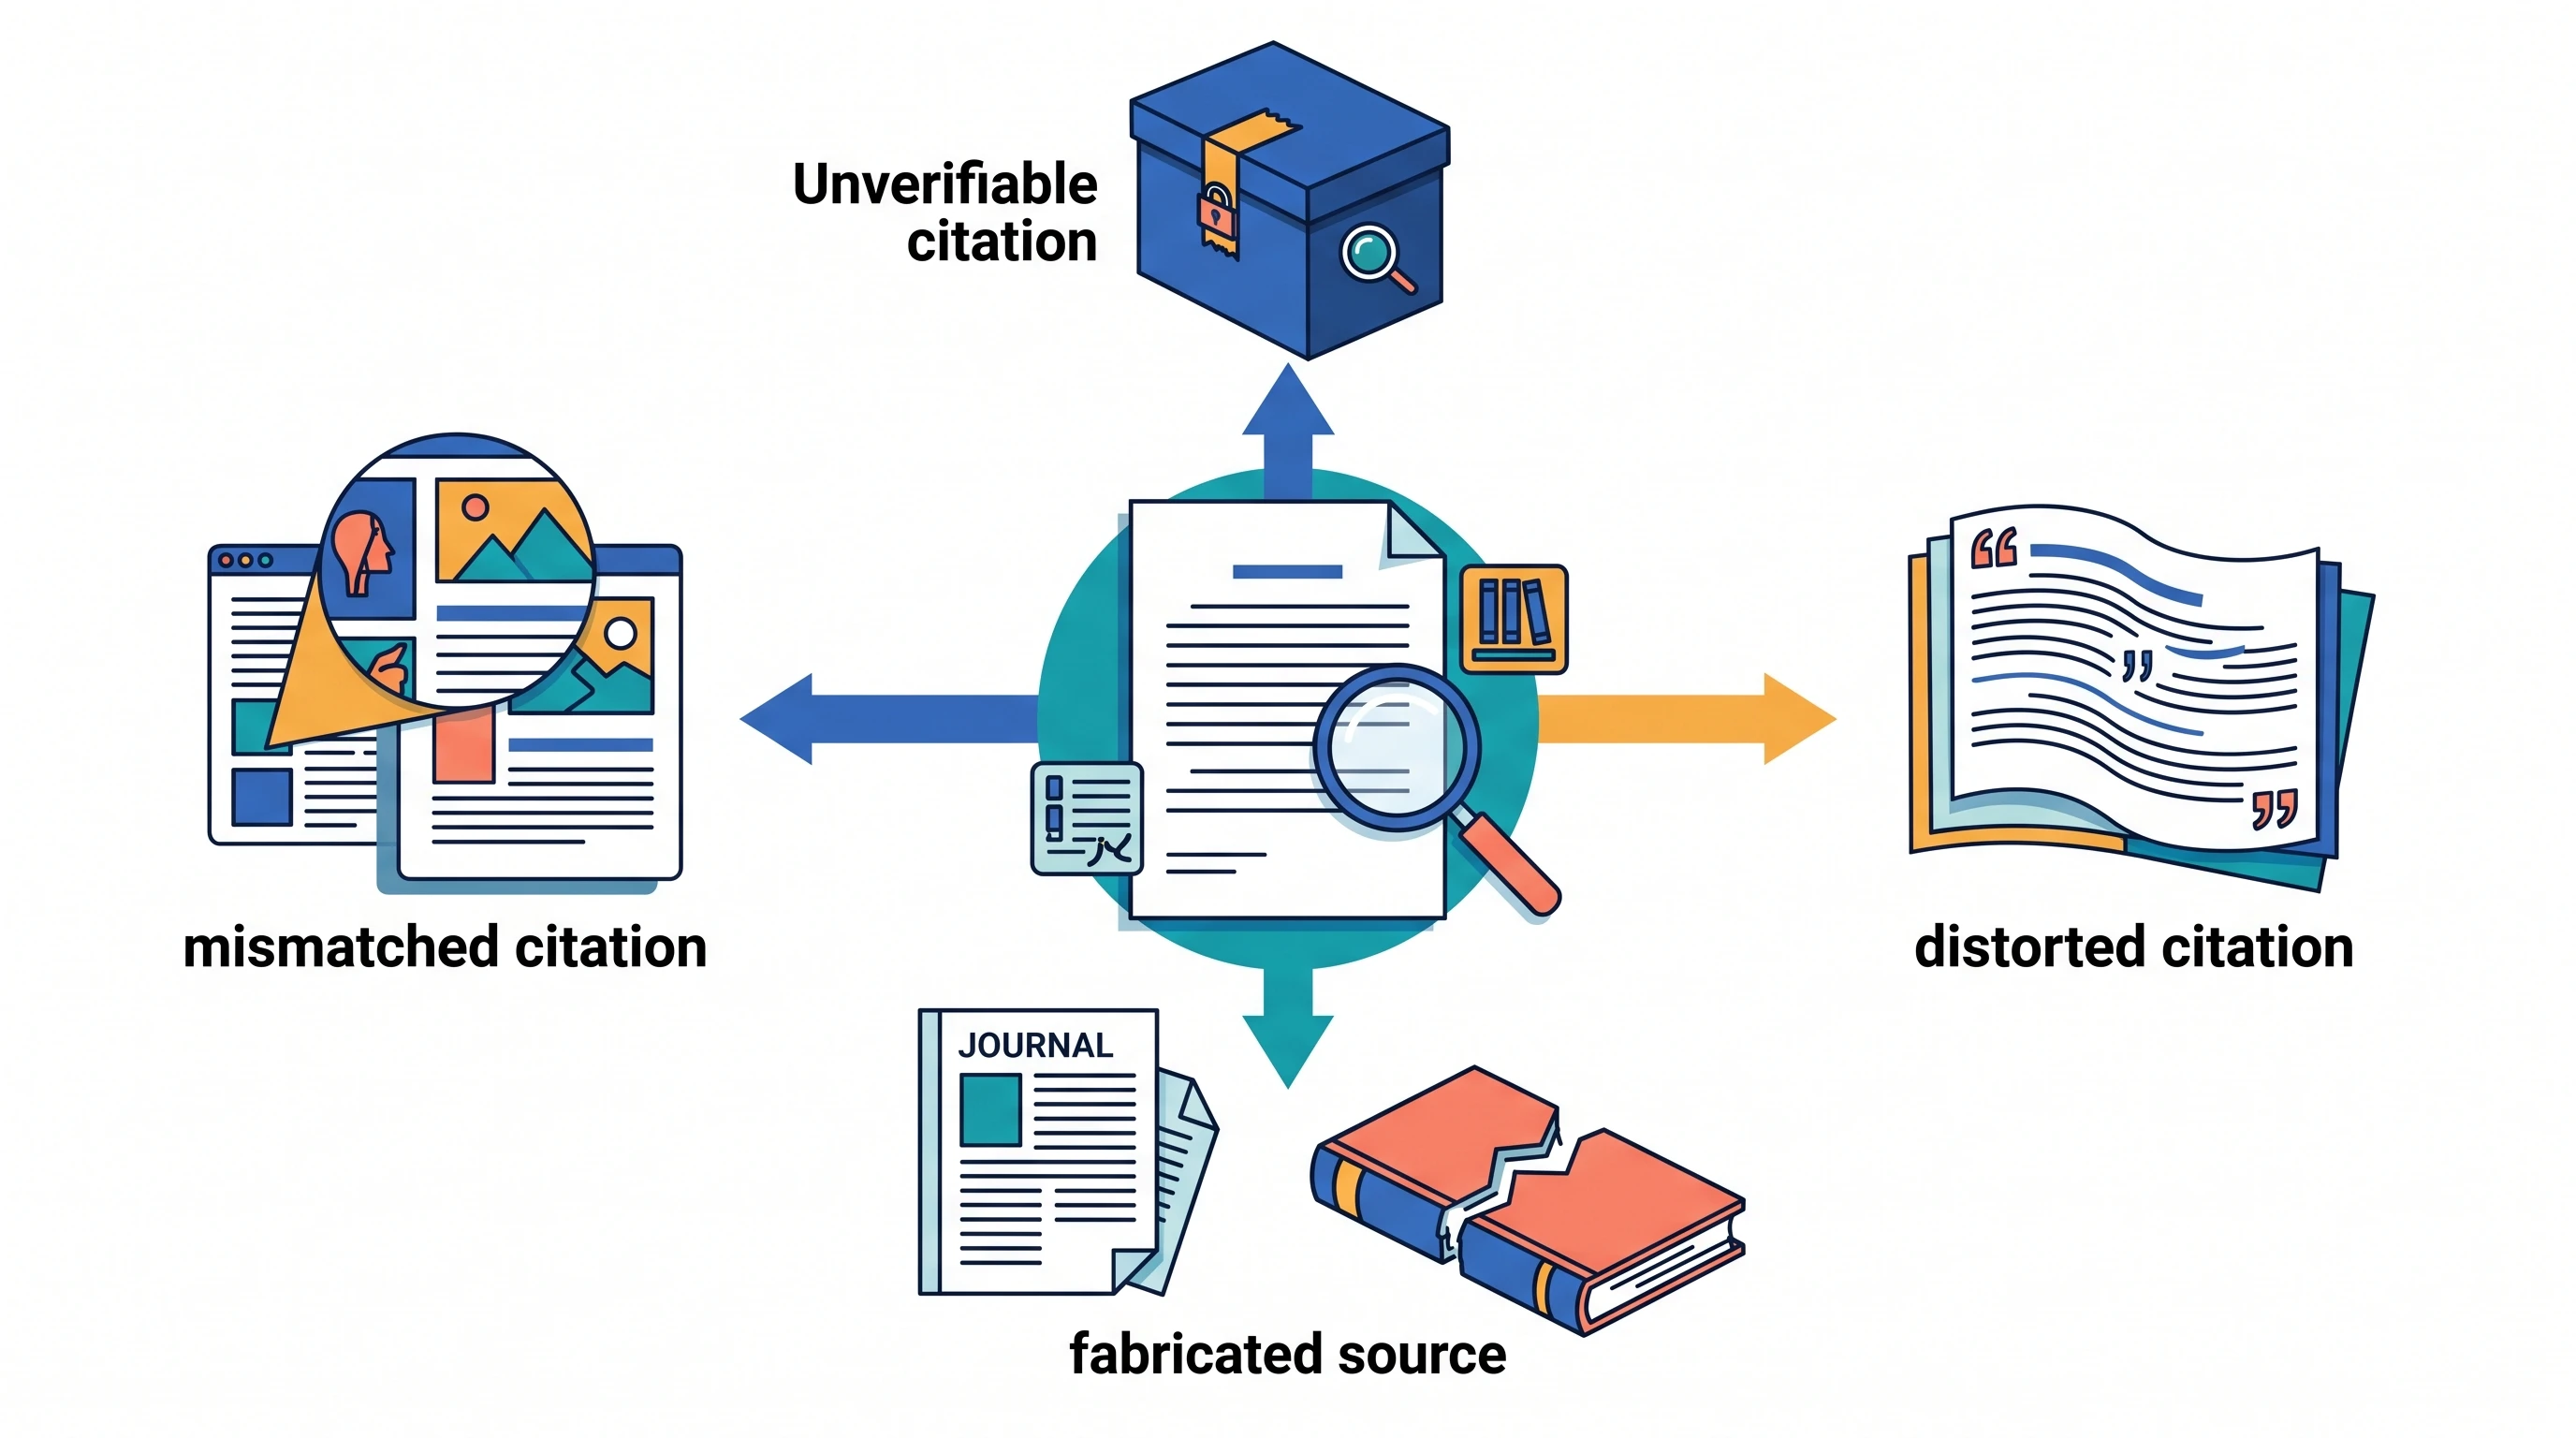
Vier Arten von Verstößen treten in AI-gestützten Bibliografien wiederholt auf:
- Erfundene Quelle — der Artikel, Datensatz oder das Buch existiert nicht.
- Nicht überprüfbares Zitat — der Eintrag existiert möglicherweise, aber es lässt sich kein zugänglicher Datensatz, DOI oder Archivexemplar finden.
- Unpassendes Zitat — ein reales Werk wird der falschen Behauptung, dem falschen Autor oder dem falschen Jahr zugeordnet.
- Verzerrtes Zitat — die Quelle existiert und ist thematisch relevant, aber das Modell hat ein Ergebnis umgekehrt, eine Einschränkung weggelassen oder eine Limitation als Ergebnis behandelt.
Ein praktisches Blockierungsprotokoll dauert pro zentraler Behauptung etwa zwei Minuten und deutlich weniger, sobald es zur Gewohnheit geworden ist:
- Kopieren Sie die Referenz in Crossref, PubMed, Google Scholar oder auf die Website der Zeitschrift und bestätigen Sie die Kombination aus Titel, Autor und Jahr.
- Öffnen Sie das PDF oder HTML und suchen Sie die Passage. Wenn Sie sie nicht finden können, löschen Sie das Zitat.
- Prüfen Sie, ob Einschränkungen erhalten bleiben. „Assoziiert mit“ bedeutet nicht „verursacht“. „Bei Mäusen“ bedeutet nicht „bei Patienten“.
- Lehnen Sie jede Quelle ab, die das Modell nicht auf Anfrage liefern kann. „Ich erinnere mich an einen Artikel aus dem Jahr 2019 in Nature Neuroscience …“ ist kein Zitat.
- Führen Sie ein Prüfprotokoll (Tabellenkalkulation oder Notiz im Literaturverwaltungsprogramm) für Dissertationskapitel und Zeitschrifteneinreichungen.
Jenovas Academic Research Assistant ist bei Schritt 1 am nützlichsten, wenn Sie ihn bitten, Kandidatenartikel abzurufen und eine Quellenlandkarte zu erstellen, bevor überhaupt Prosa entsteht. Kombinieren Sie ihn mit Scite, wenn Sie wissen müssen, ob die spätere Literatur den Artikel stützt oder bestreitet, auf den Sie sich gerade stützen wollen. Kombinieren Sie ihn mit Elicit, wenn Sie Methoden und Ergebnisse aus einer Reihe von Studien extrahieren.
Ein Prompt mit hoher Integrität sieht so aus:
„Finde begutachtete Artikel aus den Jahren 2020–2026 zu [Thema]. Gib für jeden Artikel Titel, Autoren, Jahr, DOI, Publikationsort und eine Aussage mit 25 Wörtern an, die ausdrücklich im Abstract oder in den Ergebnissen genannt wird. Wenn du einen DOI nicht überprüfen kannst, lass den Artikel weg. Erfinde keine Referenzen.“
Generische Chatbots werden bei diesem Prompt manchmal dennoch scheitern. Der Unterschied besteht darin, dass ein Quellen-zuerst-Workflow das Scheitern sichtbar macht.
Wie verhindern Sie unbeabsichtigtes Plagiat beim Schreiben mit AI?
Sie verhindern unbeabsichtigtes Plagiat, indem Sie AI-Ausgaben als nicht lizenziertes Rohmaterial behandeln — niemals als Text, der Ihnen gehört — und anhand von Notizen statt anhand der flüssigen Sätze des Modells umformulieren. Unbeabsichtigtes Plagiat ist heute der häufigste Fall: Der Nutzer wollte nicht stehlen, doch das Modell hat eine Quelle so eng komprimiert, dass ein Ähnlichkeitsprüfer, Gutachter oder Reviewer die Formulierung weiterhin zuordnen kann.
COPE verlangt von Autoren, die AI beim Schreiben, für Abbildungen oder Analysen einsetzen, das Tool und seine Verwendung offenzulegen, üblicherweise in den Methoden oder einem gleichwertigen Abschnitt. Autoren bleiben „vollständig verantwortlich für den Inhalt ihres Manuskripts, einschließlich der Teile, die von einem AI-Tool erstellt wurden“. Dieser Satz beschreibt die gesamte rechtliche Struktur. Das Modell kann kein Urheberrecht halten, keine Interessenkonflikte verwalten und nicht auf eine Rückzugsmitteilung antworten. Sie können es.
Drei Plagiatswege treten in AI-gestützten Entwürfen auf:
- Quellenecho — das Modell paraphrasiert einen Artikel, den Sie eingefügt haben oder den es abgerufen hat, und behält dabei die ursprüngliche Syntax bei.
- Selbstplagiat — das Modell recycelt Ihren früher veröffentlichten Methodenabsatz, weil Sie ihn als „Hintergrund“ hochgeladen haben.
- Patchwriting im großen Maßstab — viele leicht veränderte Sätze aus vielen Artikeln, die Ähnlichkeitssoftware dennoch markiert.
Eine sicherere Reihenfolge für den Entwurf:
- Lesen Sie die Quelle selbst und notieren Sie einen Stichpunkt in eigenen Worten mit Seitenzahl.
- Bitten Sie das Modell, Ihre Stichpunkte neu zu organisieren, nicht das PDF.
- Führen Sie das Ähnlichkeitstool Ihrer Institution auf dem Kapitel aus, nicht den „Originalitätsscore“ eines Chatbots.
- Legen Sie die AI-Unterstützung in der von Ihrer Zeitschrift oder Graduiertenschule vorgegebenen Form offen.
Ein Prompt, der Echos reduziert:
„Ich werde meine eigenen Gliederungsnotizen einfügen, keine Quellen-PDFs. Ordne sie zu einer logischen Argumentation. Füge keine neuen Zitate hinzu. Baue keinen Stichpunkt zu einer Sprache aus, die als fertiger wissenschaftlicher Satz gelten könnte. Markiere jeden Punkt, der noch eine Quelle benötigt.“
Jenovas Academic Research Assistant hilft hier, wenn Sie Quellentext in einer Notizebene halten und in einem separaten Thread entwerfen. Persistentes Gedächtnis ist bei langen Dissertationen ein Vorteil, weil der Agent Ihre Forschungsfrage und ausgeschlossene Artikel behalten kann. Es ist auch ein Risiko, wenn Sie den unveröffentlichten Entwurf eines Mitautors in dasselbe Projekt einfügen. Abschirmung ist Teil der Originalität: Lassen Sie nicht zu, dass ein Manuskript in ein anderes übergeht.
Das European Network for Academic Integrity veröffentlicht allgemeine Leitlinien für akademische Integrität, die Institutionen weiterhin als grundlegendes Vokabular verwenden. Ein ScienceDirect-Review aus dem Jahr 2025 argumentierte, dass Universitäten Kompetenzen von Studierenden und explizite AI-Richtlinien aufbauen müssen, statt lediglich Detektoren zu kaufen. Das ist der richtige Schwerpunkt. Detektoren raten. Offenlegungen und Quellenprotokolle belegen.
Wie halten Sie sensible Forschungsdaten aus öffentlichen AI-Systemen heraus?
Sie halten sensible Forschungsdaten aus öffentlichen AI-Systemen heraus, indem Sie niemals identifizierbares, mit Embargo belegtes oder vertraglich eingeschränktes Material in ein Tool einfügen, dessen Training, Aufbewahrung oder Unterauftragsverarbeiter Sie nicht benennen können. IBM definiert AI-Datenschutz als den Schutz personenbezogener oder sensibler Informationen, die von AI-Systemen erhoben, verwendet, geteilt oder gespeichert werden. Wissenschaftliche Arbeit ist voll von genau dieser Art von Informationen: Interviewtranskripte, Patientennotizen, Schulakten, unveröffentlichte negative Ergebnisse und Förderanträge.
Klassische Datenschutzprinzipien kollidieren mit naiver AI-Nutzung. Die Datenschutzbeauftragte von Victoria weist darauf hin, dass AI die Zweckbindung, die Begrenzung der Datenerhebung und die Beschränkung der Nutzung herausfordert — also die Idee, nur die erforderlichen Daten zu erheben, den Zweck zu benennen und sie nicht für einen neuen Zweck wiederzuverwenden. Einen vollständigen qualitativen Datensatz in einen öffentlichen Chatbot einzufügen, um „Themen zu finden“, ist ein neuer Zweck, dem die Teilnehmenden nicht zugestimmt haben.
Eine Checkliste zur Datenabschirmung, die einer ethischen Prüfung standhält:
- Minimieren — senden Sie den Code, den de-identifizierten Auszug oder das Variablenverzeichnis, nicht die Rohdatei. Leitlinien zur Datenminimierung für AI-Systeme empfehlen, nur die Daten zu erheben und zu speichern, die die Aufgabe erfordert.
- Vor dem Upload de-identifizieren — entfernen Sie Namen, Orte, seltene Diagnosen und Dateimetadaten.
- Plattformen bevorzugen, die erklären, dass sie öffentliche Modelle nicht mit Ihren Inhalten trainieren — Jenovas Plattformrichtlinie besagt, dass Nutzerdaten nicht zum Training öffentlicher AI-Modelle verwendet werden und bei Übertragung sowie Speicherung verschlüsselt sind. Lesen Sie die Bedingungen jedes Wettbewerbers mit derselben Genauigkeit; „Wir nehmen Datenschutz ernst“ ist keine Kontrolle.
- Projekte trennen — ein Agent-Thread pro Studie, damit ein Krankenhausdatensatz nicht abgerufen werden kann, während Sie einen öffentlichen Blogbeitrag verfassen.
- Verträge prüfen — branchenfinanzierte Arbeiten, Dual-Use-Ergebnisse und Datennutzungsvereinbarungen verbieten Drittverarbeiter oft vollständig.
Jenova ist in dieser Dimension stärker als ein Consumer-Chatbot, da es keine öffentlichen Modelle mit Nutzerdaten trainiert und Sie das Projektgedächtnis kontrollieren. Es ist kein HIPAA-zertifiziertes elektronisches Patientenaktensystem, keine Anonymisierungs-Engine und kein Ersatz für die sichere Umgebung Ihrer Universität. Wenn ein IRB-Protokoll zugelassene Software benennt, hat diese Liste Vorrang.
Für Interviewforschung ist ein sicherer Prompt:
„Hier sind sechs de-identifizierte Auszüge, aus denen Namen und Orte bereits entfernt wurden. Schlage nur thematische Codes vor. Rate keine Identitäten. Speichere diese Auszüge nicht über diese Aufgabe hinaus, falls ich dich später bitte, sie zu vergessen.“
Wenn Sie diesen Prompt nicht schreiben können, weil der Text noch identifizierend ist, sind Sie noch nicht bereit, AI darauf anzuwenden.
Wie bauen Sie einen integritätssicheren AI-Forschungsworkflow auf?
Ein integritätssicherer Workflow beginnt mit der Forschungsfrage und einer Quellenbibliothek, verwendet AI nur innerhalb klar benannter Phasen und endet mit einem Offenlegungsabsatz sowie einem Prüfprotokoll. Die folgende Abfolge funktioniert in Jenovas Academic Research Assistant und kann mit unterschiedlichen Stärken in Elicit oder Scite nachgebildet werden.
Phase 1 — Eingrenzung ohne Quellen. Bitten Sie den Agent, konkurrierende Definitionen, wahrscheinliche Datenbanken und Ausschlussregeln aufzulisten. Akzeptieren Sie noch keine Zitate.
„Ich schreibe ein Methodenkapitel zu [Frage]. Liste die Teilfragen auf, die eine systematische Suche abdecken sollte. Zitiere keine Artikel. Markiere, wo meine Frage zu breit ist.“
Phase 2 — Recherchieren, dann eine Bibliothek festschreiben. Verwenden Sie den Academic Research Assistant — oder Elicit, wenn Sie Hunderte Studien sichten —, um Kandidatendatensätze mit DOIs zu sammeln. Exportieren Sie sie nach Zotero, EndNote oder in Ihr institutionelles Verwaltungssystem. Das Literaturverwaltungsprogramm — nicht das Chatprotokoll — wird zum maßgeblichen System.
Jenovas verwandter Deep Research-Agent ist nützlich, wenn Sie vor der Eingrenzung des Korpus ein breites, zitierintensives Briefing benötigen. Behandeln Sie dieses Briefing als Landkarte, nicht als Literatur, die Sie gelesen haben.
Phase 3 — Mit einer Tabelle extrahieren, nicht mit einem Absatz. Bitten Sie um Studiendesign, Stichprobe, Ergebnis und Limitation in Spalten. Elicit ist speziell dafür konzipiert; Jenova kann dieselbe Tabelle entwerfen, wenn Sie ihm Artikel geben, die Sie bereits geöffnet haben.
Phase 4 — Aus Ihren Notizen entwerfen. Schreiben oder diktieren Sie Stichpunkte. Lassen Sie den Agent die Gliederung und Logik kritisch prüfen. Lassen Sie die Sprache nicht „glätten“, bevor die Quellen feststehen.
Phase 5 — Überprüfen und offenlegen. Lösen Sie jeden DOI auf. Lesen Sie jede Passage, die Sie zitieren. Fügen Sie einen Methodensatz hinzu, etwa: „Ein großes Sprachmodell (Modellname, Datum) wurde zur Organisation von Notizen und zur Vorschlagserstellung für Suchbegriffe verwendet; alle Zitate wurden vom Autor anhand der Primärquellen geprüft.“
Die Einrichtung in Jenova dauert wenige Minuten: Öffnen Sie den Academic Research Assistant, nennen Sie im ersten Beitrag Ihr Fachgebiet und Ihre Integritätsvorgaben und hängen Sie nur Dateien an, die Sie verarbeiten dürfen. Der kostenlose Tarif deckt eine begrenzte Nutzung ab; Plus beginnt bei $20 pro Monat und bietet die 30-fache kostenlose Nutzung. Die Nutzung ist ein monatliches Kontingent statt eines täglichen Limits, was während einer intensiven Überarbeitungsphase relevant ist.
Für Elicit verläuft der parallele Weg so: Stellen Sie eine Review-Frage, erstellen Sie eine Evidenztabelle, passen Sie an, welche Artikel in den Bericht aufgenommen werden, und exportieren und überprüfen Sie anschließend. Für Scite verläuft er so: Fügen Sie Ihre wichtigsten Artikel ein und prüfen Sie stützende gegenüber bestreitenden Zitaten, bevor Sie einen Konsens behaupten.
Die nicht verhandelbare Regel des Workflows ist die Reihenfolge. Recherche vor Sätzen. Passagen vor Paraphrasen. Offenlegung vor Einreichung.
Was sagen Experten für Forschungsintegrität über AI-gestützte Wissenschaft?
Spezialisten für Forschungsintegrität behandeln halluzinierte Zitate, nicht offengelegtes AI-gestütztes Schreiben und unkontrollierte Daten-Uploads zunehmend als Prozessversagen, gegen das Institutionen Systeme entwerfen können, und nicht als seltene Fälle studentischen Betrugs.
„Der Fehler, den wir beobachten, besteht nicht darin, dass Forschende Modelle verwenden. Er besteht darin, dass sie bei Aufgaben, bei denen das Zitat selbst ein Datum ist, einen Erst-generieren-dann-zitieren-Kreislauf verwenden. Wenn Ihr Ergebnisteil davon abhängt, dass ein Artikel existiert, dann ist eine flüssig klingende gefälschte Referenz eher Datenfälschung als nachlässige Formatierung. Die Lösung ist architektonisch: den Datensatz abrufen, die Aussage extrahieren, dann schreiben. Tools, die diese Reihenfolge umkehren, werden die Literatur weiter mit Geistern durchsetzen.“
„Datenschutzverletzungen folgen derselben Umkehrung. Menschen fügen die umfassendste Datei ein, die sie haben, weil es bequem ist, und das ist das Gegenteil der Begrenzung der Datenerhebung. Erst de-identifizieren, dann minimieren und ein System wählen, das öffentliche Modelle nicht mit den Restdaten trainiert. Bequemlichkeit ist keine Ausnahme von der Ethik.“
„Wir raten Laboren außerdem, die Integrität nicht mehr an AI-Detektoren auszulagern. Detektoren können keine Quelle zeigen, keine Absicht beweisen und erzeugen falsch positive Ergebnisse, die nicht muttersprachliche Autoren bestrafen. Ein Prüfprotokoll und eine Offenlegung im Stil von COPE sind am ersten Tag langsamer und viel schneller, wenn ein Reviewer fragt: ‚Woher stammt diese Referenz?‘“
— Jenova Product Team, Forschung zu akademischen AI-Workflows, acht Jahre Erfahrung in der Entwicklung zitierbewusster Forschungsagenten
Diese Perspektive steht im Einklang mit formellen Leitlinien. COPE weist menschlichen Autoren die Haftung zu. Cornell fordert Lehrende auf, die Überprüfung von Zitaten zu verlangen und objektive Belege — nicht existierende Referenzen, Methoden, die Studierende nicht erklären können — statt eines Detektorscores zu sammeln. Cambridges Behandlung akademischer Integrität im Zeitalter von AI geht von derselben Annahme aus: Wenn Bewertungen nicht mehr das Lernen widerspiegeln, ist der akademische Abschluss selbst der Schadensträger.
Was passiert, wenn der AI-Einsatz institutionelle Integritätsschwellen überschreitet?
Wenn der AI-Einsatz institutionelle Schwellen überschreitet, treffen Sanktionen den menschlichen Autor und zunehmend auch Betreuungspersonen — von verpflichtenden Überarbeitungen über verzögerte Einreichungen bis zur Aufhebung der Einschreibung. Richtlinien unterscheiden sich nach Land und Hochschule, doch die Richtung im Jahr 2026 ist eindeutig: engere Ähnlichkeitsgrenzen, explizite Prüfung von AI und weniger Geduld für „das Modell hat es erfunden“.
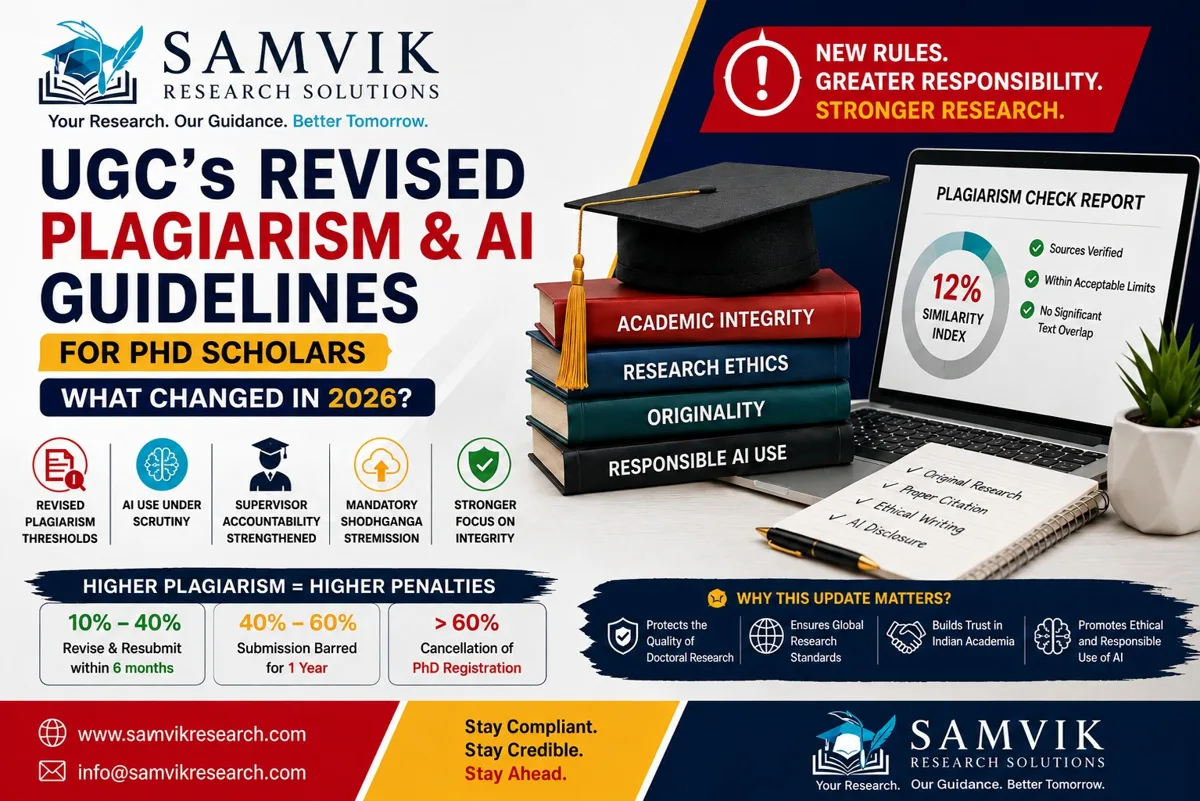
Leitlinien, die 2026 im Umfeld der Überarbeitung durch die University Grants Commission (UGC) an PhD-Forschende verteilt wurden, zeigen, wie numerische Schwellen zu Karriereereignissen werden. In diesem Rahmen führt eine Ähnlichkeit zwischen 10 % und 40 % zu Überarbeitung und erneuter Einreichung innerhalb von sechs Monaten; 40 % bis 60 % können eine Einreichung für ein Jahr verhindern; und eine Ähnlichkeit über 60 % kann die PhD-Registrierung aufheben. Dieselben Leitlinien verbinden diese Bereiche mit einer genaueren Prüfung des AI-Einsatzes, stärkerer Verantwortung der Betreuungspersonen und einer verpflichtenden Ablage in Repositorien. Selbst wenn Ihre Universität andere Grenzwerte verwendet, ist die Logik übertragbar: Überschneidungen werden als messbares Integritätssignal behandelt, und „AI hat geholfen“ ist keine Verteidigung, wenn der Text nicht von Ihnen stammt oder die Referenzen nicht real sind.
Zeitschriften fügen eine zweite Ebene hinzu. COPEs Position zur Autorschaft bedeutet, dass Sie ChatGPT, Elicit, Scite oder Jenova nicht als Mitautor aufführen können. Sie können und müssen das Tool häufig in den Methoden nennen. Eine unterlassene Offenlegung wird zunehmend als Transparenzverstoß behandelt, selbst wenn die Wissenschaft fundiert ist. Erfunde Referenzen können dagegen eine Ablehnung oder einen Widerruf rechtfertigen, weil sie die wissenschaftliche Dokumentation verfälschen.
Praktische Konsequenzen für alle, die 2026 etwas einreichen:
- Kennen Sie Ihre lokale Ähnlichkeitsschwelle bevor Sie schreiben, nicht erst nachdem das Prüfprogramm gelaufen ist.
- Bewahren Sie Prompts und Modellversionen auf, damit Sie rekonstruieren können, was das Tool beigetragen hat.
- Behandeln Sie einen niedrigen AI-Detektorscore nicht als Freigabe. Behandeln Sie eine vollständige, auflösbare Bibliografie als Freigabe.
- Wenn Sie Studierende betreuen, prüfen Sie deren Quellenprotokolle. Verantwortlichkeit wandert in der Hierarchie nach oben.
Innerhalb dieser Grenzen bleibt AI ein legitimer Beschleuniger für Recherche, Extraktion und Organisation. Als unsichtbarer Mitautor mit einer erfundenen Referenzliste eingesetzt, ist sie inzwischen einer der schnelleren Wege, einen Abschluss oder einen Artikel zu verzögern.
Referenzen
- Nature — Halluzinierte Zitate verunreinigen die wissenschaftliche Literatur
- Enago — AI-generierte Referenzen: 1 von 5 ist gefälscht
- STAT — Betrügerische Zitate, die AI-Halluzinationen zugeschrieben werden, verbreiten sich in akademischen Arbeiten
- Today’s Clinical Lab — AI-generierte gefälschte Referenzen nehmen in der biomedizinischen Literatur zu
- Accountability in Research (Taylor & Francis) — Durch generative künstliche Intelligenz erzeugte halluzinierte Zitate
- PubMed Central — Erfunde Zitate im Zeitalter von AI: ein Weckruf für Redakteure
- Cornell University Center for Teaching Innovation — AI und akademische Integrität
- COPE — Autorschaft und AI-Tools
- Elicit — AI für wissenschaftliche Forschung (Korpusgröße, Zitate auf Satzebene, Workflow für systematische Reviews)
- Scite — Mit Zitaten belegte Antworten aus mehr als 300 Millionen wissenschaftlichen Artikeln
- Paperguide — Vergleich von Elicit und Scite für Forschende (2026)
- The Drive AI — Elicit vs. Consensus vs. Semantic Scholar
- Bibliotheken der George Mason University — AI-Tools für Literaturreviews
- IBM — Datenschutzfragen im Zeitalter von AI untersuchen
- Office of the Victorian Information Commissioner — Künstliche Intelligenz und Datenschutz: Fragen und Herausforderungen
- Fortra — AI-Datenschutz: Herausforderungen und Lösungen
- European Network for Academic Integrity — Allgemeine Leitlinien für akademische Integrität
- ScienceDirect — Akademische Integrität im Zeitalter von AI neu bewerten
- Cambridge University Press — Akademische Integrität im Zeitalter von AI