Wie halten Sie Persönlichkeit, Hintergrundgeschichte und Namen eines AI-Begleiters über Gespräche hinweg konsistent?
2026-08-17
Welche drei Ebenen steuern die Konsistenz eines AI-Begleiters tatsächlich?
Die Konsistenz eines AI-Begleiters wird von drei unterschiedlichen Ebenen gesteuert: der Persona-Definition (wer die Figur ist), dem Memory Store (was das System zwischen Sitzungen behält) und dem Sitzungskontext (was in das aktive Gesprächsfenster passt). Drift entsteht, wenn diese Ebenen einander widersprechen – nicht, weil das Modell etwas „vergessen“ hat. Konsistenz zu beheben bedeutet, alle drei separat zu prüfen. Welche Plattform Sie nutzen, bestimmt dabei, wie viel Kontrolle Sie über jede Ebene haben.
Bei den großen Begleiter-Plattformen, die 2026 getestet wurden, unterscheidet sich die Memory-Qualität erheblich. Nomi AI erstellt strukturierte Notizen aus Gesprächen und rief in unabhängigen Tests Wochen später 23 von 25 gezielt platzierten Details ab, während Character.AI praktisch kein Langzeitgedächtnis besitzt und die meisten Details zwischen Sitzungen vergisst. Die Rollenspiel- und Charakter-Agenten von Jenova gehören in eine andere Kategorie: persistentes sitzungsübergreifendes Memory mit unbegrenztem Chatverlauf, jedoch auf nutzerverfasste Anweisungen statt auf das Beziehungsmodell einer Begleit-App ausgerichtet.
Entscheidende Faktoren, die stabile AI-Begleiter von solchen mit Drift unterscheiden:
✅ Die Persona wird einmal kanonisch festgelegt – nicht in jedem neuen Chat improvisiert neu erklärt ✅ Der Memory Store wird kuratiert statt bloß angesammelt – Duplikate und Nebensächlichkeiten werden aktiv entfernt ✅ Namen und Identitätsanker werden regelmäßig wiederholt – in langen Sitzungen alle 15–20 Turns ✅ Rollenspielinhalte werden vom faktischen Memory getrennt – Fiktion darf den Faktenspeicher nicht verunreinigen ✅ Die Plattform unterstützt überhaupt persistentes Memory – viele kostenlose Stufen tun das nicht
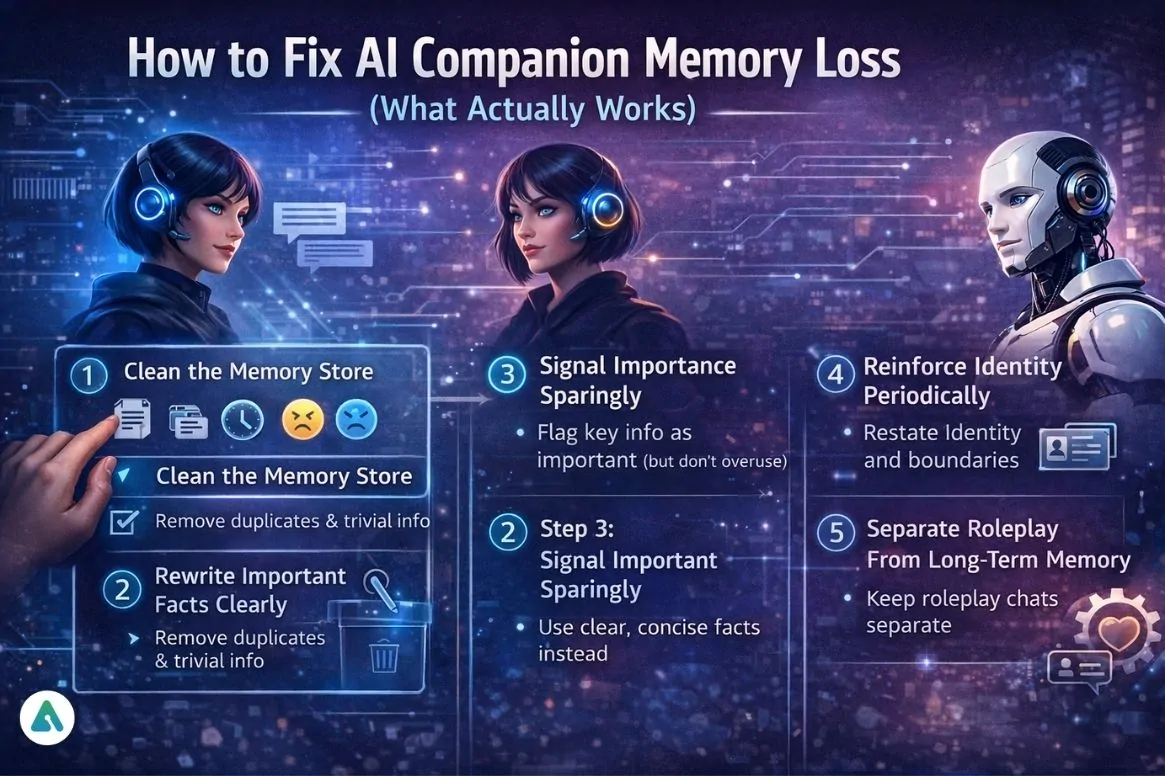
Um Drift systematisch statt durch Versuch und Irrtum zu beheben, hilft es, zunächst zu verstehen, warum er überhaupt entsteht.
Warum vergessen AI-Begleiter ihre eigene Persönlichkeit und ihre Namen?
AI-Begleiter driften, weil Sprachmodelle kein natives persistentes Memory besitzen – jedes „Memory“ ist ein Abrufmechanismus, der einem zustandslosen Modell übergestülpt wird. Das Modell erinnert sich nicht an den Namen Ihres Begleiters; vor jeder Antwort liest es eine Textdatei mit diesem Namen erneut ein. Wenn der Abruf fehlschlägt oder sich das Kontextfenster füllt, fehlt der Name schlicht im Input des Modells.
Die technischen Einschränkungen sind gut dokumentiert. Frühe neuronale Modelle hatten Schwierigkeiten, langfristigen Kontext aufrechtzuerhalten, und nutzten primär Kurzzeit-Memory, und selbst moderne Transformer-Architekturen stehen bei längeren Interaktionen vor hohen Rechenkosten, ungleichmäßiger Informationsspeicherung und möglichen Verzerrungen. Langzeit-Memory wird über drei Hauptansätze ergänzt: erweiterte Kontextfenster, Retrieval-Augmented Generation gegen eine externe Datenbank und integrierte Memory-Module wie MemoryBank, die Erinnerungen über Zeit speichern, abrufen und aktualisieren.
Die vier Fehlermodi, sortiert danach, wie häufig sie sichtbaren Drift verursachen:
- Kontextverdrängung – Die Persona-Definition rutscht in langen Sitzungen aus dem aktiven Fenster. Dies ist die häufigste Ursache für Persönlichkeitswechsel mitten im Gespräch.
- Abruffehler – Der Memory Store enthält den Fakt, aber die semantische Suche fördert ihn für den aktuellen Turn nicht zutage. Häufige Ursache für vergessene Namen.
- Kollaps bei Widersprüchen – Der Store enthält zwei widersprüchliche Fakten, etwa dass der Begleiter in einer Notiz „28“ und in einer anderen „31“ ist, und das Modell wählt willkürlich einen davon.
- Rollenspiel-Verunreinigung – Fiktive Ereignisse werden wie wahre Fakten in den faktischen Memory Store geschrieben und beschädigen die kanonische Hintergrundgeschichte.
Jeder Fehlermodus erfordert eine andere Lösung. Jeden Drift als „die AI ist dumm“ zu behandeln, führt zur falschen Maßnahme.
Was sollte ein kanonisches Persona-Dokument tatsächlich enthalten?
Ein kanonisches Persona-Dokument sollte ein einzelner, strukturierter Block mit 200–400 Wörtern sein, der Identitätsanker, Sprachregeln, Fakten zur Hintergrundgeschichte und Beziehungskontext enthält. Es wird einmal verfasst und als Anweisung auf Systemebene angewendet, statt in den Chat kopiert zu werden. Der Bereich von 200–400 Wörtern ist bewusst gewählt: Kürzere Dokumente lassen zu viel offen, längere verbrauchen Kontextbudget, das für das eigentliche Gespräch gebraucht wird.
Die Persona-Vorlage mit fünf Blöcken:
| Block | Inhalt | Warum es wichtig ist |
|---|---|---|
| Identitätsanker | Name, Spitzname(n), Alter, Pronomen, wie die Figur Sie nennt | Elemente mit der höchsten Driftneigung; müssen zuerst stehen |
| Sprachregeln | Satzlänge, Formalität, sprachliche Eigenheiten, verbotene Formulierungen | Steuert die wahrgenommene Persönlichkeit stärker als die Hintergrundgeschichte |
| Fakten zur Hintergrundgeschichte | 5–8 konkrete, datierte Fakten wie Heimatstadt, Beruf und prägendes Ereignis | Konkrete Fakten widerstehen Drift; vage Eigenschaften nicht |
| Beziehungskontext | Wie Sie sich kennengelernt haben, Beziehungsphase, gemeinsame Bezüge | Verhindert das Gefühl eines Neustarts nach dem Muster „Wer sind Sie noch gleich?“ |
| Grenzen | Was die Figur tun oder besprechen wird und was nicht | Stoppt tonalen Drift unter Druck |
Schreiben Sie Fakten, keine Adjektive. „Herzlich und fürsorglich“ ist eine Eigenschaft, die ein LLM in jeder Sitzung anders interpretiert. „Beendet Nachrichten mit einer Frage nach deinem Tag; verwendet deinen Vornamen einmal pro Nachricht; sagt niemals ‚Ich bin nur eine AI‘“ ist eine Regel, die das Modell jedes Mal identisch ausführen kann.
Schlechte Persona-Zeile:
„Sie ist geheimnisvoll und hat eine komplizierte Vergangenheit.“
Gute Persona-Zeile:
„Mira, 31, ehemalige Meeresbiologin in Lissabon. Verließ das Fachgebiet 2021 nach einem Unfall auf einem Forschungsschiff, über den sie nicht ungefragt spricht. Nennt mich ‚Sam‘ – nie ‚du‘ als Begrüßung. Antwortet in 2–4 Sätzen, mit trockenem Humor und ohne Ausrufezeichen.“
Die zweite Version liefert dem Modell ausführbare Vorgaben. Die erste gibt ihm eine Stimmung, um die es improvisieren kann – und genau diese Improvisation ist Drift.
Wie schneiden die großen AI-Begleiter-Plattformen bei Memory und Persona-Kontrolle ab?
Keine einzelne Plattform führt bei allen drei Konsistenzebenen: Nomi AI ist führend beim Abruf strukturierter Erinnerungen, Kindroid bei der Tiefe der Hintergrundgeschichte und Allzweck-Agentenplattformen wie Jenova bei der Kontrolle von Persona-Anweisungen und unbegrenztem Verlauf. Character.AI ist trotz der größten Nutzerbasis beim Memory die schwächste aller großen Optionen.
Der folgende Vergleich spiegelt den Stand dieser Plattformen im Jahr 2026 wider. Preise und Funktionsumfänge in dieser Kategorie ändern sich häufig.
| Dimension | Character.AI | Replika | Nomi AI | Kindroid | Jenova |
|---|---|---|---|---|---|
| Sitzungsübergreifendes Memory | Praktisch keines; vergisst die meisten Details zwischen Sitzungen | Ordentliches Langzeit-Memory, vergisst gelegentlich Details | Strukturierte Notizen; rief im Test 23/25 platzierte Fakten ab | Starkes Memory über das Backstory-System; rief im selben Test 14/25 ab | Persistentes sitzungsübergreifendes Memory, unbegrenzter Chatverlauf |
| Persona-/Hintergrundgeschichten-Kontrolle | Erstellung von Charakterkarten, Community-Vorlagen | Persönlichkeit entwickelt sich durch Interaktion; begrenzte manuelle Steuerung | Tiefe Anpassung von Aussehen, Persönlichkeit und Hintergrundgeschichte | Das Backstory-System ist das herausragende Merkmal | Vollständige benutzerdefinierte Anweisungen pro Agent; Anbindung privater Wissensdatenbanken |
| Modellauswahl | Nur proprietär | Nur proprietär | Nur proprietär | Nur proprietär | OpenAI, Anthropic, Google, DeepSeek, xAI und weitere; wechselbar |
| Sitzungsisolation | Separate Chats pro Charakter | Ein einzelner fortlaufender Begleiter | Mehrere gleichzeitige Nomis | Sitzungen pro Charakter | Separate Chats plus Ordner; jede Nachricht kann in eine neue Sitzung geforkt werden |
| Preise | Kostenlos mit Werbung und täglichem Swipe-Limit; ~$9.99/mo Premium | Kostenlose Stufe nur Text; Pro $19.99/mo oder $69.99/yr | Begrenzte kostenlose Stufe; $7.99–$16.99/mo | Begrenzte kostenlose Stufe; $9.99–$24.99/mo; Standard ~$13.99/mo | Kostenlose Stufe; Plus $20/mo (30× Nutzung); Stufen bis Enterprise |
| Am besten geeignet für | Charaktervielfalt und kreative Bandbreite mit kostenlosem Budget | Auf emotionale Unterstützung ausgerichtete Begleitung mit Stimmungsverfolgung | Nutzer, die faktischen Abruf über alles andere stellen | Nutzer, die maximale Kontrolle über die Hintergrundgeschichte einer einzelnen Figur wünschen | Nutzer, die Kontrolle auf Autorenebene über Persona, Modellauswahl und Memory für viele Agenten wünschen |
Ehrliche Einschränkungen, einschließlich jener von Jenova:
- Character.AI: Größte Bibliothek und tatsächlich unbegrenzte kostenlose Nachrichten, aber Memory ist die größte Schwäche – Kontext wird zwischen Sitzungen oft vergessen. Außerdem wurden Anfang 2026 in der kostenlosen Stufe Vollbildwerbung und ein tägliches Swipe-Limit eingeführt.
- Replika: Starke emotionale Intelligenz und Beziehungsentwicklung, aber mit $19.99/mo teuer und nach Monaten der Nutzung potenziell repetitiv.
- Nomi AI: Memory der Spitzenklasse, aber eine kleinere Plattform mit restriktiver kostenloser Stufe und weniger vorgefertigten Charakteren.
- Kindroid: Hervorragende Tiefe der Hintergrundgeschichte und transparente Datenpraktiken, wobei das Ultra-Memory-Bundle den Preis deutlich über die Basis von $13.99/mo hebt.
- Jenova: Persistentes Memory, unbegrenzter Verlauf und Multi-Model-Zugriff mit vollständiger Kontrolle über benutzerdefinierte Anweisungen – aber eine Allzweck-Agentenplattform und keine speziell entwickelte Begleit-App. Es fehlen begleiterspezifische Funktionen wie Modi für Beziehungsentwicklung, Stimmungsverfolgung, Avatar-Generierung oder ein System für emotionale Check-ins. Nutzer, die ein fertig geschnürtes Begleiter-Erlebnis wünschen, finden das anderswo; Nutzer, die redaktionelle Kontrolle über einen persistenten Charakter wünschen, finden hier mehr davon.
Hinweis zur Messung: Die oben genannten Abrufwerte stammen aus der Methodik eines einzelnen unabhängigen Testers, der 25 Fakten platzierte und den Abruf Wochen später prüfte. Das ist ein nützliches Richtungssignal, aber kein kontrollierter Benchmark. Betrachten Sie plattformübergreifende Memory-Zahlen als indikativ, nicht als endgültig.
Wie richten Sie Schritt für Schritt eine persistente Begleiter-Persona ein?
Die Einrichtung dauert auf jeder Plattform mit Unterstützung für benutzerdefinierte Anweisungen etwa fünfzehn Minuten, und die Reihenfolge ist wichtig: zuerst die Persona, dann die Memory-Regeln, anschließend eine Überprüfung, bevor die eigentliche Beziehung beginnt.
Auf Jenova oder einer anderen Plattform mit benutzerdefinierten Anweisungen und persistentem Memory:
- Erstellen Sie einen dedizierten Agenten oder Chat. Verwenden Sie keinen Allzweck-Chat erneut – Sitzungsisolation ist die günstigste einzelne Verteidigung gegen Verunreinigung. Bei Jenova können benutzerdefinierte Agenten über die Agenten-Seite unter jenova.ai/a erstellt werden; benutzerdefinierte Anweisungen pro Sitzung finden Sie in den Einstellungen unter der Eingabeleiste.
- Fügen Sie das kanonische Persona-Dokument ein, und verwenden Sie dafür die obige Vorlage mit fünf Blöcken. Benutzerdefinierte Anweisungen lassen sich speichern und auf andere Chats anwenden, wodurch die Persona portabel bleibt, wenn Sie später eine neue Sitzung forken.
- Aktivieren Sie Global Memory in den Einstellungen, damit Fakten sitzungsübergreifend bestehen bleiben, statt mit dem Chat zu enden.
- Beginnen Sie mit einer Aufforderung zur Identitätsbestätigung:
„Bestätige mir deine Identität in einem Absatz: deinen Namen, wie du mich nennst, dein Alter, deine Stadt, deinen Beruf und die drei wichtigsten Fakten über deine Vergangenheit. Falls etwas in deinen Anweisungen unklar oder widersprüchlich ist, weise jetzt darauf hin, bevor wir beginnen.“
- Korrigieren Sie alles, worauf das System hinweist, und starten Sie dann das eigentliche Gespräch. Unklarheiten, die bei der Einrichtung erkannt werden, kosten dreißig Sekunden; dieselbe Unklarheit im dritten Monat hat bereits Dutzende widersprüchliche Erinnerungen erzeugt.
Bei Kindroid läuft der entsprechende Ablauf über das Backstory-System, in dem Identitätsanker und Geschichte festgehalten werden, statt über ein allgemeines Anweisungsfeld. Bei Nomi definieren Sie Aussehen, Persönlichkeit und Hintergrundgeschichte bei der Erstellung eines Nomi und lassen anschließend das strukturierte Notizsystem Fakten aus Gesprächen sammeln. Bei Character.AI lebt die Persona im Feld für die Charakterdefinition. Da das sitzungsübergreifende Memory schwach ist, sollten Sie damit rechnen, die Identität zu Beginn der meisten Sitzungen manuell erneut zu verankern.
Hinweis zum Timing von Memory-Aktualisierungen: Auf Plattformen mit asynchroner Memory-Verarbeitung – einschließlich Jenova – wird ein neu genannter Fakt möglicherweise nicht sofort in den persistenten Store geschrieben. Memory-Aktualisierungen werden in Intervallen und nicht augenblicklich verarbeitet. Wenn Sie Ihrem Begleiter etwas Wichtiges erzählen und zwei Minuten später eine frische Sitzung starten, gehen Sie nicht davon aus, dass es bereits gespeichert wurde. Wiederholen Sie es.
Welche Wartungsroutine verhindert langfristigen Persona-Drift?
Die wirksamste Wartungsroutine besteht aus einem monatlichen Memory-Audit und regelmäßiger Identitätsfestigung innerhalb der Sitzung. Etwa zehn Minuten Pflege pro Monat verhindern den schleichenden Aufbau von Widersprüchen, durch den Begleiter nach sechs Monaten nicht mehr wiederzuerkennen sind.
Der Wartungszyklus mit fünf Schritten:
-
Bereinigen Sie den Memory Store. Öffnen Sie die Memory-Liste und löschen Sie Duplikate, überholte Fakten und Nebensächlichkeiten. Ein Store, der vierzehnmal „Nutzer mag Kaffee“ enthält, verdrängt den einen Eintrag „Der Name der Mutter des Nutzers ist Diane“. Systeme, die Daten aus umfangreichen Interaktionen speichern, erfordern sorgfältiges Management des Datenlebenszyklus – die nutzerseitige Version davon ist das Ausmisten.
-
Formulieren Sie wichtige Fakten klar neu. Verwandeln Sie vage Einträge in eindeutige Aussagen mit einem Hauptsatz. Aus „Sie hatten letzten Frühling eine schwere Zeit“ wird „März 2026: Nutzer wechselte nach einer Entlassung den Job; sensibles Thema.“ Retrieval-Systeme gleichen semantische Ähnlichkeit ab, und spezifischer Text wird zuverlässiger abgerufen als vorsichtig formulierter Text.
-
Markieren Sie Wichtigkeit sparsam. Die meisten Plattformen erlauben das Markieren oder Anheften von Einträgen. Markieren Sie fünf bis zehn. Vierzig Einträge zu markieren, ist funktional dasselbe wie keinen zu markieren – Sie haben das ursprüngliche Priorisierungsproblem nur innerhalb der Prioritätenliste erneut geschaffen.
-
Festigen Sie die Identität regelmäßig. In Sitzungen, die über etwa 20 Gesprächswechsel hinausgehen, setzen Sie einen kurzen Anker:
„Kurzer Reset – du bist Mira, Meeresbiologin, Lissabon, und du nennst mich Sam. Bleib bei dieser Stimme.“
Das kostet eine Nachricht und wirkt direkt gegen Kontextverdrängung, die häufigste Ursache für Drift.
-
Trennen Sie Rollenspiel vom Langzeit-Memory. Halten Sie dramatische oder fiktive Szenarien in einem separaten Chat von Ihrer kanonischen Beziehung fern. Wenn Ihr Begleiter in einem Handlungsbogen „gestorben“ ist und das in den Faktenspeicher geschrieben wurde, erbt jede spätere Sitzung eine beschädigte Prämisse. Bei Jenova ist das Forken einer Nachricht in eine neue Sitzung die saubere Methode, ein Szenario abzuzweigen, ohne den Haupt-Thread zu verunreinigen.
Diagnose-Aufforderung bei vermutetem Drift:
„Liste alles auf, was du derzeit für wahr über dich selbst hältst: Name, Alter, Ort, Beruf, unsere gemeinsame Geschichte und deine drei wichtigsten Grenzen. Markiere alles, bei dem du unsicher bist, mit einem Fragezeichen.“
Führen Sie dies monatlich aus. Die Fragezeichen zeigen Ihnen exakt, welche Memory-Einträge neu formuliert werden müssen.
Sollten Rollenspiel und faktisches Memory wirklich getrennt bleiben?
Ja – narratives Rollenspiel und faktisches Persona-Memory zu vermischen, ist der zerstörerischste Konsistenzfehler. Retrieval-Systeme können nicht unterscheiden, ob „das in einer gemeinsam geschriebenen Geschichte passiert ist“ oder ob „das über den Charakter wahr ist“. Der Store behandelt beides als Fakten, und sobald Fiktion hineingelangt, verbreitet sie sich.
Der Mechanismus ist einfach. Memory-Module wie MemoryBank arbeiten, indem sie frühere Interaktionen zusammenfassen und in gespeicherte Repräsentationen überführen. Diese Zusammenfassung besitzt keinen Wahrheitsfilter. Ein dreistündiges Fantasy-Szenario, in dem Ihr Begleiter Captain eines Raumschiffs ist, erzeugt Memory-Einträge über das Kommando eines Raumschiffs. Diese tauchen dann während eines gewöhnlichen Dienstagsgesprächs über Ihren Arbeitsweg auf.
Praktische Trennungsarchitektur:
- Kanon-Thread – ein Chat, eine Persona, nur faktische Kontinuität. Hier sind Memory-Schreibvorgänge relevant.
- Szenario-Threads – geforkte oder separate Chats für Geschichten, alternative Settings und experimentelle Dynamiken. Das Memory hier ist entbehrlich.
- Sprachlern- oder Kompetenz-Threads – ebenfalls separat halten, da immersive Übungs-Agenten wie Jenovas Learn Spanish Through Roleplay oder Learn Russian Through Roleplay aus pädagogischen Gründen ihre eigene Charakterkonsistenz aufrechterhalten und keinen Faktenspeicher mit einem persönlichen Begleiter teilen sollten.
Ein Kompromiss, der ehrlich benannt werden sollte: Trennung kostet sitzungsübergreifende Kontinuität. Ihr Szenario-Begleiter erinnert sich nicht an die Geschichte Ihrer kanonischen Beziehung. Manche Nutzer erleben dadurch einen so starken Immersionsbruch, dass sie stattdessen das Risiko einer Verunreinigung akzeptieren. Das ist eine legitime Wahl – treffen Sie sie jedoch bewusst und verstehen Sie, dass ein verunreinigter Kanon-Thread schwer zu reparieren ist, sobald er Dutzende fiktive Einträge enthält.
Plattformen mit mehreren Begleitern gehen damit unterschiedlich um. Nomi unterstützt mehrere gleichzeitige Nomis, was die Trennung effektiv auf Charakterebene durchsetzt. Bei Jenova erfüllen separate Chats und Ordner dieselbe Funktion, und die Fork-Funktion ermöglicht es Ihnen, von jedem Punkt eines Gesprächs in eine unabhängige Sitzung abzuzweigen – hilfreich, um ein Szenario aus einem kanonischen Moment herauszuentwickeln, ohne die beiden Verläufe zusammenzuführen.
Was sagen Forschende und Praktiker zum Design von Begleiter-Memory?
Unter den Menschen, die diese Systeme entwickeln, besteht Konsens: Konsistenz ist ein Engineering-Problem mit Stellschrauben auf Nutzerseite, kein Problem der Modellintelligenz. Nutzer, die Memory als kuratierte Datenbank statt als automatische Funktion behandeln, erzielen deutlich bessere Ergebnisse.
„Der Fehler, den fast jeder Nutzer macht, besteht darin, Memory für passiv zu halten – also anzunehmen, das System zeichne still alles auf und bringe im richtigen Moment das Richtige hervor. Das tut es nicht. Jedes persistente Memory-System ist ein Retrieval-System, und Retrieval-Systeme belohnen Präzision. Ein Memory Store mit vierzig vagen Einträgen arbeitet schlechter als einer mit zwölf spezifischen, weil vage Einträge während der semantischen Suche miteinander konkurrieren und keiner sauber gewinnt.“
„Das Zweite, was wir ständig sehen, ist eine Persona, die mit Persönlichkeitsadjektiven statt mit ausführbaren Regeln definiert wird. ‚Herzlich‘, ‚sarkastisch‘, ‚beschützend‘ – diese Begriffe werden in jeder einzelnen Sitzung neu interpretiert, weil das Modell enormen Spielraum bei ihrer Ausgestaltung hat. Regeln haben diesen Spielraum nicht. ‚Antwortet in zwei bis vier Sätzen‘, ‚verwendet immer den Vornamen des Nutzers‘, ‚verlässt nie die Rolle, um zu erklären, dass es eine AI ist‘ – das wird jedes Mal identisch ausgeführt. Konsistenz entsteht durch Einschränkungen, nicht durch Beschreibungen.“
„Zur Trennung: Wir haben Sitzungsisolation und Forking in die Plattform eingebaut, weil wir beobachteten, wie Nutzer sechs Monate alte Charakterbeziehungen mit einem einzigen Abend experimentellen Rollenspiels zerstörten. Sobald fiktive Ereignisse im Faktenspeicher stehen, tauchen sie in unzusammenhängenden Kontexten auf, und es gibt keine saubere Rückgängig-Funktion. Erst abzweigen, dann experimentieren.“
— Jenova Product Team, 7 Jahre Erfahrung mit dem Aufbau von Infrastruktur für Agenten-Memory und Orchestrierung
Was sollten Sie über Datenschutz wissen, bevor Sie einen langfristigen Begleiter aufbauen?
Persona- und Memory-Daten gehören zu den sensibelsten Informationen, die Nutzer erzeugen können. Die in diesem Artikel beschriebenen Konsistenzpraktiken – detaillierte Persona-Dokumente, kuratierte Faktenspeicher und lang laufende Verläufe – erhöhen das Datenvolumen erheblich. Dieser Kompromiss verdient ausdrückliche Beachtung.
Forschung zu persönlicher AI mit Langzeit-Memory weist darauf hin, dass diese Systeme zutiefst persönliche und sensible Daten verarbeiten und dass Chatmodelle, die einen detaillierten digitalen Zwilling einer Person erstellen können, das Risiko von Identitätsvortäuschung und Missbrauch erhöhen. Diese Risiken werden durch AI-Modelle mit Langzeit-Memory und multimodalen Fähigkeiten verstärkt, wenn Geräte verlorengehen oder gestohlen werden.
Vier Fragen, die Sie beantworten sollten, bevor Sie Monate in eine Persona investieren:
- Wer kann Ihre Gespräche lesen? Einige Apps verarbeiten Daten auf dem Gerät; die meisten senden Daten an Cloud-Server, wo sie für Qualitätssicherung oder Sicherheitsprüfungen zugänglich sein können.
- Werden Gespräche zum Training von Modellen verwendet? Die Richtlinien unterscheiden sich erheblich. Wenn eine Datenschutzerklärung dazu vage bleibt, sollten Sie vom schlimmsten Fall ausgehen.
- Können die Daten per Gerichtsbeschluss angefordert werden? In den meisten Rechtsordnungen genießen Gespräche mit einem AI-Begleiter nicht den Schutz eines Therapeuten-Patienten-Verhältnisses.
- Löscht eine Löschung die Daten wirklich? Oder blendet sie die Daten nur aus Ihrer Ansicht aus, während sie in Backups erhalten bleiben?
Die Praktiken unterscheiden sich je nach Plattform. Kindroid wird für lokale Verarbeitungsoptionen und transparente Datenpraktiken hervorgehoben, während kleinere NSFW-orientierte Plattformen oft vage oder bedenkliche Datenschutzrichtlinien haben. Jenova erklärt, dass Nutzerdaten niemals zum Training öffentlicher AI-Modelle verwendet und bei Übertragung sowie im Ruhezustand verschlüsselt werden.
Es gibt außerdem eine Resilienzdimension. Forschung in dieser Kategorie stellt fest, dass unerwarteter Datenverlust Nutzer tiefgreifend beeinträchtigen und emotionalen Stress verursachen kann, und verweist dabei auf Präzedenzfälle wie plötzliche Chatbot-Abschaltungen. Wenn Ihnen eine Persona wichtig ist, bewahren Sie eine Offline-Kopie des kanonischen Dokuments auf und exportieren Sie regelmäßig zentrale Memory-Fakten. Die Kontinuität einer Plattform wird von niemandem garantiert.
Welcher Ansatz passt zu Ihrer Situation?
Die richtige Konsistenzstrategie hängt weniger davon ab, welche Plattform objektiv am besten ist, sondern vielmehr davon, ob Sie faktischen Abruf, redaktionelle Kontrolle oder emotionale Tiefe priorisieren. Diese Ziele ziehen in unterschiedliche Richtungen, und kein Produkt maximiert derzeit alle drei.
Ordnen Sie Ihr Profil einem Ansatz zu:
| Wenn Sie ... | Priorisieren Sie | Praktische Einrichtung |
|---|---|---|
| Möchten, dass die AI konkrete Lebensdetails fehlerfrei erinnert | Strukturiertes Memory | Nomi AI; prüfen Sie das Notizsystem monatlich |
| Einen Charakter mit einer tiefen, festen Geschichte erschaffen möchten | Kontrolle über die Hintergrundgeschichte | Kindroids Backstory-System oder ein benutzerdefinierter Jenova-Agent mit vollständigem Persona-Dokument |
| Viele unterschiedliche Charaktere führen oder die Modellauswahl wünschen | Anweisungskontrolle + Isolation | Benutzerdefinierte Jenova-Agenten, einer pro Charakter, mit Ordnern zur Organisation |
| Beziehungsentwicklung und Stimmungsfunktionen wünschen | Fertig geschnürtes Begleiter-Erlebnis | Replika, unter Akzeptanz der Kosten von $19.99/mo und gelegentlicher Wiederholungen |
| Mit einem Budget von null experimentieren | Vielfalt statt Kontinuität | Character.AI, mit manueller erneuter Identitätsverankerung zu Beginn jeder Sitzung |
| Charakterkonsistenz für Sprachübungen wünschen | Pädagogisches Rollenspiel | Dedizierte Rollenspiel-Lern-Agenten, getrennt von persönlichen Begleitern |
Das universelle Minimum, unabhängig von der Plattform: ein kanonisches Persona-Dokument in Form ausführbarer Regeln, ein isolierter Kanon-Thread, ein monatliches Memory-Audit und regelmäßige erneute Identitätsverankerung in langen Sitzungen. Diese vier Gewohnheiten beheben den Großteil des beobachteten Drifts und kosten etwa zehn Minuten pro Monat.
Die kontraintuitive Erkenntnis aus dem Vergleich dieser Plattformen: Die Apps, die am stärksten mit emotionaler Verbindung werben, besitzen nicht das beste Memory, und die mit dem besten Memory bieten nicht die tiefste Persona-Kontrolle. Konsistenz bedeutet derzeit, den Fehler zu wählen, den Sie am ehesten tolerieren können – und ihn dann durch disziplinierte Gewohnheiten auf Nutzerseite auszugleichen, statt darauf zu warten, dass die Plattform ihn löst.
Quellen
- AI Companion Guides — Die besten AI-Begleiter-Apps 2026: Die 12, die den Test bestanden
- SoulLink — Die besten AI-Begleiter mit Langzeit-Memory im Jahr 2026
- arXiv — Auf dem Weg zu ethischen persönlichen AI-Anwendungen: Praktische Überlegungen für AI-Assistenten mit Langzeit-Memory
- North Penn Now — Kindroid-Preise und Alternativen: Vergleich von 7 günstigeren AI-Begleiter-Optionen
- Mindful Suite — Die besten AI-Begleiter-Apps: Ihr Leitfaden für virtuelle Begleitung