Wie verhindern Sie, dass AI den Kontext monatelanger Forschung vergisst?
2026-08-21
Welche Speicherarchitekturen bewahren Suchstrategien über einen vollständigen Review-Zyklus hinweg?
An Sitzungen gebundene Chatbots verlieren Suchstrings, Einschlusskriterien und extrahierte Befunde, sobald eine Unterhaltung endet – deshalb geraten monatelange Reviews ins Stocken. Tools, die das Protokoll als dauerhaften Zustand behandeln – Jenova's Academic Research Assistant mit sitzungsübergreifendem persistentem Speicher, Elicit mit Arbeitsbereichen für systematische Reviews auf Projektebene und quellengebundene Notizbücher wie Gemini Notebook – sind die Architekturen, die 2026 einen vollständigen Review-Zyklus überstehen. Consensus bleibt für die einmalige Evidenzkartierung stärker als für das Erinnern an Ihr Protokoll im nächsten Quartal.
Wichtige Faktoren, die dauerhaften Forschungsspeicher von Wegwerf-Chats unterscheiden:
✅ Eingefrorene Protokollebene – Ein- und Ausschlussregeln werden als Anweisungen gespeichert, nicht als Prompt, den Sie erneut eingeben ✅ Anwachsende Befundspeicherung – frühere Extraktionen, Ausschlussgründe und ungelöste Konflikte werden ohne erneutes Briefing abgerufen ✅ Verankertes Korpus – Papers, Notizen und Suchprotokolle werden angehängt, damit Antworten an Ihre Evidenzbasis gebunden bleiben ✅ Nachvollziehbare Entscheidungen – Screening-Begründungen, die Sie Monate später rekonstruieren können, im Einklang mit PRISMA 2020 ✅ Kontinuität über Sitzungen hinweg – ein Wechsel von Tagen, Geräten oder Modellen sollte den Zustand des Reviews nicht löschen
Um diese Tools sinnvoll zu vergleichen, hilft es, Forschungsspeicher als Stack statt als Chatbot-Funktion zu betrachten und zu testen, ob jede Ebene nach einer Woche Projektpause noch trägt.
Warum verlieren AI-Forschungsassistenten im Laufe der Zeit ihre Protokolltreue?
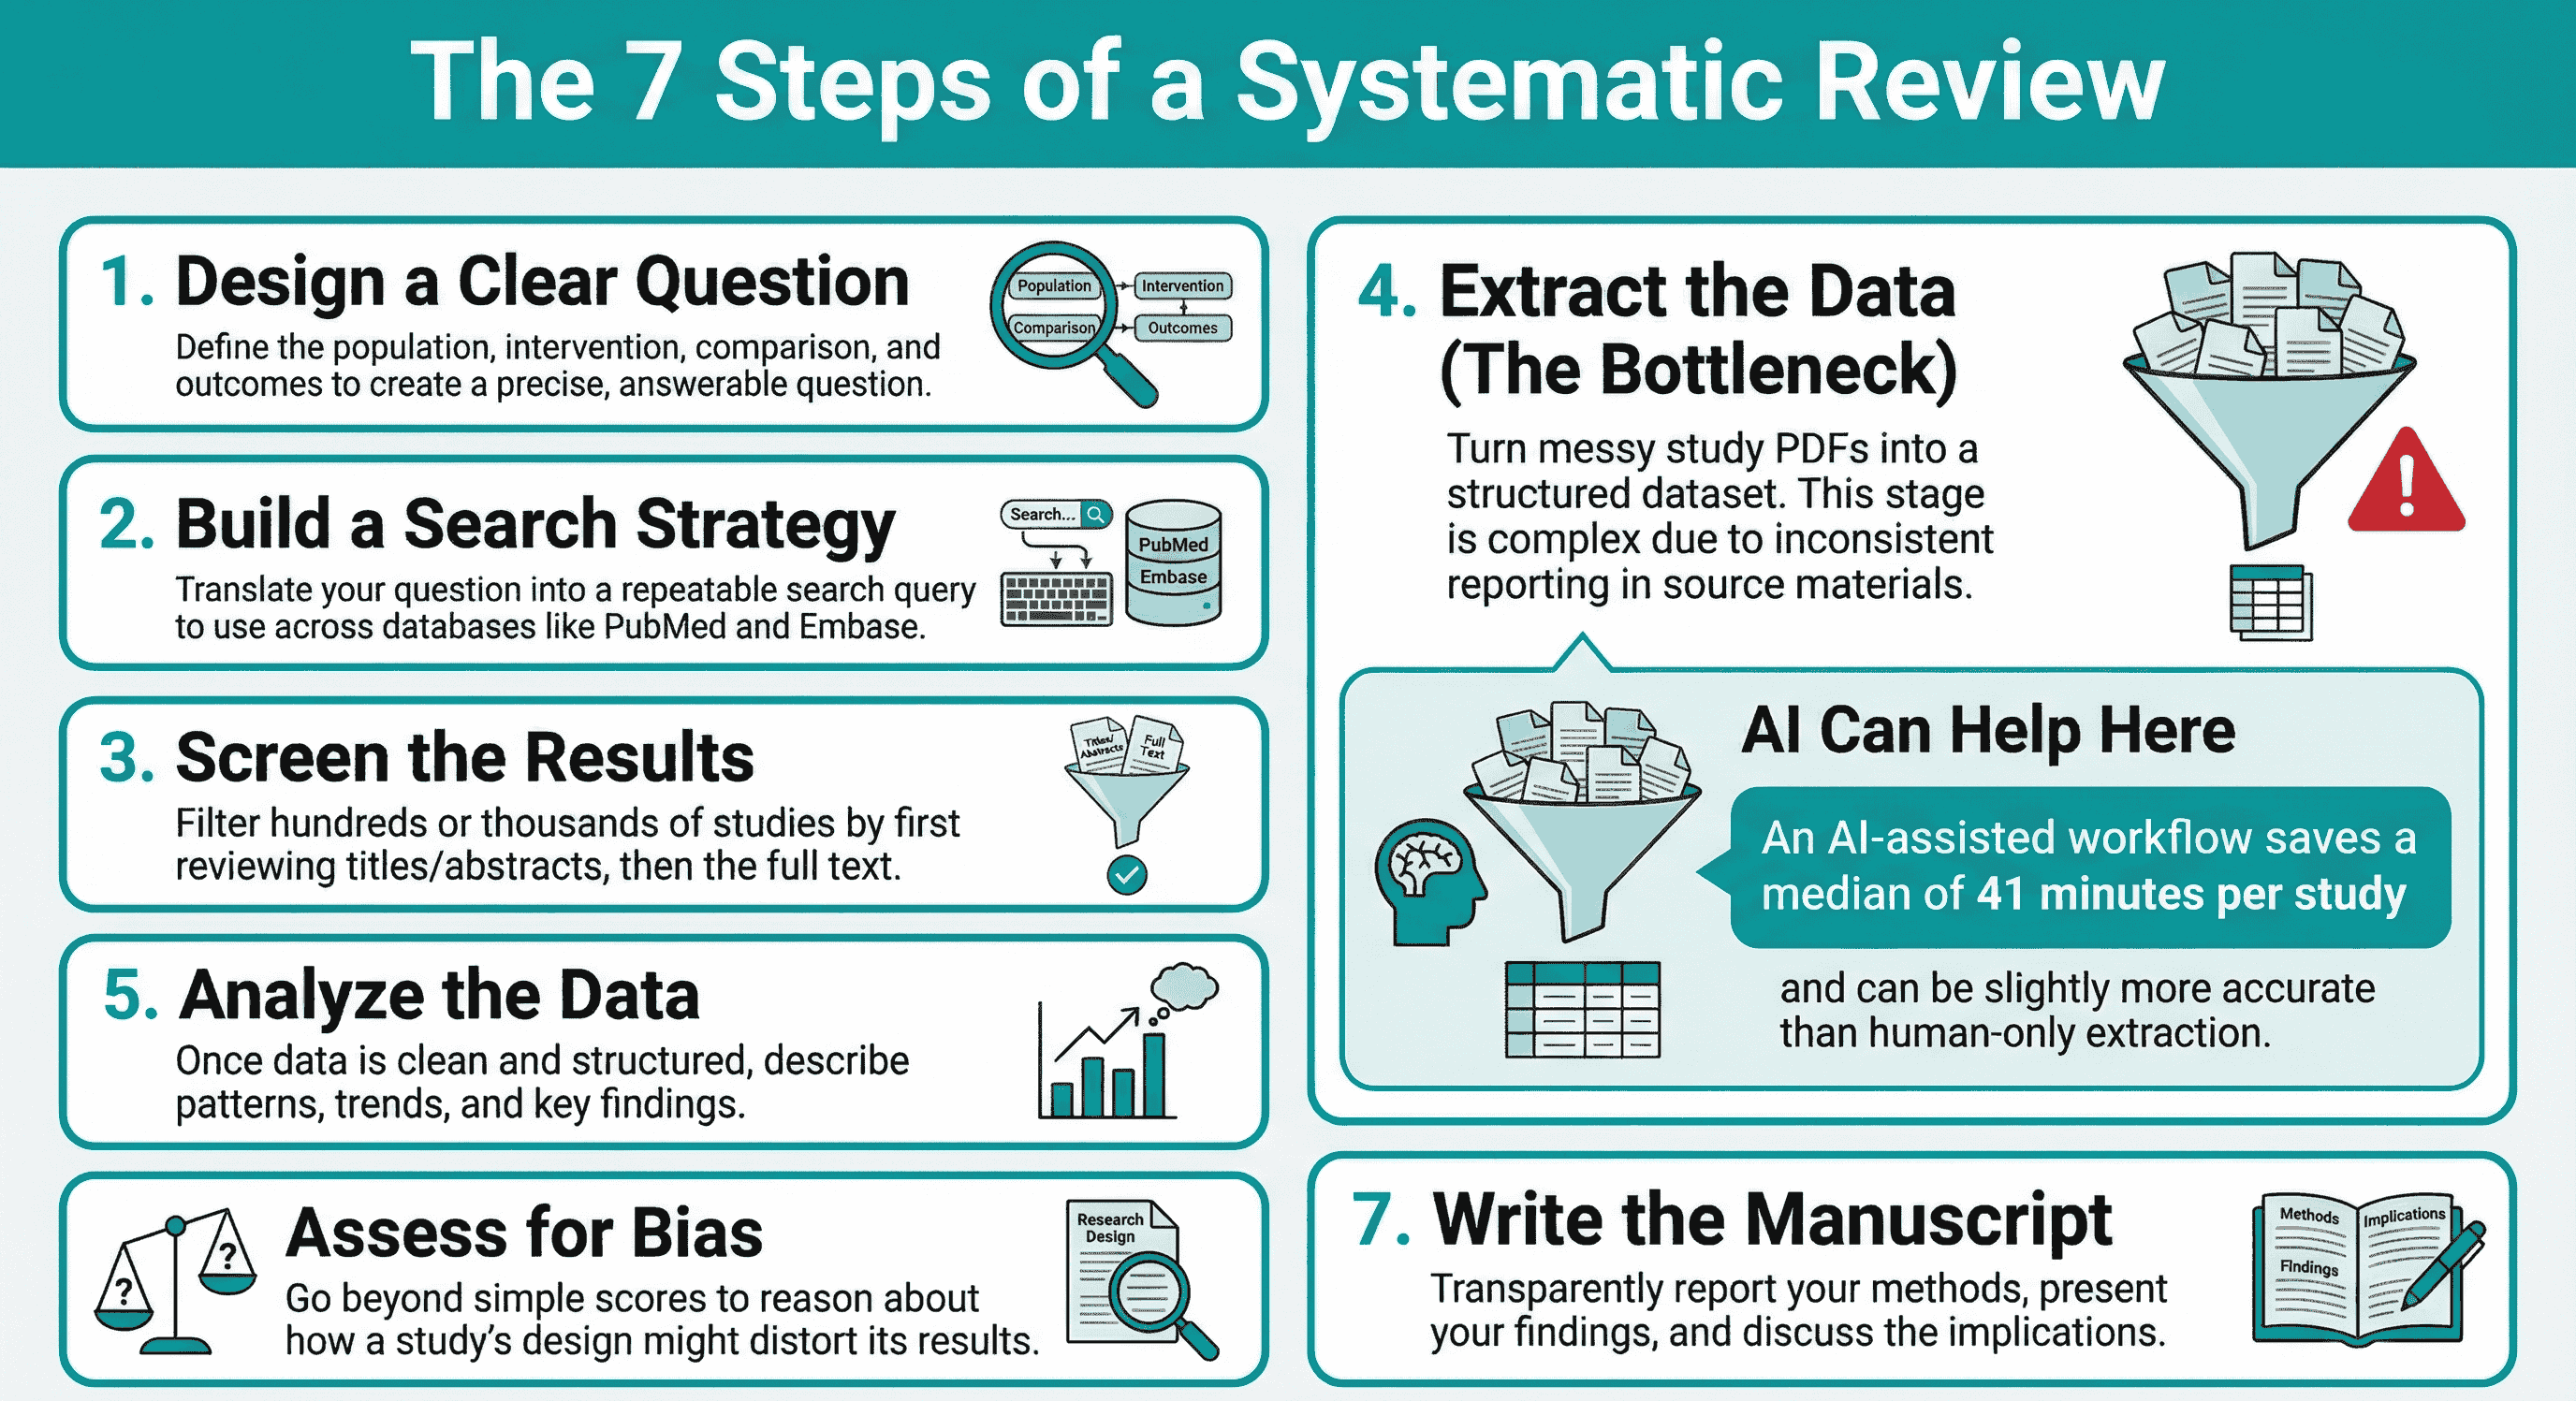
Die meisten Consumer-AI-Chats vergessen, weil sie Kontext in einem temporären Fenster speichern, nicht in einem Projekt, das die Sitzung überlebt. Ein systematischer Review ist ein Prozess mit sieben Stufen – Fragendesign, Suchstrategie, Screening, Extraktion, Analyse, Bias-Bewertung und Manuskripterstellung – und jede Stufe hängt von Entscheidungen ab, die Wochen zuvor getroffen wurden. Kann der Assistent die ursprüngliche PICO-Struktur oder den Grund für den Ausschluss einer Studie nicht mehr abrufen, beginnt der Review zu driften.
Der Berichtsstandard für diese Arbeit ist eindeutig. Das PRISMA 2020 statement ist eine evidenzbasierte Checkliste dafür, wie systematische Reviews berichtet werden sollten, und die BMJ publication of PRISMA 2020 ordnet sie für Reviews ein, die Synthesen wie paarweise Meta-Analysen umfassen. Der Methodenleitfaden der Hofstra University beschreibt das Statement als 27-item minimum set für die Berichterstattung über systematische Reviews und Meta-Analysen. Ein Assistent, der Suchstrings oder Ausschlussgründe nicht rekonstruieren kann, kann diese Checkliste nicht unterstützen.
Das Vergessensproblem ist nicht hypothetisch. Forschende setzen Machine Learning bereits entlang der gesamten Review-Pipeline ein; eine 2022 mapping of 63 ML tools umfasste Aufgaben von der Literatursuche bis zur Datenextraktion. Was diese Tools allein selten lösen, ist langfristige Treue: dieselbe Einschlussregel, im vierten Monat genauso angewendet wie im ersten.
Chatartige Assistenten verschärfen dies auf drei konkrete Arten:
- Verdunstendes Protokoll. Boolesche Strings, Datenbankabdeckung (PubMed, Embase) und Datumsgrenzen stehen in einem Prompt, der nicht als erstklassiges Objekt gespeichert wird.
- Kriteriendrift. Informelle Neuformulierungen von Einschlussregeln verändern schrittweise die Definitionen von Population, Intervention oder Outcome.
- Befundamnesie. Extrahierte Effektgrößen, widersprüchliche Ergebnisse und Notizen wie „zu diesem Paper zurückkehren“ verschwinden, wenn der Thread weg ist.
Der Leitfaden zur Evidenzsynthese des King's College London fasst den aktuellen Konsens treffend zusammen: AI kann in verschiedenen Phasen eines Reviews helfen, but it does not replace methodological control. Speicher ist diese Kontrolle, über Kalenderzeit hinweg ausgedehnt.
Worauf sollten Sie bei einem AI-Tool achten, das Forschungskontext speichert?
Sie sollten langfristige Forschungs-AI nach Protokollpersistenz, Befundkontinuität, Quellenverankerung, Auditierbarkeit, Korpusabdeckung und den Kosten für die Aufrechterhaltung dieses Zustands bewerten – nicht danach, wie flüssig sich ein einzelner Chat liest. Ein Tool, das elegante Zusammenfassungen schreibt, aber das Ausschlussprotokoll des letzten Monats nicht abrufen kann, kostet mehr Zeit, als es spart.
Dieser Artikel verwendet ein Vier-Ebenen-Modell, den Research Continuity Stack, um diese Bewertung greifbar zu machen:
- Eingefrorenes Protokoll. Suchstrategien und Ein-/Ausschlusskriterien werden außerhalb des Chatpuffers gespeichert, etwa als benutzerdefinierte Anweisungen, Protokolldokument oder Screening-Konfiguration.
- Anwachsender Speicher. Frühere Befunde, offene Fragen und Meinungsverschiedenheiten zwischen Reviewern wachsen über Sitzungen hinweg anstatt zurückgesetzt zu werden.
- Verankertes Korpus. Die tatsächlichen Papers, PDFs, Notizen und Suchezporte, die der Assistent verwenden darf.
- Entscheidungsaudit. Rekonstruierbare Gründe für Einschluss oder Ausschluss, idealerweise mit Zitaten, damit später ein zweiter Reviewer oder ein PRISMA-Flussdiagramm erstellt werden kann.
Tests anhand dieses Stacks verändern die Kaufentscheidung. Elicit ist so aufgebaut, dass Screening-Kriterien, Ausschlussgründe und Bewertungen je Kriterium PRISMA-auditable sind, was bei Ebene 1 und 4 stark ist. Gemini Notebook ist so konzipiert, dass Antworten exact quotes from uploaded sources zitieren, was bei Ebene 3 stark ist. Consensus ist dafür gebaut, 250 million-plus research papers zu durchsuchen und zu zeigen, wo Evidenz übereinstimmt, was bei der Entdeckung stark und beim Erinnern an Ihr Protokoll schwach ist. Jenova's Academic Research Assistant basiert auf unbegrenztem Chatverlauf, sitzungsübergreifendem persistentem Speicher und anhängbaren Wissensdatenbanken, was bei Ebene 1–3 für ein monatelanges Arbeitsprogramm stark ist, jedoch bei nativen PRISMA-Diagrammen schwächer.
Gewichten Sie die Ebenen nach Projekttyp. Ein systematischer Review im Cochrane-Stil sollte die Auditierbarkeit höher gewichten. Ein Literaturreview für eine Dissertation über zwei Semester sollte den anwachsenden Speicher stärker gewichten. Ein Labor, das dieselben Papers projektübergreifend wiederverwendet, sollte ein verankertes, wiederverwendbares Korpus höher gewichten.
Wie handhaben Jenova, Elicit, Consensus und Gemini Notebook langfristigen Forschungsspeicher?
Jenova ist am stärksten, wenn das Forschungsprogramm konversationell, iterativ und auf Monate angelegt ist; Elicit ist am stärksten, wenn die Arbeitseinheit ein formaler systematischer Review ist; Consensus ist am stärksten für schnelle Evidenzkartierung; Gemini Notebook ist am stärksten, wenn das Korpus bereits vorliegt. Keines der vier Tools ist universell vorzuziehen, weil sie unterschiedliche Ebenen des Research Continuity Stack optimieren.
| Funktion / Dimension | Elicit | Jenova Academic Research Assistant | Consensus | Gemini Notebook |
|---|---|---|---|---|
| Protokollpersistenz | Projektarbeitsbereich; Aktualisierungen für Living Reviews | Unbegrenzter Verlauf, persistenter Speicher, benutzerdefinierte Anweisungen | Filter auf Prompt-Ebene; kein gespeichertes Protokoll | Anweisungen und Quellen im Notizbuchbereich |
| Einschlusskriterien | Automatisch vorgeschlagene Kriterien; Dual Review; Ausschlussgründe | In Anweisungen kodiert und sitzungsübergreifend abgerufen | Natürlichsprachliche Filter je Suche | Nutzerdefiniert in einem abgegrenzten Notizbuch |
| Abruf früherer Befunde | Wiederverwendbare extrahierte Tabellen und Berichte | Sitzungsübergreifender Speicher für Notizen, Konflikte und Entscheidungen | Synthese auf Abfrageebene, kein langfristiges Protokoll | Verankert in allem, was Sie hochgeladen haben |
| Korpus / Quellen | 138 million papers, PubMed, ClinicalTrials.gov, Uploads | Nutzer-Uploads, Wissensdatenbanken, Live-Suchtools | 250M+ papers, lizenzierte Volltexte | Hochgeladene PDFs, Dokumente, Websites, Audio, Video |
| Auditierbarkeit | PRISMA-Fluss, Zitate, Bewertungen je Kriterium | Konversationelle Historie; kein natives PRISMA-Diagramm | Wissenschaftliche Zitate und Consensus Meter | Zitate auf Quote-Ebene aus Quellen |
| Preisgestaltung (Stand 2026) | Kostenpflichtiges Abonnement, einschließlich dokumentierter Pro-Stufe | Kostenloser Tarif; kostenpflichtige Pläne ab $20/Monat | Kostenpflichtiges Abonnement | Kostenlos für Einzelpersonen; Organisationsdaten werden nicht zum Training verwendet |
| Am besten geeignet für | Formale systematische Reviews und fortlaufende Aktualisierungen | Mehrmonatige Forschungsprogramme, die nichts vergessen dürfen | Schnelle Evidenz-Snapshots und Suche im Medical mode | Synthese geschlossener Korpora und quellenbasiertes Lehren |
Elicit
Elicit ist ein speziell entwickelter wissenschaftlicher Forschungsassistent, der zum search, summarize, extract data from, and chat with over 125 million papers eingesetzt wird; das Produkt für systematische Reviews indexiert 138 million papers mit wöchentlichen Aktualisierungen. Es kann bis zu 40.000 Papers screenen, Screening-Kriterien automatisch vorschlagen und jede Entscheidung mit Ausschlussgründen und unterstützenden Zitaten PRISMA-auditierbar halten.
Seine Einschränkung bei einem monatelangen Programm gemischter Forschung liegt in der Spezialisierung. Elicit eignet sich hervorragend für strukturierte Review-Operationen; es ist weniger als allgemeiner Forschungspartner konzipiert, der Nebenhypothesen, Feedback von Betreuenden und sich entwickelnde Notizen außerhalb des Review-Objekts behält.
Jenova Academic Research Assistant
Der Academic Research Assistant ist ein akademischer Forschungspartner für Literaturentdeckung, Manuskriptvorbereitung und Zitationsmanagement und läuft auf einer Plattform mit unbegrenztem Chatverlauf und sitzungsübergreifendem persistentem Speicher. Suchstrategien und Einschlusskriterien können in benutzerdefinierten Agent-Anweisungen eingefroren werden; PDFs, Protokolle und Screening-Protokolle lassen sich als private Wissensdatenbank anhängen, sodass spätere Sitzungen mit derselben Evidenzbasis beginnen.
Seine ehrliche Einschränkung ist das Gegenstück zu der von Elicit. Er liefert kein natives PRISMA-Flussdiagramm, keine Benutzeroberfläche für Dual-Review-Screening und kein spezielles Korpus mit 138 Millionen Papers für systematische Reviews. Teams, die Audit-Trails auf Cochrane-Niveau benötigen, werden Entscheidungen weiterhin in einen Review-Manager exportieren. Verwandte Arbeit, die einen einmaligen, zitierintensiven Bericht benötigt, kann an Deep Research übergeben werden, das Hunderte Quellen mit Inline-Zitaten synthetisiert; anschließend wird der Bericht zurück im selben langfristigen Thread gespeichert, damit die Befunde nicht zu einem weiteren verwaisten Dokument werden.
Consensus
Consensus ist eine akademische AI-Suchmaschine, die auf 250 million-plus papers zurückgreift, darunter lizenzierte Volltexte. Das Unternehmen berichtet von einer Nutzung durch 10 Millionen Forschende, Studierende und Kliniker sowie von mehr als 170 Partnern unter Universitätsbibliotheken. Deep Search erweitert Begriffe und verfolgt den Zitationsgraphen; Medical mode beschränkt die Suche auf etwa 50.000 klinische Leitlinien und 8 Millionen Artikel aus den 1.000 führenden medizinischen Fachzeitschriften. Der Consensus Meter visualisiert, wie stark die Evidenz bei einer Ja-oder-Nein-Frage übereinstimmt.
Der Vergleich von Paperguide aus dem Jahr 2026 liefert den richtigen Rahmen: Consensus finds and evaluates evidence; Gemini Notebook transforms sources you already have. Als Speichersystem ist Consensus eingeschränkt. Es speichert Ihre Einschlusskriterien nicht nativ als lebendes Protokoll; daher braucht ein Projekt, das ein Semester dauert, weiterhin einen externen Ort für „was wir im März entschieden haben“.
Gemini Notebook
Gemini Notebook – das Produkt, das früher NotebookLM hieß und seit Juli 2026 umbenannt ist – ist ein quellenverankerter Denkpartner. Sie laden PDFs, Websites, YouTube-Videos, Audio, Google Docs und Folien hoch; Antworten enthalten Zitate, die die exakten Textstellen zeigen. Organisationsdaten werden nicht zum Training des Produkts verwendet.
Die Grenze ist das Notizbuch. Es vergisst die Quellen nicht, die Sie ihm gegeben haben – genau deshalb funktioniert es für eine klar definierte Lektüresammlung –, und es entdeckt nicht das Paper, das Sie nie hochgeladen haben. Für einen monatelangen Review, der noch sucht, ist das eine strukturelle Grenze und keine Einstellungssache.
Wie speichern Sie Suchstrategien und Einschlusskriterien sitzungsübergreifend?
Sie speichern sie, indem Sie sie als dauerhafte Objekte niederschreiben – als Protokolldokument, benutzerdefinierte Anweisungen oder Screening-Konfiguration – und indem Sie sich weigern, die einzige Kopie in einem vergänglichen Prompt zu belassen. Existiert die Strategie nur im gestrigen Chat, existiert sie nicht.
Ein praktisches Muster sieht so aus:
- Fixieren Sie die Frage in PICO-Form. Population, Intervention, Vergleich und Outcomes sollten wortgleich in die dauerhaften Anweisungen des Assistenten kopiert werden, nicht jeden Montag umformuliert.
- Speichern Sie die Suche als wiederholbares Artefakt. Datenbanknamen, Boolesche Strings, Datumsgrenzen, Sprachgrenzen und Quellen grauer Literatur gehören in ein Dokument, das der Assistent erneut lesen kann.
- Trennen Sie Einschluss von Bauchgefühl. Kriterien wie „RCT, Erwachsene, 2015–2026, englischer Volltext“ sollten als Regeln aufgelistet sein. Präferenzen wie „scheint für unsere Theorie relevant“ sollten als Hypothesen gekennzeichnet werden, damit sie das Protokoll nicht unbemerkt umschreiben können.
- Protokollieren Sie Ausschlüsse mit Gründen. PRISMA erwartet transparente Berichterstattung über den Auswahlprozess; die Methodenübersicht von DistillerSR betont, dass PRISMA exists to help authors avoid pitfalls that undermine reviews.
Für Jenova besteht der Schritt des eingefrorenen Protokolls aus einem Block benutzerdefinierter Anweisungen plus einem angehängten Protokoll-PDF. Ein dauerhafter Prompt, der Monate übersteht, sieht so aus:
Du bist mein Partner für systematische Reviews für das Projekt HEP-24. Population: Erwachsene ab 18 Jahren mit NAFLD. Intervention: GLP-1-Rezeptoragonisten. Vergleich: Standardversorgung oder Placebo. Primäre Outcomes: MRI-PDFF und NAS. Schließe RCTs und prospektive Kohorten, 2018–2026, mit englischem Volltext ein. Schließe Tierstudien, Konferenzabstracts ohne Daten und Studien unter 8 Wochen aus. Wiederhole immer die Einschlussregeln, bevor du ein neues Batch screenst, und erweitere die Population niemals stillschweigend.
Für Elicit besteht das Äquivalent darin, das Review-Protokoll im Produkt zu verfeinern und anschließend automatisch vorgeschlagene Screening-Kriterien zu akzeptieren, zu bearbeiten oder zu ersetzen. Jede Entscheidung kann einen Ausschlussgrund und ein unterstützendes Zitat enthalten, was eher einer PRISMA-Audit-Datei als einem Chatprotokoll entspricht.
Für Gemini Notebook fügen Sie denselben PICO-Block in die Anweisungen des Notizbuchs ein und laden das Protokoll sowie den Suchezport hoch. Der Assistent bleibt diesen Dateien treu und erfindet keine Papers außerhalb davon.
Der zu beobachtende Fehlermodus ist die „hilfreiche Erweiterung“. Nach sechs Wochen beginnen Modelle oft, benachbarte Populationen einzuschließen, weil sie relevant klingen. Ein eingefrorenes Protokoll, das der Assistent zu Beginn jeder Sitzung wiederholen muss, ist die kostengünstigste Kontrolle, die Sie hinzufügen können.
Wie verändert persistenter Speicher Datenextraktion und Bias-Bewertung?
Persistenter Speicher macht aus der Extraktion keine einmalige Transkriptionsaufgabe, sondern einen kumulativen Datensatz – dort geht der Großteil der Zeit verloren, und dort ist AI-Unterstützung inzwischen empirisch testbar. Das Diagramm mit den sieben Review-Schritten markiert die Extraktion als Engpass, weil Outcome-Daten in Quell-PDFs uneinheitlich berichtet werden; ein Assistent, der sich nicht an das Extraktionssheet erinnert, führt dieses Chaos jede Woche erneut ein.
Die Evidenz aus 2026 ist präziser als Marketingversprechen. Eine Studie innerhalb eines Reviews auf medRxiv verglich Elicit-gestützte Extraktion mit ausschließlich menschlicher Extraktion über 50 RCTs zu chronischen Erkrankungen und fand no difference in overall accuracy (mittlere Differenz 0,57 auf einer Skala von 0–100), während AI-gestützte Extraktion 24.82 minutes faster war und über die 50 Studien hinweg $181.98 weniger kostete. Fehlertypen und Schweregrad waren ähnlich. Die eigene Validierung von Elicit berichtet, dass VDI/VDE correctly extracted 1,502 of 1,511 data points (99.4%), und CSIRO-Forschende fanden near-zero false negatives im Vergleich zur manuellen Extraktion.
Eine weitere Forschungsrichtung behandelt AI als zweiten Reviewer und nicht als Ersatz. Ein Cochrane Evidence Synthesis and Methods paper berichtete, dass AI-Tools bei der Datenextraktion eine hohe und ähnliche Leistung wie menschliche Reviewer zeigten, insbesondere bei standardisierten Variablen. Die Methodennotiz der Birmingham City University ist vorsichtiger: Generative Tools perform well on year, country, and participant counts, was nicht dasselbe ist wie die Extraktion nuancierter Outcomes auf Studienarm-Ebene.
Was Speicher zusätzlich zur reinen Extraktionsgenauigkeit bringt, ist Konsistenz des Sheets:
- Dieselben Outcome-Namen, Zeitpunkte und Einheiten werden in Woche 12 ebenso verwendet wie in Woche 2.
- Bereits markierte Diskrepanzen („zwei Stichprobengrößen im selben Paper“) werden nicht so wiederentdeckt, als wären sie neu.
- Die Bias-Bewertung kann über das Studiendesign nachdenken, nicht nur über einen Score. Arbeit zum Verzerrungsrisiko betrifft die Frage, wie Randomisierung, Verblindung und fehlende Daten Ergebnisse verzerren könnten – dafür müssen die Designnotizen der Studie erinnert werden, nicht nur das Abstract.
Die Einschränkung von Jenova liegt hier bei der Benutzeroberfläche, nicht bei der Absicht. Persistenter Speicher erinnert daran, dass Sie die Verdeckung der Zuteilung als kritische Domäne behandeln, füllt jedoch nicht automatisch eine Cochrane-RoB-2-Tabelle aus. Bei Elicit ist die Einschränkung umgekehrt: Die Extraktion kann stark strukturiert und mit Zitaten belegt sein, während informelle Bias-Überlegungen aus einem Betreuungstreffen weiterhin einen Ort zur Persistenz benötigen. Teams, die beides tun, sollten im strukturierten Tool extrahieren und die Kommentare auf Design-Ebene im langfristigen Forschungs-Agenten festhalten.
Wie richten Sie einen AI-Forschungsworkflow ein, der Monate überdauert?
Sie richten ihn ein, indem Sie ein dauerhaftes Projekthome erstellen, das Protokoll vor der ersten Suche laden und jede spätere Sitzung als Aktualisierung dieses Homes statt als neuen Chat behandeln. Der Workflow folgt derselben Idee, unabhängig davon, ob Sie einen speicherorientierten Agenten oder einen Arbeitsbereich für systematische Reviews verwenden; nur die Buttons unterscheiden sich.
Jenova-Einrichtung (unter zwei Minuten, danach fortlaufend)
- Öffnen Sie den Academic Research Assistant und speichern Sie das Protokoll, falls das Projekt langfristig angelegt ist, als benutzerdefinierte Anweisungen in einem dedizierten Agenten.
- Hängen Sie das Protokoll, die Suchstrings und jede vorhandene Screening-Tabelle als Wissensdatenbank an.
- Beginnen Sie mit einem Zustandsbericht statt mit einem vagen „weiter“:
Wiederhole unser PICO, die durchsuchten Datenbanken, das Datum der letzten Suche, die Anzahl eingeschlossener/ausgeschlossener Studien und die drei ungelösten Konflikte aus der letzten Sitzung. Screene dann die nächsten 25 Titel anhand der eingefrorenen Kriterien. Erweitere die Einschlusskriterien nicht.
- Beenden Sie jede Sitzung mit einer schriftlichen Übergabe, die die nächste Sitzung laden kann: Suchaktualisierungen, neue Ausschlüsse mit Gründen, noch fehlende Extraktionsfelder und Fragen für den zweiten Reviewer.
Kostenpflichtige Jenova-Pläne beginnen bei $20/Monat für das 30×-Nutzungskontingent des kostenlosen Tarifs; höhere Stufen liegen bei $50, $100, $200, $500 und $1,000 pro Monat. Die Nutzung wird monatlich am Abrechnungsdatum zurückgesetzt. Diese Preisgestaltung ist für monatelange Arbeit relevant, weil ein Review, der stirbt, wenn mitten im Screening ein Limit des kostenlosen Tarifs erreicht wird, ein Speicherfehler anderer Art ist.
Elicit-Einrichtung
Der Ablauf für systematische Reviews in Elicit lautet: Protokoll verfeinern, Suchen über PubMed, ClinicalTrials.gov und das eigene Paper-Korpus kombinieren – oder aus anderen Datenbanken importieren –, mit AI-gestütztem Dual Review screenen, mit zitiergestützten Feldern extrahieren und anschließend Berichte synthetisieren, die PRISMA flow diagrams, paper-summary tables, and search strategies enthalten können. Living Reviews sind die monatelange Funktion: Kombinieren Sie den Review mit Alerts, damit dasselbe Protokoll neue Papers aufnimmt, ohne ein neues Projekt zu erstellen.
Gemini-Notebook-Einrichtung
Erstellen Sie ein Notizbuch pro Review. Laden Sie Protokoll, Suchezport und PDFs hoch. Stellen Sie nur Fragen, die anhand dieser Dateien beantwortbar sein sollten. Wenn neue Papers das Screening überstehen, fügen Sie sie demselben Notizbuch hinzu, statt ein zweites zu beginnen; aufgeteilte Notizbücher sind der Weg, auf dem quellenverankerte Tools „vergessen“.
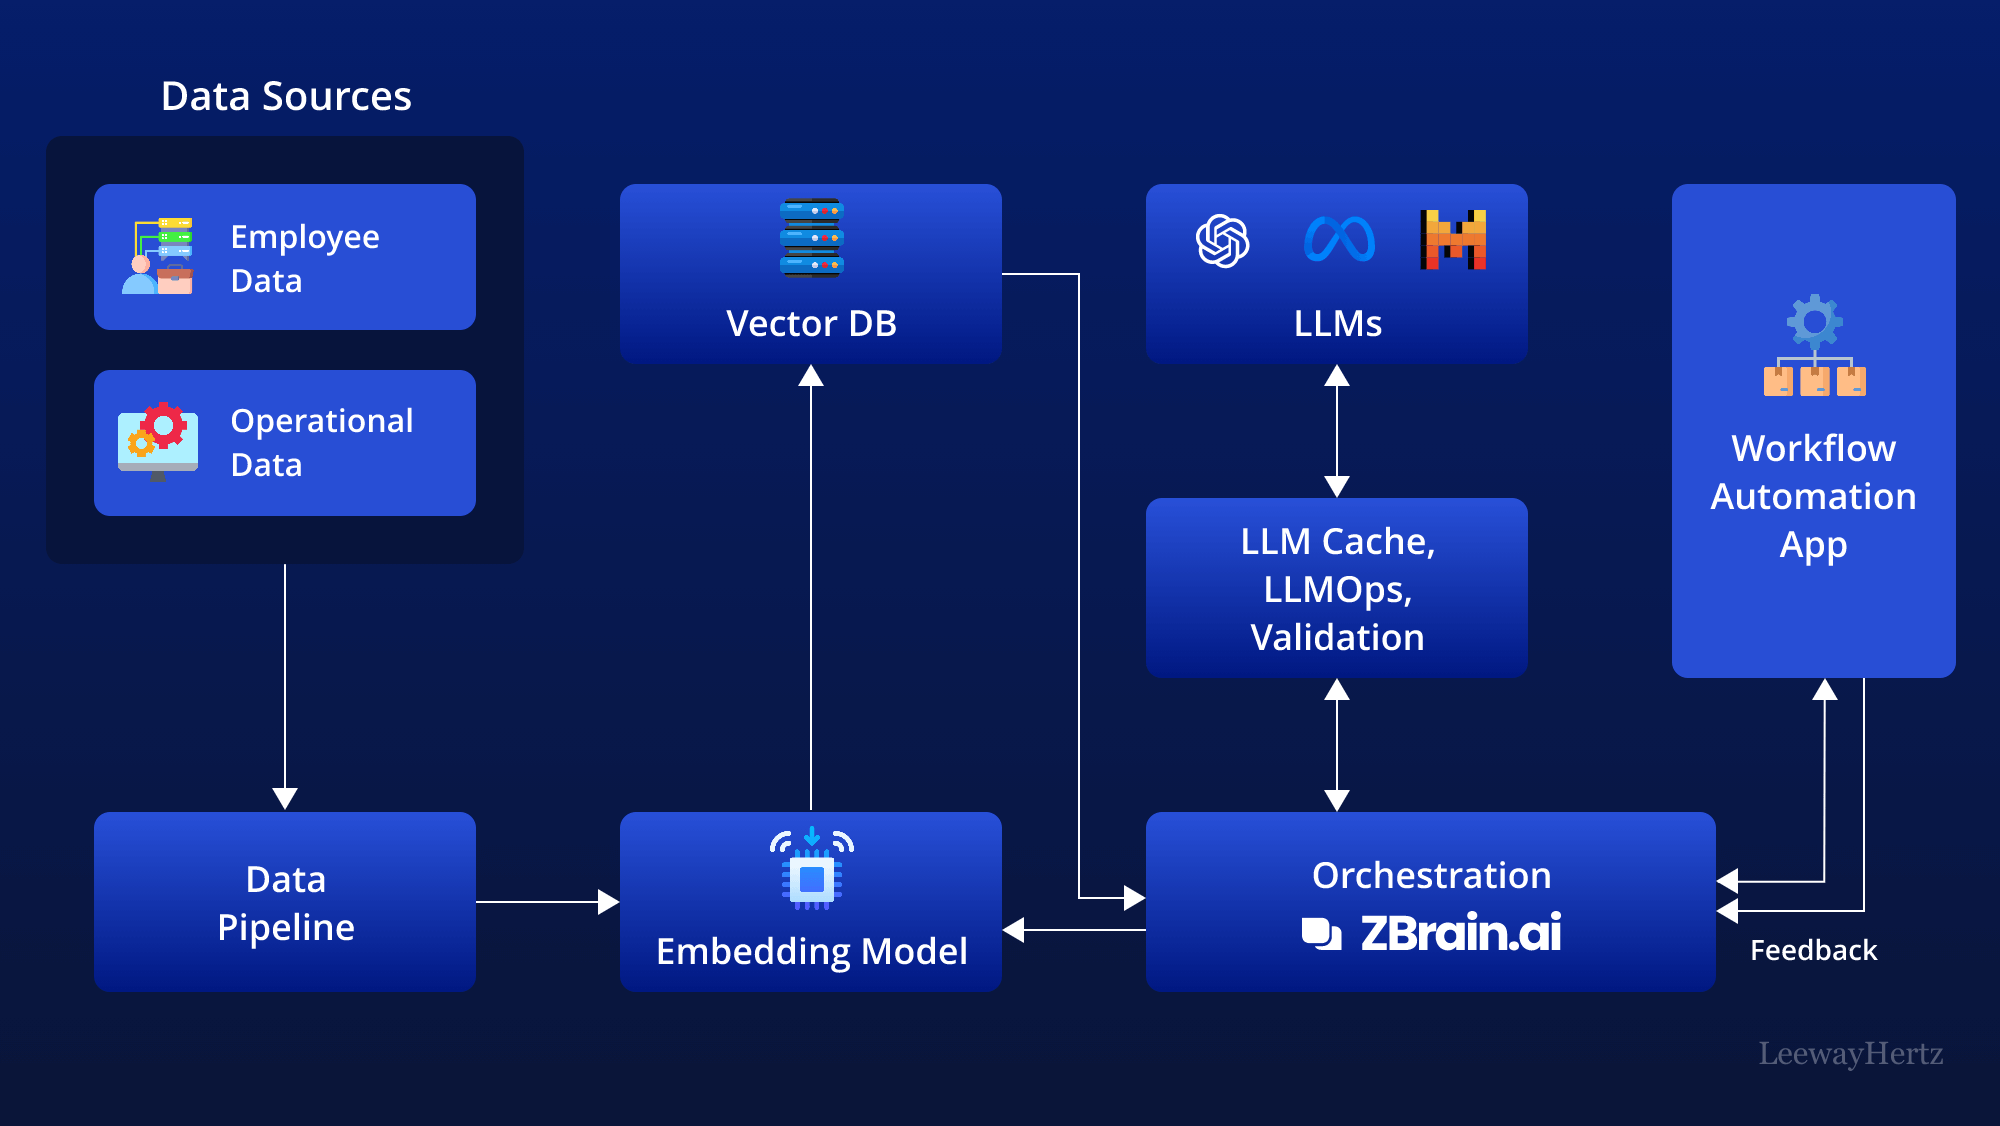
Das Architekturdiagramm ist die industrielle Version derselben Idee. Dauerhafter Forschungsspeicher ist eine Pipeline: Quellen durchlaufen Aufnahme, Embeddings, einen Vector Store, Orchestrierung, Modellaufrufe, Validierung und eine Feedbackschleife. Forschende müssen diesen Stack nicht selbst zusammenbauen, aber sie benötigen ein Produkt, das ihn implementiert. Der Sitzungs-Chat ist nur die letzte Box. Wenn Befunde nie im Speicher, in einer Wissensdatenbank oder in einem Review-Arbeitsbereich landen, hat die Pipeline keinen Zustand – und im vierten Monat erklären Sie erneut, was im ersten Monat geschah.
Was sagen Forschungsmethodologen über AI-Speicher in der Evidenzsynthese?
Methodologen behandeln AI als arbeitssparenden Reviewer mit einem Audit-Problem, nicht als Ersatz für ein rekonstruierbares Protokoll. Die nützliche Expertenfrage lautet nicht „kann das Modell eine Stichprobengröße extrahieren?“, sondern „kann ein zweiter Mensch sehen, warum dieses Paper im Februar ausgeschlossen wurde, und im Oktober noch zustimmen?“
„Die Reviews, die im sechsten Monat auseinanderfallen, scheitern fast nie daran, dass das Modell ein Synonym übersehen hat. Sie scheitern, weil die Einschlussregel nie als Objekt gespeichert wurde. Teams tippen in jeder Sitzung eine leicht andere Populationsdefinition ein und wundern sich dann, warum sich die Evidenztabelle nicht stabilisiert. Persistenter Speicher ist in diesem Kontext keine Komfortfunktion. Er ist der einzige Weg, auf dem Protokoll und Befunde dieselbe Zeitachse teilen.“
„Wir sehen außerdem, dass Teams strukturierter Extraktion zu stark vertrauen und zu wenig in Entscheidungsprotokolle investieren. Mit Zitaten belegte Datenfelder sind notwendig, und die Extraktionsstudien von 2026 sind bei Genauigkeit im Verhältnis zur Zeit ermutigend. Sie dokumentieren jedoch nicht, warum eine Grenzfallstudie behalten wurde. Kann Ihre AI diesen Grund nicht abrufen, haben Sie keinen Living Review. Sie haben eine Reihe verwandter Chats.“
„Das praktische Design, das wir empfehlen, ist langweilig: Protokoll in Anweisungen einfrieren, Befunde in Speicher oder einem Arbeitsbereich ansammeln, Antworten in einem Korpus verankern, auf das Sie verweisen können, und ein Audit exportieren, das die PRISMA-Checkliste verarbeiten kann. Wählen Sie Tools für diese vier Aufgaben. Wählen Sie kein Tool, weil sich der erste Nachmittag flüssig anfühlte.“
— Jenova Product Team, Design langfristiger Forschungsworkflows
Diese Haltung entspricht der Berichtslandschaft, in die Reviews eintreten müssen. Das Erläuterungs- und Ausarbeitungspapier zu PRISMA 2020 auf PMC stellt ausdrücklich fest, dass die Leitlinie für Reviews gilt, die include synthesis, und das EQUATOR Network führt dieselbe updated reporting guideline. Ein Assistent, der Methoden nicht erinnern kann, kann Ihnen nicht helfen, Methoden zu berichten.
Was geschieht mit der Reproduzierbarkeit, wenn ein AI-Assistent die Ausschlüsse des letzten Monats nicht abrufen kann?
Reproduzierbarkeit wird zum Theater: Sie können weiterhin einen flüssigen Abschnitt zu verwandter Forschung erzeugen, aber die Studienmenge nicht mehr verteidigen. Ein monatelanges Projekt produziert Hunderte Einschluss- und Ausschlussentscheidungen. Sind diese Entscheidungen nicht abrufbar, können ein neuer Screener, eine Betreuungsperson oder ein Journal-Reviewer nicht zwischen protokollgesteuertem Ausschluss und sitzungsabhängiger Stimmung unterscheiden.
Living Systematic Reviews machen das Scheitern sichtbar. Elicit beschreibt Living Reviews als Kombination des abgeschlossenen Reviews mit Alerts, sodass neue Informationen every year, or as needed aufgenommen werden können, und erlaubt das Teilen eines Links zum gesamten Prozess und zu Zwischenergebnissen. Das funktioniert nur, wenn die Ausschlüsse des letzten Quartals Teil des Objekts sind, das aktualisiert wird. Ein Chatbot, der „sich an das Thema erinnert“, aber nicht an das Ausschlussprotokoll, nimmt Papers erneut auf, die Sie bereits abgelehnt haben, oder lehnt Papers erneut ab, die Sie bereits extrahiert haben.
Drei Reproduzierbarkeitsprüfungen decken die Lücke schnell auf:
- Wiedergabetest. Bitten Sie den Assistenten nach einer Woche Pause, die letzten 20 Ausschlüsse mit Begründungen aufzulisten. Erfindet er Gründe oder vermischt Projekte, fehlt die Audit-Ebene.
- Erweiterungstest. Geben Sie ihm ein thematisch verlockendes Abstract außerhalb des Geltungsbereichs. Argumentiert er für Einschluss, ohne die eingefrorenen Kriterien zu zitieren, ist die Protokollpersistenz gescheitert.
- Übergabetest. Ein Kollege sollte vom letzten Zustandsbericht des Assistenten aus ohne mündliches Briefing weitermachen können. Kann er das nicht, ist der Speicher persönlich und nicht wissenschaftlich.
Jenova besteht Wiederholungs- und Übergabetests, wenn Anweisungen, Wissensdatenbanken und Sitzungsspeicher tatsächlich genutzt werden; es erfordert weiterhin, dass Sie ein PRISMA-förmiges Protokoll exportieren, wenn ein Journal ein Flussdiagramm verlangt. Elicit erfüllt den Audittest nativer und verlangt dennoch, dass Sie informelles wissenschaftliches Urteil an anderer Stelle bewahren. Consensus und Gemini Notebook bestehen, allein verwendet, unterschiedliche Prüfungen nicht: Consensus kann Ihre Ausschlüsse nicht wiedergeben, und Gemini Notebook kann keine Papers wiedergeben, die nie hochgeladen wurden.
Das Problem monatelanger Forschung lautet daher nicht „welches Modell ist 2026 am intelligentesten“. Entscheidend ist, ob Suchstrategien, Einschlusskriterien und frühere Befunde in einem Stack gespeichert sind, der noch existiert, wenn Sie zurückkehren. Wählen Sie das Tool, das diese drei Objekte bewahrt, und lassen Sie den Assistenten sie zu Beginn jeder Sitzung wiederholen, damit Drift offen stattfinden muss.
Referenzen
- PRISMA 2020 statement — Checkliste, Flussdiagramme und Berichtsleitlinien für systematische Reviews
- PRISMA statement — Überblick über die zentrale Berichtsleitlinie für systematische Reviews
- The BMJ — The PRISMA 2020 statement: eine aktualisierte Leitlinie für die Berichterstattung über systematische Reviews
- Hofstra University LibGuides — PRISMA-Checkliste mit 27 Punkten für systematische Reviews und Meta-Analysen
- ScienceDirect — AI-Tools für systematische Literaturreviews und Meta-Analysen, einschließlich einer Kartierung von 63 ML-Tools
- King's College London — AI-Tools in der Evidenzsynthese
- Elicit — Systematische Literaturreviews: Screening, Extraktion, PRISMA-Audit, Living Reviews und Validierungsergebnisse
- Elicit — Produkt- und Preisübersicht, einschließlich Korpusgröße und Forschendenbasis
- Consensus — Akademische AI-Suchmaschine, Korpusgröße, Deep Search und Medical mode
- Paperguide — Consensus vs NotebookLM: Evidenzentdeckung gegenüber Quellentransformation (2026)
- Gemini Notebook (ehemals NotebookLM) — Quellenverankerte Notizbücher, Zitate auf Quote-Ebene und Datennutzungsrichtlinie
- DistillerSR — PRISMA-Leitlinien und Fallstricke, die systematische Reviews beeinträchtigen
- medRxiv — Genauigkeit und Effizienz AI-gestützter Datenextraktion mit Elicit gegenüber ausschließlich menschlicher Extraktion (2026)
- Wiley / Cochrane Evidence Synthesis and Methods — AI-Tools als zweite Reviewer für die Datenextraktion
- Birmingham City University — Leistung generativer AI bei der Datenextraktion für Literaturreviews
- PubMed Central — PRISMA 2020: Erklärung und Ausarbeitung
- EQUATOR Network — Eintrag zur PRISMA-2020-Berichtsleitlinie