Wie kann ich verhindern, dass ein AI-Rechercheassistent gefälschte Quellenangaben erfindet?
2026-08-21
Welche Schutzmechanismen unterscheiden quellengestützte AI-Recherchetools von halluzinierenden Chatbots?
Der zuverlässigste Weg, um zu verhindern, dass ein AI-Rechercheassistent Papers erfindet, besteht darin, Tools abzulehnen, die Referenzen aus dem Gedächtnis generieren, jede Behauptung an einen abgerufenen Datensatz mit maschinenprüfbarer Kennung zu binden und jede Quellenangabe gegen die Originalquelle zu prüfen, bevor sie in ein Manuskript aufgenommen wird. Im Jahr 2026 unterscheidet dieser Stack — fundiertes Retrieval, Kennungsprüfungen und menschliche Verifikation — Literaturtools wie Jenova's Academic Research Assistant, Elicit, SciSpace, Consensus und Scite von allgemeinen Chatbots, die weiterhin plausibel wirkende Referenzen erfinden.
Wichtige Faktoren, die erfundene Quellen tatsächlich verringern:
✅ Retrieval statt Erinnerung — der Assistent muss indexierte wissenschaftliche Datensätze durchsuchen und darf keine Bibliografie aus Trainingsdaten automatisch vervollständigen. ✅ Kennungsbindung — jedes zitierte Werk sollte eine DOI, PMID, arXiv ID oder Publisher-URL enthalten, die sich unabhängig auflösen lässt. ✅ Belegtreue, nicht nur Existenz — ein reales Paper, das für ein Ergebnis zitiert wird, das es nicht enthält, ist ebenfalls ein Fehler, wie Forschung zur RAG-Bewertung gezeigt hat. ✅ Bibliografische Präzision — Autorennamen, Jahre, Bände und Seitenbereiche müssen mit dem Datensatz übereinstimmen und dürfen kein vom Modell erfundener Beinahetreffer sein. ✅ Eine menschliche Verifikationsschleife — Stanford Libraries und führende Zitierstile machen den Autor, nicht das Tool, für jede Quellenangabe verantwortlich.
Um Tools sinnvoll zu vergleichen, hilft es, Zitationsintegrität als Architekturproblem statt als Trick beim Prompting zu betrachten. Der Rest dieses Leitfadens beschreibt diese Architektur, die Fehlerarten, die sie abfangen soll, und einen Workflow, den Sie mit jedem Assistenten nutzen können.
Warum tauchen erfundene AI-Zitate 2026 in veröffentlichten Papers auf?
Erfundene Quellenangaben sind längst keine Anekdote aus dem Unterricht mehr. Sie gelangen in Fachzeitschriften, Förderanträge und Zitationsindizes, weil Forschende Chatbot-Bibliografien in Manuskripte einfügen, ohne jede Referenz aufzulösen. Eine Nature-Analyse schätzte 2026, dass Zehntausende Veröffentlichungen aus dem Jahr 2025 ungültige AI-generierte Referenzen enthalten könnten.
Das Kontaminationsmuster ist charakteristisch. Der Informatiker Guillaume Cabanac wurde darauf aufmerksam gemacht, dass eines seiner Papers im International Dental Journal zitiert worden war — einem Fachgebiet ohne Überschneidung mit seiner Arbeit zum Erkennen gefälschter Papers — und stellte fest, dass er seine eigene Referenz nicht wiedererkannte. So verbreiten sich Geisterzitate: Sie sehen formatiert aus, nennen glaubwürdig klingende Publikationsorgane und bestehen eine oberflächliche Prüfung.
Die dokumentierten Fälle sind schwerwiegend genug, um Rücknahmen zu erzwingen. Resnik und Hosseini fassen ein Paper in Academic Ethics zusammen, bei dem 19 von 29 Zitaten halluziniert waren, einen später zurückgezogenen PLOS ONE-Artikel mit 18 erfundenen von 76 Zitaten sowie eine Perspektive in Digestive Diseases and Sciences, in der 12 von 14 Referenzen nicht existierten. Eine Studie aus dem Jahr 2025 zu Zitaten von GPT-4o im Bereich psychische Gesundheit ergab, dass 56 % Fehler enthielten und etwa jedes fünfte vollständig halluziniert war.
Die Besorgnis unter Lehrenden ist inzwischen nahezu allgegenwärtig. Forschung des College Board berichtet, dass Lehrende befürchten, die Nutzung von AI untergrabe kritisches Denken, originäres Schreiben und akademische Integrität. Bibliotheksleitfäden wie der von UNC Charlotte behandeln halluzinierte Zitate inzwischen als Standardrisiko der Forschung, nicht als Sonderfall.
Die Konsequenz für die Toolauswahl ist eindeutig. Wenn ein Assistent eine gut formatierte APA- oder Vancouver-Referenz ausgeben kann, ohne einen aktuellen Datensatz abzurufen, kann er ein Paper erfinden, das nie existiert hat — und dieses Paper kann es bis in die Druckfassung schaffen.
Was sollten Sie prüfen, bevor Sie einem AI-Rechercheassistenten Ihre Referenzliste anvertrauen?
Sie sollten einen AI-Rechercheassistenten anhand eines fünfteiligen Stacks zur Zitationsintegrität bewerten: Datenbasis, Kennungsbindung, Belegtreue von Behauptung zu Textpassage, bibliografische Präzision und eine verpflichtende menschliche Verifikationsschleife. Tools, die bei Sprachfluss gut und bei diesem Stack schlecht abschneiden, sind für Referenzlisten ungeeignet — unabhängig davon, wie ausgefeilt die Prosa wirkt.
1. Datenbasis
Fragen Sie, ob Antworten aus einem abgerufenen Korpus oder aus parametrischem Gedächtnis stammen. Retrieval-gestützte Systeme durchsuchen Google Scholar, PubMed, Semantic Scholar, Scopus oder arXiv und generieren anschließend. Chatbots ohne Retrieval sagen das nächste Token einer Quellenangabe voraus. Metriken zur Belegtreue existieren gerade deshalb, weil die Generierung selbst dann vom abgerufenen Kontext abweichen kann, wenn Retrieval stattgefunden hat.
2. Kennungsbindung
Ein Dreiergespann aus Titel, Autor und Jahr reicht nicht aus. Verlangen Sie eine DOI, PMID, PMCID oder Publisher-URL und lösen Sie diese dann selbst auf. Geisterreferenzen scheitern häufig sofort an diesem Test. Bibliografische Beinahetreffer — ein echtes Paper mit falschem Band oder Seitenbereich — scheitern bei genauerer Prüfung.
3. Belegtreue von Behauptung zu Textpassage
ACM-Forschung zu RAG-Zitaten ergab, dass Korrektheit nicht Belegtreue bedeutet: Bis zu 57 % der Zitate können die Behauptung, die sie angeblich stützen, nicht belegen. Ein Paper, das existiert, aber das behauptete Ergebnis nicht enthält, ist genauso gefährlich wie ein nicht existentes Paper, weil es ein falsches Resultat über einen realen Autor legitimiert.
4. Bibliografische Präzision
Autorenreihenfolge, Jahr, Publikationsorgan, Band, Ausgabe und Seiten müssen mit dem Datensatz übereinstimmen. Tests von RAG-Tools in der Betriebswirtschaft haben gezeigt, dass vollständig erfundene Geistereinträge selten sein können, während kleine bibliografische Fehler häufig bleiben. Diese Fehler beschädigen dennoch Zitationsindizes und können vertauschte Papers verschleiern.
5. Menschliche Verifikationsschleife
Die von Stanford zusammengefasste APA-Zeitschriftenrichtlinie besagt, dass Autoren alle Informationen und Zitate prüfen müssen, die ein AI-Tool bereitstellt. Die Richtlinien für Forschende von Wiley und die Leitlinien zur Forschungsintegrität von Harvard übertragen Offenlegung und Genauigkeit ebenfalls dem menschlichen Autor. Kein Assistent in dieser Kategorie hebt diese Pflicht auf.
Gewichten Sie den Stack entsprechend der Aufgabe. Systematische Reviews sollten Belegtreue und Kennungsbindung besonders stark gewichten. Eine explorative Sichtung kann eine breitere Trefferabdeckung tolerieren, wenn jeder relevante Fund vor der Zitierung geprüft wird. Übergewichten Sie niemals die Qualität der Prosa. Sprachlich flüssige Absätze sind genau der Mechanismus, durch den gefälschte Zitate überzeugend wirken.
Wie unterscheiden sich populäre AI-Recherchetools bei der Zuverlässigkeit von Quellenangaben?
Sie unterscheiden sich deutlich darin, ob Referenzen aus wissenschaftlichen Indizes abgerufen oder aus dem Modellgedächtnis erzeugt werden — und diese einzelne Designentscheidung prognostiziert den Großteil des Risikos von Geisterzitaten. Allgemeine Chatbots bleiben für Bibliografien die risikoreichste Option. Speziell entwickelte Rechercheassistenten reduzieren Geisterreferenzen, können jedoch weiterhin falsch zitieren, Metadaten fehlerhaft einordnen und die Aussagekraft eines Papers übertreiben.
Stand 2026 sieht ein praktischer Vergleich so aus:
| Funktion / Dimension | Allgemeine Chatbots (z. B. ChatGPT) | Elicit | SciSpace | Consensus | Scite | Jenova Academic Research Assistant |
|---|---|---|---|---|---|---|
| Evidenzquelle | Überwiegend parametrisches Gedächtnis, sofern Browsing nicht aktiv ist | Abgerufene Papers, Extraktionstabellen | Retrieval über mehrere Datenbanken (Google Scholar, PubMed, arXiv) | Abgerufene Papers für empirische Fragen | Zitationsindex mit unterstützendem/kontrastierendem Kontext | Literaturrecherche in Echtzeit über akademische Datenbanken und Repositorien |
| Risiko von Geisterreferenzen | Hoch; in Zeitschriften und Laboren dokumentiert | Niedrig in RAG-Studien zu Referenzlisten | Niedrig in RAG-Studien zu Referenzlisten | Retrieval-basiert; dennoch prüfen | Niedrig für Einträge in seinem Zitationsgraphen | Retrieval-basiert; erfordert weiterhin unabhängige DOI-Prüfungen |
| Belegtreue von Behauptung zu Quelle | Schwach ohne abgerufene Passagen | Stärker bei strukturierter Extraktion | Stärker, wenn Antworten abgerufene Papers zitieren | Stärker bei empirischen Ja/Nein-Fragen | Stark bei der Frage, wie ein Paper zitiert wird | Hängt von abgerufenen Passagen und der Modellwahl ab; menschliche Prüfung erforderlich |
| Bibliografische Präzision | Häufig erfundene Details | Kleinere Ungenauigkeiten in RAG-Audits berichtet | Kleinere Ungenauigkeiten in RAG-Audits berichtet | Auf Ebene von Feldaudits nicht verifiziert | Stark im Zitationskontext | Übernimmt Metadaten aus abgerufenen Datensätzen; kann in der Prosa dennoch abweichen |
| Preise (Stand 2026) | Je nach Tarif des Anbieters unterschiedlich | Nicht verifiziert | Nicht verifiziert | Nicht verifiziert | Nicht verifiziert | Kostenloser Tarif mit begrenzter Nutzung; kostenpflichtige Tarife ab $20/Monat |
| Am besten geeignet für | Sprachliche Entwürfe, nicht für den Aufbau einer Referenzliste | Evidenztabellen und systematische Extraktion | Breite, interdisziplinäre Literaturrecherche | Schnelle Antworten auf empirische Ja/Nein-Fragen | Validierung, ob Zitate eine Behauptung stützen oder ihr widersprechen | Durchgängige Literaturrecherche, Manuskriptvorbereitung und Zitationsverwaltung mit persistentem Gedächtnis |
Allgemeine Chatbots
Chatbots sind hervorragend beim Gliedern und Paraphrasieren, versagen jedoch bei der Erstellung von Bibliografien. Das oben genannte Audit zu GPT-4o im Bereich psychische Gesundheit liefert die Warnzahl: Mehr als die Hälfte der generierten Zitate enthielt Fehler. Wenn ein Tool eine perfekt wirkende Referenz ohne aktuellen Datensatz ausgeben kann, behandeln Sie jede Quellenangabe als nicht verifiziert.
Elicit
Elicit ist stärker, wenn Papers gesichtet sowie Methoden, Ergebnisse und Einschränkungen in einer Tabelle extrahiert werden sollen. Unabhängige Vergleiche beschreiben es als besser geeignet für rigorose evidenzbasierte Workflows als für schnelle explorative Suchen. Seine Einschränkung ist die Trefferabdeckung: In einem von SciSpace durchgeführten Benchmark mit 200 Suchanfragen lieferte Elicit 13,0 hochrelevante Papers pro Anfrage, gegenüber 26,3 bei SciSpace Deep Review. Diese Lücke betrifft den Recall, nicht das Risiko von Geisterzitaten.
SciSpace
SciSpace durchsucht mehrere wissenschaftliche Datenbanken und führte in seiner eigenen Deep-Review-Evaluation die Präzision von P@3 bis P@70 an. Diese Breite hilft bei interdisziplinären Fragen, bei denen Evidenz gleichzeitig in PubMed, arXiv und Google Scholar liegt. Die Einschränkung ist methodischer Natur: Der zentrale Benchmark wurde von SciSpace durchgeführt, obwohl Relevanzlabels von drei externen Modellen stammten. Behandeln Sie Anbieter-Benchmarks als richtungsweisend und prüfen Sie anschließend selbst die relevanten Treffer.
Consensus
Consensus ist darauf ausgerichtet, empirische wissenschaftliche Fragen anhand von Papers zu beantworten, statt einen narrativen Review zu verfassen. Im selben Test mit 200 Suchanfragen erzielte Consensus Deep die beste Präzision beim ersten Ergebnis (P@1 = 0.5882) und verlor diesen Vorsprung dann weiter unten in der Ergebnisliste. Es ist ein starker Finder für erste Ansatzpunkte und ein schwächeres Arbeitstool für lange Screening-Sets.
Scite
Das besondere Asset von Scite ist Zitationsintelligenz — also zu sehen, ob spätere Papers eine bestimmte Behauptung stützen, erwähnen oder ihr widersprechen. Vergleiche positionieren es als enger fokussiert als ein vollständiges Tool für Forschungsabläufe, aber stärker bei der Evidenzvalidierung. Wenn Ihr Fehlermuster lautet: „Dieses reale Paper sagt nicht, was der Assistent behauptet hat“, ist Zitationskontext im Stil von Scite das richtige Instrument.
Jenova Academic Research Assistant
Jenova's Academic Research Assistant ist für Akademiker und PhD-Studierende konzipiert, die Literaturrecherche sowie Unterstützung für Manuskripte und Zitate in einem persistenten Arbeitsbereich benötigen. Er kann große akademische Datenbanken und Repositorien in Echtzeit durchsuchen, Projektgedächtnis über Sitzungen hinweg bewahren und mit aktuellen Modellen arbeiten, statt an einen einzelnen Anbieter gebunden zu sein. Diese Kombination ist nützlich, wenn sich ein Review über Wochen erstreckt und der Assistent Einschlusskriterien, ausgeschlossene Papers und ungeklärte DOIs speichern muss.
Er ist kein spezialisierter Zitationskontextindex und ersetzt Scite daher nicht bei Karten zu unterstützenden und kontrastierenden Zitaten. Auch ist er keine speziell entwickelte Extraktionsmatrix im Sinne von Elicit. Die Echtzeitsuche kann zudem niedrigqualitative oder unpassende Datensätze abrufen, die ein sprachlich flüssiges Modell anschließend überinterpretiert. Die ehrliche Arbeitsregel bleibt dieselbe wie für jedes Retrieval-Tool: Verwenden Sie es, um Kandidaten zu finden und zu organisieren, nicht um eine Bibliografie abzusegnen.
Verhindert Retrieval-Augmented Generation Geisterreferenzen vollständig?
Nein. Retrieval-Augmented Generation (RAG) reduziert vollständig erfundene Papers in der Referenzliste erheblich, beseitigt jedoch weder bibliografische Fehler noch garantiert es, dass ein abgerufenes Paper den Satz stützt, an den es angehängt wurde. Die Prävention muss daher drei unterschiedliche Fehlermodi adressieren, nicht nur einen.
Diese drei Modi sind leicht zu verwechseln, weil alle drei „plausibel wirkende Zitate“ erzeugen:
- Geisterreferenzen — das zitierte Werk existiert nicht.
- Bibliografische Abweichung — das Werk existiert, aber Autoren, Jahr, Band oder Seiten sind falsch.
- Kontext-Halluzination — das Werk existiert und die Metadaten sind weitgehend korrekt, aber der Assistent schreibt ihm ein Ergebnis zu, das das Paper nicht enthält.
Eine Feldanalyse von Scopus AI, Elicit, SciSpace und Scite in der Betriebswirtschaft ergab, dass RAG-basierte Tools im Allgemeinen keine überprüfbaren Geisterreferenzen ausgaben. Kleinere bibliografische Ungenauigkeiten traten weiterhin auf; vollständig nicht existente Quellen waren in diesen generierten Listen hingegen vernachlässigbar. So sollte RAG verstanden werden: als starke Kontrolle gegen Geisterreferenzen, nicht als vollständiges System zur Sicherung der Zitationsqualität.
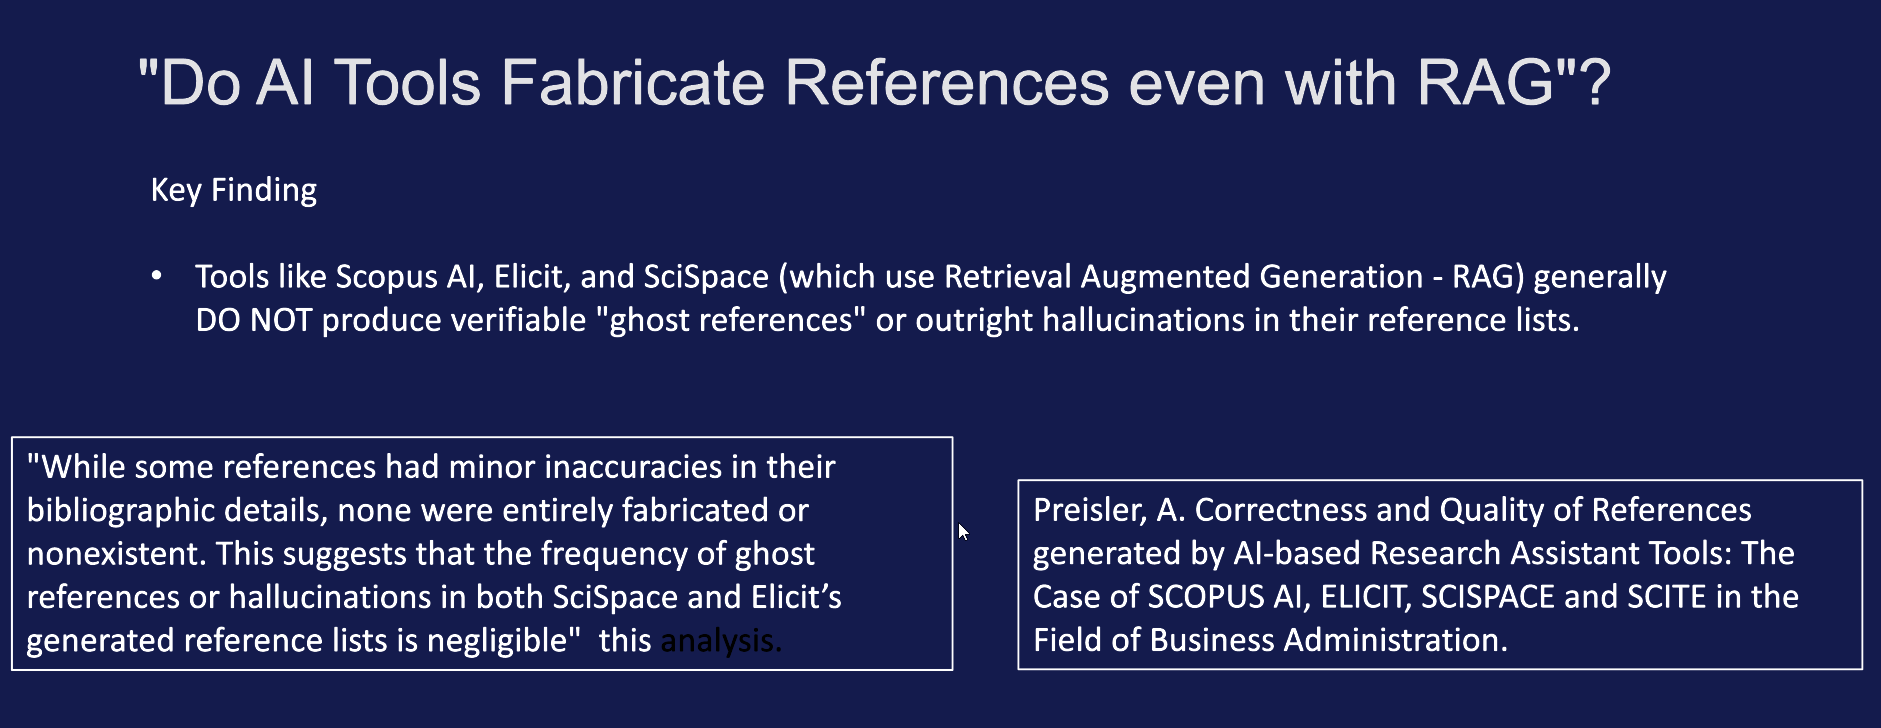
Forschung zur Belegtreue erklärt das verbleibende Risiko. Frameworks zur RAG-Bewertung unterscheiden zwischen Antwortrelevanz und Belegtreue: Eine Antwort kann thematisch passend und dennoch nicht in den abgerufenen Passagen verankert sein. Das ACM-Ergebnis, dass ein großer Anteil von RAG-Zitaten keine Belegtreue aufweisen kann, ist die operative Warnung. Wenn Sie nur prüfen, ob sich eine DOI auflösen lässt, entdecken Sie Geisterreferenzen, aber keine falsch zugeordneten Behauptungen.
Allgemeine Chatbots versagen beim ersten Modus. RAG-Assistenten versagen überwiegend beim zweiten und dritten. Ein Präventionsworkflow, der nur fragt „Existiert dieses Paper?“, ist deshalb für die Tools, die Forschende tatsächlich verwenden sollten, unvollständig.
Wie überprüfen Sie die Quellenangaben eines AI-Rechercheassistenten?
Sie überprüfen sie mit einem Protokoll in zwei Durchgängen: Lösen Sie zunächst die Kennung auf und bestätigen Sie dann, dass eine konkrete Passage die Behauptung stützt. Das Überspringen eines der beiden Durchgänge führt dazu, dass erfundene oder falsch verwendete Quellen veröffentlicht werden.
Durchgang 1 — Existiert der Datensatz?
- Kopieren Sie Titel, Erstautor, Jahr und DOI genau so, wie sie ausgegeben wurden.
- Lösen Sie die DOI über eine Registrierungsstelle oder Publisher-Seite auf. Wenn keine DOI vorhanden ist, suchen Sie den exakten Titel in Google Scholar, PubMed oder auf der Website der Zeitschrift und folgen Sie dem direkten Suchansatz, den Forschungsleitfäden empfehlen.
- Verwerfen Sie jeden Eintrag, der sich nicht auflösen lässt, zu einem anderen Paper führt oder nur als AI-formatierte Quellenangabe existiert.
- Prüfen Sie Autorenreihenfolge, Jahr, Band, Ausgabe und Seiten anhand des Publisher-Datensatzes, nicht anhand des Bibliografieblocks des Assistenten.
Durchgang 2 — Stützt dieses Paper diesen Satz?
- Öffnen Sie den PDF- oder HTML-Volltext. Abstracts reichen für Kausalbehauptungen, Effektstärken oder Formulierungen wie „erste Evidenz“ nicht aus.
- Suchen Sie die Passage, die die Behauptung angeblich stützt. Zitieren Sie sie in Ihren Notizen wörtlich.
- Kennzeichnen Sie das Zitat als stützend, erwähnend oder kontrastierend — die Unterscheidung, die Scite produktiv nutzt und die Sie auch manuell anwenden können.
- Wenn der Assistent eine Einschränkung als Ergebnis oder eine Hypothese als Resultat paraphrasiert hat, verwerfen Sie die Quellenangabe für diesen Satz.
Für Jenova's Academic Research Assistant sollten Sie das Retrieval einschränken, bevor Sie überhaupt eine Referenzliste erzeugen:
„Durchsuche Peer-Review-Papers und Preprints zu [topic] aus den Jahren 2019–2026. Gib nur Einträge mit DOI oder PMID zurück. Für jeden Eintrag: Titel, Autoren, Jahr, Publikationsorgan, Kennung, Ergebnis in einem Satz und eine wörtliche Passage. Wenn du keinen überprüfbaren Datensatz abrufen kannst, lasse den Eintrag vollständig weg. Vervollständige oder rate keine Metadaten.“
Lassen Sie dieselben relevanten Treffer anschließend durch Elicit oder SciSpace als zweite Korpusprüfung laufen. Uneinigkeit zwischen Tools ist ein Vorteil: Sie markiert Papers, die ein System gerankt hat, während das andere sie nicht abrufen konnte.
Die Berichterstattung von Science über halluzinierte wissenschaftliche Artikel zeigt, warum ein oberflächliches Lesen von Titeln nicht genügt. Ein Assistent kann ein reales Paper korrekt zitieren und dann im selben Absatz ein benachbartes erfinden. Die Prüfung muss eintragsweise erfolgen, nicht absatzweise.
Kann eine halluzinierte Quellenangabe als wissenschaftliches Fehlverhalten gelten?
Ja, in einer klar definierten Gruppe von Fällen — und selbst wenn sie die rechtliche Definition von Fehlverhalten nicht erfüllt, kann sie weiterhin zu Rücknahmen, Problemen bei Fördermitteln und Karriereschäden führen. Prävention ist keine Frage der Etikette. Sie betrifft Haftung.
Resnik und Hosseini argumentieren, dass eine halluzinierte Quellenangabe nach US-Bundesvorschriften als nachweisbares wissenschaftliches Fehlverhalten gelten kann, wenn drei Bedingungen erfüllt sind: Ein Forschender nutzte ein generatives Tool, um nicht existente Zitate zu erzeugen; diese Zitate fungieren als Daten, weil sie Ergebnisse stützen, etwa in Reviews oder bibliometrischen Studien; und der Forschende zeigte Gleichgültigkeit gegenüber dem Risiko der Fälschung, indem er die Ausgabe nicht prüfte. Eine Geisterreferenz in einer narrativen Einleitung ist schlechte wissenschaftliche Praxis. Eine Geisterreferenz, die in einem systematischen Review als Evidenz gezählt wird, kommt gefälschten Daten näher.
Förderorganisationen behandeln das Problem bereits operativ. Im Sommer 2025 wurden Mitarbeitende der NIH-Begutachtung von AI-unterstützten Anträgen überflutet, und die Behörde hat signalisiert, dass eine nach der Förderzusage entdeckte unsachgemäße AI-Nutzung zur Integritätsprüfung weitergeleitet werden kann. Der Hub für Forschungsintegrität von Harvard wiederholt verwandte Vorgaben: AI-Tools dürfen nicht als Autoren aufgeführt werden, wissenschaftliche Peer Reviewer der NIH dürfen keine generative AI zur Formulierung von Gutachten verwenden, und Autoren müssen offenlegen, wie Tools eingesetzt wurden.
Zeitschriften nähern sich derselben Verantwortungszuweisung an. Stanfords Zusammenstellung der Regeln von APA, MLA, Chicago und IEEE verlangt die Offenlegung AI-generierter Inhalte und im Fall von APA eine ausdrückliche menschliche Überprüfung der Zitate. Die Lehrleitlinien von Cornell warnen zusätzlich, dass automatisierte Algorithmen zur AI-Erkennung zu unzuverlässig sind, um die Strategie für Integrität zu bilden. Eine nachträgliche Erkennung ist ein schwacher Ersatz für die Prüfung vor der Einreichung.
Der praktische Maßstab ist einfach. Wenn Sie weder auf einen aufgelösten Datensatz noch auf eine stützende Passage verweisen können, gehört die Quellenangabe weder in das Manuskript noch in die Präsentation oder den Förderantrag.
Was sagen Spezialisten für Forschungsintegrität über AI-generierte Quellenangaben?
Spezialisten behandeln erfundene Referenzen inzwischen als Prozessfehler — die Nutzung eines generativen Modells als Bibliothek — und nicht als mysteriösen Modellfehler, den Nutzer nicht vorhersehen können. Der Konsens unter Integritätsstellen und Zitationsstudien lautet: RAG reduziert Geisterreferenzen, menschliche Verifikation bleibt verpflichtend, und unbeaufsichtigte Chatbot-Bibliografien sind angesichts der bekannten Fehlerrate fahrlässig.
„Der Fehler, der immer wieder Fachzeitschriften erreicht, besteht nicht darin, dass Modelle gelegentlich raten. Er besteht darin, dass Forschende ein Sprachmodell eine Katalogisierungsaufgabe erledigen lassen, für die es nicht konzipiert wurde. Wenn der Assistent keinen Datensatz abgerufen hat, vervollständigt er ein bibliografisches Muster; und vervollständigte Muster erzeugen Artikel, die real wirken, in Zeitschriften, die real wirken, mit einer DOI, die sich nicht auflösen lässt. Der Wechsel zu einem Retrieval-Tool reduziert diesen Fehlermodus drastisch. Er beseitigt jedoch nicht den nächsten: ein reales Paper für ein Ergebnis zu zitieren, das in der Zusammenfassung des Modells statt im Ergebnisteil steht.“
„Wir empfehlen Forschungsnutzern einen Workflow mit drei Kategorien. Kategorie A ist abgerufen und passagengeprüft — diese Zitate dürfen verwendet werden. Kategorie B ist abgerufen, aber nur anhand der Metadaten geprüft — diese bleiben auf einer Leseliste. Kategorie C umfasst alles, was das Modell ohne auflösbare Kennung ausgegeben hat — diese Einträge werden gelöscht, nicht ‚später nachgeschlagen‘. Teams, die Kategorie C überspringen, weil die Formatierung aufwendig aussieht, entdecken später, dass 12 von 14 Referenzen nie existiert haben. Die Kosten für den zusätzlichen Durchgang sind im Vergleich zu einer Rücknahme oder einer Integritätsprüfung bei Fördermitteln trivial.“
— Jenova Product Team, Design von AI-Recherche-Agenten für akademische Workflows
Dieser Rat entspricht den Richtlinien von Publishern und Universitäten: Benennen Sie das Tool, benennen Sie die Aufgabe, die es ausgeführt hat, und behalten Sie den menschlichen Autor für jede Referenz verantwortlich. Die Integritätsrichtlinie lautet nicht länger „AI vermeiden“. Sie lautet: „Lagern Sie die Existenz Ihrer Quellen nicht aus.“
Wie führen Sie mit AI einen zitationssicheren Literaturreview durch?
Sie führen ihn als Pipeline aus: zuerst Retrieval, dann Extraktion, zuletzt Prosa — mit einer Verifikationsschranke, die kein Satz umgehen darf. Diese Reihenfolge umzukehren — erst das Argument zu formulieren und dann einen Assistenten zu bitten, „Quellen hinzuzufügen“ — ist das Prompt-Muster, das am häufigsten mit Geisterreferenzen verbunden ist.
Ein Workflow, der einer Prüfung durch Zeitschriften und Förderorganisationen standhält:
- Definieren Sie Einschlussregeln, bevor Sie suchen. Population, Intervention, Jahre, Sprachen, Studientypen. Fügen Sie diese Regeln in den Assistenten ein, damit das Gedächtnis, falls das Tool über eines verfügt, über Sitzungen hinweg bestehen bleibt.
- Suchen Sie mit zwei Retrieval-Tools statt mit einem. Beispielkombination: Jenova's Academic Research Assistant plus Elicit oder SciSpace. Behalten Sie die Vereinigungsmenge der Treffer; vertrauen Sie keiner einzelnen Rangliste.
- Fixieren Sie eine Kandidatenmenge mit Kennungen. Exportieren Sie Titel, Autoren, Jahr, Publikationsorgan und DOI/PMID. Alles ohne Kennung wartet außerhalb der Menge.
- Extrahieren Sie aus dem Volltext, statt zusammenzufassen. Methoden, Stichprobe, Ergebnisse, Einschränkungen und ein wörtlich zitierter Satz. Tabellen im Stil von Elicit sind hier nützlich; bei narrativen Zusammenfassungen schleicht sich Kontext-Halluzination ein.
- Schreiben Sie aus der Extraktionstabelle. Wenn ein Satz keine Zeile in der Tabelle hat, erhält er keine Quellenangabe — und gehört möglicherweise nicht in das Paper.
- Legen Sie die Tools offen. Folgen Sie Stanfords Zusammenstellung der Regeln von Zitierstilen: Toolname, Version, Datum und ausgeführte Funktion, etwa Suche, Extraktion oder sprachliche Bearbeitung.
- Führen Sie für die eingereichte Bibliografie einen abschließenden DOI-Durchlauf durch. Dieser letzte Durchgang erkennt Copy-and-Paste-Abweichungen und jede Referenz, die das Modell während einer Überarbeitung eingefügt hat.
Ein Prompt, der Jenova innerhalb der Pipeline statt im Chatbot-Modus hält:
„Verfasse den Hintergrundabschnitt ausschließlich anhand der von mir hochgeladenen Kandidatenmenge. Jeder empirische Satz muss eine DOI aus dieser Menge zitieren und darf keine neuen Quellen einführen. Wenn eine Behauptung nicht durch die Extraktionsnotizen gestützt wird, markiere sie als UNSUPPORTED, statt sie zu zitieren.“
Nutzen Sie bei SciSpace oder Elicit die jeweilige Retrieval- oder Extraktionsansicht, um dieselbe Tabelle neu aufzubauen und die Zeilen zu vergleichen. Wenn sich die Tabellen bei einem Ergebnis widersprechen, lesen Sie den PDF-Volltext. Die Uneinigkeit ist günstiger als eine Korrektur nach der Veröffentlichung.
Die Einschränkung, die diese Pipeline wirksam macht, ist ebenso psychologisch wie technisch: Bitten Sie keinen Assistenten, auch keinen starken, jemals darum, „Referenzen bereitzustellen“ für Prosa, die ohne Quellen verfasst wurde. Dieser Prompt verwandelt ein Recherchetool zurück in einen Zitationsgenerator — genau den Fehlermodus, den dieser gesamte Stack verhindern soll.
Referenzen
- Nature — Halluzinierte Zitate verschmutzen die wissenschaftliche Literatur
- Accountability in Research (Resnik & Hosseini) — Von generativer künstlicher Intelligenz erzeugte halluzinierte Zitate
- Stanford Libraries — AI in der akademischen Forschung: Zitierleitlinien
- ACM Digital Library — Korrektheit ist nicht Belegtreue bei Retrieval Augmented Generation
- DeepEval — Metrik zur Belegtreue für RAG-Systeme
- Confident AI — RAG-Bewertungsmetriken: Antwortrelevanz, Belegtreue und kontextuelle Relevanz
- UNC Charlotte Library — Forschungsleitfaden zu AI-halluzinierten Zitaten
- Wiley — AI-Richtlinien für Forschende
- College Board — Besorgnis von Lehrenden, dass die AI-Nutzung durch Studierende die akademische Integrität untergräbt
- Harvard Medical School Academic and Research Integrity — AI in der Forschung
- Cornell Center for Teaching Innovation — AI und akademische Integrität
- SciSpace — Benchmark zum Literaturvergleich von SciSpace, Elicit und Consensus über 200 Suchanfragen
- Paperguide — Vergleich zwischen Elicit und SciSpace
- Paperguide — Vergleich zwischen Elicit und Scite
- Science — Ungesehen zitieren: Wenn AI wissenschaftliche Artikel halluziniert
- SciSpace — Produktvergleich von SciSpace und Elicit