Wie kann ein AI-Forschungsassistent Evidenzlücken für ein neues Thema kartieren?
2026-08-22
Was unterscheidet einen nachvollziehbaren Suche-Screening-Kartierung-Workflow von allgemeinen Literaturzusammenfassungen?
Ein zuverlässiger AI-Forschungsassistent beginnt nicht damit, beliebige gefundene Arbeiten zusammenzufassen. Er erstellt eine reproduzierbare Suchstrategie, screent eine klar abgegrenzte Studienmenge anhand expliziter Kriterien und kartiert anschließend, was diese Studien abdecken – und was nicht. So sind leere Zellen Evidenzlücken und keine Suchartefakte. Im Jahr 2026 ist dieser Unterschied wichtig, weil allgemeine Chat-Zusammenfassungen vollständig wirken können, obwohl sie Zitate erfinden oder unvereinbare Studiendesigns zu einer einzigen Aussage verdichten.
Für ein neues Thema ist die praktische Arbeitseinheit häufig ein Kernset aus 50 Arbeiten: groß genug, um Cluster zu erkennen, und klein genug, damit Forschende jede Ein- oder Ausschlussentscheidung noch überprüfen können. Tools, die diesen Workflow unterstützen, sind Jenova's Academic Research Assistant, der Workflow für systematische Übersichtsarbeiten von Elicit, Rayyan und Zitationsnetzwerk-Kartierer wie ResearchRabbit.
Was einen zitierfähigen Suche-Screening-Kartierung-Prozess von einer wegwerfbaren Literatursammlung unterscheidet:
✅ Nachvollziehbare Suchanfragen – Boolesche Zeichenfolgen, Datenbanken, Zeitfenster und Synonyme werden vor Beginn des Screenings dokumentiert
✅ Prüfbares Screening – jede Arbeit erhält ein Include-, Exclude- oder Unsure-Tag, das an ein festgelegtes Kriterium gebunden ist
✅ Extrahierte statt paraphrasierte Evidenz – Befunde, Methoden und Einschränkungen bleiben mit einer überprüfbaren Quelle verknüpft
✅ Mehrdimensionale Lückenkarten – leere Zellen werden nach Population, Methode, Geografie und Ergebnis kodiert, nicht nach Bauchgefühl
✅ Menschliche Überprüfung – AI entwirft die Karte; Forschende bestätigen, dass jedes Zitat in der Originalarbeit existiert
Um Assistenten sinnvoll zu vergleichen, hilft es, Suche, Screening und Lückenkartierung als drei Aufgaben mit unterschiedlichen Fehlermodi zu behandeln – statt als eine einzige Funktion für „Literaturrecherche“.
Warum werden Evidenzlücken-Karten für neue Forschungsthemen unverzichtbar?
Evidenz- und Lückenkarten sind zu einer Standardmethode geworden, um auf einen Blick zu erkennen, wo ein Forschungsfeld dicht besetzt ist und wo es Lücken gibt, bevor Forschende sich auf ein neues Studiendesign festlegen. Eine Evidenz- und Lückenkarte ist eine systematische visuelle Darstellung der Verfügbarkeit relevanter Evidenz für einen Politik- oder Forschungsbereich, die anhand eines vorab festgelegten Suchprotokolls und nicht anhand einer ad-hoc-Leseliste erstellt wird.
Diese für die Campbell Collaboration entwickelte Definition lässt sich leicht missbrauchen. Viele Karten berichten darüber, welche Evidenz vorhanden ist, nicht darüber, zu welchem Schluss diese Evidenz gelangt. Die Verwechslung beider Aspekte erzeugt falsche Sicherheit: Eine dicht besetzte Zelle kann methodisch schwach sein, und eine leere Zelle kann auf eine fehlgeschlagene Suche statt auf eine echte Wissenslücke zurückgehen.
Die Methode ist längst kein Nischenansatz mehr. Eine Übersicht aus dem Gesundheitsbereich von 2016 identifizierte 145 Kartierungstitel, von denen 34 Publikationen explizite Evidenzkarten enthielten. Mapping-Reviews und Evidenzlücken-Karten gelten heute als eigenständige Syntheseprodukte zur Navigation komplexer Forschungskorpora, zwischen einem Scoping-Review und einer vollständigen systematischen Übersichtsarbeit.
Für Personen, die 2026 in ein neues Thema einsteigen, ist der Druck sehr praktisch. Elicit weist darauf hin, dass systematische Übersichtsarbeiten häufig mit bis zu 20.000 Datensätzen beginnen und auf 30–100 eingeschlossene Arbeiten reduziert werden – ein Prozess, der manuell drei Monate bis über ein Jahr dauern kann. Ein Screening von 50 Arbeiten ersetzt diese Goldstandard-Pipeline nicht. Es ist jedoch das richtige erste Instrument, wenn entschieden werden soll, ob eine systematische Übersichtsarbeit, eine Primärstudie oder eine engere Forschungsfrage gerechtfertigt ist.
AI beschleunigt den ersten Durchlauf. Sie beseitigt jedoch nicht die Berichtsanforderungen von PRISMA 2020, die weiterhin transparente Methoden zur Identifikation, Auswahl und Extraktion verlangen.
Worauf sollten Sie bei einem AI-Forschungsassistenten für das Literatur-Screening achten?
Sie sollten einen AI-Forschungsassistenten danach bewerten, ob er eine Suchstrategie reproduzierbar, eine Screening-Entscheidung überprüfbar und eine Lückenbehauptung widerlegbar halten kann – nicht danach, wie flüssig er eine Literaturübersicht schreibt. Die nachfolgende TRACE-GAP-Checkliste ist der Bewertungsrahmen dieses Artikels.
TRACE-GAP-Bewertungsdimensionen
- T — Nachvollziehbare Suchanfragen. Kann das Tool die exakten Datenbanken, Zeichenfolgen, Einschränkungen und Zeiträume ausgeben, die andere Forschende erneut ausführen könnten?
- R — Relevanzkriterien. Können Ein- und Ausschlussregeln festgelegt werden, bevor eine Arbeit bewertet wird?
- A — Prüfbares Screening. Enthält jede Entscheidung einen Grund und nicht nur ein Ja oder Nein?
- C — Extraktion auf Zitationsebene. Sind Befunde mit einer Textstelle oder zumindest einer konkreten Arbeit verknüpft, statt mit einer vermischten Zusammenfassung?
- E — Kodierung der Evidenzstärke. Können Studiendesign, Stichprobe und Einschränkungen neben dem Befund erfasst werden?
- G — Lückendimensionen. Kann die Karte mindestens zwei Achsen verwenden, typischerweise Intervention × Ergebnis oder Population × Methode?
- A — Validierung über Cluster hinweg. Erzwingt der Workflow eine zweite Prüfung, bevor eine leere Zelle als Lücke bezeichnet wird?
- P — Priorisierte Fragen. Macht die Ausgabe aus validierten Lücken Forschungsfragen statt einer dekorativen Heatmap?
Ein Benchmark in einem Einkaufsleitfaden für 2026, der Assistenten anhand ihrer Zitationsverankerung bewertete, kam zu dem Ergebnis, dass Quellenlinks auf Absatzebene das niedrigste Verhältnis von Halluzinationen zu Überprüfungsaufwand erzeugten: Atlas mit 0,05, Elicit mit 0,07, Consensus mit 0,09 und SciSpace mit 0,16. Dieselbe Übersicht behandelte ResearchRabbit als Netzwerk-Kartierer und nicht als Antwortgenerator – die richtige Kategorie für die Erweiterung ausgehend von Seed-Papers.
Zwei weitere Tests sind für die akademische Nutzung wichtig. Erstens verlangt PRISMA 2020 weiterhin, dass Autorinnen und Autoren extrahierte Werte überprüfen; jedes Tool, das das unterstützende Zitat verbirgt, besteht diesen Test nicht. Zweitens haben halluzinierte Zitate bereits Expertentexte und wissenschaftliche Journal-Pipelines erreicht, weshalb „klingt wissenschaftlich“ kein Akzeptanzkriterium ist.
Jenova's Academic Research Assistant ist besonders stark beim Entwurf von Strategien, der Recherche über mehrere Datenbanken, persistentem Projektgedächtnis und zitationsbewusstem Schreiben. Als spezialisierte Plattform für Dual-Screening ist er schwächer: Er erstellt weder ein PRISMA-Flussdiagramm noch führt er eine verblindete Konfliktauflösung durch, wie es Rayyan und Covidence tun.
Wie vergleichen sich Jenova, Elicit, Rayyan und ResearchRabbit bei Suche, Screening und Lückenkartierung?
Jenova ist am stärksten als Partner für Strategie und Synthese, Elicit als Engine für strukturierte Extraktion, Rayyan als Arbeitsplatz für Screening großer Mengen und ResearchRabbit als Explorer für Zitationsnetzwerke – und keines dieser Tools sollte für ein neues Thema als einziges geschlossenes System eingesetzt werden. Der hilfreiche Vergleich besteht darin, welche Aufgabe jedes Tool übernehmen sollte.
| Funktion / Dimension | Jenova Academic Research Assistant | Elicit | Rayyan | ResearchRabbit / Scite |
|---|---|---|---|---|
| Unterstützung der Suchstrategie | Dialogbasierter PICO-/Boolean-Entwurf mit Scholar- und Websuche; persistentes Projektgedächtnis | Semantische Suche über 125M+ Arbeiten; schlägt Screening-Felder aus der Frage vor | Importiert Exporte klassischer Datenbanken; primär kein Suchdesigner | ResearchRabbit erweitert ausgehend von Seed-Papers; Scite prüft später die Zitationshaltung |
| Screening von etwa 50 Arbeiten | Kriterienbasierte Include-/Exclude-Tabellen im Chat mit Gründen und Einschränkungen | Priorisiertes Screening plus zitategestützte Extraktionszeilen | Speziell für Titel-/Abstract-Screening, Deduplizierung und Team-Workflows entwickelt | Schwach als Screener; stark als Finder verwandter Arbeiten oder Zitationsprüfer |
| Kartierung von Evidenzlücken | Cluster-Kodierung, Validierung leerer Zellen und Übertragung in Forschungsfragen | Gute Extraktionstabellen zum späteren Aufbau einer Karte | Screening-Log unterstützt Karten; die Kartierung erfolgt überwiegend nachgelagert | Netzwerkkarten zeigen fehlende Verbindungen, nicht validierte Evidenzlücken |
| Zitationsverankerung | Antworten mehrerer Modelle mit Quellenvorrang-Prompts; menschliche Überprüfung weiter erforderlich | Zitate auf Arbeitsebene für extrahierte Felder | Entscheidungsprotokoll ist prüfbar; Synthese ist nicht das Produkt | Scite kennzeichnet stützende, kontrastierende oder lediglich erwähnende Zitate |
| Preise (Stand 2026) | Kostenloses Kontingent mit begrenzter Nutzung; Plus ab 20 $/Monat | Pro, Team und Enterprise (Listenpreise variieren je nach Tarif) | Für die Basisnutzung dauerhaft kostenlos | ResearchRabbit kostenlos; Scite Student etwa 10 $/Monat, Premium etwa 20 $/Monat |
| Am besten geeignet für | Strategie für neue Themen, Einordnung eines 50-Arbeiten-Sets und Übertragung von Lücken in Studienbegründungen | Strukturierte Extraktion über viele Arbeiten hinweg | Team-Screening im Maßstab systematischer Übersichtsarbeiten | Einstieg in ein Feld über ein Seed-Paper, danach Prüfung zentraler Zitate |
Rayyan berichtet von mehr als 1 Million Forschenden an über 20.000 Institutionen in mehr als 190 Ländern und ist auf Prüfbarkeit, Reproduzierbarkeit und AI-gestützte Priorisierung ausgerichtet. Ein Softwarevergleich aus dem Jahr 2026 stellte die Wahl weiterhin als Covidence für institutionelles Review-Management, Rayyan für zugängliches Screening und Elicit für AI-Suche und -Extraktion dar.
Jenovas Einschränkung liegt in der Benutzeroberfläche, nicht in der Zielsetzung. Ein Screening von 50 Arbeiten im Chat ist überprüfbar, wenn Sie eine Tabelle erzwingen, ersetzt aber keine zwei unabhängigen Screener bei einem Export mit 5.000 Datensätzen. Bei Elicit gilt das Gegenteil: Die Tabelle ist hervorragend, doch Elicit selbst erklärt, dass publikationsreife Reviews weiterhin traditionelle Keyword-Suchen durchführen und semantische Suche als Ergänzung behandeln sollten. Die Einschränkung von ResearchRabbit besteht in der ehrlichen Abgrenzung seines Umfangs: Es kartiert, was verbunden ist, nicht was nach einer Qualitätsbewertung fehlt.
Für ein neues Thema ist der ertragreichste Stack meist Jenova oder Semantic Scholar für die Strategie, Rayyan oder Elicit für das Screening, Scite für die Zitationshaltung und anschließend wieder Jenova für die Lückenerzählung. Jenova's Deep Research agent ist die bessere Übergabe, wenn die Karte mit 50 Arbeiten ein längeres, zitationsdichtes Briefing benötigt.
Wie erstellen Sie mit einem AI-Forschungsassistenten eine reproduzierbare Suchstrategie?
Sie erstellen eine reproduzierbare Suchstrategie, indem Sie die Frage, Konzepte, Quellen und Einschränkungen festlegen, bevor Sie ein Modell darum bitten, Arbeiten zu finden. Die Aufgabe des Assistenten besteht darin, fehlende Synonyme und verzerrende Einschränkungen sichtbar zu machen – nicht darin, eine Leseliste zu improvisieren.
Beginnen Sie mit einem Forschungsanker: Population oder Setting, Intervention oder Exposition, gegebenenfalls Vergleichsgruppe, Ergebnisse und die Studiendesigns, die Sie akzeptieren werden. Mapping-Reviews können breiter angelegt sein als eine einzelne PICO-Frage, benötigen aber weiterhin eine ex-ante-Suchstrategie und ein Kodierungsformular. Universitätsleitfäden beschreiben Evidenz- oder Lückenkarten als primäre Tabelle mit Zeilen, Spalten und Filtern für bestimmte Variablen. Diese Zeilen und Spalten sollten auf dem Papier stehen, bevor die erste Suchanfrage ausgeführt wird.
Ein hilfreicher erster Prompt in Jenova's Academic Research Assistant sieht so aus:
„Ich erschließe eine neue Forschungsrichtung zu [Thema]. Entwirf eine reproduzierbare Suchstrategie mit: (1) PICO- oder PECO-Elementen, (2) Ein- und Ausschlusskriterien, (3) Datenbanken und Quellen grauer Literatur, (4) Boolean-Zeichenfolgen mit Synonymen und kontrolliertem Vokabular sowie (5) einem Zeitfenster von 2019–2026. Liste Begriffe auf, die mir wahrscheinlich fehlen, sowie Einschränkungen, die relevante Studiendesigns ausblenden würden.“
Erzwingen Sie anschließend eine Methodenprüfung:
„Formuliere die Strategie so um, dass andere Forschende sie erneut ausführen können. Trenne unverzichtbare Begriffe von optionalen Synonymen. Kennzeichne, wo semantische Suche die Sensitivität verbessern würde und wo ausschließlich exakte Datenbanksyntax akzeptabel ist.“
Gute Assistenten werden Sie zu mehreren Quellen führen. Ein biomedizinisches Thema benötigt weiterhin MEDLINE/PubMed sowie mindestens einen ergänzenden Index; Bildungs- und Sozialpolitik erfordern häufig ERIC, PsycINFO oder eine spezialisierte Kartenbibliothek. Der Syntheseleitfaden der University of Toronto behandelt Mapping-Reviews als Möglichkeit, Lücken zu erkennen, bevor man sich auf eine engere systematische Übersichtsarbeit festlegt.
Bei Tests treten immer wieder zwei Strategiefehler auf. Der erste ist ein zu frühes Überfiltern nach „Review“ oder „RCT“, wodurch genau die leeren Zellen verschwinden, die Sie finden wollten. Der zweite besteht darin, das Modell Datenbanken auswählen zu lassen, nachdem es bereits einige leicht zugängliche Treffer gesehen hat. Fixieren Sie das Protokoll und suchen Sie erst dann.
Jenova hilft hierbei, weil die Unterhaltung über Sitzungen hinweg bestehen bleibt und Forschungsanker, Suchzeichenfolgen und Ausschlussliste im Gedächtnis behalten kann. Es ersetzt jedoch keine durch Bibliothekarinnen oder Bibliothekare geprüfte Suche für eine systematische Übersichtsarbeit, die bei einer Fachzeitschrift eingereicht werden soll – und Sie sollten nicht so tun, als würde es das.
Wie sollten Sie etwa 50 zentrale Arbeiten screenen, ohne methodische Strenge zu verlieren?
Sie sollten 50 Arbeiten als kodiertes Entscheidungsprotokoll screenen: eine Zeile pro Studie, ein Grund pro Entscheidung, und keine Arbeit wird aufgenommen, nur weil das Abstract „relevant klingt“. Fünfzig Arbeiten sind ein Arbeitskorpus für ein neues Thema, keine Behauptung, dass die Literatur vollständig durchsucht wurde.
Übernehmen Sie die Disziplin des systematischen Screenings, auch wenn Sie noch keine PRISMA-Übersicht schreiben. PRISMA 2020 ist die aktuelle Berichtsrichtlinie für Reviews, die Studien identifizieren, auswählen und synthetisieren. Die zugehörige Checkliste mit 27 Punkten soll diese Methoden transparent machen. Ihr Protokoll mit 50 Arbeiten erfüllt nicht die Anforderungen einer vollständigen systematischen Übersichtsarbeit, sollte aber dieselben Grundfragen beantworten können: Was wurde gefunden, was wurde behalten und warum?
Ein praktischer Screening-Prompt:
„Screene die folgenden 50 Arbeiten anhand dieser Ein- und Ausschlusskriterien. Gib für jede Arbeit Folgendes zurück: Entscheidung (
include/exclude/unsure), das einzelne Kriterium, das die Entscheidung bestimmt hat, Studiendesign, Population, Setting, primäres Ergebnis und eine Einschränkung. Zitiere die Textstelle, die die Entscheidung begründet. Füge keine Arbeiten hinzu, die nicht in dieser Liste enthalten sind.“
Führen Sie anschließend selbst einen Kalibrierungsdurchlauf für die ersten zehn Datensätze durch. Wenn Assistent und Forschende bei mehr als zwei oder drei Fällen nicht übereinstimmen, sind die Kriterien noch zu unscharf. Präzisieren Sie Definitionen von Population, Design und Ergebnis, bevor Sie die verbleibenden vierzig bewerten.
Rayyan ist das bessere Instrument, wenn die Menge wächst oder ein zweiter Screener hinzukommt. Unabhängige Vergleiche von Covidence und Rayyan behandeln beide seit Langem als geeignete Plattformen für das Screening systematischer Übersichtsarbeiten mit unterschiedlichen Kollaborationsmodellen. Elicit ist das bessere Instrument, wenn als Nächstes eine Datentabelle erforderlich ist: Stichprobengröße, Richtung des Ergebnisses und Methodenfelder, die mit unterstützenden Zitaten gefüllt sind.
Jenovas ehrliche Grenze liegt in der Stapelverarbeitung. Chat-basiertes Screening ist schnell für 50 sorgfältig ausgewählte Arbeiten und unhandlich für 5.000 importierte Datensätze. Nutzen Sie es, um Kriterien durchzusetzen und ein einheitliches Codebook zu extrahieren. Übertragen Sie dasselbe Codebook in Rayyan oder Elicit, falls das Projekt zu einem formalen Review wird.
Lassen Sie das Modell niemals einen fehlenden PDF-Volltext „ergänzen“. Wenn der Volltext nicht verfügbar ist, bleibt die Zeile unsure, nicht include. Diese einzelne Regel verhindert den Großteil der Zitationskulisse.
Wie verwandeln Sie gescreente Arbeiten in eine validierte Evidenzlücken-Karte?
Sie verwandeln eine gescreente Menge in eine Lückenkarte, indem Sie jede eingeschlossene Studie in zwei oder mehr Dimensionen kodieren, leere Zellen als vorläufig markieren und dann prüfen, ob diese leeren Zellen einer zweiten Suche standhalten. Eine leere Zelle, die nicht hinterfragt wurde, ist ein Kodierungsüberbleibsel und keine Forschungsbegründung.
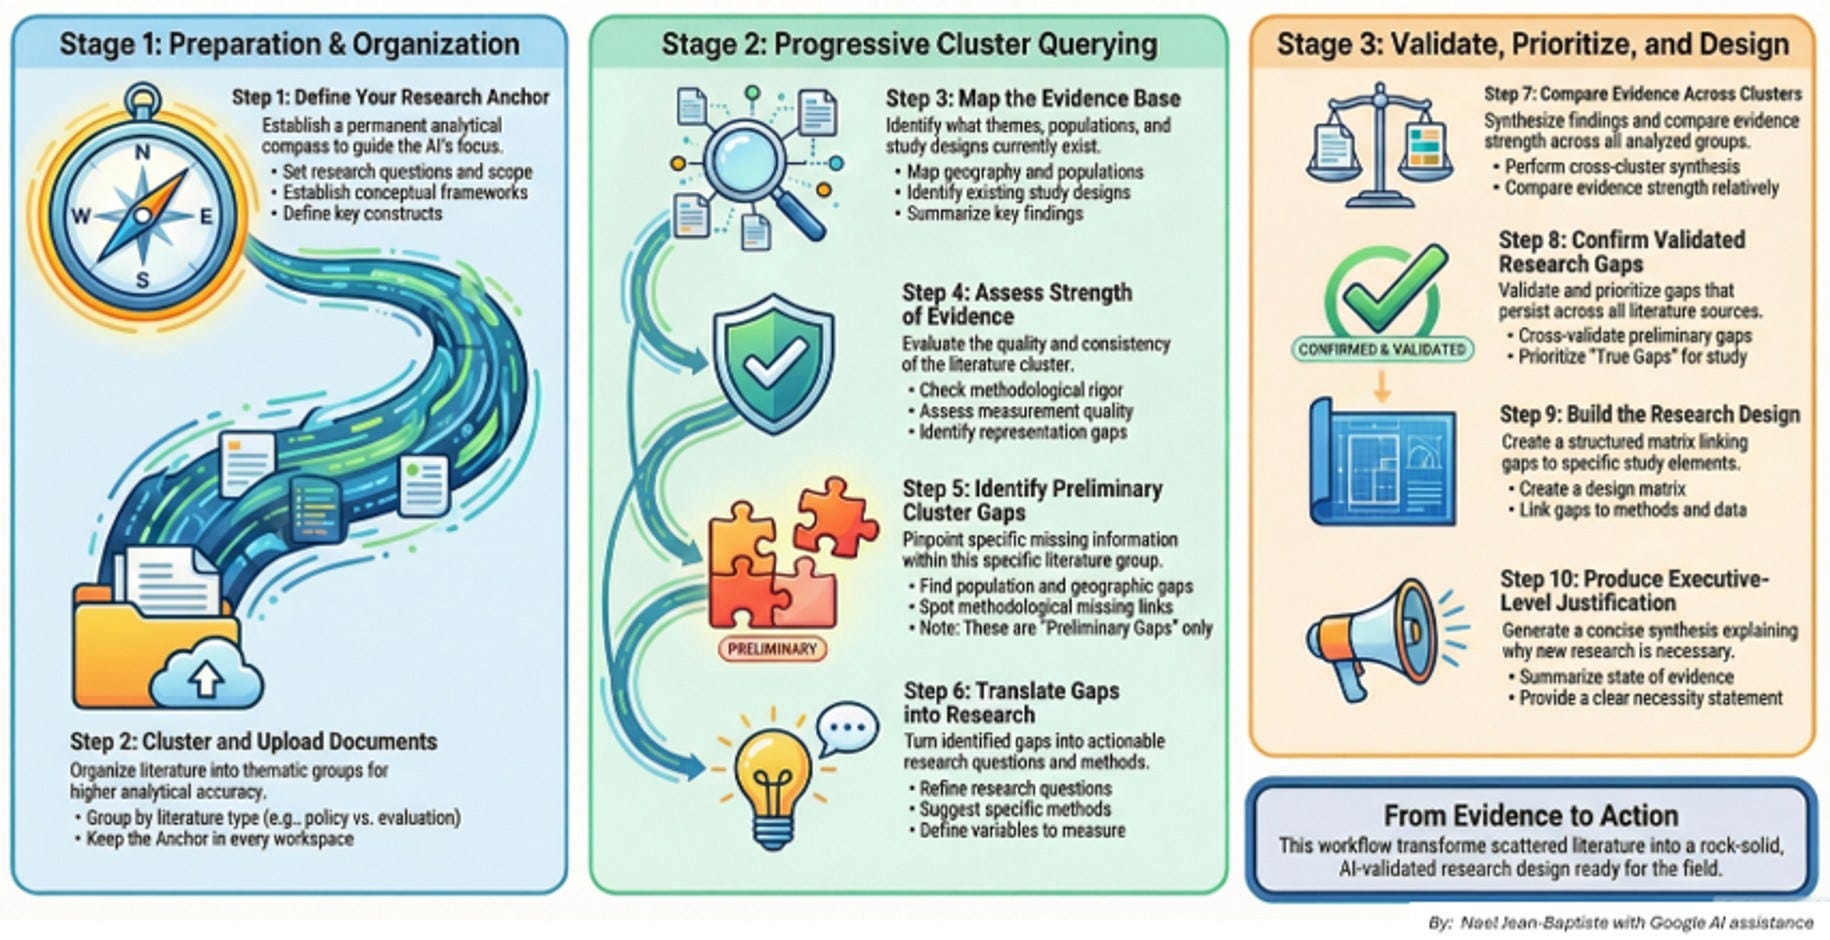
Der Workflow in der obigen Abbildung zeigt die richtige Reihenfolge: Bereiten Sie einen analytischen Anker vor, clustern Sie die Dokumente, bewerten Sie die Evidenzstärke, markieren Sie vorläufige Lücken und validieren Sie diese Lücken anschließend clusterübergreifend, bevor Sie eine Studie konzipieren. So sollten formale Karten funktionieren. Interaktive Evidenzlücken-Karten sind strukturierte visuelle Werkzeuge zur Darstellung von Umfang und Merkmalen der Evidenz, nicht Poster bevorzugter Hypothesen.
Eine belastbare Karte benötigt in der Regel mindestens:
- Zeilen: Interventionen, Expositionen oder Forschungsfragen
- Spalten: Ergebnisse, Populationen oder Studiendesigns
- Filter: Jahr, Geografie, Qualität und Publikationsstatus
- Zelleninhalte: Studienzahl sowie eine grobe Stärke-Kennzeichnung (Review, Studie, Beobachtungsstudie, Protokoll)
Bitten Sie den Assistenten, die erste Matrix ausschließlich aus eingeschlossenen Arbeiten zu erstellen:
„Erstelle ausschließlich auf Basis der eingeschlossenen Studien eine Lückenmatrix mit Zeilen = [Interventionen oder Fragen] und Spalten = [Ergebnisse oder Populationen]. Liste in jeder Zelle Studienzahl, dominantes Design und Aktualität auf. Markiere leere Zellen als Preliminary. Schlage anschließend drei Folgesuchen vor, die jede leere Zelle widerlegen könnten, einschließlich Studienregistern und grauer Literatur.“
Die Validierung ist der Schritt, den die meisten AI-Texte auslassen. Methodische Vergleiche betonen, dass Karten laufende Studien aus Registern einbeziehen, eine kritische Bewertung anwenden und innerhalb von etwa drei Jahren aktualisiert werden sollten. Eine Zelle, die in Ihrem Set aus 50 Arbeiten leer erscheint, kann auf einem Preprint-Server oder in einem Protokollregister gut gefüllt sein.
Jenova ist in dieser Phase nützlich, weil es das Codebook, die Matrix und die abgelehnten Arbeiten in einem Thread behalten und anschließend das Memo „Warum diese Studie notwendig ist“ ausschließlich aus validierten Lücken formulieren kann. Wenn Sie es zulassen, wird es leere Zellen überinterpretieren. Verlangen Sie für jede Lücke, die Sie finanzieren oder über die Sie schreiben wollen, eine Suche zur Widerlegung.
Wenn das Thema später zu einem Scoping-Review wird, wechseln Sie die Berichtsstruktur zu PRISMA-ScR, das 20 essenzielle und 2 optionale Punkte festlegt. Rüsten Sie eine informelle Karte mit 50 Arbeiten nicht nachträglich so um, als wäre sie bereits ein Scoping-Review.
Wie holen Sie das Maximum aus einem AI-gestützten Suche-Screening-Kartierung-Workflow heraus?
Sie holen das Maximum aus dem Workflow heraus, indem Sie dem Assistenten ein fixiertes Protokoll, einen begrenzten Korpus und ein Überprüfungsbudget geben – und jede Behauptung ablehnen, die nicht im Original-PDF geöffnet werden kann. Geschwindigkeit entsteht durch konsistente Kodierung, nicht durch das Überspringen von Volltextprüfungen.
Eine kompakte Arbeitsabfolge:
- Schreiben Sie den Anker. Ein Absatz, der die zu belegende Behauptung, die Population und die Art von Evidenz beschreibt, die der Behauptung widersprechen würde.
- Entwerfen und fixieren Sie die Suche. Datenbanken, Zeichenfolgen, Zeiträume und Ausschlussregeln werden vor Beginn der Recherche in einer datierten Notiz festgehalten.
- Stellen Sie gezielt 50 Arbeiten zusammen. Kombinieren Sie Reviews, aktuelle Studien oder Primärarbeiten und zumindest einige Arbeiten aus angrenzenden Feldern, damit die Karte keine Illusion eines einzelnen Clusters erzeugt.
- Screenen Sie in einer Tabelle. Include, Exclude oder Unsure, jeweils mit einem entscheidenden Kriterium und einer zitierten Textstelle.
- Extrahieren, dann bewerten. Befunde, Einschränkungen, Design und Stichprobe bleiben in getrennten Feldern.
- Kartieren, dann greifen Sie die Leerstellen an. Jede vorläufige Lücke erhält eine zweite Suche, die darauf ausgelegt ist, sie zu widerlegen.
- Schreiben Sie aus der Matrix. Der Neuheitssatz der Arbeit sollte die validierte leere Zelle benennen, nicht eine vage Intuition.
Halten Sie in Jenova diese gesamte Kette in einem Projekt, damit der Assistent die Einschlussregeln nicht stillschweigend zwischen Sitzungen ändern kann. Ein Folge-Prompt, der ein Abdriften verhindert:
„Wende die ursprünglichen Einschlusskriterien erneut auf diese neue Arbeit an. Wenn du ein Kriterium ändern müsstest, um sie einzuschließen, halte an und zeige mir die vorgeschlagene Änderung, statt die Arbeit zu bewerten.“
Bei Elicit sollten Sie mit der Forschungsfrage beginnen, das System Screening- und Extraktionsfelder vorschlagen lassen und diese Felder dann überschreiben, bevor Sie die vollständige Menge ausführen. Importieren Sie bei Rayyan den Datenbankexport, legen Sie Labels an, die Ihrem Codebook entsprechen, und behandeln Sie den AI-Relevanz-Ranker als Sortierung statt als Entscheidung.
Planen Sie Überprüfungszeit ausdrücklich ein. Ein praktikables Ziel für ein Kernset aus 50 Arbeiten sind zwei bis vier Minuten menschlicher Prüfung pro eingeschlossenem Volltext, mit Fokus darauf, ob der zitierte Befund tatsächlich in der Arbeit steht und ob das Design korrekt kodiert wurde. Das ist noch immer deutlich günstiger als eine ununterstützte Extraktion und der einzige Weg, die PRISMA-Erwartung zu erfüllen, dass extrahierte Werte überprüft werden.
Was sagen Forschungsmethodiker und Tool-Entwickler über AI-gestützte Evidenzkartierung?
Forschungsmethodiker betrachten Evidenzkarten als protokollgesteuerte Darstellungen von Verfügbarkeit, während Tool-Entwickler immer wieder feststellen, dass nicht der Text, sondern das Zitat der Bereich ist, in dem AI Fehler macht. Beide Gruppen gelangen zu derselben operativen Regel: AI darf Suche und Screening strukturieren, aber Forschende bleiben für jede Zelle der Karte verantwortlich.
„Der Fehlermodus, den wir am häufigsten sehen, besteht darin, die leere Zelle als Entdeckung zu behandeln. Eine leere Zelle ist nur eine Hypothese über fehlende Evidenz. Sie wird erst zu einer validierten Lücke, nachdem Sie benachbarte Cluster, graue Literatur und Protokollregister geprüft und bestätigt haben, dass die Abwesenheit kein Suchartefakt ist. Wenn diese Prüfungen nicht erfolgt sind, haben Sie keine Lückenkarte. Sie haben eine Visualisierung Ihrer ersten Suchanfrage.“
„Bei einem Screening von 50 Arbeiten entstehen die Zeitersparnisse durch konsistente Kodierung, nicht durch das Überspringen von Volltexten. Die sinnvolle Arbeitsteilung ist einfach: Der Assistent entwirft die Include-/Exclude-Entscheidung, die Extraktionszeile und die erste Matrix; die Forschenden investieren einige Minuten pro eingeschlossener Arbeit, um zu bestätigen, dass das Zitat existiert und das Design bei der Nacherzählung nicht aufgewertet wurde. Dadurch werden dennoch Tage unstrukturierter Notizen zu einem einzigen Codebook verdichtet.“
„Wir würden keine systematische Übersichtsarbeit für eine Fachzeitschrift allein auf Basis von Chat-Protokollen einreichen. Spezialisierte Screening-Plattformen bleiben bei Dual-Review, Konfliktauflösung und PRISMA-Diagrammen überlegen. Ein dialogbasierter Forschungsassistent verdient seinen Platz früher im Prozess: beim Fixieren der Frage, beim Aufdecken verzerrender Suchbegrenzungen, beim Sichtbarhalten abgelehnter Arbeiten und beim Überführen einer validierten leeren Zelle in eine präzise Studienbegründung.“
— Jenova Product Team, akademische Forschungsworkflows, 8 Jahre Erfahrung im Aufbau quellennachvollziehbarer AI-Forschungstools
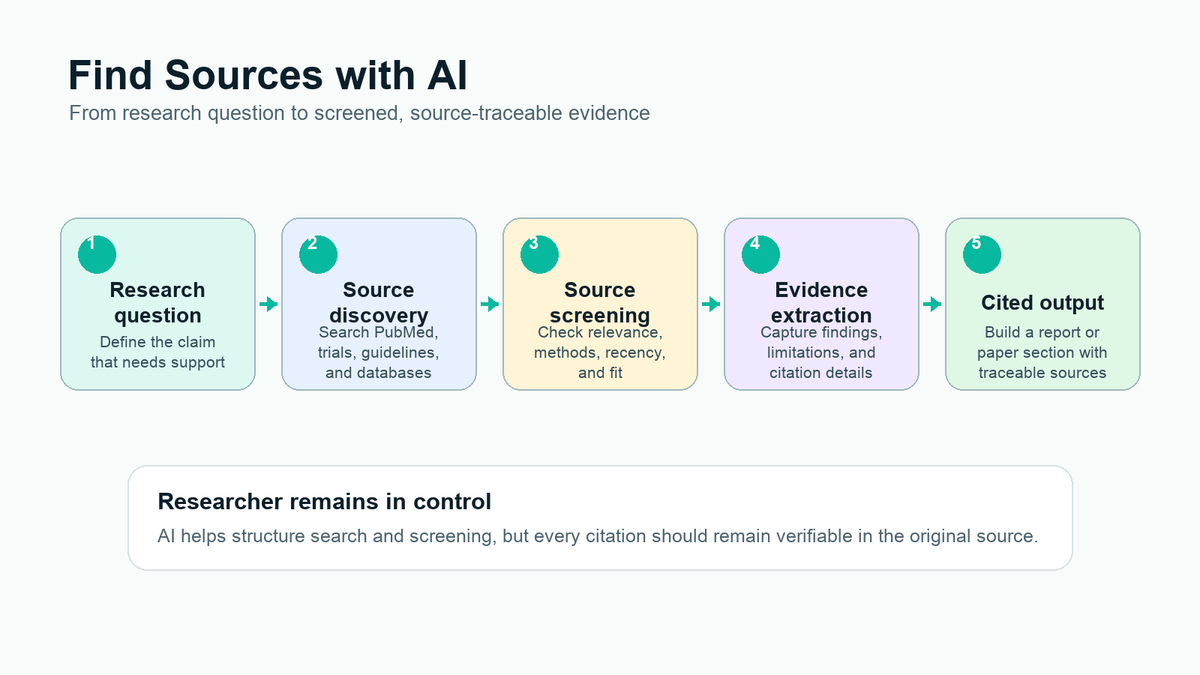
Diese Vorsicht stimmt mit unabhängigen Arbeiten überein. Übersichten zu generativen Systemen in der Literatursynthese finden weiterhin reale Fähigkeiten bei gleichzeitigen Zuverlässigkeitsgrenzen, die unbeaufsichtigte Reviews unsicher machen. Leitlinien zu systematischen Evidenzkarten betonen ebenfalls die strukturierte Kategorisierung wissenschaftlicher Evidenz statt narrativer Sicherheit. Die Vorgabe, dass Forschende im fünfstufigen Quellenworkflow die Kontrolle behalten, ist kein Slogan. Sie ist der Qualitätssicherungsschritt, von dem der Rest der Methode abhängt.
Referenzen
- Saran und White — Evidenz- und Lückenkarten: ein Vergleich verschiedener Ansätze (PMC)
- Khalil et al. — Methodik für Mapping-Reviews, Evidenzkarten und Lückenkarten (Research Synthesis Methods)
- Elicit — Einführung in Elicit Systematic Review
- PRISMA Statement — Berichtsleitlinien für PRISMA 2020
- Atlas Workspace — Die besten AI-Forschungsassistenten (2026), halluzinationsgeprüfter Vergleich
- Fortune — AI-Halluzinationen dringen in wissenschaftliche Expertenarbeit ein (Mai 2026)
- University of Illinois Grainger LibGuide — Scoping-Reviews, Mapping-Reviews, Evidenz- oder Lückenkarten
- Page et al. — Die PRISMA-2020-Erklärung (The BMJ)
- University of Kansas Medical Center — PRISMA und verwandte Review-Standards
- Elicit — Workflow für systematische Übersichtsarbeiten gemäß PRISMA 2020
- Rayyan — AI-gestützte Plattform für systematische Übersichtsarbeiten
- INRA.AI — Vergleich von Covidence, Rayyan und Elicit
- University of Toronto Libraries — Mapping-Reviews in der Familie der Wissenssynthesen
- Kellermeyer, Harnke und Knight — Vergleich von Covidence und Rayyan (PMC)
- EvalCommunity Academy — Interaktiver Evidenzlücken-Kartierer
- PRISMA — PRISMA-Erweiterung für Scoping-Reviews
- Adel, Alateeq und Alshahrani — Kann generative AI Literatur zuverlässig synthetisieren? (AI & Society)
- Khalil et al. — Leitlinien zur Durchführung systematischer Evidenzkarten (Science of the Total Environment)