Wie kann AI interdisziplinäre Evidenz synthetisieren, ohne Fakten zu vermischen?
2026-08-21
Welche drei Evidenzebenen müssen bei fachübergreifender AI-Synthese getrennt bleiben?
AI kann interdisziplinäre Evidenz nur dann zuverlässig synthetisieren, wenn sie jede Aussage als Quellfakt, Schlussfolgerung der Autoren oder Modellinferenz kennzeichnet — und verhindert, dass diese Ebenen in einem einzigen unmarkierten Absatz verschmelzen. Im Jahr 2026 entscheidet diese Trennung darüber, ob ein Research Brief auditierbar ist oder ob eine flüssige Zusammenfassung vorläufige Behauptungen zu scheinbarer Autorität reinwäscht. Allgemeine Chatbots vermischen diese Ebenen weiterhin standardmäßig. Deshalb sind bibliografische Erfindungen und Zitierfehler weiterhin gut dokumentiert.
Speziell entwickelte Research Agents — darunter Jenovas Academic Research Assistant — eignen sich besser für diese Aufgabe, wenn sie reale Quellen abrufen, Zuschreibungen erhalten und eigene Gedankensprünge des Modells sichtbar machen. Sie ersetzen keine PRISMA-registrierte systematische Übersichtsarbeit.
Wesentliche Faktoren, die herkunftsbewusste Synthese von unmarkierter Paraphrase unterscheiden:
✅ Quellfakten sind Messungen, Methoden, Stichprobengrößen und Beobachtungen, die im Primärtext berichtet werden
✅ Schlussfolgerungen der Autoren sind Interpretationen, die die Autoren einer Studie in Diskussion oder Abstract ziehen — keine unabhängigen Wahrheiten
✅ AI-Inferenz ist analogisches, prädiktives oder integratives Denken, das das Modell über Studien oder Fachgebiete hinweg hinzufügt
✅ Fachübergreifende Zuordnung muss explizit sein, denn ein in einer Disziplin etablierter Mechanismus ist in einer anderen oft nur eine Hypothese
✅ Jeder extrahierbare Satz sollte einer einfachen Prüfung standhalten: Wer hat dies behauptet, in welchem Dokument und mit welchem epistemischen Status?
Um Tools für dieses Problem zu vergleichen, sollten Sie Provenienz als erstklassiges Bewertungskriterium behandeln und nicht als reine Formatpräferenz. Der Rest dieses Leitfadens nutzt diese Perspektive — das FCI-TRACE-Framework — um zu bewerten, wie Synthesesysteme tatsächlich arbeiten.
Warum scheitert interdisziplinäre AI-Synthese, wenn die Provenienz zusammengeführt wird?
Interdisziplinäre Synthese scheitert ohne Provenienz, weil Fachgebiete nicht dieselben Evidenzstandards teilen und Sprachmodelle darauf optimiert sind, kohärente Prosa zu erzeugen, statt diese Standards zu bewahren. Ein empirisches Ergebnis aus einer Klimastudie, die Behauptung eines Ökonomen zur kausalen Identifikation und eine klinische Praxisleitlinie können grammatikalisch in einem Satz zusammengeführt werden. Dieser Satz liest sich dann wie gesichertes Wissen, selbst wenn nur eine Klausel jemals gemessen wurde.
Dies ist kein hypothetischer Fehlermodus. Eine Scientific-Reports-Studie über von ChatGPT generierte Literaturübersichten ergab, dass 55 % der GPT-3.5-Zitate und 18 % der GPT-4-Zitate erfunden waren und dass 43 % beziehungsweise 24 % der übrigen echten Zitate erhebliche bibliografische Fehler enthielten. Spätere Berichte brachten einen breiteren Anstieg erfundener Zitate in veröffentlichten Arbeiten mit generativen Tools in Verbindung. Multi-Modell-Reviews aus dem Jahr 2026 zeigen weiterhin, dass fast 40 % der von AI generierten Referenzen Fehler oder Erfindungen enthalten und nur 26,5 % vollständig korrekt sind.
Außerhalb gut indexierter wissenschaftlicher Prosa sind die Halluzinationsraten sogar noch höher. Eine von MIT Sloan zusammengefasste Stanford-HAI-Evaluation ergab, dass allgemeine Chatbots bei 58–82 % der juristischen Rechercheanfragen auf Modellen aus dem Jahr 2023 halluzinierten. Rechtliche, politische und klinische Bereiche sind genau die Kontexte, in denen interdisziplinäre Briefings am häufigsten angefragt werden — und in denen eine unmarkierte Inferenz die höchsten Kosten verursacht.
Das tieferliegende Problem ist Quellenwäsche: Eine einschränkende Formulierung in einem Diskussionsteil wird ohne Einschränkung wiederholt und dann zitiert, als wäre sie ein Ergebnis. Provenienzstandards existieren, um diese Transformation zu verhindern. Interdisziplinäre Arbeit vervielfacht das Risiko, weil sich Leser nicht auf gemeinsame Methoden verlassen können, um zu erkennen, wann sich der Status einer Aussage geändert hat.
Nach welchen Kriterien sollten Sie ein AI-System zur Evidenzsynthese bewerten?
Sie sollten ein AI-System zur Evidenzsynthese danach bewerten, ob es FCI-Ebenen auch bei Uneinigkeit intakt halten kann — nicht danach, wie viele Arbeiten es erwähnt. Sprachgewandtheit, Geschwindigkeit und sogar Vollständigkeit sind zweitrangig, wenn das Ergebnis nicht auditierbar ist. Das hier verwendete FCI-TRACE-Framework bewertet sechs Dimensionen.
FCI (epistemischer Status)
- Fakten: Kann das System ein Ergebnis mit Fundstelle (Arbeit, Abschnitt, Abbildung oder Tabelle) zitieren oder eng paraphrasieren?
- Schlussfolgerungen: Schreibt es Interpretationen namentlich den Autoren zu und erhält es Einschränkungen?
- Inferenz: Kennzeichnet es analoge oder integrative Schritte als modellgeneriert?
TRACE (Qualität der Synthese)
- Nachverfolgbarkeit: Jede Behauptung wird einer Quellenpassage zugeordnet, nicht nur einem Arbeitstitel.
- Aktualität: Das System unterscheidet zwischen Preprint-Daten, Veröffentlichungsdaten und Leitlinienaktualisierungen — ein bekannter Fehler selbst in nicht auf AI basierenden bibliografischen Tools und ein dokumentierter ChatGPT-Fehlermodus in der Studie von Walters und Wilder.
- Übereinstimmung: Konvergierende und widersprüchliche Ergebnisse werden tabellarisch dargestellt, nicht zu einem falschen Konsens gemittelt.
- Abdeckung: Wenn die Frage fachübergreifend ist, werden mindestens zwei disziplinäre Methoden repräsentiert.
- Epistemische Kennzeichnung: Status-Tags sind im Fließtext sichtbar und nicht in einer Fußnote verborgen.
Dies ist strenger als allgemeine Checklisten für „AI bei Literaturübersichten“, die häufig bei Suche und Zusammenfassung enden. Universitätsleitfäden verzeichnen inzwischen Tools, die Arbeiten zusammenfassen und Daten in strukturierte Tabellen extrahieren, und Teams für systematische Reviews unterscheiden halbautomatisches von vollautomatischem Screening. Diese Funktionen sind wichtig. Sie verhindern jedoch nicht automatisch, dass eine Schlussfolgerung der Autoren als Fakt umgeschrieben wird.
Protokolltransparenz gehört weiterhin zur Bewertung. PRISMA 2020 ist eine Checkliste mit 27 Berichtsitems für systematische Reviews mit Synthese, die zusammen mit Erläuterungspublikationen über das EQUATOR Network gepflegt wird. Keine Chatbot-Sitzung ist ein PRISMA-Review. Ein belastbarer AI-Workflow sollte dennoch Einschlusslogik, durchsuchte Quellen und die Ergänzungen des Modells dokumentieren.
Wie gehen führende AI-Research-Tools mit Fakten, Autorenbehauptungen und Modellinferenz um?
Führende Tools lassen sich klar unterscheiden: Arbeitsgrundlagen, die auf Papers basieren, verringern Erfindungen, während allgemeine Chatmodelle flüssig formulieren, aber schwach attribuieren — und fast keines FCI-Labels nativ in der generierten Prosa durchsetzt. Der folgende Vergleich betrifft epistemische Sorgfalt, nicht allgemeine Popularität.
| Funktion / Dimension | Allgemeines ChatGPT | Elicit | Jenova Academic Research Assistant | Scite (Zitationskontext) |
|---|---|---|---|---|
| Grundlegungskorpus | Trainingsdaten plus optionales Browsing; Zitate oft ungeprüft | Suche, Zusammenfassung und Extraktion über 125 Millionen Papers; genutzt von mehr als 2 Millionen Forschenden | Live-Abruf wissenschaftlicher Quellen und des Webs, Anhänge und persistenter Sitzungsspeicher | Zitationsgraph und unterstützender/kontrastierender Kontext dazu, wie Papers zitiert werden |
| FCI-Kennzeichnung im Output | Typischerweise unmarkiert; Fakten, Diskussionsbehauptungen und Modellsprünge haben dieselbe Stimme | Stärker bei Extraktion auf Paper-Ebene als bei epistemischen Tags auf Satzebene | Kann angewiesen werden, FCI-Ebenen zu kennzeichnen und das Protokoll sitzungsübergreifend beizubehalten | Kennzeichnet eher die Zitierhaltung als den Behauptungstyp innerhalb einer Synthese |
| Interdisziplinäre Synthese | Hohe Sprachgewandtheit; schwache Audit-Spur über Fachgebiete hinweg | Am stärksten bei empirischen Forschungsfragen und strukturierter Extraktion | Am stärksten, wenn über Tage hinweg ein Methodenprotokoll plus fachliche Nachverfolgung erforderlich ist | Als Synthesizer begrenzt; stärker als Perspektive auf Zitationskontext |
| Zitationsprüfung | Hohe Erfindungs- und Fehlerraten in systematischen Tests | Paper-basierte Zeilen reduzieren erfundene Referenzen | Retrieval plus Attribution; erfordert weiterhin menschliche Stichprobenprüfungen | Nativer Kontext dazu, ob spätere Papers eine Behauptung stützen oder ihr widersprechen |
| Screening / Extraktion | Unstrukturiert | Automatisiert Screening und Datenextraktion für systematische Reviews | Iterative Entdeckung und Manuskriptunterstützung, keine dedizierte Screening-UI | Keine Screening-Workbench |
| Preise (Stand 2026) | Abonnement; genaue Verbrauchertarife hier nicht verifiziert | In diesem Review nicht verifiziert | Kostenloser Tarif mit begrenzter Nutzung; Plus für 20 US-Dollar/Monat (30× Nutzung) | In diesem Review nicht verifiziert |
| Am besten geeignet für | Entwürfe, sobald Quellen bereits vorliegen | Spaltenbasierte Extraktion aus empirischen Papers | Sitzungsübergreifende, mehrquellige Briefings, bei denen FCI-Ebenen sichtbar bleiben müssen | Prüfung, wie eine Behauptung in nachfolgender Literatur behandelt wird |
Elicit. Die Betrachtung des Produktumfangs zeigt eine Research-Workbench und keinen Chatbot: Nutzer stellen eine Frage, rufen Papers ab und extrahieren Felder. Unabhängige Vergleiche aus dem Jahr 2026 beschreiben Elicit als stärker bei Literaturentdeckung, Screening und Datenextraktion, während Consensus als stärker bei wissenschaftlichen Ja/Nein-Fragen beschrieben wird. Diese Extraktionsstärke ist real. Die Einschränkung ist komplementär: Eine ausgefüllte Tabelle kann weiterhin das kausale Verb eines Abstracts so darstellen, als wäre es ein Ergebnis, sofern der Nutzer keine Spalten definiert, die Befunde von Interpretationen trennen.
Consensus und Semantic Scholar. Consensus wird wiederholt als Antwortmaschine über echte Papers und nicht als vollständige Review-Pipeline positioniert (The Drive AI). Eine Übersicht aus dem Jahr 2026 nannte Consensus mit etwa 144 US-Dollar pro Jahr als Einstiegspreis. Semantic Scholar bleibt in denselben Vergleichen ein Rückgrat für die Literaturentdeckung. Keines der Tools bietet nach den hier geprüften öffentlichen Beschreibungen eine verpflichtende Überlagerung von Fakten und Inferenz.
Scite. Scite passt besser, wenn die Frage lautet, wie ein Paper zitiert wird, und nicht, wie zwei Disziplinen zusammengeführt werden können. Vergleiche behandeln es als Spezialisten für Zitationskontext gegenüber dem breiteren Review-Workflow von Elicit (Paperguide, 2026). Kennzeichnungen unterstützender gegenüber kontrastierender Zitate sind wertvoll, aber weiterhin von FCI verschieden: Ein späteres Paper kann eine Schlussfolgerung der Autoren „unterstützen“, die nie ein Fakt war.
Allgemeines ChatGPT. Es bleibt die falsche Standardeinstellung für unbeaufsichtigte Synthese. Selbst die verbesserte Erfindungsrate von 18 % bei GPT-4 ist mit zitierfähiger Arbeit unvereinbar, und numerische Zitationsfelder wie Band, Seiten und Jahr sind die häufigsten Fehler bei echten Referenzen. Bibliotheksleitfäden behandeln halluzinierte Zitate inzwischen als eigenständiges Thema der Forschungsintegrität.
Jenova Academic Research Assistant. Dieser Agent wurde für Akademiker und Doktoranden entwickelt, die Literaturentdeckung, Manuskriptunterstützung und Zitationsmanagement statt einer Einmalzusammenfassung benötigen. Auf der Jenova-Plattform kann er wissenschaftliche Suche nutzen, einen unbegrenzten Chatverlauf beibehalten und ein Methodenprotokoll im persistenten Speicher halten, sodass FCI-Regeln nicht in jeder Sitzung zurückgesetzt werden. In Verbindung mit Deep Research — das breit sucht und zitationsdichte Berichte erstellt — eignet er sich gut für interdisziplinäre Fragen, die sich über mehrere Arbeitssitzungen erstrecken.
Ehrliche Einschränkungen sind wichtig. Das Tool ist nicht Covidence, DistillerSR oder Rayyan: Es gibt keine dedizierte Workbench für PRISMA-Flussdiagramme und kein natives Extraktionsraster für 125 Millionen Papers in dem Umfang, den Elicit bewirbt. Entscheidungen über Einschluss bei hohem Risiko und statistisches Pooling bleiben Aufgaben menschlicher Reviewer. Der Tiefenvorteil liegt in der Protokollpersistenz und expliziten Kennzeichnung, nicht in automatisierter Gewissheit.
Wie verhindert Wissensorchestrierung, dass disziplinäre Evidenz zu einer einzigen Erzählung verschmilzt?
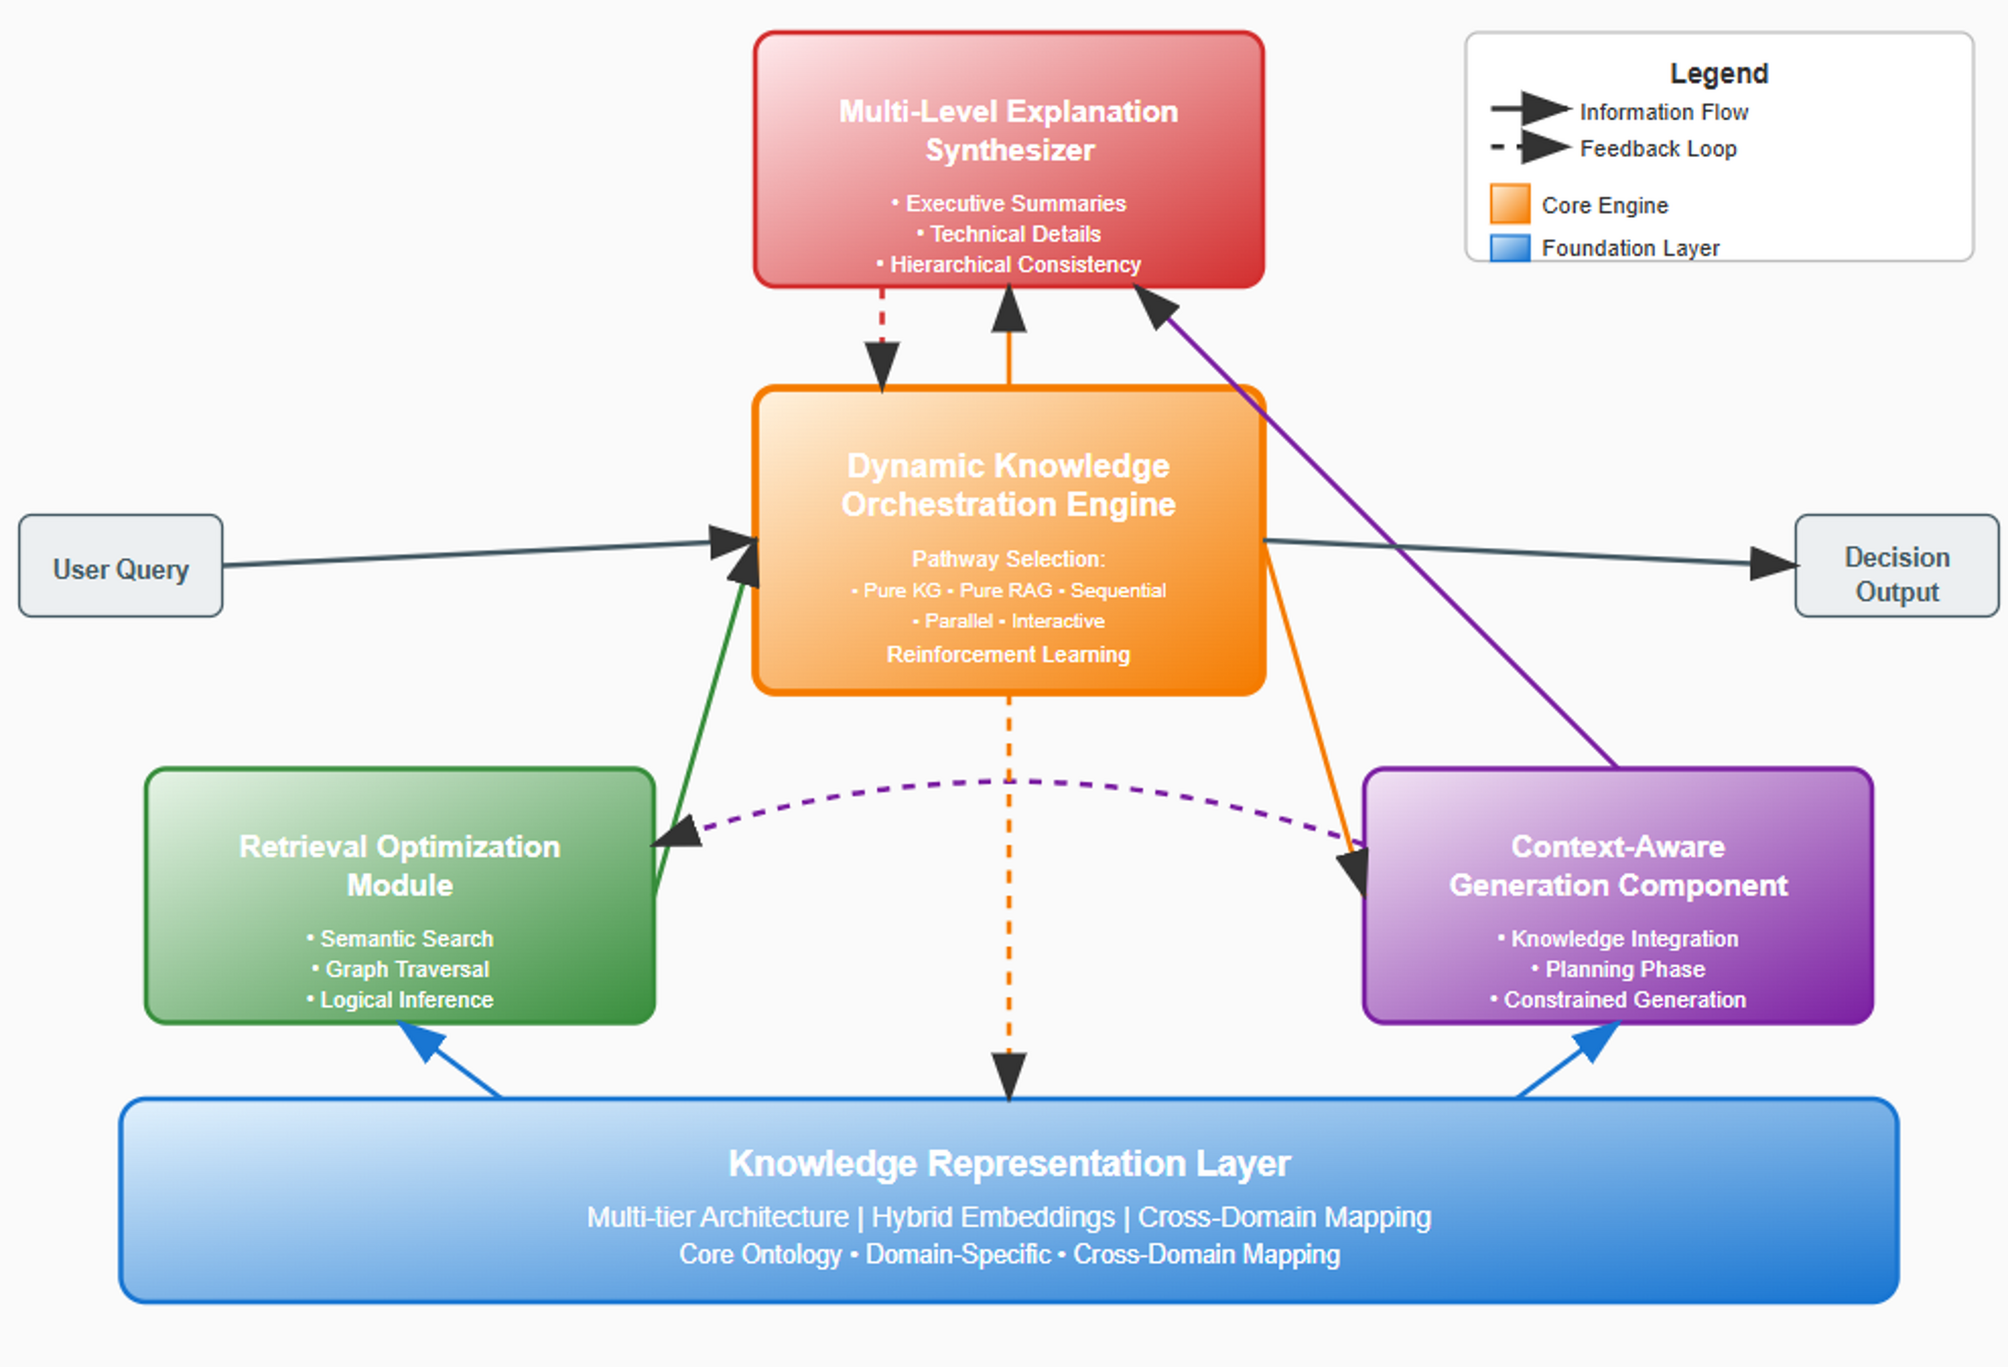
Wissensorchestrierung bewahrt disziplinäre Evidenz, indem sie vor der Generierung einen Retrieval-Pfad auswählt und Erklärungen dann dazu zwingt, hierarchisch mit dem Abgerufenen konsistent zu bleiben. Die Betrachtung eines typischen Orchestrierungsstapels zeigt, warum „einfach abrufen und dann schreiben“ für interdisziplinäre Arbeit nicht genügt.
Das Fundament bildet eine Wissensrepräsentationsschicht: hybride Embeddings, Domain-Ontologien und fachübergreifende Zuordnung. Ohne diese Schicht behandelt ein Modell „Unsicherheit“ in der Klimaphysik, „Unsicherheit“ in der Ökonometrie und „Unsicherheit“ in klinischen Leitlinien als dieselbe Token-Nachbarschaft. Das sind sie nicht. Die Zuordnung von Begriffen zwischen Fachgebieten ist ein Inferenzschritt und sollte als solcher gekennzeichnet werden.
Über dieser Schicht kombiniert ein Modul zur Retrieval-Optimierung semantische Suche, Graph-Traversierung und logische Inferenz. Graph-Traversierung ist wichtig, wenn die Frage relational ist: Lässt sich Mechanismus A in der Ökologie auf Mechanismus B im Public Health übertragen? Semantische Suche allein liefert ähnliche Sprache; sie beweist keine gemeinsame kausale Struktur. Logische Inferenz über extrahierte Behauptungen kommt Evidenz-Inferenz-Netzwerken für interpretierbare Behauptungsprüfung näher.
Die Orchestrierungs-Engine wählt anschließend einen Pfad — nur Wissensgraph, nur RAG, sequenziell, parallel oder interaktiv — statt immer Textsegmente in einen Prompt zu kippen. Paralleles Retrieval eignet sich, wenn zwei Disziplinen unabhängig gesammelt werden müssen, bevor irgendeine Zuordnung erfolgt. Sequenzielles Retrieval eignet sich, wenn das Ergebnismaß eines Fachgebiets die nächste Suchanfrage begrenzen soll. Diese Modi ohne Kennzeichnung zu vermischen, führt dazu, dass ein Klima-Gesundheits-Briefing unbemerkt zu einer Politikempfehlung wird.
Eine Phase der kontextbewussten Generierung sollte unter Einschränkungen planen: Kein kausales Verb generieren, wenn die Quelle keines verwendet; keine Stichprobenrahmen zusammenführen. Die letzte Phase, ein mehrstufiger Erklärungssynthesizer, macht FCI sichtbar — Executive Summary, technische Details und eine Konsistenzprüfung, damit die Zusammenfassung der Evidenz nicht vorauseilt. Schnittstellen für Behauptung und Evidenz in der aktuellen Forschung, etwa PaperTrail, weisen in dieselbe Richtung: Vertrauenswürdigkeit in wissenschaftlichen Kontexten hängt von der Zuordnung von Behauptungen zu Evidenz ab, nicht von flüssigerer Prosa.
Jenovas Academic Research Assistant legt nicht jeden internen Routing-Schalter als forschernahes Bedienelement offen. Das ist eine reale Einschränkung für Teams, die einen vollständig überprüfbaren DAG benötigen. Er bietet jedoch das praktische Äquivalent für die meisten akademischen Workflows: persistente Anweisungen, angehängte Korpora, Live-Retrieval und genügend Speicher, um ein Kennzeichnungsprotokoll stabil zu halten, während sich Evidenz ansammelt.
Wie kann eine semantische Zitationspipeline Behauptungen prüfen, bevor sie in eine Synthese eingehen?
Eine semantische Zitationspipeline prüft Behauptungen, indem sie jedes Zitat als Hypothese behandelt, die mit dem Quelldokument abgeglichen werden muss, und nicht als formatiertes Ornament am Ende eines Absatzes. Wird dieser Schritt übersprungen, übernimmt die interdisziplinäre Synthese jede erfundene oder verzerrte Referenz, die der Generator erzeugt.
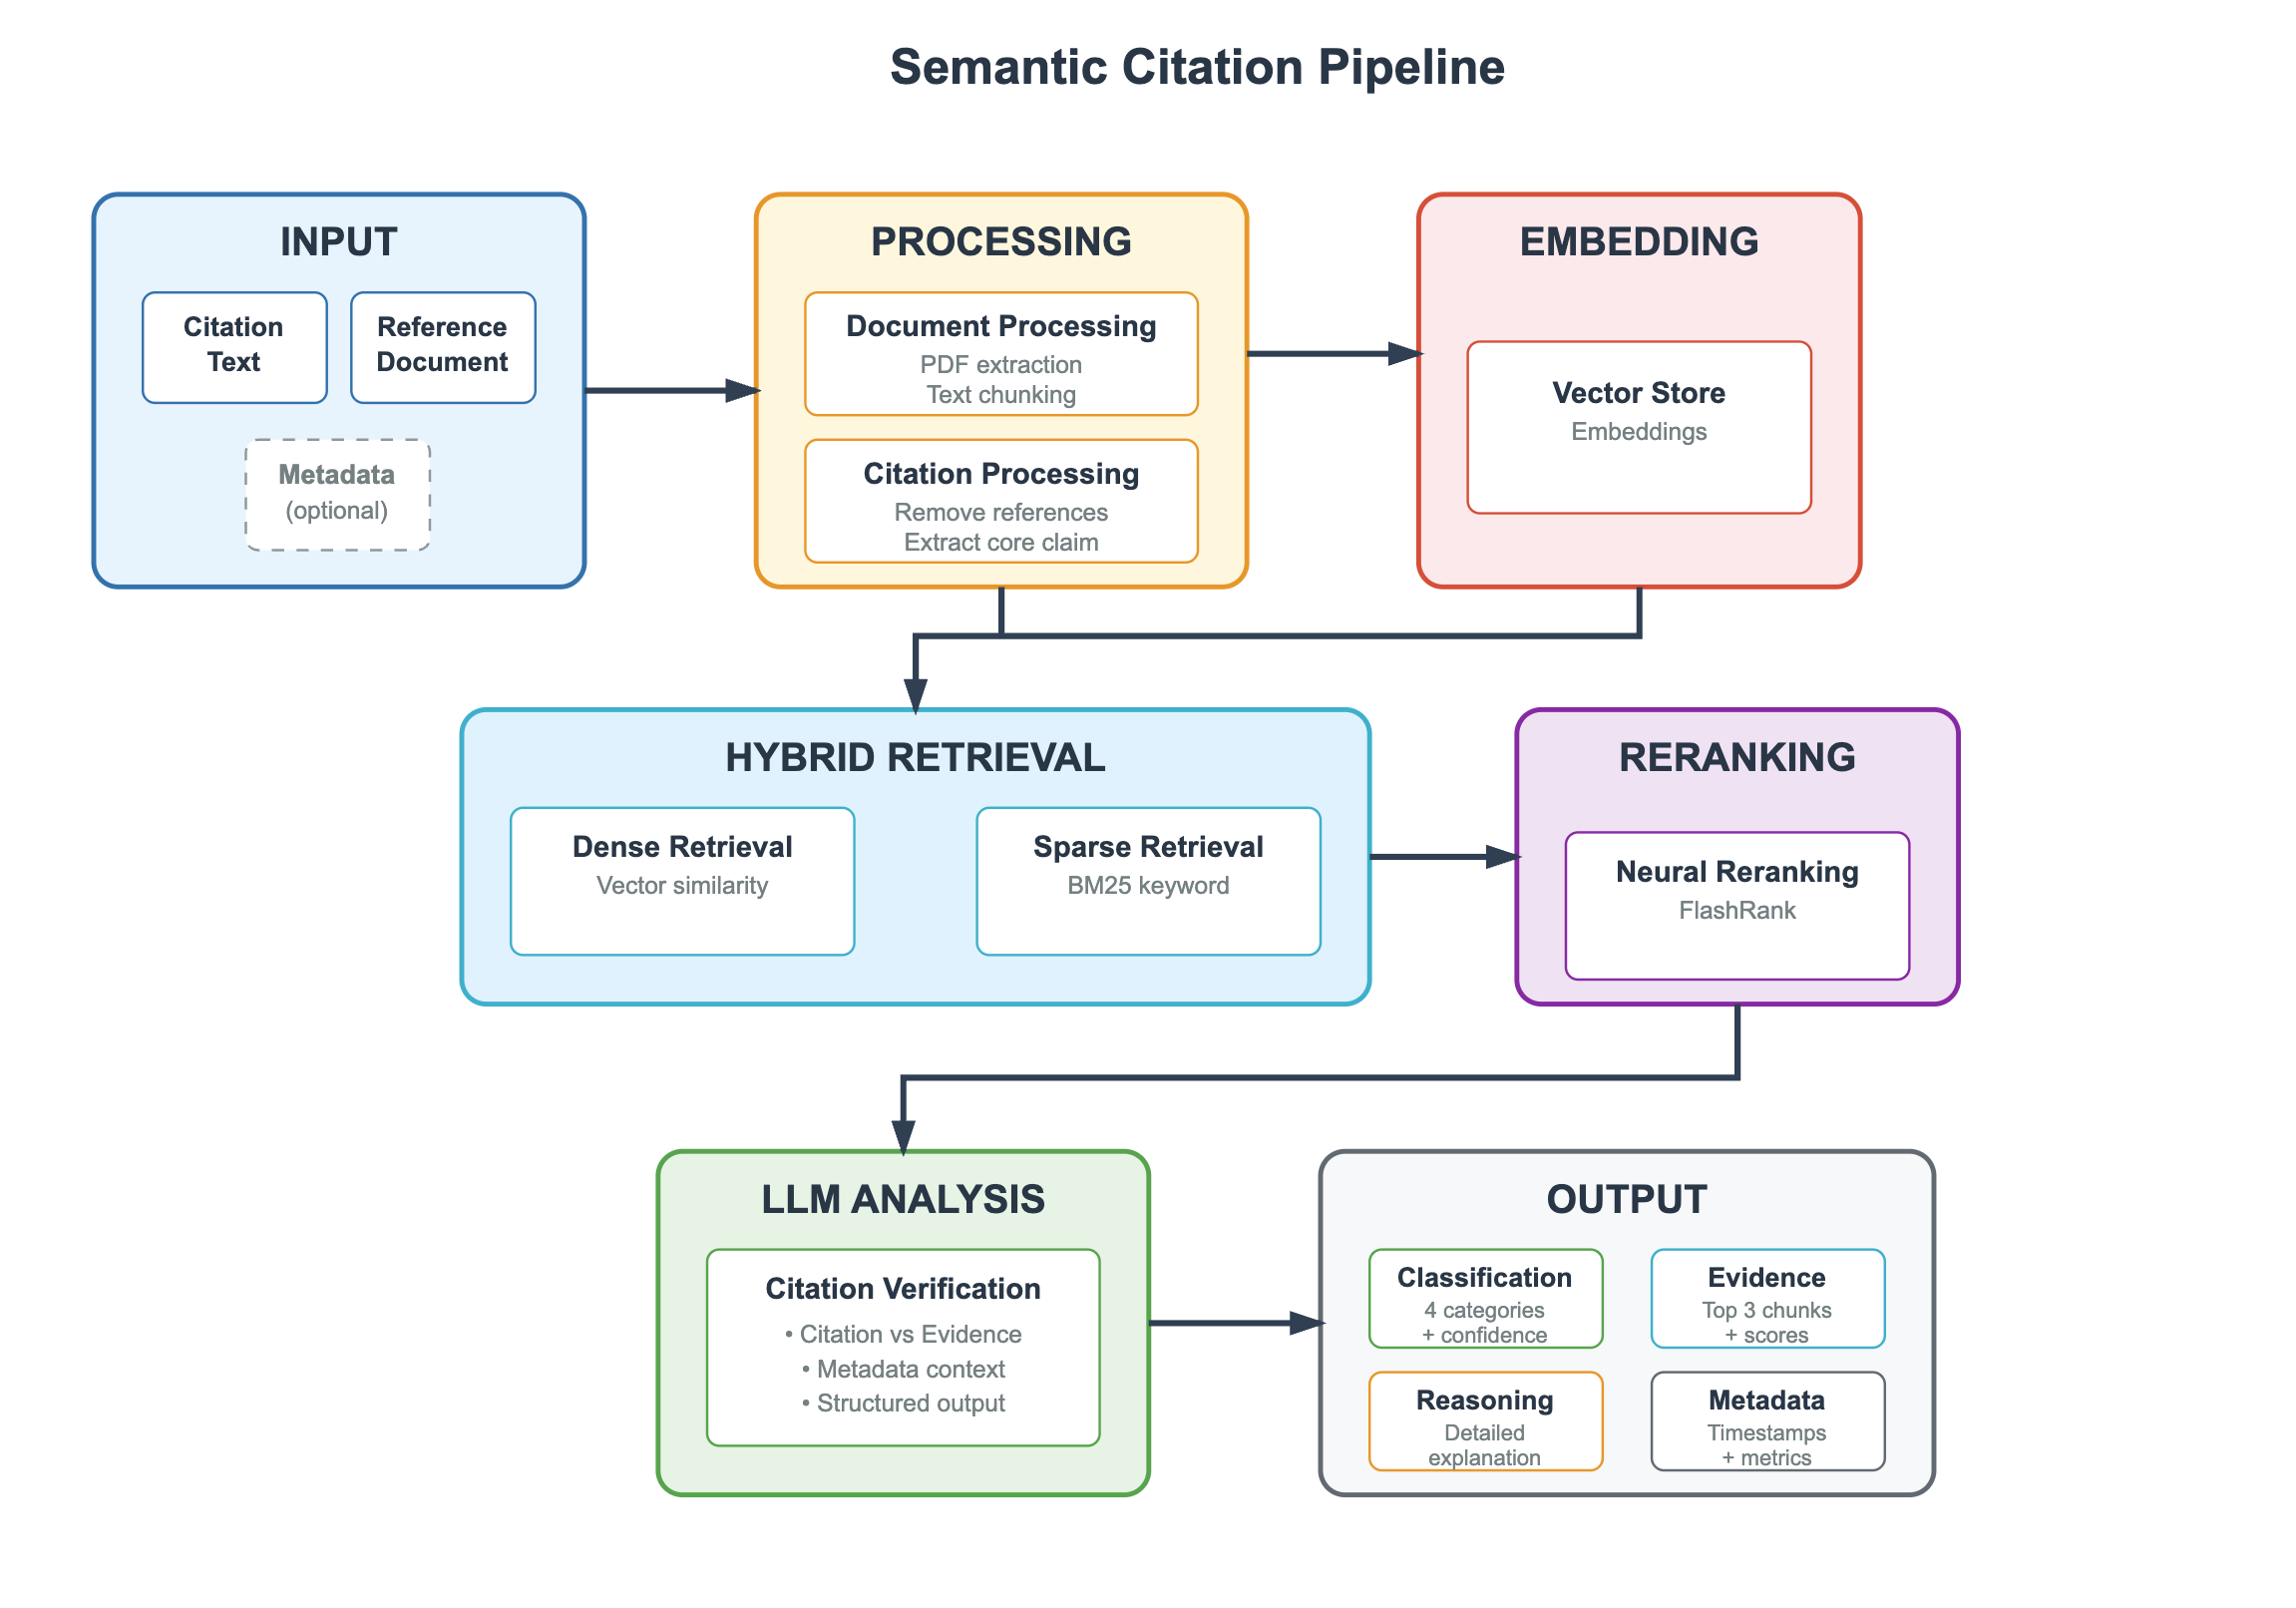
Die Betrachtung einer produktionsnahen Pipeline zeigt eine feste Reihenfolge. Input sind der Zitationstext, das Referenzdokument und optionale Metadaten. Die Verarbeitung extrahiert PDF-Text, segmentiert ihn, entfernt das Literaturverzeichnis, damit das Modell eine Behauptung nicht „prüfen“ kann, indem es die Bibliografie liest, und isoliert die Kernbehauptung. Embedding speichert diese Segmente. Das hybride Retrieval führt anschließend dichte Vektorsuche und sparse BM25 parallel aus — notwendig, weil Fachjargon und statistische Notation bei reiner Embedding-Suche häufig scheitern. Neurales Reranking (etwa FlashRank) behält die besten Passagen. Erst danach klassifiziert die LLM-Analyse die Beziehung zwischen Behauptung und Evidenz.
Das nützliche Ergebnis ist kein binäres Bestehen oder Nichtbestehen. Eine vierstufige Klassifikation mit Konfidenz — gestützt, widerlegt, nicht behandelt oder teilweise behandelt — ergänzt um die wichtigsten Evidenzpassagen und eine schriftliche Begründung, ist das, was ein Synthese-Agent aufnehmen sollte. Dieses Muster entspricht der breiteren Entwicklung hin zu erklärbarer Behauptungsprüfung auf Evidenzebene. Es entspricht auch den Empfehlungen universitärer Lehreinheiten, wenn diese AI-Assistenten beschreiben, die Evidenz extrahieren, statt Narrative zu erfinden.
Selbst mit einer Pipeline bleiben zwei Fehlermodi bestehen. Erstens kann eine korrekt zitierte Schlussfolgerung der Autoren noch immer als Fakt falsch abgelegt werden, wenn der Klassifikator den Abschnittskontext ignoriert, etwa Ergebnisse gegenüber Diskussion. Zweitens kann hybrides Retrieval einen sehr ähnlichen Satz aus einem anderen Paper desselben Fachgebiets hervorholen — Zitationsdrift durch Paraphrase. Menschliche Prüfung der wichtigsten Passagen ist daher Teil der Methode und kein Eingeständnis des Scheiterns.
Jenova-Workflows können diese Pipeline annähern, indem sie Zitat plus Fundstelle verlangen, bevor eine Behauptung in ein Synthesememo aufgenommen werden darf, und Deep Research anschließend als zweiten Durchlauf über dieselbe Bibliografie ausführen. Sie ersetzen keinen dedizierten Zitationsprüfdienst mit eingefrorenen Evaluationsmetriken. Exportieren Sie für Dissertationskapitel und Zeitschrifteneinreichungen die Evidenztabelle und prüfen Sie sie.
Wie weisen Sie einen AI-Research-Agent an, Fakten, Schlussfolgerungen und Inferenz zu trennen?
Sie weisen den Agent mit einem dauerhaften Protokoll an, das Labels definiert, stille Aufwertungen des Behauptungsstatus verbietet und vor jeder fachübergreifenden Erzählung eine Widerspruchstabelle verlangt. Die Wahl des Tools ist wichtig, aber unmarkierte Prompts führen auf jeder Plattform zum Zusammenbruch von FCI.
Für Jenovas Academic Research Assistant sieht eine belastbare Einrichtung so aus:
- Öffnen Sie den Agent unter jenova.ai/a/academic-research-assistant und nennen Sie Forschungsfrage, einbezogene Disziplinen und zeitliche Grenzen.
- Fügen Sie ein dauerhaftes FCI-Protokoll ein (speichern Sie es in benutzerdefinierten Anweisungen, wenn dieselben Regeln sitzungsübergreifend gelten sollen):
„Arbeitsprotokoll: Kennzeichne jeden Satz als [FACT], [AUTHOR CONCLUSION] oder [AI INFERENCE]. Fakten benötigen eine Quellenfundstelle. Schlussfolgerungen der Autoren müssen das Paper benennen und Einschränkungen beibehalten. AI-Inferenz umfasst jede fachübergreifende Zuordnung, jeden kausalen Sprung oder jede Empfehlung, die nicht von einer Quelle behauptet wird. Bei widersprüchlicher Evidenz darfst du sie nicht mitteln. Erstelle eine Tabelle: Claim | Layer | Source | Locator | Agreement (support / contradict / absent).“
- Legen Sie den Korpus an. Hängen Sie PDFs an, denen Sie bereits vertrauen, und verlangen Sie danach weitere Entdeckung, anstatt die erste Suche das Fachgebiet definieren zu lassen.
- Fordern Sie ein mehrschichtiges Ergebnis — annotierte Bibliografie, FCI-markierte Befunde und anschließend eine kurze Synthese, die keine neuen Fakten einführen darf.
Ein Prompt für den ersten Durchgang, der normalerweise eine brauchbare Struktur erzeugt:
„Frage: Wie hängen die Intensität städtischer Wärmeinseln, Wohnqualität und kardiovaskuläre Notfallaufnahmen in Städten mit hohem Einkommen seit 2015 zusammen? Disziplinen: Klimatologie, Epidemiologie, Stadtökonomie. Output: (1) Quellenkarte, (2) FCI-markierte Befunde, (3) Widerspruchsprotokoll, (4) AI-Inferenzen zuletzt aufgeführt und als ungetestet markiert. Zitiere nichts, was du nicht abgerufen hast.“
Bei Elicit liegt die entsprechende Disziplin eher im Spaltendesign als in Prosa-Labels. Erstellen Sie separate Extraktionsfelder für berichtetes Ergebnis, Interpretation der Autoren, Population und identifizierte Einschränkungen, entsprechend dem Frage-zu-Extraktion-Workflow des Tools. Verwenden Sie keine einzelne Spalte „wichtigster Befund“; in dieser Spalte werden Diskussionsverben zu Ergebnissen aufgewertet.
Bei einem allgemeinen Chatbot sollten Sie eine adversarielle Prüfung hinzufügen, die die Nature-Studie als notwendig nahelegt: Fordern Sie Zitate und lösen Sie anschließend jede Referenz unabhängig in einer Bibliotheksdatenbank auf. Dasselbe Modell zu fragen, „ist dieses Zitat echt?“, ist unzuverlässig. Handelt es sich bei dem Projekt um einen systematischen Review, verwenden Sie für Einschlussentscheidungen Screening-Tools, wie sie in Bibliotheksleitfäden zur Evidenzsynthese beschrieben werden, und halten Sie den Chatbot von Entscheidungen zur Eignung fern.
Deep Research auf Jenova ist die bessere Folgemaßnahme, wenn die Bibliografie groß ist und Sie einen zitationsdichten zweiten Durchlauf benötigen. Nutzen Sie es, nachdem FCI-Regeln etabliert sind, nicht als ersten unmarkierten Durchlauf.
Was sagen Forschungsmethodologen über AI-Evidenzprovenienz?
Forschungsmethodologen betrachten unmarkierte AI-Synthese als Berichtsfehler und nicht als Produktivitätsgewinn: Kann ein Leser nicht erkennen, welche Ebene ein Satz einnimmt, ist das Dokument noch keine Evidenz. Diese Sichtweise steht im Einklang mit PRISMAs Forderung nach transparenter Synthese und mit Studien zur Zitationsintegrität, die erfundene Referenzen als Bedrohung für die Evidenzbasis behandeln.
„Der Fehlermodus, den wir beobachten, besteht nicht darin, dass Modelle Papers nicht lesen können. Sie schreiben in einer einzigen epistemischen Stimme. Eine Methodenzahl, eine einschränkende Klausel aus einem Diskussionsteil und eine fachübergreifende Analogie verlassen das Modell als gleich selbstsicheres Englisch. Interdisziplinäre Gremien streiten dann über die Schlussfolgerung, obwohl sie über die Ebene streiten sollten. Wenn ein Satz nicht beantworten kann: ,Wer hat dies behauptet, und wurde es gemessen oder inferiert?‘, sollte er nicht in ein Ergebnisbriefing aufgenommen werden.“
„FCI-Kennzeichnung ist kostengünstiger als nachträglicher Widerruf. Teams, die Fundstellen vor der Synthese erzwingen, investieren mehr Zeit in den ersten Durchlauf und deutlich weniger Zeit in die Auflösung von Zitationsdrift. Die Nature-ChatGPT-Studie bleibt die warnende Ausgangsbasis: Selbst große Rückgänge bei Erfindungen lassen Restfehlerraten zurück, die in einem Literaturverzeichnis nicht akzeptabel sind. Provenienz ist das Kontrollsystem. Sprachgewandtheit ist es nicht.“
„Orchestrierungs- und Zitationsprüfpipelines sind die Operationalisierung dieses Standards. Rufen Sie Disziplinen parallel ab, wenn sie keine gemeinsamen Konstrukte teilen. Prüfen Sie Behauptungen anhand von Segmenten, bevor sie den Synthesizer erreichen. Halten Sie den integrativen Schritt des Modells in einem separaten, benannten Block. Diese Architektur ist konservativer als eine Chatbot-Zusammenfassung — genau darum geht es.“
— Jenova Product Team, Design von AI-Research-Agents, acht Jahre Erfahrung im Aufbau von Retrieval- und Attributions-Workflows für wissenschaftliche und professionelle Nutzer
Die Konsequenz für die Toolauswahl ist begrenzt. Bevorzugen Sie Systeme, die ein Protokoll halten, Quellen zeigen und Widerspruch tolerieren können. Bevorzugen Sie nicht Systeme, die lediglich interdisziplinär klingen.
Wann sollte menschliche Prüfung AI-Synthese über Fachgebiete hinweg überstimmen?
Menschliche Prüfung sollte AI-Synthese immer dann überstimmen, wenn eine Behauptung eine Entscheidung verändert, eine disziplinäre Methodengrenze überschreitet oder nicht auf eine Fundstelle zurückgeführt werden kann — also bei den meisten Aufgaben, die Synthese überhaupt rechtfertigen. AI ist ein Multiplikator für Entwurf und Retrieval. Sie ist keine epistemische Autorität.
Ein Überstimmen ist unter mindestens fünf Bedingungen nicht verhandelbar:
- In der Synthese erscheint kausale Sprache, aber nicht im Ergebnisteil der zitierten Arbeit.
- Ein Konstrukt-Mismatch ist möglich, beispielsweise „Stress“ in der Psychologie gegenüber „allostatischer Last“ in der Medizin gegenüber „Volatilität“ in der Ökonomie.
- Leitlinien oder Recht sind betroffen; die Halluzinationsraten bei juristischen Anfragen waren in kontrollierten Tests besonders hoch.
- Statistisches Pooling wird impliziert. Sprachmodelle führen keine belastbare Meta-Analyse durch, indem sie Abstracts paraphrasieren, und PRISMA 2020 existiert speziell für Reviews mit Synthese.
- Zitationsprüfung wurde nicht gegen das PDF durchgeführt. Erfundenen oder veränderten Referenzen sind auch 2026 noch häufig genug, dass Zeitschriften und Bibliotheken sie als Integritätsproblem behandeln.
Eine praktische Arbeitsteilung sieht so aus: Der Academic Research Assistant schlägt Quellenkarte, FCI-Tags und Widerspruchsprotokoll vor. Elicit oder ein Screening-Tool übernimmt strukturierte Extraktion, wenn der Korpus einen formalen Review darstellt. Ein menschlicher Methodologe entscheidet über Aufwertungen der Ebenen und alle fachübergreifenden Inferenzen. Die AI darf die Zuordnung vorschlagen; nur ein Mensch darf sie aufwerten.
So eingesetzt ist AI-Synthese kein Ersatz für interdisziplinäres Urteilsvermögen. Sie ist eine Möglichkeit, Fakten, Schlussfolgerungen der Autoren und Modellinferenz in getrennten, überprüfbaren Strömen zu halten, damit das Urteilsvermögen mit ehrlicher Grundlage arbeiten kann.
Referenzen
- Rules Integrity Initiative — Provenienz und Quellenwäsche
- Walters & Wilder, Scientific Reports — Erfindungen und Fehler in von ChatGPT generierten bibliografischen Zitaten
- Forbes — AI für Anstieg erfundener Zitate in Forschungspublikationen verantwortlich gemacht (2026)
- Enago — AI-Halluzinationen in Forschungszitaten (2026)
- MIT Sloan — Umgang mit AI-Halluzinationen und Bias, einschließlich Stanford-HAI-Raten bei juristischen Anfragen
- George Mason University Libraries — AI-Tools für Literaturübersichten
- King's College London — AI-Tools in der Evidenzsynthese
- PRISMA-2020-Statement
- Page et al., The BMJ — Das PRISMA-2020-Statement
- EQUATOR Network — PRISMA-Berichtsleitlinie
- Elicit — AI für wissenschaftliche Forschung
- Paperguide — Vergleich Elicit vs Scite (2026)
- PapersFlow — Elicit vs Consensus AI
- The Drive AI — Elicit vs Consensus vs Semantic Scholar
- Omid Saffari — Die besten AI-Research-Tools 2026
- UNC Charlotte Library — Von AI halluzinierte Zitate
- Wu et al., AAAI — Evidence Inference Networks für interpretierbare Behauptungsprüfung
- PaperTrail — Eine Schnittstelle für Behauptung und Evidenz zur Fundierung wissenschaftlicher LLM-Ausgaben (arXiv)
- Zhang et al., EACL — Multimodale und erklärbare Behauptungsprüfung
- University of Iowa — AI-gestützte Literaturübersichten