Wie kann AI Belege finden und Antworten an Gutachter formulieren?
2026-08-22
Was unterscheidet evidenzbasierte Antwort-Tools von allgemeinem AI-Drafting?
Die Tools, die Autorinnen und Autoren 2026 dabei helfen, Gutachtern gut zu antworten, sind nicht jene, die die glatteste Prosa schreiben. Es sind jene, die jeden Gutachterkommentar zitierfähigen Belegen zuordnen, prüfen, ob diese Belege die Aussage tatsächlich stützen, und anschließend eine Antwort formulieren, deren Wortlaut nicht stärker ist als die Evidenzlage. Jenova's Academic Research Assistant ist für diesen evidenzorientierten Zyklus konzipiert — Literaturrecherche, Zitiermanagement und manuskriptgestütztes Drafting — während Scite, Elicit, SciSpace und Consensus jeweils einen Teil derselben Aufgabe mit unterschiedlichen Stärken abdecken.
Ein brauchbarer AI-Workflow für Erwiderungen unterscheidet sich von flüssiger, aber riskanter Formulierung durch Folgendes:
✅ Recherche auf Kommentarebene statt einer einzigen Literatursammlung für das gesamte Schreiben ✅ Zitationsprüfungen, die den konkreten Satz in der Quelle öffnen, nicht nur die bibliografische Angabe ✅ Ein Support-Label für jede Aussage — vollständig abgestimmt, teilweise abgestimmt, widersprochen oder unbestimmt ✅ Vorsichtiges Drafting, das dem Label entspricht, statt „legt nahe“ zu „belegt“ aufzuwerten ✅ Eine menschliche Prüfung, die einen von AI vorgeschlagenen Satz ablehnen, eingrenzen oder löschen kann
Ein Nature-Bericht aus dem Jahr 2026 über eine Frontiers-Umfrage unter rund 1.600 Wissenschaftlerinnen und Wissenschaftlern in 111 Ländern ergab, dass mehr als die Hälfte der Forschenden AI bereits beim Peer Review eingesetzt hat. Derselbe Druck betrifft nun Autorinnen und Autoren, die Antwortschreiben verfassen. Um Tools sinnvoll zu vergleichen, hilft es, das Auffinden von Belegen, die Überprüfung von Zitaten und die Kalibrierung von Aussagen als drei getrennte Aufgaben zu behandeln — nicht als eine einzige Schreibaufgabe.
Warum scheitern Antwortschreiben an Gutachter, wenn Zitate nicht überprüft sind?
Die meisten gescheiterten oder verzögerten Überarbeitungen brechen nicht zusammen, weil der Autor unhöflich war. Sie scheitern, weil ein Zitat nicht aussagt, was das Schreiben behauptet, eine zugesagte Analyse nicht im Manuskript enthalten ist oder die Antwort ein Ergebnis übertreibt, das die Arbeit nur schwach stützt. Herausgeber und Gutachter können solche Diskrepanzen innerhalb weniger Minuten prüfen.
Allzweckmodelle erleichtern diesen Fehlermodus eher, als dass sie ihn erschweren. Universitäre Leitlinien sind eindeutig: AI-Systeme erfinden häufig Zitate, die echt wirken, aber nicht existieren, und das Einreichen einer fabrizierten Referenz gilt als wissenschaftlicher Betrug. Die Leitlinien der Stellenbosch University für verantwortungsvollen AI-Einsatz ergänzen, dass viele Tools Referenzen nicht in Echtzeit mit aktuellen Datenbanken abgleichen können. Ein Antwortschreiben ist ein besonders riskanter Ort, um diese Lektion zu lernen, denn jedes neue Zitat ist ein implizites Versprechen, dass die Quelle existiert und den exakt gerade geschriebenen Satz stützt.
Es gibt einen zweiten, weniger auffälligen Fehler: echte Paper, aber falsch eingesetzt. Ein Methodenpaper wird als Ergebnisbeleg zitiert, ein Review als Primärstudie oder ein Resultat aus einer anderen Population als direkte Bestätigung dargestellt. All das übersteht eine DOI-Prüfung und bleibt dennoch irreführend. Scites Smart Citations wurden speziell dafür entwickelt, sichtbar zu machen, ob spätere Arbeiten eine Aussage stützen, infrage stellen oder lediglich erwähnen. Das ist ein anderes Problem als die Prüfung, ob eine Referenz korrekt formatiert wurde.
Regelbasierte Prüfer für Literaturangaben sind auf der mechanischen Ebene tatsächlich sehr stark. PoolText stellt fest, dass AI-Referenzprüfer bei Stilfehlern, fehlenden Feldern, Zeichensetzung und DOI-Formatierung sehr genau sind. Das ist notwendig, aber nicht ausreichend. Eine perfekt formatierte, nicht gestützte Aussage bleibt eine Übertreibung.
Worauf sollten Sie bei einem AI-Workflow für Gutachterantworten achten?
Sie sollten Tools anhand von sechs Dimensionen bewerten: Kommentarsegmentierung, Belegrecherche, Prüfung des Quellsatzes, Klassifikation der Stützung einer Aussage, kalibriertes Drafting und Erinnerung an Überarbeitungen. Ein Tool, das nur in einer dieser Dimensionen gut abschneidet, wird dennoch ein Schreiben erzeugen, das fertig aussieht, aber nicht fertig ist.
Das in diesem Artikel verwendete Comment-to-Evidence Alignment Framework gewichtet die sechs Dimensionen wie folgt:
- Kommentarsegmentierung (15 %) — Kann das System jede Gutachterforderung isolieren, einschließlich zusammengesetzter Kommentare, die in einem Absatz zwei Anforderungen verbergen?
- Belegrecherche (20 %) — Durchsucht es Manuskript, Daten der Autoren und externe Literatur getrennt voneinander und nennt anschließend, aus welchem Pool die Stützung stammt?
- Prüfung des Quellsatzes (20 %) — Kann ein Mensch genau den Satz öffnen, der die Antwort angeblich stützt?
- Klassifikation der Aussage-Stützung (20 %) — Wird jedes vorgeschlagene Zitat als gestützt, teilweise gestützt, nicht gestützt oder unklar gekennzeichnet?
- Kalibriertes Drafting (15 %) — Übernimmt die Prosa das Label, oder verfällt sie standardmäßig in selbstsicheres akademisches Englisch?
- Erinnerung an Überarbeitungen (10 %) — Kann das System frühere Runden, zugesagte Analysen und verworfene Formulierungen berücksichtigen?
Diese Gewichtung ist bewusst gewählt. Das Drafting ist der günstigste Teil der Aufgabe. Bei Recherche und Klassifikation entscheidet sich, ob Schreiben zitierfähig werden oder selbst zu einem zweiten Review-Problem werden. Forschungen zum Vergleich von AI-generierten und menschlichen Peer Reviews haben keinen eindeutigen Zusatznutzen von AI gegenüber menschlichen Gutachtern gezeigt. Das ist auch für Autorinnen und Autoren eine nützliche Warnung: Flüssigkeit ist kein Validitätssignal.
Praktische Tests, die schwache Tools rasch entlarven:
- Geben Sie dem Modell einen Gutachterkommentar, den Ihr Paper nicht vollständig beantworten kann, und prüfen Sie, ob es ein Ergebnis erfindet.
- Bitten Sie es, den stützenden Satz aus jedem zitierten Paper zu zitieren, nicht nur den Zitierschlüssel.
- Erzwingen Sie ein vierstufiges Support-Label, bevor irgendein Antwortsatz formuliert wird.
- Führen Sie denselben Kommentar eine Woche später erneut aus und prüfen Sie, ob das Schreiben einer früheren Einräumung widerspricht.
Wenn ein Produkt diese Tests nicht auf sichtbare Weise nicht bestehen kann, hilft es Ihnen nicht. Es verbirgt die Unsicherheit, die Sie eigentlich steuern müssen.
Wie schneiden führende AI-Forschungstools bei Belegrecherche und Zitationsprüfungen ab?
Derzeit dominiert kein einzelnes Produkt alle drei Aufgaben — Belege für jeden Kommentar finden, das Zitat überprüfen und eine Antwort formulieren, die nicht übertreibt. Der sinnvolle Vergleich lautet, für welche Aufgabe jedes Tool tatsächlich entwickelt wurde.
| Funktion / Dimension | Elicit | Jenova Academic Research Assistant | Scite | SciSpace Response-to-Reviewers |
|---|---|---|---|---|
| Belegrecherche | AI-Suche und Datenextraktion in mehr als 125 Millionen Papers | Literaturrecherche in Echtzeit plus an Manuskripte angehängte Wissensdatenbanken | Lizenzierte wissenschaftliche Volltexte und Zitationskontexte in einem großen, von Verlagen gestützten Korpus | Paper-gestützter Agentenworkflow für Gutachterkommentare |
| Zitationsprüfung | Stark bei strukturierter Extraktion; 1.502 von 1.511 Datenpunkten korrekt (99,4 %) in Elicits veröffentlichtem Test | Ruft potenzielle Quellen und Zitationsdetails ab; menschliche Bestätigung des Quellsatzes bleibt erforderlich | Jede AI-Aussage verlinkt auf den konkreten Satz im konkreten Paper | Nützlich für die Zusammenstellung eines Antwortpakets; die Prüftiefe hängt von den zugrunde liegenden Quellen ab |
| Drafting von Antwortschreiben | Indirekt — besser für Tabellen und Literaturantworten als für ein vollständiges Schreiben | Stark bei Punkt-für-Punkt-Entwürfen, wenn Kommentare und Manuskript in der Sitzung vorliegen | Indirekt — darauf ausgelegt zu prüfen, ob Befunde tragen, nicht das Schreiben zu verfassen | Speziell entwickelter Workflow zum Drafting von Antworten an Gutachter |
| Signale zur Aussage-Stützung | Extraktionsgenauigkeit, kein Schema mit vier Support-Labels | Vom Nutzer vorgegebene Klassifikation innerhalb des Drafting-Zyklus | Stützender, kontrastierender und erwähnender Zitationskontext | Gutachterorientierte Struktur statt formaler Support-Taxonomie |
| Preise (Stand 2026) | In diesem Review nicht verifiziert | Kostenloses Kontingent mit begrenzter Nutzung; kostenpflichtige Pläne ab $20/Monat | In diesem Review nicht verifiziert | In diesem Review nicht verifiziert |
| Am besten geeignet für | Systematische Extraktion und Evidenztabellen | Durchgängige Überarbeitungszyklen, die mit einem Manuskript verbunden bleiben | Prüfung, ob die Literatur einen Satz tatsächlich stützt | Autoren, die einen spezialisierten Agenten für das Drafting von Erwiderungen möchten |
Elicit ist besonders stark, wenn ein Gutachter einen fehlenden Vergleich, eine klarere Übersicht verwandter Arbeiten oder extrahierte Kennzahlen aus einer Reihe von Studien verlangt. Die Zusammenfassung eines Forschungsleitfadens der George Mason University beschreibt es als Tool, das Paper zusammenfasst und Daten in strukturierte Evidenzansichten extrahiert. Seine Einschränkung für Erwiderungen liegt im Umfang: Eine ausgezeichnete Evidenztabelle ist noch kein im Ton kalibriertes Schreiben, und sie wird Sie nicht automatisch daran hindern, einen extrahierten Befund zu einer Kausalaussage aufzuwerten.
Scite ist besonders stark, wenn das Risiko in einer Fehlinterpretation der Literatur liegt. Es durchsucht mehr als 300 Millionen wissenschaftliche Artikel und zeigt vor allem, wie spätere Papers eine bestimmte Aussage behandelt haben. Das ist das richtige Tool, wenn ein Gutachter schreibt: „Dieses Zitat stützt Ihre Schlussfolgerung nicht“, oder wenn Sie versucht sind, ein wegweisendes Paper so zu zitieren, als herrsche im Fachgebiet weiterhin Einigkeit darüber. Als vollständiges Überarbeitungssekretariat ist es schwächer: Es wird nicht eigenständig ein Antwortschreiben mit 14 Kommentaren verwalten, Manuskriptzeilennummern nachverfolgen oder sich merken, was Sie in Runde eins eingeräumt haben.
SciSpace gehört zu den wenigen Produkten, die „Antwort an Gutachter“ als erstklassigen Workflow statt als Chat-Prompt behandeln. Dieser Fokus ist ein echter Vorteil, wenn Sie Struktur benötigen. Die entsprechende Einschränkung ist dieselbe wie bei jedem Drafting-Agenten: Strukturierte Ausgabe kann ein Ergebnis dennoch übertreiben, wenn die darunterliegende Evidenzschicht dünn ist.
Consensus ist eine Suchmaschine für peer-reviewte Literatur, die darauf ausgelegt ist, wissenschaftliche Aussagen schnell zu finden, zu organisieren und zu analysieren. Sie ist für den Teil einer Erwiderung nützlich, der fragt: „Was sagt das Fachgebiet derzeit?“ Sie ist kein Zitationsprüfer und kein Formatierer für Schreiben.
Jenova's Academic Research Assistant steht zwischen diesen spezialisierten Tools. Er kann Manuskript, Gutachter-PDF und frühere Korrespondenz in einem persistenten Arbeitsbereich zusammenhalten, die Literatur durchsuchen und Kommentar für Kommentar Antworten formulieren. Er bietet nicht nativ Scite-ähnliche Aufstellungen stützender gegenüber kontrastierender Zitate und ist kein Word-ready-Exportwerkzeug für Überarbeitungspakete in dem Sinne, wie es PeerReplys Workflow für Antworten an Gutachter bewirbt. Das sind ehrliche Lücken. Die ausgleichende Stärke ist Kontinuität: Eine Überarbeitung, die sechs Wochen dauert, braucht Erinnerung mehr als einen Generator für ein einmaliges Schreiben.
Paper Digest ist als enger Spezialist ebenfalls erwähnenswert. Seine Ausrichtung auf die Prüfung von Aussagen liegt näher an Scite als an einem Drafting-Chatbot, was es zu einem besseren Prüfer im zweiten Durchgang als zu einem Schreiber im ersten Durchgang macht.
Wie findet eine Q&A-Engine mit mehreren Analyseaspekten stützende Belege für jeden Kommentar?
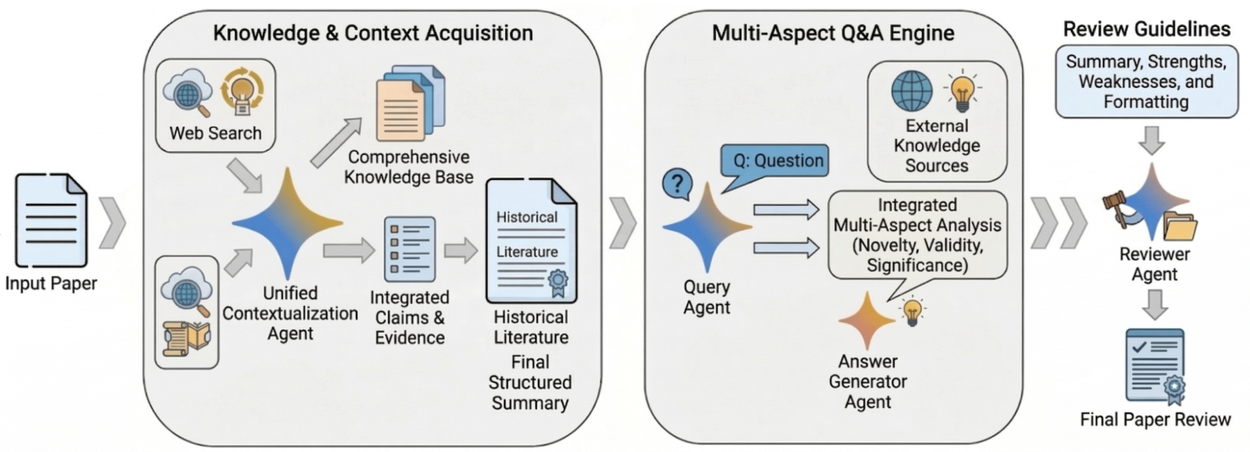
Ein zuverlässiges System „liest nicht die Reviews und schreibt einen Brief“. Es macht aus jedem Gutachterkommentar eine Abfrage, recherchiert in drei getrennten Wissenspools und entscheidet erst dann, ob eine Antwort formuliert werden kann. Genau diese Architektur zeigt das obige Pipeline-Diagramm: zuerst Wissenserwerb, dann Fragebeantwortung mit mehreren Aspekten, zuletzt Synthese.
Die drei Pools sollten getrennt bleiben:
- Der Manuskript-Pool — Abbildungen, Tabellen, Methoden, Einschränkungen und jede Analyse, die Sie bereits durchgeführt haben.
- Der Autoren-Pool — Laborprotokolle, zusätzliche Robustheitsprüfungen, Datenwörterbücher und frühere Antwortschreiben.
- Der Literatur-Pool — Papers, die tatsächlich auf den Einwand des Gutachters eingehen und über eine Scholar-ähnliche Suche statt über Modellgedächtnis abgerufen werden.
Das Vermischen dieser Pools ist der Beginn von Übertreibungen. Ein Satz, der in der Literatur zutrifft, ist kein Ergebnis Ihres Papers. Eine Sensitivitätsprüfung in einem Notebook ist keine veröffentlichte Tabelle. Ein wirksamer Abfrage-Agent stellt zu einem Kommentar drei unterschiedliche Fragen: Ist dies bereits im Manuskript enthalten? Falls nicht, verfügen die Autoren über unveröffentlichte Stützung? Falls nicht, rechtfertigt die Literatur eine begrenzte Aussage, eine Überarbeitung oder ein Zugeständnis?
In der Praxis sieht der Rechercheschritt für Jenova's Academic Research Assistant so aus:
- Hängen Sie das Manuskript, das Entscheidungsschreiben und alle Ergänzungsmaterialien an.
- Fordern Sie ein nummeriertes Verzeichnis der Gutachterforderungen an, einschließlich impliziter Anforderungen.
- Erzwingen Sie für jede Forderung eine Suche in drei Pools, bevor irgendein Drafting beginnt:
„Gutachter 2, Kommentar 3 fragt, ob der Effekt nach Ausschluss der Teilstichprobe von 2019 bestehen bleibt. Durchsuche zuerst ausschließlich das angehängte Manuskript. Zitiere die Tabelle, den Abschnitt oder den Satz, der die Frage beantwortet. Wenn nichts gefunden wird, schreibe ‚nicht im Manuskript‘ und liste auf, welche Analyse erforderlich wäre. Zitiere keine externen Papers, als wären sie unsere Ergebnisse.“
- Erst nachdem im Manuskript nichts gefunden wurde, sollte der Agent die Literatur durchsuchen oder eine neue Analyse vorschlagen.
Spezialisierte Produkte für Erwiderungen folgen einer ähnlichen Aufteilung. Manusights argumentiert, dass allgemeine Sprachmodelle weiterhin die praktischsten Tools für das Drafting des Schreibens selbst sind. Das stimmt, soweit es um Prosa geht. Die Evidenz-Engine muss diesem Sprachmodell jedoch vorausgehen. Andernfalls wird das Schreiben zu einer selbstsicheren Wiederholung dessen, was der Chatbot als am ähnlichsten gefunden hat, und nicht dessen, was die Aktenlage enthält.
Neuheit, Validität und Bedeutung — die drei Analyseachsen einer Review-Engine mit mehreren Aspekten — sind zugleich die drei Achsen, auf denen die meisten Gutachterkommentare tatsächlich liegen. Ein Kommentar zu fehlenden Baselines ist eine Validitätsfrage. Ein Kommentar zum inkrementellen Beitrag ist eine Neuheitsfrage. Ein Kommentar dazu, ob sich irgendjemand dafür interessieren sollte, ist eine Bedeutungsfrage. Diese Zuordnung verhindert, dass ein Validitätseinwand mit einem Absatz über Bedeutung beantwortet wird.
Wie sollte AI die Stützung eines Zitats klassifizieren, bevor Sie eine Quelle anführen?
Jedes Zitat in einem Antwortschreiben sollte eines von vier Labels erhalten, bevor es in den Entwurf aufgenommen werden darf: gestützt, teilweise gestützt, nicht gestützt oder unklar. Wenn das System kein Label vergeben kann, sollte es auch keine Fußnote vergeben.
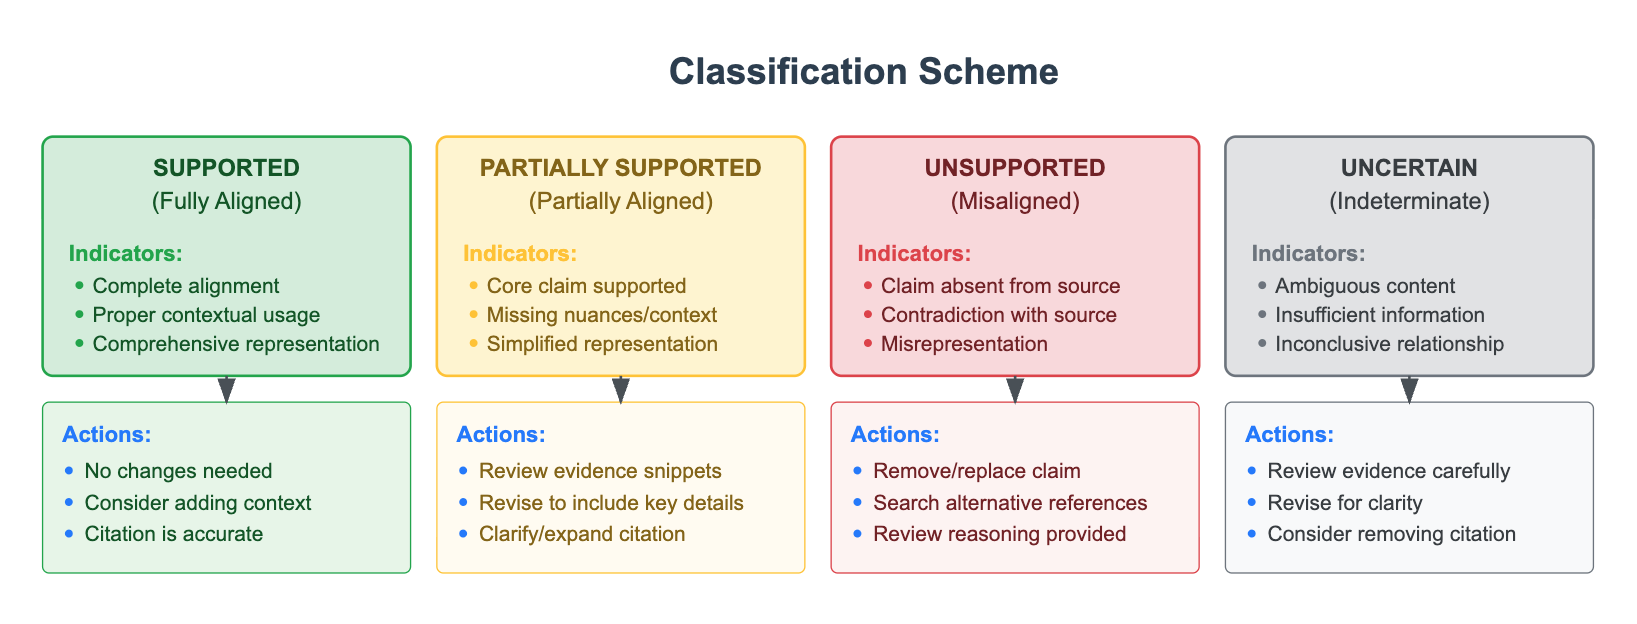
Diese Klassifikation unterscheidet einen Zitationsprüfer von einem Aussagenprüfer.
Gestützt bedeutet, dass die Quelle die Aussage mit demselben Umfang, derselben Population und derselben kausalen Stärke formuliert, die Sie verwenden möchten. Maßnahme: Behalten Sie das Zitat bei. Erwägen Sie, eine Kontextklausel mit fünf Wörtern hinzuzufügen, damit der Gutachter die Übereinstimmung erkennt.
Teilweise gestützt bedeutet, dass der Kernfakt in der Quelle enthalten ist, Ihr Satz jedoch eine Einschränkung, eine Stichprobenbegrenzung oder ein widersprüchliches Sekundärergebnis ausgelassen hat. Maßnahme: Schreiben Sie den Satz so um, dass die fehlende Nuance enthalten ist, oder ersetzen Sie das Zitat durch eine bessere Primärquelle. Dies ist das häufigste ehrliche Label in realen Erwiderungen — und jenes, das allgemeine Chatbots zu „gestützt“ vereinfachen.
Nicht gestützt bedeutet, dass die Aussage fehlt, ihr widersprochen wird oder die Quelle auf eine Weise verwendet wird, die sie nicht zulässt. Maßnahme: Löschen oder ersetzen Sie sie. Behalten Sie das Zitat nicht bei, nur weil die Autorenliste renommiert ist oder die DOI aufgelöst wird.
Unklar bedeutet, dass das PDF hinter einer Paywall liegt, der relevante Abschnitt mehrdeutig ist oder das Verhältnis zwischen Aussage und Quelle anhand des verfügbaren Textes nicht bestimmt werden kann. Maßnahme: Öffnen Sie das Paper oder entfernen Sie das Zitat. Unsicherheit ist keine abgeschwächte Form von Stützung.
Scite setzt ein eng verwandtes Schema auf Literaturmaßstab um, indem es zeigt, ob spätere Papers einen Befund stützen, infrage stellen oder diskutieren. Das ist für externe Zitate äußerst wertvoll. Es klassifiziert jedoch nicht Ihre eigenen neuen Sätze anhand Ihrer eigenen Abbildungen. Bei manuskriptinternen Aussagen muss das Schema mit vier Labels vom Drafting-Workflow selbst angewandt werden.
Ein Prompt, der das Schema durchsetzt:
„Gib für jeden Satz, den du für die Antwort an Gutachter 1 vorschlägst, Folgendes aus: (1) den Satz, (2) das Zitat, (3) ein wörtliches Zitat aus der Quelle oder dem Manuskript, (4) ein Label — Gestützt / Teilweise gestützt / Nicht gestützt / Unklar — und (5) die aufgrund dieses Labels erforderliche Überarbeitung. Nimm keinen Satz mit dem Label Nicht gestützt auf. Überarbeite jeden teilweise gestützten Satz, bevor du ihn mir zeigst.“
Der Vergleich von AI-Suchmaschinen durch Columbia Journalism Review stellte systematische Zitationsfehler fest, selbst wenn die genannten Quellen bekannte Marken waren. Akademische Tools sind in dieser Dimension besser als Antwort-Engines für das offene Web, doch der Fehlermodus ist derselbe: Der Name eines vertrauenswürdigen Mediums wird als Ersatz für einen geprüften Satz verwendet. Das Vier-Label-Gate soll genau diese Ersetzung verhindern.
Wie formulieren Sie eine Punkt-für-Punkt-Antwort, ohne Schlussfolgerungen zu übertreiben?
Sie formulieren erst, nachdem die Labels vorliegen, und lassen das Label das Verb bestimmen. „Zeigt“, „demonstriert“ und „beweist“ sind gestützten Aussagen mit passendem Umfang vorbehalten. Teilweise gestützte Aussagen erhalten Formulierungen wie „steht im Einklang mit“, „geht teilweise auf ... ein“ oder „gilt unter [genannter Einschränkung]“. Unklare Aussagen erhalten keine Verben. Sie erhalten einen Plan oder werden gelöscht.
Ein sauberes Gerüst für ein Antwortschreiben sieht so aus:
- Formulieren Sie den Punkt des Gutachters in neutraler Sprache neu.
- Erläutern Sie, was Sie getan haben: bereits im Paper enthalten, neu analysiert oder eingeräumt.
- Verweisen Sie auf eine Fundstelle: Seite, Zeile, Tabelle, Abbildung oder Ergänzungsmaterial.
- Zitieren Sie externe Arbeiten nur, wenn sich der Kommentar auf die Literatur bezieht, und nur mit einem Support-Label.
- Schließen Sie mit der exakten Änderung im Manuskript oder mit einem begrenzten Grund, warum Sie keine vorgenommen haben.
Jenova's Academic Research Assistant kann dieses Gerüst über ein langes Schreiben hinweg aufrechterhalten, wenn Sie die Einschränkung von Beginn an vorgeben:
„Formuliere die Antwort an Gutachter 2 ausschließlich anhand von gestützten und überarbeiteten, teilweise gestützten Punkten aus der Evidenztabelle. Verwende die von mir bereitgestellte Verbliste. Jeder Absatz muss eine Fundstelle im Manuskript oder ein ausdrückliches Zugeständnis enthalten. Stelle zukünftige Experimente nicht so dar, als seien sie abgeschlossen. Beschreibe den Diskussionsteil eines zitierten Papers nicht so, als wäre er unser Ergebnis.“
Bei SciSpace oder einem allgemeinen Modell, das als Verfasser eines Schreibens verwendet wird, muss dieselbe Einschränkung eingefügt werden, weil Drafting-Produkte auf Vollständigkeit und Höflichkeit optimieren. Vollständigkeit führt dazu, dass Phantomanalysen erscheinen. Höflichkeit führt dazu, dass eine Meinungsverschiedenheit zu „wir stimmen zu und haben nun gezeigt“ aufgewertet wird.
Vorsichtige Formulierungen sind nicht dekorativ. Sie sind ein Merkmal der Aussagegenauigkeit. Nützliche Einschränkungen sind konkret:
- Einschränkungen des Geltungsbereichs: „in dieser Stichprobe“, „unter der linearen Spezifikation“, „bei Teilnehmenden mit vollständigem Follow-up“
- Epistemische Einschränkungen: „steht im Einklang mit“, „schließt nicht aus“, „liefert vorläufige Stützung“
- Prozessbezogene Einschränkungen: „wir berichten nun“, „wir haben ergänzt“, „wir können dies mit dem vorliegenden Design nicht testen“
Unzulässige Aufwertungen in einem Erwiderungsentwurf sind unter anderem, aus einer Korrelation einen Effekt zu machen, aus einer Robustheitsprüfung eine Replikation, aus einem nicht signifikanten Ergebnis „kein Unterschied“ und aus einem einzelnen stützenden Zitat „es ist gut belegt“. Leitlinien für AI-gestütztes akademisches Schreiben betonen, dass Autoren weiterhin dafür verantwortlich sind, zu prüfen, ob generierter Text den tatsächlichen Aussagen des Manuskripts entspricht. Die Vorgaben der Zeitschriften unterscheiden sich, doch die Zusammenfassung von The Conversation zu Verlagsregeln lautet, dass routinemäßige mechanische Hilfe möglicherweise nicht zitiert werden muss, während inhaltlich substanzieller AI-generierter Inhalt dies häufig muss. Ein Antwortschreiben, das von einem Modell formulierte Literaturinterpretationen enthält, fällt in der Regel in den zweiten Fall.
ProofreaderPros Praxisleitfaden für Antwortschreiben liegt mit Struktur und Ton richtig. Struktur und Ton sind nicht der schwierige Teil. Der schwierige Teil besteht darin, sich zu weigern, einen Kommentar stärker zu beantworten, als Ihre Tabelle es erlaubt. Wenn der Gutachter eine kausale Identifikationsstrategie verlangt hat, die Ihnen nicht zur Verfügung steht, ist der ehrliche Entwurf ein Absatz über Einschränkungen und, sofern möglich, eine schwächere, aber identifizierte Analyse — nicht eine selbstsicherere Wiederholung der ursprünglichen Regression.
Ein Prompt für einen zweiten Durchgang, der Übertreibungen aufspürt:
„Vergleiche jeden Antwortabsatz mit der Evidenztabelle. Markiere jeden Satz, dessen Verb stärker ist als sein Support-Label. Markiere jedes Zitat, das nicht wörtlich belegt ist. Markiere jede Zusage, die keiner nachverfolgten Manuskriptänderung entspricht.“
Was sagen Fachleute für wissenschaftliche Integrität über AI-gestützte Erwiderungen?
Forschende, die sich mit der Integrität von Peer Reviews befassen, kehren immer wieder zu demselben Punkt zurück: AI kann Recherche und Formatierung beschleunigen, doch der Autor bleibt für den Wahrheitsgehalt jedes Satzes verantwortlich, der an den Herausgeber zurückgeht.
„Der Fehler, den wir sehen, ist selten ein fehlendes Komma in der Referenzliste. Es ist ein Satz, der für das zitierte Paper epistemisch eine Stufe zu stark ist. Ein Modell, das dafür belohnt wird, hilfreich zu sein, wird diese Lücke für Sie schließen, sofern Sie es nicht daran hindern. Die günstigste Kontrolle ist architektonisch: recherchieren, labeln, dann formulieren. Wenn Sie diese Reihenfolge umkehren, wird das Schreiben Aussagen enthalten, die Sie erst später zu rechtfertigen versuchen.“
„Smart-Citation-Tools haben die Kosten dafür verändert, zu prüfen, ob das Fachgebiet ein Paper weiterhin für zutreffend hält. Sie haben nicht die Kosten dafür verändert, zu prüfen, ob Ihre eigene Tabelle 3 das Verb in Absatz 6 der Antwort stützt. Diese zweite Prüfung besteht weiterhin darin, dass ein Mensch eine Zahl neben einem Satz liest. Autoren, die sie überspringen, sparen keine Zeit. Sie leihen sie sich aus der nächsten Review-Runde.“
„Wir raten Teams außerdem, ein Ablehnungsprotokoll zu führen. Jedes Mal, wenn das Modell ‚wir zeigen‘ schreiben möchte, das Label aber nur teilweise gestützt lautet, notieren Sie den abgelehnten Satz. Nach zwei oder drei Papers werden Sie die typischen Übertreibungen Ihres Labors erkennen — meist kausale Verben, Verallgemeinerungen über die Stichprobe hinaus und das Zitieren von Reviews, als wären sie Studien. Benutzerdefinierte Anweisungen sind lediglich eine Möglichkeit, dieses Protokoll zu kodieren.“
— Jenova Product Team, Design akademischer Workflows, acht Jahre Unterstützung für Manuskript- und Zitationssysteme
Dieser Rat steht im Einklang mit der Forschungsliteratur zu AI im Review selbst. Ein PMC-Review zu AI im Peer Review betont, dass Gutachter AI-generierte Inhalte vor jeder Entscheidung weiterhin kritisch bewerten müssen. Dieselbe Pflicht gilt, wenn die AI auf Seiten der Autoren im Entscheidungsschreiben sitzt. Autoren, die ChatGPT-Modelle in der Peer-Review-Korrespondenz verwenden, werden ausdrücklich dazu angehalten, Vorschläge anhand der Kernaussagen des Manuskripts und der wissenschaftlichen Integrität zu prüfen.
Editages Praxistest zu AI bei Peer-Review-Antworten ist weniger wegen einer Alles-oder-nichts-Rangliste als wegen des erkennbaren Musters nützlich: Modelle können beurteilen, ob eine Antwort vollständig wirkt, und zugleich schwach darin sein, ob die Antwort wahr ist. Vollständig zu wirken ist die Eigenschaft, durch die Schreiben zu früh eingereicht werden.
Wann sollten Sie eine von AI formulierte Gutachterantwort überschreiben?
Sie sollten den Entwurf überschreiben, sobald das Support-Label schwächer ist als der Satz, sobald der Kommentar ein Urteil verlangt, das das Modell nicht fundieren kann, oder sobald eine Zustimmung Sie auf eine Aussage festlegen würde, die Sie in der nächsten Runde nicht verteidigen können. Überschreiben ist der normale Weg, kein Ausnahmeweg.
Überschreiben Sie in diesen Fällen sofort:
- Der Agent zitiert ein Paper, das Sie nicht geöffnet haben.
- Der Agent beantwortet eine Methodenkritik mit zusätzlichem Einführungstext und ohne neuen Test.
- Der Agent behandelt ein Missverständnis des Gutachters als Aufforderung zu mehr Zitaten statt als Anlass, Ihre Erklärung neu zu formulieren.
- Der Agent „findet“ eine Analyse, die nicht im Repository enthalten ist.
- Der Agent stimmt zwei Gutachtern zu, die inkompatible Analysen verlangt haben, ohne den Konflikt zu markieren.
- Der Agent verwendet einen Review-Artikel, um eine primäre empirische Behauptung zu stützen.
Einige Kommentare sollten niemals vollständig delegiert werden. Anfragen zu Forschungsethik, Datenzugang, Interessenkonflikten und dazu, ob ein Ergebnis klinisch oder politisch bedeutsam ist, verlangen eine menschliche Entscheidung darüber, wofür Sie einstehen wollen. AI kann die Dokumente zusammenstellen. Sie kann keine Verantwortung dafür übernehmen.
Es gibt zudem ein wachsendes umgekehrtes Problem: Autoren begegnen inzwischen Gutachterkommentaren, die selbst AI-generiert zu sein scheinen. Die richtige Reaktion bleibt evidenzorientiert. Formulieren Sie die umsetzbare wissenschaftliche Anforderung im Kommentar neu, ignorieren Sie die allgemeine Füllformulierung und beantworten Sie die Anforderung, die Sie dokumentieren können. Ein nach AI klingendes Review mit einem nach AI klingenden Schreiben zu beantworten, verdoppelt lediglich den unbegründeten Text in der Akte.
Ein praktikabler menschlicher Abschluss für jeden Kommentar:
- Lesen Sie den Satz des Gutachters und schreiben Sie selbst eine Zusammenfassung mit sechs Wörtern.
- Akzeptieren oder verwerfen Sie die Evidenzzeile des Agenten, bevor Sie den formulierten Absatz ansehen.
- Wenn Sie die Zeile verwerfen, bearbeiten Sie nicht den Absatz. Schicken Sie den Agenten zurück zur Recherche.
- Wenn Sie eine teilweise gestützte Zeile akzeptieren, bearbeiten Sie das Verb selbst.
- Erst dann übernehmen Sie den Absatz in das Schreiben.
So eingesetzt ergänzen sich Jenova's Academic Research Assistant, Scite, Elicit und ein spezialisierter Drafting-Agent wie SciSpace, statt austauschbar zu sein. Recherchetools verringern das Risiko, dass Sie ein Paper übersehen. Klassifikation verringert das Risiko, dass Sie eines falsch verwenden. Drafting-Tools verringern das Risiko, dass das Schreiben unübersichtlich ist. Keines davon verringert das Risiko einer Übertreibung, wenn Sie sich nicht weigern, aus nicht gelabelten Aussagen zu formulieren.
Der Maßstab, den es wert ist, über dem Prompt-Fenster anzubringen, ist einfach: Wenn Sie nicht auf einen Satz, eine Tabelle oder ein Zugeständnis zeigen können, das das Verb rechtfertigt, gehört der Satz nicht in die Antwort.
Referenzen
- Nature — Mehr als die Hälfte der Forschenden nutzt inzwischen AI für Peer Review
- University of Pretoria Library — Zitiermanagement und Risiken von AI-Halluzinationen
- Stellenbosch University — Leitlinien für verantwortungsvollen AI-Einsatz beim akademischen Schreiben
- Scite — Smart Citations und satzgenaue Prüfung wissenschaftlicher Aussagen
- PoolText — Was AI im Peer Review kann und nicht kann, einschließlich Referenzprüfung
- ScienceDirect — Vergleich AI-generierter und menschlicher Peer Reviews
- Elicit — AI-Literatursuche und berichtete Extraktionsgenauigkeit
- George Mason University Libraries — AI-Tools für Literaturreviews
- SciSpace — Agentenworkflow für Antworten an Gutachter
- Consensus — AI-Suche in peer-reviewter Literatur
- PeerReply — Punkt-für-Punkt-Antworten und Workflow für Überarbeitungspakete
- Paper Digest — Prüfung von Aussagen anhand akademischer Evidenz
- Manusights — Die besten AI-Tools für Antworten an Gutachter
- Columbia Journalism Review — AI-Suchmaschinen und Zitationsfehler
- PMC — AI-gestütztes akademisches Schreiben
- The Conversation — Verlagsleitlinien zu AI in Zeitschriftenpapers
- ProofreaderPro — Mit AI-Hilfe ein Antwortschreiben an Gutachter verfassen
- PMC — Künstliche Intelligenz im Peer Review
- PMC — Navigation durch Peer Review mit ChatGPT 4
- Editage — Tests zu AI bei Peer-Review-Antworten
- ResearchGate — Diskussion zu AI-generierten Gutachterkommentaren