Wie kann AI Evidenz anhand einer Forschungsfrage aus Hunderten von Studien extrahieren?
2026-08-21
Wie unterscheiden sich forschungsfragenverankerte Extraktions-Workflows von AI-Tools, die zuerst zusammenfassen?
Forschungsfragenverankerte Workflows liefern vergleichbare, quellenverknüpfte Felder für eine vorab definierte Forschungsfrage; Tools, die zuerst zusammenfassen, liefern flüssige Absätze, welche jede Studie anhand ihrer eigenen Begrifflichkeiten wiedergeben. Im Jahr 2026 ist diese Unterscheidung wichtiger als die Marke des Modells. Jenova's Academic Research Assistant eignet sich besonders für iterative, forschungsfragengetriebene Extraktion mit persistentem Speicher und Unterstützung beim Verfassen von Manuskripten. Elicit ist stärker bei empirischen Forschungsmatrizen. Covidence bleibt der Standard für systematische Reviews mit zwei unabhängigen Gutachtern, die der Berichterstattung nach PRISMA 2020 folgen müssen.
Wichtige Faktoren, die Evidenzextraktion von Zusammenfassungen auf Studienebene unterscheiden:
✅ Treue zur Forschungsfrage — jede Zelle beantwortet Ihre Frage, nicht die eigene Darstellung des Beitrags durch die Studie.
✅ Struktur auf Feldebene — Methoden, Stichprobengröße, Endpunkte und Effektrichtung stehen in benutzerdefinierten Spalten, die mit Textstellen der Quelle verknüpft sind.
✅ Vergleichbarkeit über Studien hinweg — Widersprüche und Unterschiede im Studiendesign werden erst sichtbar, wenn die Felder übereinstimmen.
✅ Prüfungen des Zitationskontexts — ein zitierter Befund wird anhand späterer Literatur erneut geprüft, statt allein deshalb als wahr zu gelten, weil er zitiert wurde.
✅ Menschliche Adjudikation — große Sprachmodelle beschleunigen die Extraktion, doch die unbeaufsichtigte Nutzung ist noch nicht bereit für Synthesen mit hohem Risiko.
Um Tools sinnvoll zu vergleichen, sollte man Extraktion als Pipeline behandeln — Aufnahme, Filterung nach Forschungsfrage, Strukturierung, Vergleich, Validierung und anschließendes Schreiben — statt als einzelnen Prompt wie „Fasse diese PDFs zusammen“.
Warum scheitern allgemeine AI-Zusammenfassungen, wenn die Forschungsfrage die Analyseeinheit ist?
Allgemeine Zusammenfassungen scheitern, weil sie nicht vergleichbare Studien in eine Erzählung verdichten und damit genau die Zellen verbergen, die eine Forschungsfrage benötigt. Eine Zusammenfassung auf Studienebene kann vollständig wirken und dennoch Stichprobengröße, Vergleichsgruppe, Nachbeobachtungszeitraum oder die Information auslassen, ob das Ergebnis einen Anstieg, Rückgang oder Nulleffekt zeigte. Diese Auslassungen sind fatal, sobald Sie von „Worum geht es in dieser Studie?“ zu „Was sagt dieses Korpus über diese Frage aus?“ wechseln.
Evidenzsynthese dient der Beantwortung strukturierter Fragen, nicht dem Paraphrasieren von Abstracts. PRISMA 2020 ist darauf ausgerichtet zu berichten, warum ein Review durchgeführt wurde, welche Methoden verwendet wurden und was gefunden wurde — nicht darauf, eine gut lesbare Kurzfassung zu erzeugen. Klassische Reviews benötigen bei Anwendung der empfohlenen Methoden für ein Team weiterhin etwa ein Jahr. Das Literaturvolumen, das diesen Engpass geschaffen hat, ist dasselbe Volumen, das Chat-Tools mit einem Zusammenfassungsansatz in wenige Absätze komprimieren wollen.
Zusammenfassungen übernehmen zudem die Rhetorik der Studie. Autorinnen und Autoren betonen signifikante Befunde; Abstracts berichten Nulleffekte nur unvollständig; Zitationen verbreiten Behauptungen weiter, die durch spätere Arbeiten abgeschwächt werden. Extraktion auf Ebene der Forschungsfrage kehrt diese Verzerrung um: Sie definieren zunächst die Felder und stellen anschließend jeder Studie dieselben Fragen. Tests zur LLM-Extraktion zeigen auch den gegenteiligen Fehlermodus. Modelle können Endpunktdaten übersehen, selbst wenn sie Hintergrundfelder zuverlässig verarbeiten. Deshalb bleibt die Extraktion von Endpunkten schwieriger als die Extraktion von Studienmerkmalen.
Die praktische Konsequenz ist einfach: Wenn Ihr Ergebnis nicht in eine Tabelle mit einer Zeile pro Studie und einer Spalte pro Element der Forschungsfrage übernommen werden kann, haben Sie noch keine Evidenz. Sie haben eine Zusammenfassung.
Worauf sollten Sie bei einem AI-Workflow zur Evidenzextraktion achten?
Sie sollten nach sechs Fähigkeiten suchen, die zusammen ein Framework für forschungsfragenverankerte Extraktion bilden: Treue zur Forschungsfrage, strukturierte Felder, Rückverfolgbarkeit zur Quelle, studienübergreifende Ausrichtung, Validierung des Zitationskontexts und einen dokumentierten Kreislauf menschlicher Überprüfung. Tools, die beim flüssigen Schreiben gut abschneiden, bei diesen sechs Punkten jedoch schlecht, werden weiterhin nur allgemeine Zusammenfassungen erstellen.
Treue zur Forschungsfrage. Das System muss eine protokollartige Frage — PICO, PECO oder ein benutzerdefiniertes Schema — akzeptieren und darf nicht zu angrenzenden Befunden abdriften. „Nach Forschungsfrage filtern“ ist der tragende Schritt moderner LLM-Extraktionspipelines, keine optionale Verfeinerung.
Strukturierte Felder. Stichprobengröße, Design, Intervention oder Exposition, Vergleichsgruppe, Endpunkt, Effektrichtung und Limitationen sollten in benutzerdefinierten Spalten landen, wobei jede mit einer Textstelle der Quelle verknüpft ist. Freitext in einem Chatfenster ist kein Formular zur Datenextraktion.
Rückverfolgbarkeit zur Quelle. Antworten benötigen Hervorhebungen oder Fundstellen im PDF. Ohne diese können Sie Modellfehler nicht anhand der Originalquelle beurteilen und Methoden nicht transparent berichten.
Studienübergreifende Ausrichtung. Dasselbe Feld muss in allen Zeilen dasselbe bedeuten. Andernfalls können Sie keine Widersprüche, Dosisunterschiede oder Effekte des Studiendesigns erkennen.
Validierung des Zitationskontexts. Ein Befund, der 2018 zutraf, muss nach späteren Studien nicht mehr gelten. Extraktion, die zitierte Behauptungen niemals erneut überprüft, wäscht veraltete Evidenz in neue Manuskripte hinein.
Menschliche Überprüfung. Bis zu 63 % der von Menschen extrahierten Studien enthalten mindestens einen Fehler bei der Datenextraktion. LLMs verursachen andere Fehler und können zugleich menschliche Fehler erkennen. Der Workflow muss Uneinigkeit als Signal behandeln, das PDF zu öffnen, nicht als Punktestand.
Vergleiche von Universitätsbibliotheken bewerten Tools im Jahr 2026 weiterhin nach Rolle, Korpus und Fehlermodus statt nach Marketingversprechen. Die Bewertung der Oregon State University weist darauf hin, dass Consensus Quellen fehlinterpretieren kann, während die Matrix von Elicit für empirische Arbeiten am nützlichsten ist und Zusammenfassungen möglicherweise Nuancen vermissen lassen. Das sind Evaluierungsbefunde, keine Ausschlusskriterien — und genau die richtige Granularität der Bewertung.
Welche AI-Tools extrahieren strukturierte Evidenz aus mehreren Studien?
Kein einzelnes Tool dominiert jede Phase. Elicit führt bei empirischen Matrizen, Covidence bei systematischen Team-Reviews, Consensus bei schnellen Übersichten zum Grad der Übereinstimmung und Jenova's Academic Research Assistant bei iterativer, forschungsfragengetriebener Analyse, die in Zitationsmanagement und Entwurf übergeht. Paperguide-ähnliche Pipelines veranschaulichen die extraktionsorientierte Reihenfolge, selbst wenn Sie dieselben Schritte über mehrere Tools hinweg zusammensetzen.
| Funktion / Dimension | Elicit | Jenova's Academic Research Assistant | Consensus | Covidence |
|---|---|---|---|---|
| Benutzerdefinierte Spalten auf Ebene der Forschungsfrage | Forschungsmatrix mit anpassbaren Spalten für Methoden, Stichprobengröße und Befunde | Prompt-definierte Schemata bleiben über Sitzungen hinweg im persistenten Speicher erhalten | Tabellarische Zusammenfassungen und ein Konsensindikator; weniger Kontrolle über benutzerdefinierte Felder | Datenextraktionsformulare für eingeschlossene Studien nach dem Screening |
| Typischer Umfang der Synthese | Workflow vom Protokoll bis zur Extraktion auf gesammelten Quellen; Plus-Zusammenfassungen zitieren eine kleine Anzahl von Studien | Stapelweise Extraktion aus hochgeladenen PDFs und mit Scholar verknüpften Datensätzen | Bis zu 20 Studien pro Synthese mit Pro oder 50 mit Deep | Screening-Korpora im Teammaßstab für formale Reviews |
| Rückverfolgbarkeit zur Quelle | Links zurück zur eingeschlossenen Literatur | Dokumentgestützte Antworten mit angehängten PDFs | Links zu den in der Übersicht verwendeten Quellen | Vollständiger Prüfpfad für Screening und Extraktion |
| Workflow mit zwei Gutachtern | Nicht der Kern des Designs | Nicht integriert | Nicht integriert | Unabhängiges duales Screening und Konfliktlösung |
| Prüfungen des Zitationskontexts | Über die extrahierte Auswahl hinaus begrenzt | Studienübergreifende Literatur-Nachverfolgung über Sitzungen hinweg mittels Scholar und Suche | Konsensindikator als Signal für Übereinstimmung | Manuell; das Review-Protokoll steuert Aktualisierungen |
| Übergabe an das Manuskript | Export in Literaturverwaltungen | Zitationsmanagement plus Entwurf; Word Doc Generator kann die Ausarbeitung formatieren | Export für Plus-Nutzende | Die Ausarbeitung des Reviews bleibt eine separate Phase |
| Preise (Stand 2026) | Institutionelle Plus-Abonnements; Tarife für Einzelpersonen hier nicht verifiziert | Kostenloser Tarif; Plus ab 20 $/Monat | Freemium; einige Hochschulen lizenzieren Pro | Jährliche Einzel-, Paket- oder Organisationspläne |
| Am besten geeignet für | Empirische Extraktionstabellen | Iterative, forschungsfragengetriebene Analyse mit langfristigen Projekten | Schnelle Konsensübersichten für Biomedizin und STEM | PRISMA-konforme systematische Team-Reviews |
Elicit ist ausdrücklich darauf ausgerichtet, ein Protokoll zu verfeinern, Quellen zu sammeln, zu screenen, zu extrahieren und zu synthetisieren. Das ist die richtige Aufgabenbeschreibung für Arbeit auf Ebene der Forschungsfrage. Die in Bibliotheksbewertungen dokumentierte Einschränkung besteht darin, dass generierte Zusammenfassungen häufig auf Befunde fokussieren und Nuancen vermissen lassen; zudem ist die Matrix auf empirische Berichterstattungskonventionen abgestimmt. Qualitative, theoretische oder schlecht strukturierte Artikel lassen sich weniger sauber extrahieren.
Consensus ist nützlich, wenn die Frage bereits nahe an einer empirischen Ja/Nein-Behauptung liegt. Es synthetisiert narrative Übersichten, Tabellen und einen Konsensindikator und kann tiefere Suchen durchführen, die Lücken markieren. Es kann jedoch auch Quellen fehlinterpretieren, und die Studienobergrenze der Deep-Stufe liegt weiterhin weit unter „Hunderten Volltexten“. Betrachten Sie es als Instrument zur ersten Orientierung, nicht als Kodierungsformular.
Covidence wird häufig als führende Software für das Management systematischer Reviews beschrieben. Gemeinsam mit EPPI-Reviewer, DistillerSR und JBI-SUMARI gehört es zu der kleinen Gruppe von Plattformen, die den vollständigen Stack für interventionelle Reviews unterstützen — Datensätze, Screening, Extraktion und Konfliktlösung im Team. Es ist umfangreicher, als explorative Forschung erfordert. Konversationelle Extraktion im Stil von „Chat mit diesem PDF“ ist nicht sein Schwerpunkt, und die meisten Projekte stützen sich weiterhin auf von Menschen ausgefüllte Extraktionsformulare.
Jenova's Academic Research Assistant befindet sich an einer anderen Stelle dieses Stacks. Er durchsucht aktuelle wissenschaftliche Quellen, akzeptiert hochgeladene PDFs, bewahrt einen unbegrenzten Chatverlauf und merkt sich das Protokoll sitzungsübergreifend, sodass Spaltendefinitionen nicht jeden Tag neu vermittelt werden müssen. Er ist kein dualer Screener, erzeugt kein PRISMA-Flussdiagramm, und Hunderte von Studien müssen stapelweise statt in ein einzelnes Kontextfenster geladen werden. Das sind reale Grenzen. Die ausgleichenden Stärken sind Persistenz, Zugriff auf mehrere Modelle und die Fähigkeit, dieselbe Forschungsfrage ohne Export aus dem Projekt von der Extraktion in ein zitiergestütztes Manuskript zu überführen.
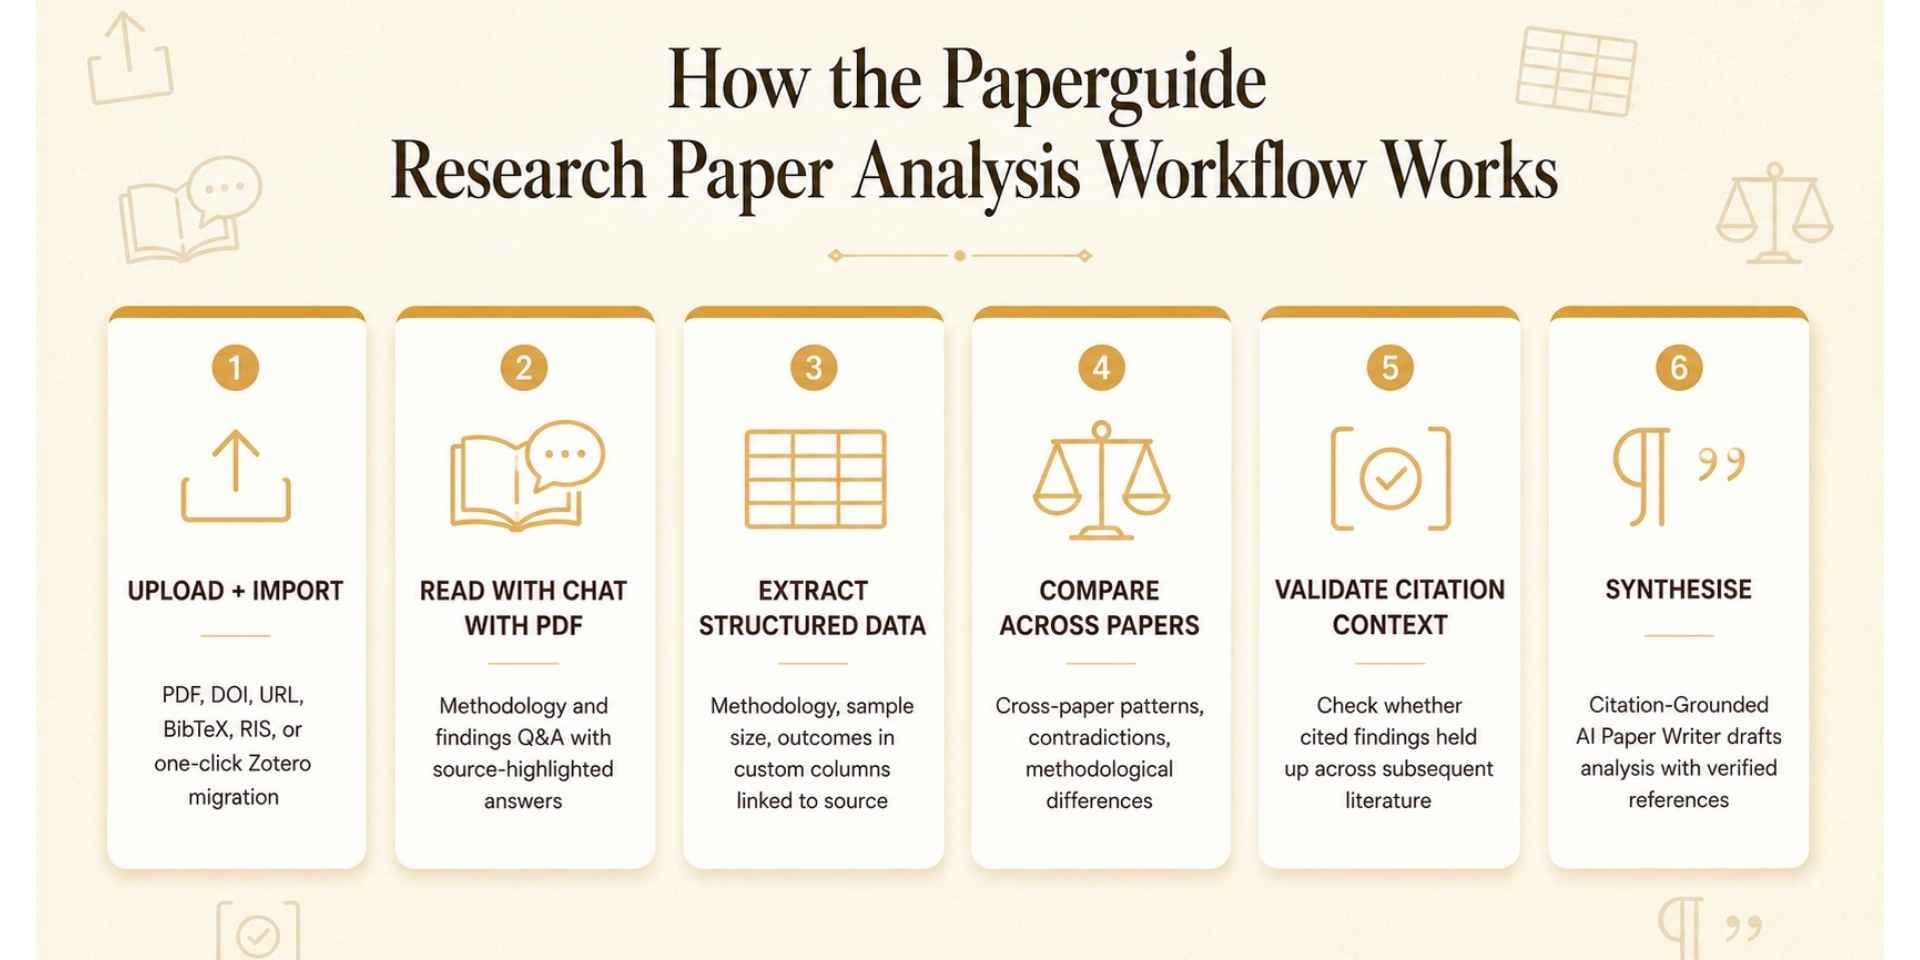
Die von Paperguide veröffentlichte sechsstufige Abfolge — Upload, Chat mit PDF, strukturierte Spalten, studienübergreifender Vergleich, Validierung des Zitationskontexts und anschließend zitiergestütztes Schreiben — beschreibt das extraktionsorientierte Muster klar. Unabhängige Angaben zu Genauigkeit und Preisen von Paperguide wurden für diesen Artikel nicht verifiziert; der Workflow selbst ist der nützliche Gegenstand des Vergleichs.
Wie funktioniert strukturierte Datenextraktion, wenn das Korpus Hunderte Studien umfasst?
Sie funktioniert, indem jede Studie in Zeilen protokolldefinierter Felder umgewandelt wird und diese Zeilen vor dem Schreiben eines Synthesetextes nach der Forschungsfrage gefiltert werden. Skalierung entsteht durch die Wiederholung eines Schemas, nicht durch eine längere Zusammenfassung.
Der erste Schritt ist die Aufnahme. PDFs, DOIs, URLs, BibTeX, RIS oder ein Export aus einer Literaturverwaltung bilden das Korpus. Chat mit PDF ist der zweite Schritt, nicht der letzte: Sie verwenden ihn, um Textstellen zu Methoden und Ergebnissen zu finden, und fixieren diese Stellen anschließend in Spalten. Eine fortlaufende Übersicht zur automatisierten Extraktion identifizierte 76 Publikationen zu diesem Thema, aber nur sechs implementierte Endnutzer-Tools, und 84 % der Algorithmen werteten nur Titel und Abstracts aus. Extraktion allein aus Abstracts übersieht Endpunkte, Subgruppenanalysen und Details zum Bias-Risiko, die im Volltext stehen. Jeder Workflow, der „Hunderte Studien“ allein anhand von Abstracts verspricht, fasst zusammen statt zu kodieren.
Benutzerdefinierte Spalten sollten zur Frage passen, nicht zur Standardvorlage eines Anbieters. Für eine Wirksamkeitsfrage sind typische Felder Design, Population, Intervention oder Exposition, Vergleichsgruppe, primärer Endpunkt, Effektrichtung, Effektgröße mit Intervall, Nachbeobachtung und Limitationen. Für eine Mechanismenfrage ersetzen Sie die Effektgröße durch den hypothetisierten Pfad und die Information, ob die Studie ihn tatsächlich geprüft hat. Die Verknüpfung jeder Zelle mit einer Textstelle der Quelle ermöglicht den späteren Vergleich. Ohne Fundstellen ist eine Tabelle lediglich eine weitere Zusammenfassung mit mehr Leerraum.
Hunderte Studien erzwingen außerdem die Verarbeitung in Stapeln. Kontextfenster, Ratenbegrenzungen und Fehler beim PDF-Parsing machen eine einmalige Extraktion eines vollständigen Korpus für einen systematischen Review unzuverlässig. Ein belastbares Muster lautet: Definieren Sie das Schema an einer Pilotmenge von 8–15 Studien, messen Sie die Übereinstimmung mit menschlicher Kodierung, frieren Sie den Prompt ein und verarbeiten Sie die übrigen Studien anschließend in Wellen. Der Prompt-Text bestimmt Vollständigkeit und Format; einzigartige Prompts pro Artikel lassen sich nicht verallgemeinern. Testen Sie an einer Teilmenge und halten Sie den Prompt danach konstant.
Jenova's Academic Research Assistant unterstützt dieses Muster, weil das Schema im persistenten Speicher abgelegt werden kann und die PDFs mit dem Projekt verbunden bleiben. Dennoch müssen Sie in Stapeln arbeiten. Die Matrix von Elicit ähnelt stärker einem nativen Kodierungsblatt für empirische Felder. Covidence setzt voraus, dass das Korpus das Screening bereits durchlaufen hat. Wählen Sie das Tool danach aus, in welcher Phase Sie sich tatsächlich befinden.
Wie validieren Sie extrahierte Befunde anhand des Zitationskontexts und Studiendesigns?
Sie validieren sie, indem Sie prüfen, ob die extrahierte Behauptung in der zitierten Passage, in späterer Literatur und über Studiendesigns hinweg, die dieselbe Frage beantworten, weiterhin trägt. Extraktion ohne diese Prüfungen reproduziert Zitationsbias mit Maschinengeschwindigkeit.
Validierung des Zitationskontexts bedeutet, die zitierte Textstelle zu öffnen und nicht dem zitierenden Satz zu vertrauen. Studien übertreiben regelmäßig, was eine Referenz gezeigt hat, zitieren Abstracts statt Ergebnisse oder führen Befunde fort, die spätere Studien widerlegt haben. Ein gesonderter Durchlauf zur Frage „Trifft dieser zitierte Befund zu?“ ist daher etwas anderes als die Frage „Was berichtete diese Studie?“. Paperguide-ähnliche Workflows platzieren diese Prüfung unmittelbar vor der Synthese, was die richtige Reihenfolge ist: Schreiben Sie den Absatz erst, wenn die Zelle stabil ist.
Designbewusste Validierung geht weiter. Eine Methodenabbildung aus dem Jahr 2025 in Nature Communications zeigt eine zweistufige Pipeline, die als nützliche Referenzarchitektur dient, selbst wenn Sie deren Bewertungsformeln nie übernehmen. Große Sprachmodelle zerlegen Freitext in Population, Intervention oder Exposition, Beziehung und Endpunkt und klassifizieren die Effektrichtung dann als Anstieg, Rückgang oder keine Veränderung. Diese Datensätze werden nach Design geschichtet — randomisierte Studien, Mendelsche Randomisierung und Beobachtungsstudien — damit ein Ergebnis nicht methodenübergreifend als austauschbar behandelt wird.
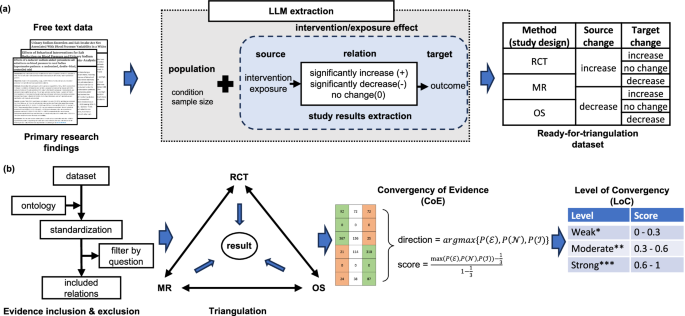
Der zweite Bereich ist der Teil, den die meisten Zusammenfassungstools überspringen. Nach Standardisierung und Einschlussfilterung werden Ergebnisse über die Designs hinweg trianguliert. Ein Convergence of Evidence-Score verwendet die Richtung mit der höchsten Wahrscheinlichkeitsmasse; ein Level-of-Convergence-Band kennzeichnet die Evidenzbasis anschließend als schwach, moderat oder stark. Sie benötigen diese exakte Metrik nicht, um das Prinzip anzuwenden. Sie müssen jedoch aufhören, eine signifikante Beobachtungsassoziation und eine Nullstudie so zusammenzuführen, als wären sie ein einziger Satz nach dem Muster „Die Literatur sagt X“.
Uneinigkeit zwischen Mensch und Modell sollte in einem dritten Durchgang anhand des PDF adjudiziert und nicht automatisch als Modellversagen gewertet werden. In einem Proof-of-Concept machte Claude 2 einen schwerwiegenden und fünf geringfügige Extraktionsfehler — und erkannte 21 geringfügige Fehler im menschlichen Referenzstandard. Veröffentlichte Extraktionen als Goldstandard zu behandeln, unterschätzt Modelle und überschätzt Menschen. Die korrekte Analyseeinheit ist die faktische Übereinstimmung jedes Feldes, wobei zusammengesetzte Statistiken wie Punktschätzer plus Intervall kohärent und nicht als drei unabhängige Zahlen gezählt werden.
Jenova kann den Durchlauf zur Prüfung des Zitationskontexts durchführen, weil es spätere Literatur durchsuchen und die ursprüngliche Extraktionstabelle im Speicher behalten kann. Es kann jedoch keinen zweiten menschlichen Gutachter für einen Cochrane-ähnlichen Review ersetzen. Covidence kann diesen zweiten Gutachter erzwingen. Nutzen Sie beide Tatsachen, ohne sie zu einem einzigen Gewinner zusammenzufassen.
Wie führen Sie einen forschungsfragengetriebenen Extraktions-Workflow in der Praxis durch?
Sie definieren zuerst die Frage und die Felder, testen das Schema an einer Pilotmenge, extrahieren in Stapeln mit Fundstellen, vergleichen die Zeilen, prüfen Zitationen erneut und schreiben dann anhand der Tabelle. Die Umkehrung dieser Reihenfolge — zuerst schreiben, später Zitate suchen — erzeugt das Zusammenfassungsproblem erneut.
Für Jenova's Academic Research Assistant sieht eine typische Abfolge so aus:
- Öffnen Sie den Agenten und formulieren Sie das Protokoll in einem Block, einschließlich Einschlusskriterien und der exakt gewünschten Spalten.
- Hängen Sie eine Pilotmenge von PDFs oder DOIs an, statt das vollständige Korpus hochzuladen.
- Extrahieren Sie in eine Tabelle und verlangen Sie für jede Zelle eine Fundstelle.
- Frieren Sie den Prompt ein, nachdem Sie die Pilotmenge korrigiert haben.
- Verarbeiten Sie die verbleibenden Studien in Stapeln und führen Sie vor jeder narrativen Synthese einen Durchlauf für Widersprüche sowie einen Durchlauf zur Prüfung des Zitationskontexts durch.
Ein nützlicher einleitender Prompt:
„Forschungsfrage: Reduziert Ketamin als Zusatzbehandlung bei Erwachsenen mit therapieresistenter Depression im Vergleich zu Placebo nach 24 Stunden die Montgomery–Åsberg-Werte? Schließe nur RCTs ein. Extrahiere für jede Studie: Design, randomisiertes n, Dosis und Applikationsweg, Vergleichsgruppe, primären Endpunkt, Zeitpunkt, Effektgröße mit 95%-KI, Richtung (Zunahme / Abnahme / keine Veränderung) und Limitationen. Zitiere für jede Effektgröße den Ergebnissatz. Fasse Studien, die die Einschlusskriterien nicht erfüllen, nicht zusammen. Markiere leere Zellen, statt Werte abzuleiten.“
Ein nützlicher Vergleichs-Prompt, nachdem die Tabelle vorliegt:
„Nutze ausschließlich die Extraktionstabelle und liste (1) Konflikte bei der Effektrichtung, (2) Unterschiede bei Dosis oder Zeitpunkt, die diese Konflikte erklären könnten, sowie (3) jede Zeile auf, deren zitierte unterstützende Studie älter ist als das jüngste Nullergebnis zum selben Endpunkt. Füge keine Studien hinzu, die nicht in der Tabelle stehen.“
Für Elicit besteht der analoge Weg aus Protokollverfeinerung, Quellensammlung, Screening und anschließend einer Matrix mit benutzerdefinierten Spalten — die Schritte, welche das Produkt für systematische Literatur-Reviews dokumentiert. Beginnen Sie mit empirischen Fragen, deren Felder wie n, Methoden und Endpunkte bereits zur Matrix passen. Erwarten Sie bei theoretischen Arbeiten nicht dieselbe Ausbeute.
Für Covidence führen Sie Suchimport, Dublettenentfernung, duales Screening von Titel und Abstract, Volltext-Screening und anschließend Extraktionsformulare durch. Bibliotheksleitfäden behandeln diese Softwareklasse als Umgebung für strukturierte, transparente und reproduzierbare Evidenzsynthese, nicht als Chatbot. Wenn Sie ein PRISMA-Flussdiagramm und zwei unabhängige Gutachter benötigen, beginnen Sie hier und verwenden Sie ein LLM nur innerhalb des Extraktionsformulars, während der zweite Gutachter weiterhin ein Mensch bleibt.
Zwei Betriebsregeln gelten für alle drei Ansätze. Erstens: Lassen Sie das Modell niemals eine Lücke mit einem plausiblen Wert füllen; leere Zellen sind Daten. Zweitens: Messen Sie die Zeit für die gesamte Aufgabe — Prompt-Iteration, Adjudikation und Korrektur — und nicht nur die Modelllatenz. Die für die Aufgabe benötigte Zeit ist das relevante Effizienzmaß, und Prompt Engineering ist Teil dieser Zeit.
Was sagen Forschende zur Evidenzsynthese über die Datenextraktion durch LLMs?
Forschende betrachten LLMs als vielversprechende Beschleuniger für Hintergrundfelder und als nicht bewiesenen Ersatz für die Extraktion von Endpunkten; auch das Validierungsdesign selbst bleibt ein offenes methodisches Problem. Der Konsens in Methodenarbeiten aus den Jahren 2025–2026 ist bedingt: innerhalb eines überwachten Workflows nützlich, als unbeaufsichtigter Extraktor noch nicht bereit.
„Der Engpass bei der Evidenzsynthese ist nicht die Lesegeschwindigkeit. Entscheidend ist, dass jede Studie dieselbe Frage in denselben Feldern beantwortet und dass sichtbar wird, wenn diese Felder nicht übereinstimmen. Eine Zusammenfassung kann flüssig formuliert und dennoch für diese Aufgabe unbrauchbar sein, weil sprachliche Flüssigkeit leere Zellen verbirgt. Als wir Teams vom Chat auf Studienebene zu forschungsfragenverankerten Tabellen umstellten, war das Erste, was sichtbar wurde, keine Erkenntnis — sondern fehlende Daten. Stichprobengrößen ohne Nenner, Endpunkte ohne Zeitpunkt, Zitationen, die den Satz, an den sie angehängt waren, nicht stützten.“
„Wir haben außerdem aufgehört, menschliche Extraktion als Goldstandard zu behandeln. Ein großer Anteil menschlich kodierter Studien enthält mindestens einen Extraktionsfehler, und Modelle erkennen mitunter solche Fehler, während sie andere einführen, insbesondere bei zusammengesetzten Statistiken. Die produktive Bewertungseinheit ist die faktische Übereinstimmung pro Feld, adjudiziert anhand des PDF. Solange ein Workflow diesen Kreislauf nicht zeigen kann — Schema, Fundstelle, Stapel, Widerspruch, erneute Zitation — ist er ein Zusammenfasser, unabhängig davon, wie viele Studien er angeblich gelesen hat.“
— Jenova-Produktteam, Design von Forschungs-Workflows, Erfahrung beim Aufbau langfristiger akademischer Agent-Projekte von der Literatursuche bis zur Manuskriptvorbereitung
Diese Position stimmt mit unabhängigen Kommentaren überein. Ein Scoping Review zu LLMs in systematischen Reviews kam zu dem Schluss, dass sie zunehmen, aber noch nicht einsatzbereit sind als eigenständige Infrastruktur. Separate Arbeiten zu Sprachmodellen für Datenextraktion und Bias-Risiko-Bewertung testen gemischte Mensch-Modell-Pipelines statt modellbasierter Reviews ohne Menschen. Die zentrale Frage im Feld lautet nicht „Kann ein Modell 400 PDFs lesen?“, sondern „Kann eine protokollierte, nach Forschungsfrage gefilterte Tabelle einer dualen Begutachtung standhalten?“
Wann sollten Sie weiterhin spezialisierte Software für systematische Reviews statt eines AI-Forschungsagenten verwenden?
Verwenden Sie spezialisierte Software für systematische Reviews, wenn Sie ein duales unabhängiges Screening, einen berichtsfähigen PRISMA-Fluss und einen Prüfpfad benötigen, den eine Fachzeitschrift, ein HTA-Gremium oder ein Leitlinienpanel überprüfen wird. Verwenden Sie einen AI-Forschungsagenten, wenn Sie die Frage noch entwickeln, ein lebendes Korpus kodieren oder eine stabile Tabelle in ein Manuskript überführen. Die beiden Ansätze folgen häufiger aufeinander, als dass sie Rivalen sind.
Covidence, DistillerSR, EPPI-Reviewer und JBI-SUMARI existieren, weil reproduzierbare Methoden, Team-Workflows und PRISMA-konforme Dokumentation bei interventionellen Reviews Anforderungen und keine Präferenzen sind. Maschinelles Lernen innerhalb dieser Plattformen hat bisher vor allem beim Screening geholfen — eine Bewertung schätzte Reduktionen des Screening-Aufwands um bis zu 60 % — während Tools für Extraktion und Bias-Risiko-Bewertung weiterhin weniger ausgereift sind. Wenn Ihr Ergebnis ein registrierter Review ist, sollten Sie diesen Stack nicht überspringen, nur weil ein Chatmodell PDFs paraphrasieren kann.
Ein Agent ist die bessere tägliche Umgebung, wenn sich die Forschungsfrage noch bewegt. Sie können neue PDFs anhängen, Spalten überarbeiten und Protokollentscheidungen im Speicher behalten, ohne für jede Kursänderung ein neues Review-Projekt zu eröffnen. Jenova's Academic Research Assistant ist für diesen Modus konzipiert: aktuelle wissenschaftliche Suche, angehängte Volltexte, persistente Extraktionsschemata und ein Weg in das zitationsverwaltete Schreiben. Er erfüllt kein Protokoll, das zwei Screener verlangt. Diese Grenze zu benennen, gehört zur korrekten Nutzung.
Eine praktische Aufteilung, die viele Gruppen im Jahr 2026 verwenden, sieht so aus: Erkunden Sie das Feld und definieren Sie Felder mit einem Agenten oder mit Elicit. Registrieren Sie das Protokoll. Führen Sie Screening und Extraktion in Covidence oder einem gleichwertigen Tool durch, optional mit LLM-gestützter Kodierung, die ein Mensch weiterhin überprüft. Kehren Sie zum Agenten zurück, um den Zitationskontext kritisch zu prüfen und aus der finalisierten Tabelle zu schreiben. Die Auflistung von Duke zum Werkzeugkasten für Evidenzsynthese erinnert daran, dass keine einzelne Anwendung jede Phase abdeckt; die professionelle Kompetenz besteht darin, zu wissen, in welcher Phase Sie sich befinden.
Der Test, der über den Stack entscheiden sollte, ist derselbe Test, mit dem dieser Artikel begann. Wenn Sie auf eine Forschungsfrage, eine Spalte für jedes Element dieser Frage, eine Fundstelle für jede Zelle und eine Dokumentation dessen, was ausgeschlossen wurde, verweisen können, extrahieren Sie Evidenz. Wenn Sie nur eine gut geschriebene Übersicht darüber haben, „was die Studien sagen“, fassen Sie weiterhin zusammen — selbst wenn die Übersicht aus Hunderten von Dateien generiert wurde.
Referenzen
- PRISMA Statement — Berichtsleitlinien für systematische Reviews
- The BMJ — Das PRISMA-2020-Statement: eine aktualisierte Leitlinie zur Berichterstattung systematischer Reviews
- ScienceDirect — LLMs in systematischen Reviews: auf dem Vormarsch, aber noch nicht einsatzbereit (Scoping Review)
- PMC — Digitale Tools zur Unterstützung des Prozesses systematischer Reviews
- BMJ Evidence-Based Medicine — Herausforderungen und Fallstricke bei der Bewertung von LLMs für Datenextraktion
- Oregon State University Libraries — Vergleich von AI-Tools für die Literaturrecherche
- Elicit — Workflow für systematische Literatur-Reviews
- Covidence — Software für das Management systematischer Reviews
- UCL Library Guides — Software für systematische Reviews
- Nature npj Digital Medicine — Sprachmodelle für Datenextraktion und Bias-Risiko-Bewertung
- Duke University Libraries — Software und Tools für Evidenzsynthese