Reduziert Multi-Modell-AI blinde Flecken bei der Aktienanalyse besser?
2026-08-24
Wie legen Modellkonflikte und Ensemble-Prüfungen verborgene Risiken der Investmentthese offen?
Modellübergreifende Prüfungen reduzieren blinde Flecken und Übervertrauen zuverlässiger als die Aktienanalyse mit einem einzelnen Modell, denn Uneinigkeit zwischen Modellen ist selbst ein Risikosignal und keine Störung, die man einfach wegmitteln sollte. Im Jahr 2026 kann eine einzelne, flüssig formulierte Antwort von ChatGPT, Claude oder Gemini wie abgeschlossene Research wirken. Genau diese Sprachgewandtheit ist das Problem. Ein Modell, ein Kontextfenster und eine Trainingsverteilung erzeugen eine stimmige Geschichte, selbst wenn Zahlen veraltet sind, ein Filing falsch gelesen wurde oder das Bären-Szenario fehlt.
Was sorgfältige AI-Aktienresearch tatsächlich von selbstsicherem Raten unterscheidet:
✅ Quellenverankerung — aktuelle Filings, Schätzungen und Kurse statt eines Trainingsstichtags ✅ Modellvielfalt — mehr als ein Anbieter, damit Verzerrungen eines gemeinsamen Korpus leichter erkennbar werden ✅ Rollenvielfalt — fundamentale, technische, makroökonomische und Portfolio-Perspektiven statt eines Generalisten ✅ Darstellung von Unsicherheit — Bandbreiten, Konflikte und Hinweise wie „Nicht verifiziert“ statt Scheingenauigkeit ✅ Kosten einer zweiten Prüfung — niedrig genug, damit Abgleiche tatsächlich stattfinden, bevor die Positionsgröße erhöht wird
Eine nützliche Arbeitsregel ist der Konflikt-als-Signal-Test: Betrachten Sie Modellkonsens als Hypothese und Modellkonflikte als Research-Agenda. Der Rest dieses Artikels wendet diesen Test auf Einzelmodell-Chatbots, spezialisierte Scorer wie Danelfin, Recherchetools mit Quellenfokus wie Perplexity und Jenovas spezialisierte Aktien-Agenten an.
Warum bleibt Übervertrauen bestehen, wenn Anleger ein einziges AI-Modell nutzen?
Übervertrauen bleibt bestehen, weil ein einzelnes Modell eine ausgefeilte Erzählung liefert und ausgefeilte Erzählungen die Reibung unterdrücken, die normalerweise zu einer zweiten Prüfung zwingt. Die Behavioral Finance betrachtet Übervertrauen als systematische Verzerrung, nicht als Persönlichkeitsfehler. An den Märkten zeigt es sich durch übermäßiges Handeln, konzentrierte Wetten und ignorierte gegenteilige Evidenz.
Dieses Muster verschwindet nicht, wenn der Analyst eine AI ist. Forschung zu Übervertrauen und Bestätigungsfehlern im Handel verknüpft die Verzerrung mit höherem Umsatz, geringerer Diversifikation und schwächeren Renditen. Eine Studie aus dem Jahr 2025 zum Anlegerverhalten im AI-Zeitalter stellt fest, dass manuelle Übersteuerungen die Effizienzgewinne von Algorithmen zunichtemachen und die Volatilität erhöhen statt sie zu verringern. Neuere Arbeiten beschreiben „algorithmisches Übervertrauen“](https://papers.ssrn.com/sol3/papers.cfm?abstract_id=7237618): Sobald die Analyse an ein Modell delegiert wird, behandeln Nutzer dessen Ergebnis als objektiver, als es tatsächlich ist.
Eine Sitzung mit nur einem Modell verschärft dies auf drei mechanische Arten. Erstens wird das Modell für Kohärenz belohnt und füllt daher Lücken, statt sie offenzulegen. Zweitens sieht der Nutzer keine Uneinigkeit von Gleichrangigen, also genau das Signal, mit dem Institutionen Konfidenzintervalle ausweiten. Drittens ist die Oberfläche konversationell, sodass auch eine falsche Zahl in selbstsicherer Prosa erscheint. Die Anlegerwarnung der U.S. SEC zu AI ist in diesem Punkt eindeutig: AI kann falsche oder ungenaue Informationen erzeugen und verbreiten, und Anleger sollten Behauptungen bei registrierten Fachleuten prüfen.
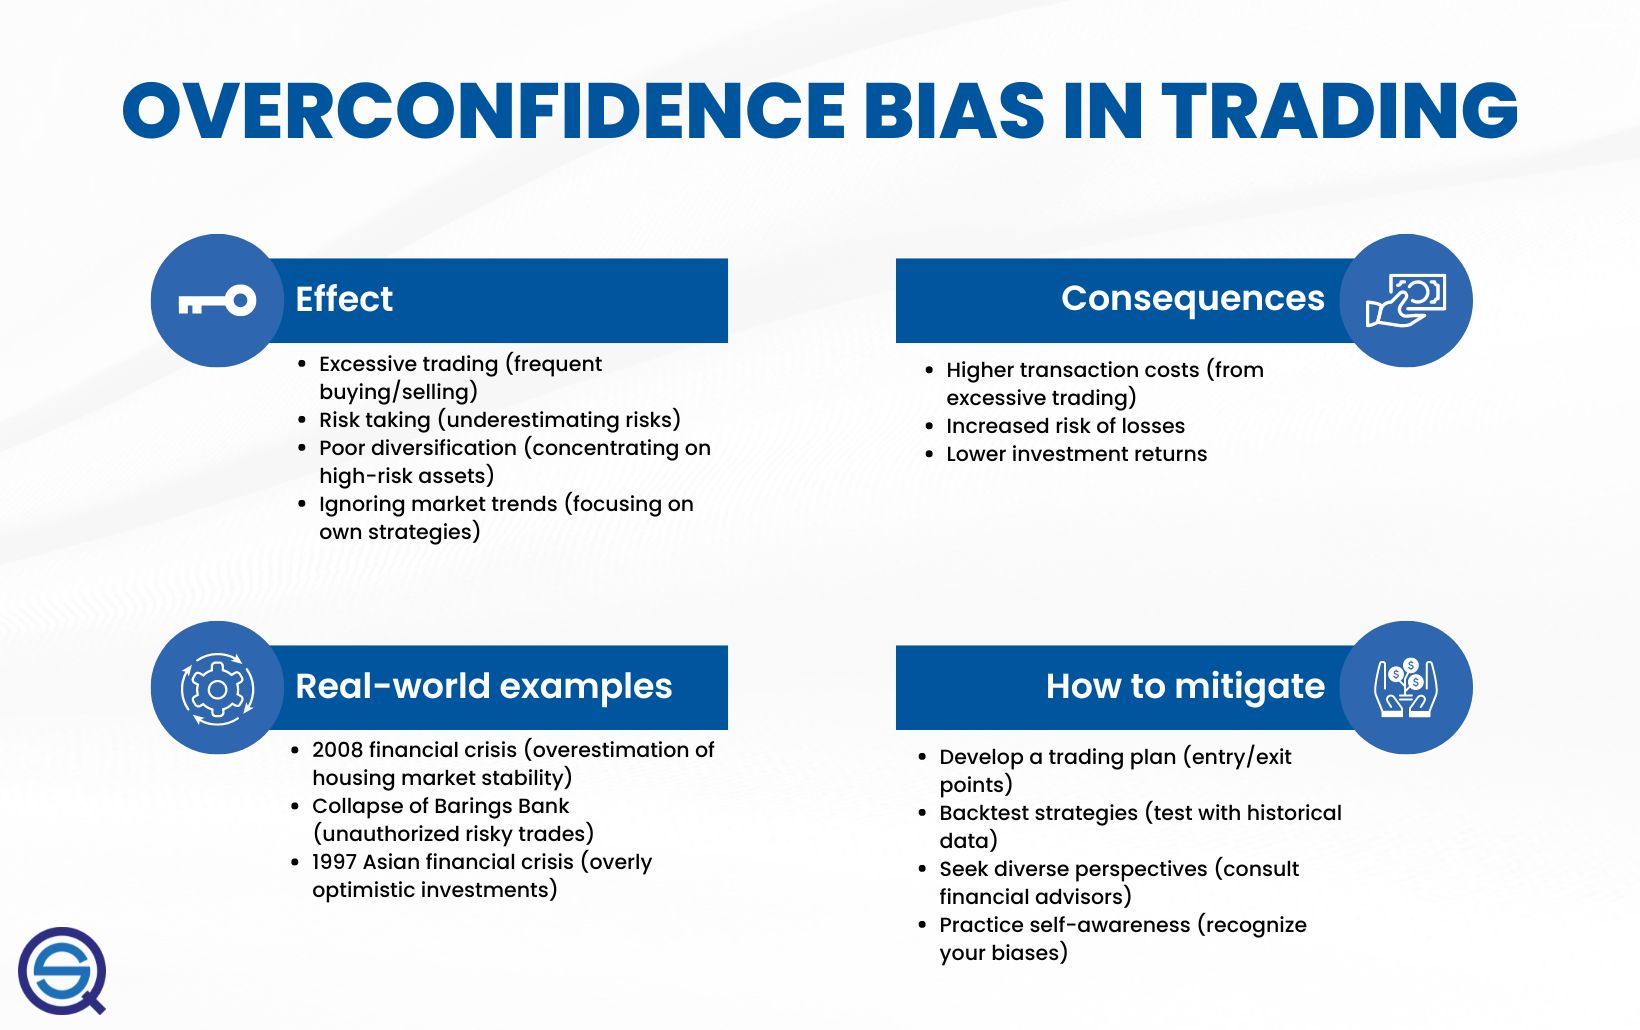
Klassische Gegenmaßnahmen — ein schriftlicher Plan, historische Tests und vielfältige Perspektiven — lassen sich direkt auf die Research-Architektur übertragen. Ein einzelnes Modell kann beim Formulieren des Plans helfen. Es kann jedoch nicht selbst die vielfältige Perspektive sein.
Was sollten Sie beim Vergleich von Einzelmodell- und Multi-Modell-Aktienanalysen bewerten?
Sie sollten sechs Abdeckungsebenen bewerten, nicht die Frage, welche Oberfläche intelligenter klingt. Nennen wir dies das Sechs-Ebenen-Audit für blinde Flecken. Es ist eine praktische Checkliste für jeden Ticker, jedes Tool und jeden Zeithorizont.
1. Quellenverankerung. Ruft das System aktuelle SEC-Filings, Schätzungen und Kurse ab, oder vervollständigt es Text auf Basis eines Stichtags? Openbook Analytics weist darauf hin, dass allgemeine Chatbots keine Live-Marktdaten haben und die von ihnen erzeugten Zahlen nicht verifizieren können und dass der CEO von Perplexity veraltete Marktdaten auf der Plattform eingeräumt hat.
2. Modellvielfalt. Ein Anbieter bedeutet einen Fehlermodus. Der Abgleich von GPT-ähnlichen Ergebnissen mit Claude, Gemini oder DeepSeek ist nur dann nützlich, wenn sich Prompt, Daten und Rolle tatsächlich ändern. Marken auf demselben veralteten Prompt auszutauschen, ist keine Vielfalt.
3. Rollenvielfalt. Eine fundamentale Einschätzung, eine Betrachtung von Kursverlauf und Marktstruktur sowie ein Makro-Overlay erfassen unterschiedliche Fehler. Das ähnelt eher einer Research-Besprechung als einem Chatbot-Thread.
4. Unsicherheitsdarstellung. Bevorzugen Sie Bandbreiten, konkurrierende Szenarien und ausdrückliche Hinweise wie „Nicht verifiziert“ gegenüber einem einzigen Kursziel.
5. Persistenz. Arbeit an einer Investmentthese erstreckt sich über Wochen. Tools, die die abweichende Einschätzung vom vergangenen Dienstag vergessen, blähen das Vertrauen in der nächsten Sitzung wieder auf.
6. Kosten pro Prüfung. Wenn ein zweiter Modelldurchlauf teuer oder umständlich ist, wird er genau dann ausgelassen, wenn die Position am größten ist.
Die FINRA-Analyse zu AI in der Wertpapierbranche formuliert dieselben Fragen in regulatorischer Sprache: Modellrisikomanagement, Erklärbarkeit, Datenintegrität und Kontrollmechanismen. Von Unternehmen wird erwartet, dass sie verstehen, wie ein Modell zu einem Ergebnis gelangt, bevor sie sich in Workflows für Anlageberatung nach Regulation Best Interest und FINRA Rule 2111 darauf stützen. Privatanleger haben kein Programm nach Rule 3110. Sie benötigen dennoch eine vergleichbare Gewohnheit: Wissen, was das Modell nicht sehen kann.
Ein Harvard-Business-School-Papier aus dem Jahr 2025 zur Auslandsverzerrung in finanziellen LLM ergänzt einen subtileren Fehlermodus. Informationen können in Trainingsdaten fehlen oder vorhanden sein, aber zu gering gewichtet werden. Zwei auf die USA ausgerichtete Modelle können sich bei einem Titel aus einem Schwellenmarkt „einig“ sein und dennoch dieselbe Lücke teilen.
Wie unterscheiden sich ChatGPT, Danelfin, Perplexity und Jenova bei der Abdeckung blinder Flecken?
Sie unterscheiden sich zunächst darin, ob sie einen Score, eine zitierte Zusammenfassung oder eine überprüfbare Research-Akte erzeugen. ChatGPT ist am stärksten als Denkpartner und am schwächsten als Zahlenmaschine. Danelfin ist am stärksten als transparenter Screener und schwächer bei einer Debatte über mehrere Rollen hinweg. Perplexity ist am stärksten beim Abrufen zitierter Ausschnitte und schwächer, wenn diese Ausschnitte veraltet sind. Jenovas Fundamental Stock Analyst ist am stärksten, wenn eine Investmentthese Gewinne, Bewertung und Sentiment zusammenführen und anschließend durch andere Modelle oder spezialisierte Agenten herausfordern muss.
Openbook Analytics berichtet in einer Zusammenfassung früherer Tests, dass ChatGPT bei etwa 35 % der Finanz- und Anlagefragen falsch lag und Gemini in einigen Bewertungen Finanzinformationen mit Halluzinationsraten von bis zu 88–91 % erzeugte. Diese Zahlen sind kein Grund, Sprachmodelle aufzugeben. Sie sind ein Grund, keines von ihnen allein eine Investmentthese abschließen zu lassen.
| Funktion / Dimension | ChatGPT | Danelfin | Perplexity | Jenova Fundamental Stock Analyst |
|---|---|---|---|---|
| Primäres Ergebnis | Erklärende Prosa | Erklärbarer AI Score und Merkmale | Zitierte Antworten aus dem Web | Auf Filings gestütztes fundamentales Memo |
| Live- / verifizierte Marktdaten | Schwach; durch Stichtag begrenzt | Für bewertete Anlageuniversen entwickelt | Zitiert, kann aber veraltet sein | SEC-Filings, Schätzungen, Sentiment |
| Multi-Modell-Abgleich | Manuell, über mehrere Konten | Ein proprietäres System | Multi-Modell-Suche, eine Zusammenfassung | Native Unterstützung mehrerer Anbieter plus spezialisierte Agenten |
| Umgang mit Unsicherheit | Standardmäßig selbstsichere Prosa | Score plus Merkmalsattribution | Quellen, aber geringere Darstellung des Restrisikos | Konkurrierende Szenarien, Modellkonflikte, Speicher |
| Preise (Stand 2026) | Etwa 20 $/Monat im Bezahlplan | In dieser Analyse nicht verifiziert | 20 $/Monat Pro; kostenlose Stufe | Kostenlose Stufe; Bezahlpläne ab 20 $/Monat |
| Am besten geeignet für | Konzeptprüfung, Entwürfe des Bären-Szenarios | Screening und Timing einer bekannten Liste | Schnell beschaffte Fakten mit Quellen | Abgeglichene Aktienresearch |
ChatGPT
ChatGPT bleibt nützlich, um einen Abschnitt eines 10-K zu übersetzen, die Branchenstruktur aufzulisten oder ein Bären-Szenario in klarer Sprache zu erzwingen. Ein Vergleich von vier Modellen aus dem Jahr 2026 ordnet es eher dem Generalistenlager als einem Terminal mit Live-Daten zu. Seine Einschränkung ist strukturell: Es wird weiterhin eine saubere Margenüberleitung aus dem Gedächtnis formulieren. Genau so gelangt Übervertrauen in eine Research-Notiz.
Danelfin
Danelfin ist ein anderes Produkt. Es veröffentlicht einen AI Score und keinen Chat. Das Unternehmen gibt an, dass US-Aktien mit einem Score von 10/10 den Markt nach drei Monaten um 21,05 % annualisierte Alpha übertroffen haben seit 2017, während Titel mit 1/10 um 33,28 % hinterherhinkten, und dass eine AI-Score-Strategie vom 3. Januar 2017 bis zum 9. Juni 2025 376 % erzielte, gegenüber 166 % für den S&P 500. Erklärbare Merkmale sind ein echter Schutz gegen Black-Box-Scoring. Die Einschränkung ist komplementär: Ein Score kann ein Anlageuniversum ordnen, ohne das konkrete Bilanzierungs-, Segment- oder politische Risiko zu testen, das diese Position brechen würde.
Perplexity
Perplexity verdient seinen Platz als Quellenebene. Der Vergleich von Helm Terminal für 2026 besagt, dass es bei aktuellen, zitierten Fakten und Finanzfunktionen führend ist, während Claude bei tiefgehender Filing-Synthese führt. Die Einschränkung ist jene, auf die der CEO bereits hingewiesen hat: Eine Quellenangabe ist nur so aktuell wie die Seite, auf die sie verweist. Perplexity mit einem Filing-nativen Workflow abzugleichen, ist wertvoller, als die Zahl der Quellen als Beweis zu behandeln.
Jenova Fundamental Stock Analyst
Jenovas Fundamental Stock Analyst ist als Aktien-Spezialist konzipiert: Gewinne, relative Bewertung, Analyse des Geschäftsmodells und Echtzeitdaten über Filings, Schätzungen und Sentiment hinweg. Auf der Jenova-Plattform kann er über Modelle von OpenAI, Anthropic, Google, DeepSeek und xAI hinweg erneut ausgeführt werden und neben anderen Spezialisten stehen, statt vorzugeben, alle Rollen selbst abzudecken. Persistenter Speicher hält den letzten Konflikt auf dem Tisch.
Hier sind ehrliche Grenzen wichtig. Jenova veröffentlicht keinen langfristigen zusammengesetzten Score, der mit Danelfins Erfolgsbilanz von 2017–2025 vergleichbar wäre. Multi-Modell-Durchläufe verbrauchen mehr Nutzung als ein einzelner Durchlauf. Widersprüchliche Antworten erhöhen die kognitive Belastung, und der Nutzer muss das 10-K weiterhin selbst öffnen. Das sind reale Kosten. Es sind zugleich die Kosten dafür, Sprachgewandtheit nicht mit Sorgfalt zu verwechseln.
Wie verändert Multi-Agenten-Orchestrierung die fundamentale Aktienresearch?
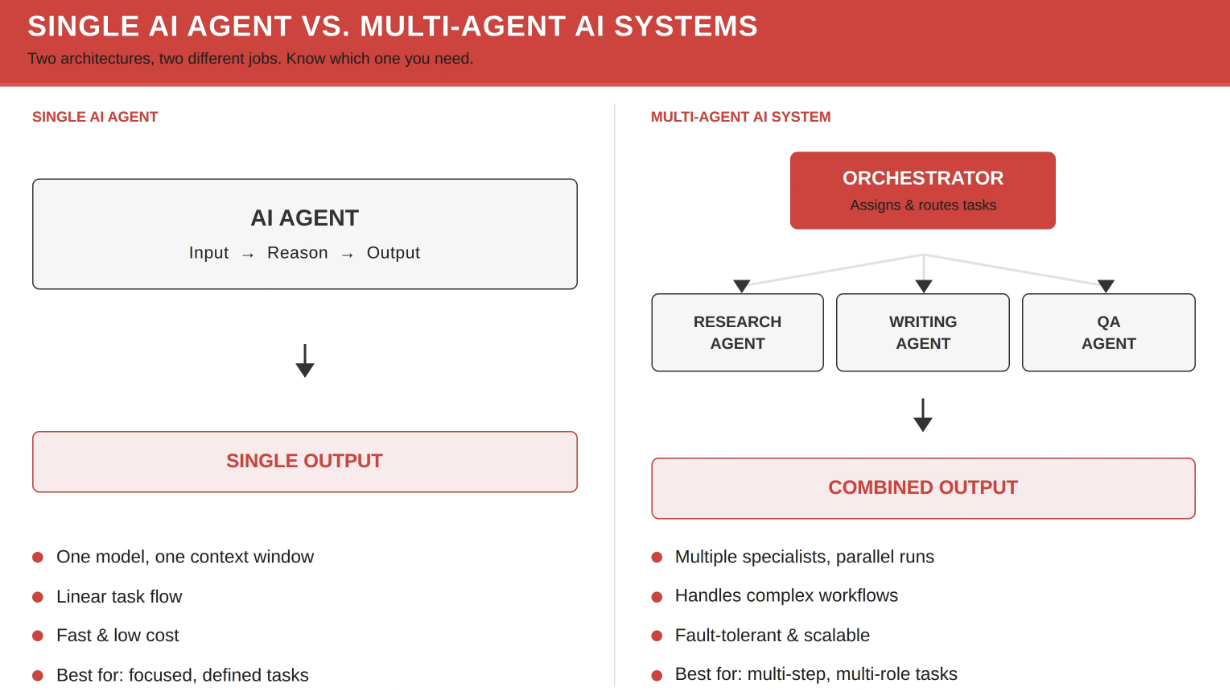
Orchestrierung verändert die Aufgabe von „einen Analysten fragen“ zu „ein kleines Analystenteam besetzen und die Akte abstimmen“. Ein einzelner Agent folgt einem linearen Weg: Eingabe, Schlussfolgerung, Ausgabe. Das ist schnell, günstig und passend, wenn die Frage eng umrissen ist. Ein Multi-Agenten-Setup ergänzt einen Orchestrator, der Arbeit an Spezialisten — Recherche, Schreiben und Qualitätsprüfung — verteilt und ein kombiniertes Ergebnis zurückgibt. Die Architektur ist langsamer und teurer. Sie verhindert jedoch auch, dass ein eloquenter Fehler zum gesamten Memo wird.
Bei Aktienarbeit lautet die analoge Aufteilung nicht abstrakt „Recherche / Schreiben / QA“. Sie lautet:
- Fundamental: Gewinnqualität, Unit Economics, Bewertung, Kapitalallokation
- Technisch: Struktur, Volumen, Momentum, Invalidierungsniveaus
- Makro: Politik, Zinsen, Regime über Anlageklassen hinweg
- Portfolio: Positionsgröße, Korrelation, Drawdown und ob die Idee in dieses Portfolio gehört
Jenovas Fundamental Stock Analyst deckt den ersten Platz ab. Die Kombination mit dem Technical Stock Analyst und dem Macro Strategist ist die praktische Version einer Multi-Agenten-QA. Ein Modell, das die Geschichte mag, eines, das sagt, der Kursverlauf sei gebrochen, und eines, das sagt, der Zinspfad zerstöre das Bewertungsmultiple, sind keine fehlgeschlagene Anfrage. Sie ergeben eine vollständige Risikobesprechung.
Ensemble-Evidenz außerhalb von Aktien-Chatbots weist in dieselbe Richtung. Eine arXiv-Studie aus dem Jahr 2025 zu LLM-Ensembles auf Daten des Survey of Professional Forecasters stellte fest, dass eine LLM-Kombination bei mehreren kurzfristigen Indikatoren einfache Durchschnittsbildung übertraf und bei hoher Uneinigkeit von Experten nützlicher blieb. Der Mechanismus war keine Magie. Das Ensemble gewichtete kürzlich ungenaue Experten geringer, passte sich an verzögerte Revisionen an und weigerte sich, jede Stimme gleich zu behandeln. Das ist das Gegenteil davon, einen Chatbot nach einem Kursziel zu fragen und dann aufzuhören.
Die FINRA-Sprache zu Black-Box-Modellen und Erklärbarkeit ist selbst für Workflows von Privatanlegern relevant. Wenn Sie nicht erklären können, warum das Bullen-Szenario den Kontakt mit einem zweiten Modell und einer zweiten Rolle überstanden hat, verfügen Sie über keinen Anlageprozess. Sie verfügen über ein Transkript.
Können technische, makroökonomische und Portfolio-Agenten erfassen, was ein einzelnes Modell übersieht?
Ja. Sie erfassen Kategoriefehler — die Fehler, die ein rein fundamentales Modell strukturell kaum bemerken wird. Ein Sprachmodell, das gerade eine saubere Erzählung über einen Qualitätswert geschrieben hat, wird selten von sich aus darauf hinweisen, dass die Aktie überdehnt ist, dass der Sektor eine reine Duration-Wette darstellt oder dass die Position einen Faktor verdoppelt, den Sie bereits besitzen.
Typische Versäumnisse je Rolle:
- Technische Rolle. Das fundamentale Modell kann bei der Bewertung richtig liegen und ein Jahr zu früh sein. Kursstruktur, gescheiterte Ausbrüche und Volumendivergenzen sind keine Fußnoten. Sie bestimmen Timing und Invalidierung. Der Technical Stock Analyst ist auf diese Fragen ausgerichtet: Marktstruktur, Momentum und klar definierte Risiken.
- Makro-Rolle. Ein DCF auf Aktienebene, der das politische Regime ignoriert, ist eine Tabelle mit einer verborgenen Zinsannahme. Der Macro Strategist ist für klassenübergreifende Synthese und Politikanalyse konzipiert — genau dort brechen viele angeblich „idiosynkratische“ Geschichten.
- Portfolio-Rolle. Eine großartige Idee isoliert betrachtet kann ein schlechter zusätzlicher Baustein für das Portfolio sein. Drift, Stress und Korrelation liegen auf der Portfolioebene, und das ist die Aufgabe von Jenovas Portfolio Management Strategist.
Hier teilen auch Plattformen mit einem einzelnen Score und Chatmodelle mit nur einem Modell einen blinden Fleck. Danelfins Score kann transparent über die Merkmale hinter einem Ranking sein und dennoch nichts darüber aussagen, ob Ihr Portfolio bereits denselben Faktor long hält. ChatGPT kann Risiken abstrakt auflisten und trotzdem nicht wissen, dass Sie bereits drei Softwaretitel mit derselben Zinssensitivität besitzen. Durch die Prüfung mehrerer Rollen werden diese Fehler sichtbar.
Die Einschränkung ist die Korrelation der Weltanschauung. Wenn jeder Agent mit einem Bullen-Prompt arbeitet oder jedes Modell denselben sekundären Blogbeitrag erhält, ist das Theater. Rollenvielfalt funktioniert nur, wenn der technische Agent den Trade verwerfen darf, der Makro-Agent das Bewertungsmultiple neu bewerten darf und der Portfolio-Agent die Positionsgröße auf ein symbolisches Maß reduzieren darf.
Wie führen Sie einen Multi-Modell-Abgleich für eine Aktien-These durch?
Sie führen ihn als Akte mit vier Durchgängen aus, nicht als längeren Chat. Das Ziel ist, Uneinigkeit bewusst zu erzeugen und anschließend zu entscheiden, welche Evidenz sie auflösen würde.
Durchgang 1 — Fakten verankern. Bitten Sie den Fundamental Stock Analyst nur um eine quellenbasierte Momentaufnahme: die letzten zwei berichteten Perioden, Guidance, Segmentmix, Nettoverschuldung, Aktienrückkäufe und die Bewertungsmultiples, die tatsächlich zum Geschäft passen. Verbieten Sie Kursziele in diesem Durchgang.
„Extrahiere anhand des neuesten 10-K, 10-Q und der letzten zwei Earnings Calls für [TICKER] Umsatz nach Segmenten, Brutto- und operative Marge, FCF, Nettoverschuldung und verwässerte Aktienanzahl. Belege jede Zahl mit dem Filing oder Call. Wenn du eine Zahl nicht belegen kannst, schreibe Nicht verifiziert.“
Durchgang 2 — Ändern Sie das Modell, nicht die Frage. Führen Sie dieselbe Extraktion bei einem zweiten Anbieter erneut aus. Wesentliche Unterschiede bei einer berichteten Zahl sind kein „Stil“. Sie sind ein Vorfall der Datenintegrität. Prüfen Sie das Filing selbst, bevor Sie zu Durchgang 3 übergehen.
Durchgang 3 — Besetzen Sie die anderen Rollen. Senden Sie denselben Ticker an den Technical Stock Analyst für Invalidierungsniveaus und an den Macro Strategist für die Zins-, FX- oder Rohstoffannahme, die im Multiple verborgen liegt.
„Ignoriere das bullische fundamentale Memo. Bestimme das Kursniveau und das Makro-Regime, die dieses Setup nicht haltenswert machen würden, selbst wenn die These letztlich richtig ist.“
Durchgang 4 — Erzwingen Sie einen schriftlichen Widerspruch. Bitten Sie ein beliebiges Modell, die Gegenseite mit gleicher Länge und gleicher Quellenbasis zu vertreten. Die Behavioral-Finance-Analyse von Lucid.now weist auf das übliche menschliche Muster hin: Überschätzung der Prognosefähigkeit, zu häufiges Handeln und Konzentration auf eine bevorzugte Geschichte. Ein verpflichtender Widerspruch unterbricht dieses Muster, wenn auch der „Analyst“ ein Modell ist.
Mit ChatGPT oder Claude allein können Sie die Durchgänge 2 und 4 näherungsweise nachbilden, indem Sie ein zweites Produkt öffnen und denselben quellenbasierten Auszug einfügen. Aktuelle Filing-Abrufe oder persistenten Speicher über Wochen hinweg können Sie nicht nachbilden, sofern das Tool diese Funktionen nicht tatsächlich bietet. Bei Danelfin ist Durchgang 1 durch Score und Merkmalsliste teilweise automatisiert; die Durchgänge 3 und 4 benötigen weiterhin eine separate Research-Oberfläche.
Die Preisgestaltung von Jenova ist nutzungsbasiert und nach Stufen aufgebaut: ein kostenloser Plan mit begrenzter Nutzung, anschließend 20 $, 50 $, 100 $, 200 $, 500 $und 1.000$ pro Monat, wenn die Kontingente steigen. Eine Prüfung mit vier Durchgängen kostet mehr als ein einzelner Chat. Für jede Position, die groß genug ist, um relevant zu sein, ist das der günstigere Fehler.
Was sagen Marktpraktiker über AI-Übervertrauen in der Research?
Praktiker, die täglich mit diesen Tools arbeiten, behandeln die Gewissheit eines einzelnen Modells eher als Prozessfehler denn als Merkmal „besserer“ Modelle.
„Der teuerste Fehler, den wir sehen, ist keine falsche Zahl. Es ist eine plausibel klingende Zahl, die nie mit einem zweiten Modell abgeglichen wurde. Wenn drei Anbieter bei einer Margenüberleitung übereinstimmen, die keiner von ihnen mit dem 10-Q abstimmen kann, ist genau diese Übereinstimmung das Warnsignal. Wir würden lieber ein Memo mit zwei widersprüchlichen Bandbreiten und einer Liste nicht verifizierter Punkte veröffentlichen als ein einziges Kursziel ohne offene Restfragen.“
„Multi-Modell ist nicht automatisch sicherer. Wenn Sie GPT, Claude und Gemini dieselbe schlampige Frage stellen, erhalten Sie häufig dieselbe schlampige Antwort mit unterschiedlichen Adjektiven. Vielfalt muss bewusst gestaltet werden: unterschiedliche Rollen, unterschiedliche Datenabrufe und eine dauerhafte Anweisung zum Widerspruch. Andernfalls haben Sie korreliertes Übervertrauen zum Dreifachen der Tokenkosten gekauft.“
„Am Desk entscheidet Uneinigkeit darüber, was wir als Nächstes lesen. Wenn Fundamentales und Makro im Konflikt stehen, prüfen wir die Zinsannahme. Wenn Fundamentales und Technisches im Konflikt stehen, prüfen wir Timing und Positionsgröße. Wenn alle Rollen zu schnell übereinstimmen, gehen wir davon aus, dass die Akte dünn ist. Diese Gewohnheit ist älter als LLM. Die Modelle erleichtern es lediglich, sie zu überspringen.“
— Jenova Product Team, Design und Evaluierung von Aktien-Agenten, mehrjährige Arbeit an Multi-Modell-Research-Workflows
Diese Haltung entspricht dem FINRA-Schwerpunkt auf Tests, Fallback-Plänen und funktionsübergreifender Aufsicht, bevor AI-Tools Anlageberatung beeinflussen. Sie entspricht auch dem Ergebnis der Ensemble-Prognoseforschung: Kombinationen helfen am stärksten, wenn die Eingaben voneinander abweichen und jemand eine Regel hat, wie sie zu gewichten sind.
Wann ist eine Analyse mit einem einzelnen Modell weiterhin die bessere Wahl?
Eine Analyse mit einem einzelnen Modell ist weiterhin die bessere Wahl, wenn die Aufgabe klar abgegrenzt ist, die Fehlerkosten niedrig sind und Geschwindigkeit wichtiger ist als Restrisiko. Multi-Modell-Abgleiche sind ein Kontrollsystem. Sie benötigen kein Kontrollsystem, um ROIC zu definieren oder ein Unternehmen in zwei Absätzen zusammenzufassen.
Ein einzelnes Modell genügt in der Regel, wenn:
- Sie ein Konzept lernen und keine Position bemessen
- Sie das Filing bereits geöffnet haben und nur einen Leseassistenten benötigen
- Sie Filterkriterien sprachlich ausarbeiten und keine Bewertung berechnen
- Sie vor einem langsameren, quellenbasierten Workflow einen ersten Entwurf brauchen
- Zusätzliche Modellaufrufe die Entscheidung nicht verändern würden
Openbooks Leitfaden für 2026 zieht dieselbe Kategorietrennung: Allgemeine Chatbots sind Ausgangspunkte, keine primären Research-Engines. Danelfins Score ist ein einzelnes System, aber ein spezialisiertes; ihn als Screen zu nutzen und dann aufzuhören, bleibt dennoch eine Einzelmodell-Entscheidung, wenn niemand den Titel hinterfragt. Perplexity ist der richtige einzelne Durchgang, wenn Sie innerhalb weniger Minuten eine Quellenkette benötigen und die Primärquelle selbst überprüfen werden.
Der Fehlermodus besteht darin, den günstigen Durchgang für die teure Entscheidung einzusetzen. Übervertrauen wird nicht durch AI verursacht. Es entsteht dadurch, dass der Prozess bei der ersten kohärenten Antwort endet. Die Zusammenfassung der Leitlinien US-Finanzaufsichtsbehörden durch Sidley aus dem Jahr 2025 unterstreicht, dass Unternehmen AI bereits als beaufsichtigte Tätigkeit behandeln müssen, nicht als Orakel. Private Anleger sollten den Geist dieser Regel übernehmen, auch wenn kein Prüfer danach fragt.
Eine kompakte Entscheidungsregel: Wenn ein Fehler die Positionsgröße verändern würde, nutzen Sie mindestens zwei Modelle und zwei Rollen. Wenn ein Fehler nur einen Satz in Ihren Notizen verändern würde, genügt ein gutes Modell.
Wie sollten Regulierung und Modellrisiko Ihren AI-Research-Workflow prägen?
Sie sollten Sie dazu zwingen zu dokumentieren, was das Modell nicht gesehen hat, und nicht nur, was es gesagt hat. Die FINRA-Diskussion zu AI richtet sich an Broker-Dealer, doch die Kontrollthemen sind übertragbar. Modellrisikomanagement, Daten-Governance, Erklärbarkeit und Aufsicht existieren, weil autonom wirkende Tools auf korrelierte Weise scheitern.
Für einen individuellen Research-Prozess sind die übertragbaren Kontrollen überschaubar:
- Bewahren Sie die Primärquelle in der Akte auf. Kann das Modell nicht auf das 10-K, 10-Q, 8-K oder Call-Transkript verweisen, ist die Behauptung ein Entwurf.
- Dokumentieren Sie Uneinigkeit. Ein Einzeiler — „Claude sieht Margendruck, Gemini nicht, 10-Q Seite 37 ungeklärt“ — ist nützlicher als ein neu erzeugtes Bullen-Szenario.
- Trennen Sie Empfehlung von Erklärung. Chatbots sind keine Eignungs-Engine. FINRA weist darauf hin, dass AI-Tools, die Empfehlungen erzeugen, bei Mitgliedsunternehmen unter Regulation BI und Rule 2111 fallen. Privatanleger sollten Modellergebnisse als Analyse behandeln, nicht als personalisierte Empfehlung.
- Unterstellen Sie gemeinsame Verzerrungen, bis das Gegenteil belegt ist. Das HBS-Ergebnis zur Auslandsverzerrung ist ein Beispiel. Zwei Modelle können dieselbe nicht-US-amerikanische Tatsache übersehen. Ein lokales Filing, eine Quelle in einer zweiten Sprache oder ein menschlicher Spezialist ist die tatsächliche Diversifikation.
- Bevorzugen Sie Tools, die „Nicht verifiziert“ sagen können. Scheingenauigkeit ist das verräterische Zeichen. Ein System, das den Absatz immer vervollständigt, ist nicht „analytischer“. Es ist weniger beaufsichtigt.
All dies erfordert kein institutionelles Budget. Bloomberg-ähnliche Terminals liegen weiterhin in einer anderen Kostenwelt — Openbook nennt typische Bloomberg-Preise von über 25.000 $ pro Jahr. Die Kontrolle, die Übervertrauen tatsächlich reduziert, ist günstiger: ein zweites Modell, eine zweite Rolle und eine Regel, dass Konsens ohne Quellen die Positionsgröße nicht erhöht.
Aktienanalyse mit einem einzelnen Modell ist ein Entwurfswerkzeug. Multi-Modell- und Multi-Rollen-Abgleiche sind Werkzeuge gegen blinde Flecken. Nutzen Sie das erste, um die Akte zu beginnen. Nutzen Sie das zweite, um zu entscheiden, ob die Akte abgeschlossen ist.
Quellen
- Openbook Analytics — Die besten AI-Tools für Aktienanalysen im Jahr 2026
- Investopedia — Behavioral Finance: Verzerrungen, Emotionen und Anlegerverhalten
- Preprints.org — Übervertrauen und Bestätigungsfehler im Handel
- ResearchGate — Anlegerübervertrauen im AI-Zeitalter: menschliche versus algorithmische Entscheidungsfindung
- SSRN — Anlegerverhalten an Aktienmärkten: Entstehung von AI und algorithmischem Übervertrauen
- Investor.gov — Artificial Intelligence (AI) und Anlagebetrug: Anlegerwarnung
- FINRA — Artificial Intelligence in der Wertpapierbranche: zentrale Herausforderungen und regulatorische Erwägungen
- Harvard Business School — Wenn LLM international werden: Auslandsverzerrung in der AI-Finanzanalyse
- Danelfin — AI Stock Picker und Methodik des AI Score
- AI Business Weekly — AI-Preisleitfaden 2026: ChatGPT, Claude und Gemini
- Perplexity — Preise für Privatpersonen und Unternehmen
- Helm Terminal — ChatGPT vs. Claude vs. Gemini vs. Perplexity für Aktienresearch
- arXiv — Können LLM die Kombination von Expertenprognosen verbessern?
- Lucid.now — AI bei Finanzentscheidungen: verhaltenswissenschaftliche Erkenntnisse
- Sidley Austin — Artificial Intelligence: Leitlinien US-amerikanischer Wertpapier- und Rohstoffaufsichtsbehörden