Generator für Charakterstimmen: AI-Stimmen für Spiele, Geschichten & Film
2026-09-06
Jenova hilft Ihnen, unverwechselbare Figuren zu entwickeln, gut sprechbare Dialoge zu schreiben und produktionsreife Prompts für jeden Generator für Charakterstimmen vorzubereiten. Im September 2026 können AI-Sprachsysteme eine Klangfarbe in Sekunden kopieren, doch die meisten Ergebnisse klingen weiterhin generisch, weil dem zugrunde liegenden Text Persönlichkeit fehlt. Sprecheraufnahmen im Studio bleiben für Indie-Teams langsam und teuer, während eine oberflächliche Sprachsynthese jede Rolle auf denselben Rhythmus reduziert.
- ✅ Charakterkonsistente Persönlichkeiten über lange Geschichten und Spielschleifen hinweg
- ✅ Dialoge, die zum Sprechen geschrieben sind, nicht nur zum Lesen auf einer Seite
- ✅ Prompts, die für moderne Sprachmodelle und Lokalisierung strukturiert sind
- ✅ Unterstützung für Skripte, Comics, Musik und Rollenspiel in einem kreativen Workflow
Um zu verstehen, warum das wichtig ist, sollte man betrachten, was Kreative tatsächlich von einem Generator für Charakterstimmen benötigen: nicht noch einen Regler mit der Bezeichnung „fröhlich“, sondern eine Stimme, die zu jemandem gehört. Der Engpass ist selten der Renderer. Es sind die Figurenarbeit, die Sprechweise und die ethische Grenze zwischen originärer Performance und unautorisierter Imitation.
Kurzantwort: Was ist ein Generator für Charakterstimmen?
Ein Generator für Charakterstimmen ist ein AI-System, das unverwechselbare, persönlichkeitsbezogene Sprache erzeugt, damit jede Rolle wie eine andere Person klingt. Kreative nutzen ihn für Spiele, Geschichten, Videos und Barrierefreiheit — doch die Stimme funktioniert nur, wenn die Figur bereits klar definiert ist.
Wichtige Fähigkeiten:
- Eigene Klangfarbe, eigenes Tempo und eigene emotionale Bandbreite für jede Figur
- Skripte und Prompts, die Sprachsynthese überstehen, ohne wie ein GPS zu klingen
- Rollenspiel mit fest verankerter Charakterkonsistenz, bevor Sie überhaupt auf „Generieren“ klicken
- Workflows für originäre Figuren, die das Klonen realer Personen ohne Einwilligung vermeiden
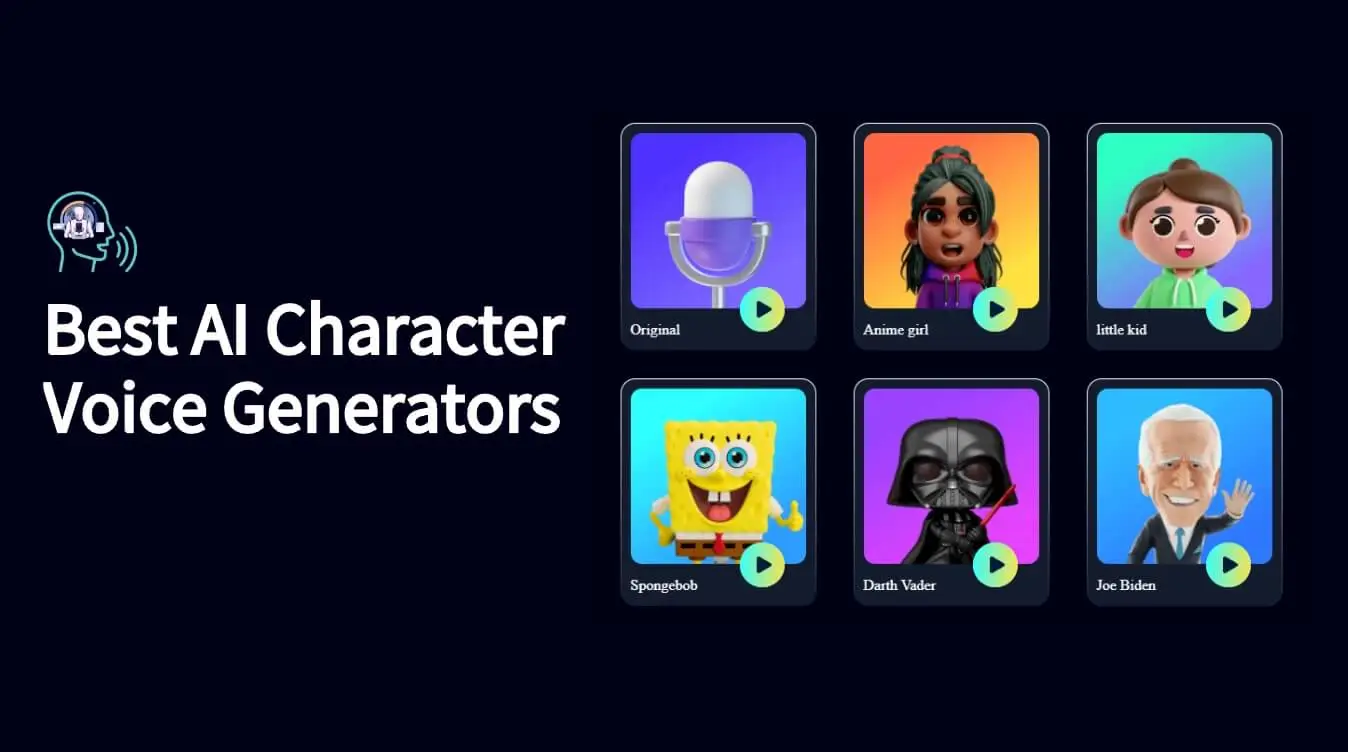
Warum die meisten Generatoren für Charakterstimmen noch immer generisch klingen
Die Nachfrage nach synthetischer Sprache ist längst nicht mehr experimentell. Forschungsunternehmen erfassen die AI-Stimmengenerierung inzwischen als eigenen Markt und nicht bloß als Nebenfunktion von Chatbots.
6,4 Milliarden USD — Größe des globalen Markts für AI-Stimmengeneratoren im Jahr 2025, mit prognostiziertem Wachstum von 8,36 Milliarden USD im Jahr 2026
19,09 Milliarden USD — Markt für Sprach- und Stimmerkennung im Jahr 2025, für 2026 auf 23,70 Milliarden USD prognostiziert
Diese Ausgaben fließen in Spiele, Lokalisierung, Social Video und Kundenaudio. Die Nutzung von Voice AI stieg 2025 um das Neunfache, und 84 Prozent der befragten Organisationen planten, ihre Budgets für Sprachtechnologie zu erhöhen. Doch der Kauf eines Renderers kauft noch keine Performance. Der Zugang zu einer Stimme, an die sich das Publikum erinnert, ist weiterhin frustrierend schwierig:
- Jede Figur übernimmt denselben Rhythmus, dasselbe Atemmuster und denselben Ton eines „hilfsbereiten Assistenten“
- Studiosessions sind für umfangreiche NPC-Inhalte, YouTube-Besetzungen und wöchentliche Webtoon-Synchronisationen zu langsam und zu teuer
- Für die Seite geschriebene Zeilen brechen beim Sprechen zusammen — Satzteile häufen sich, Witze verpuffen, Namen werden verstümmelt
- Klone von Prominenten und Politikern schaffen rechtliche Risiken und Vertrauensprobleme, selbst wenn die Oberfläche sie nur einen Klick entfernt anbietet
- Teams jonglieren mit Autoren, Prompt Engineers, Komponisten und Stimmtools, ohne über eine gemeinsame Figurenbibel zu verfügen
Dieselbe Stimme, anderes Namensschild
Ein Generator für Charakterstimmen kann die Tonhöhe verändern und dennoch bei der Identität scheitern. Zuhörer nehmen Haltung wahr, nicht nur Frequenzen: wie ein Bösewicht einen Konsonanten verzögert, wie ein Kind einen Witz hastig vorträgt oder wie eine müde Kapitänin am Ende eines Berichts leiser wird. Forschung zu emotionsbewusster, charakterspezifischer Sprache aus Comics und textgesteuerter Mehrfiguren-Stimmengenerierung kommt immer wieder zum selben Ergebnis — das Modell benötigt Charakterkontext, nicht nur ein Wellenformziel. Ohne schriftlich ausgearbeitete Persönlichkeit erhalten Sie ein Kostüm, keine Performance.
Die Kostenbarriere für Indie- und mittelgroße Teams
Menschliche Hauptrollen tragen weiterhin emotional komplexe Szenen. Das Produktionsproblem liegt in der langen Reihe von Nebeninhalten: Tausende NPC-Begrüßungen, lokalisierte Varianten und Aussprachen von Spielernamen. Branchenanalysen zu ethischer AI-Stimme in Spielen beschreiben eine Aufteilung nach dem Prinzip „Mensch plus“ — Schauspieler für Heldenszenen, Synthese für große Mengen — und stellen fest, dass Indie-Teams inzwischen innerhalb von Wochen statt Monaten in Dutzende Sprachen lokalisieren können. Das hilft jedoch nur, wenn die Ausgangszeilen gut sprechbar und die Figurenprofile stabil sind. Andernfalls bezahlen Sie dafür, mittelmäßiges Audio zu vervielfachen.
Skripte, die nie zum Hören gedacht waren
Romanprosa und UI-Texte kämpfen gegen den Mund. Verschachtelte Sätze, unerklärte Akronyme und unaussprechliche Fantasy-Namen zwingen das Modell in roboterhafte Betonungsmuster. Ein Generator für Charakterstimmen gibt eine schlechte Zeile getreu wieder. Die Lösung liegt weiter vorn im Prozess: kürzere Einheiten, phonetische Schreibweisen, emotionale Regieanweisungen und Dialoge, die ein Sprecher tatsächlich in einem Atemzug sagen könnte.
Einwilligung, Klonen und Plattformen, die Probleme einladen
Zero-Shot-Systeme können eine Klangfarbe in etwa drei Sekunden nachbilden. Diese Geschwindigkeit ist für Repliken mit Einwilligung und originäre Figuren nützlich. Sie ist gefährlich, wenn eine Bibliothek öffentliche Personen oder urheberrechtlich geschützte Maskottchen als Presets anbietet. Die FTC hat klargestellt, dass es keine AI-Ausnahme vom bestehenden Verbraucherschutzrecht gibt, und sie nutzt die Voice Cloning Challenge sowie eine Impersonation Rule, um gegen täuschendes Audio vorzugehen. Im Spielebereich wurde das Interactive Media Agreement vom Juli 2025 mit 95,04 % Zustimmung verabschiedet und machte schriftliche Einwilligung für Stimmreplikation unverzichtbar. Wenn Ihre Pipeline die Einwilligung nicht nachweisen kann, sollten Sie die Stimme nicht generieren.
Genau dafür wurde Jenova entwickelt: für die Charakterintelligenz rund um den Generator, nicht als Abkürzung am Gesetz vorbei.
Die Jenova-Lösung
Ein Generator für Charakterstimmen wandelt Text in Audio um. Jenova macht diesen Text vertonenswert. Sie definieren, wer spricht, wie die Figur denkt, was sie niemals sagen würde und wie eine Zeile wirken soll — anschließend übergeben Sie einem beliebigen Sprachmodell einen klaren Prompt und ein sauberes Skript. Dedizierte Audioplattformen erzeugen Wellenformen; diese Plattform entwickelt die Person hinter der Wellenform.
| Traditioneller Ansatz | Jenova |
|---|---|
| Eine Kabine buchen, auf Sessions warten, jede Nachaufnahme neu schneiden | Figurenprofile und gut sprechbare Entwürfe in einer einzigen Arbeitssitzung |
| Eine TTS-Stimme mit neuem Anzeigenamen | Persönlichkeit, Diktion und emotionale Einheiten für jede Rolle |
| Eine berühmte Stimme klonen und hoffen, dass es niemand bemerkt | Originäre Figuren, Repliken mit Einwilligung und dokumentierte Nutzung |
| Autor in einem Tab, Prompt-Notizen im nächsten, Komponist im dritten | Verknüpfte Agenten für Geschichte, Prompts, Comics, Musik und Auslieferung |
| Flache Lokalisierung, die Humor und Timing ignoriert | Zeilen, die für Silbenlänge und kulturelle Neufassung strukturiert sind |
Figurenbibeln, bevor Sie Audio anfassen
Beginnen Sie mit Identität, nicht mit einem Preset. Der Name Generator erzeugt Namen, die kulturell stimmig und gut aussprechbar sind — ein praktischer Filter, den viele Stimm-Pipelines überspringen, bis ein Modell auf einer Konsonantenhäufung herumbeißt. Kombinieren Sie ihn mit dem Writing Assistant, um die Diktion festzulegen: Wortschatzgrenze, Tabuwörter, wiederkehrende Witze und die eine Metapher, zu der eine Figur immer greift. Wenn diese Einschränkungen bestehen, hat jeder Generator für Charakterstimmen etwas Konkretes zu performen.
Dialoge, die für den Mund gebaut sind
Der Film Screenwriter behandelt Zeilen als zeitlich gesteuertes Verhalten: Unterbrechung, Stille und Subtext. Dieses Handwerk lässt sich direkt auf Spiel-Ausrufe, vertikale Dramen und synchronisierte Comics übertragen. Sie erhalten Regieanweisungen in Klammern, denen ein Sprachmodell folgen kann — etwa „leise, dann heller“ — statt vager Bezeichnungen wie „traurig“. Für serielles Erzählen auf Mobilgeräten hält der Microdrama Screenwriter Cliffhanger kurz genug, um sie ohne Luftnot einzusprechen.
Beispiel einer Anweisung, die Sie in einen Generator einfügen können:
„Sprich als Kapitänin Ilya Voss, 50+, rau und tief aus der Brust. Wenn sie wütend ist, wird sie nie lauter — sie spricht langsamer. Zeile: ‚Du hast die Karte mitgebracht. Das Wetter nicht.‘ Pause nach Karte. Kein Lächeln.“
Prompts, die den Kontakt mit einem Modell überstehen
Die meisten „schlechten AI-Stimmen“ sind das Ergebnis schlechter Anweisungen. Der Prompt Generator verwandelt eine Figurenbibel in modellfertige Texte: Akzenthinweise, Alter, Aufnahmeumgebung, emotionaler Bogen und Negativ-Prompts wie „kein Moderationsrhythmus, kein Lächeln auf den Vokalen“. Das ist der Unterschied zwischen einer Bibliothekskarte mit dem Namen „Anime-Mädchen“ und einer Person, die zufällig animiert ist.
Bild, Musik und der Rest der Szene
Stimme ist nur eine Ebene. Der Graphic Designer gestaltet das Gesicht, das das Ohr erwartet. Manga Creator, Comic Creator und Webtoon Creator produzieren sequenzielle Kunst, deren Mundbewegungen und Panelrhythmus Sie vertonen können. Der Music Composition Assistant und der Lyric Writer geben Figuren Motive und singbare Zeilen, damit gesprochene Stimme und Lied zur selben Welt gehören.
Während sich dedizierte Sprach-APIs auf das Rendern von Audio spezialisieren, konzentriert sich Jenova auf Schreiben, Prompting und Kontinuität, die darüber entscheiden, ob jemand dieses Audio ein zweites Mal hören möchte.
Spezialisierte AI-Agenten für die Arbeit mit Charakterstimmen
Testen Sie Jenova kostenlos — keine Kreditkarte erforderlich. Diese Agenten decken die Aufgaben ab, die unmittelbar vor und nach einem Generator für Charakterstimmen liegen.
Roleplay Game Master
Wenn Sie eine Figur erst in Sprache hören müssen, bevor Sie sie synthetisieren, ist dies der Proberaum. Der unbegrenzte Speicher hält Diktion, Geheimnisse und Beziehungen über Sitzungen hinweg stabil — das textliche Äquivalent zu einem fest verankerten Stimmmodell.
- Prüft wiederkehrende Sprüche auf Belastbarkeit, bis sie unvermeidlich klingen
- Hält Stimmen von Gruppe und NPCs in langen Kampagnen klar voneinander getrennt
- Erzeugt charaktertreue Zeilen, die Sie direkt in einen Generator übernehmen können
Film Screenwriter
Nutzen Sie ihn, wenn die Stimme Handlung tragen muss, nicht nur Atmosphäre. Struktur, Szenenziele und Dialoghandwerk verhindern, dass Performances zu Exposition mit lustigem Akzent werden.
- Einheiten und Konflikte, die emotionale Veränderungen im Audio rechtfertigen
- Kurze, nachaufnahmefreundliche Zeilen für Spiele und Werbung
- Figurenentwicklung, die eine Synchronisation über zwölf Episoden hinweg übersteht
Prompt Generator
Sprachmodelle sind nur so gut wie ihr Briefing. Dieser Agent schreibt Prompts für Text-, Bild-, Musik- und Videosysteme — einschließlich der Sprachmodelle, für die Sie bereits bezahlen.
- Konsistente Prompt-Blöcke pro Figur, damit Episoden zusammenpassen
- Emotions- und Raumbeschreibungen, denen Modelle tatsächlich folgen
- Iterative Verfeinerung, wenn eine Aufnahme zu hell oder zu langsam zurückkommt
Writing Assistant
Das zentrale Werkzeug für Bibeln, Erzähltexte und Überarbeitungen nach dem Muster „Das sollte wie diese Figur klingen“. Es passt sich an Format und Publikum an, sodass eine Hintergrund-Erklärung und eine Beleidigung in der Taverne nicht denselben Satzrhythmus teilen.
- Redaktioneller Durchgang für Sprechbarkeit und Lesbarkeitsniveau
- Tonabgleich über Questtexte, Trailer und Patchnotes hinweg
- Zusammenarbeit, wenn Sie bereits einen Entwurf haben, der fast funktioniert
Music Composition Assistant
Ein Generator für Charakterstimmen verarbeitet Sprache. Dieser Agent gestaltet das musikalische Fundament darunter — Motive, Harmonie und Arrangement-Notizen, die Sie an eine DAW oder ein anderes Modell weitergeben können.
- Leitmotive, die an bestimmte Rollen gebunden sind
- Tempokarten, die Raum für Dialoge lassen
- Theoriebewusste Anleitung, damit ein Bösewicht-Thema nicht mit dem Stimmumfang kollidiert
Public Speaking Coach
Wenn Sie selbst auftreten — oder jemanden anleiten müssen — arbeitet dieser Agent an Vortrag, Nervosität und Publikum. Er ist das menschliche Gegenstück zur synthetischen Sprache: Atem, Pause und Betonung, die Sie anschließend in einem Prompt kodieren können.
- Markierungen für Tempo und Betonung, die sich auf TTS-Tags übertragen lassen
- Frage-und-Antwort- sowie Vorleseproben für hybride Streams
- Hinweise dazu, was eine Zeile beim Zuhörer bewirkt, nicht nur dazu, wie sie klingt
So läuft ein Workflow für Charakterstimmen tatsächlich ab
Sie brauchen nicht zuerst ein Studio. Sie brauchen eine Person auf der Seite, eine Zeile, die sich sagen lässt, und einen Prompt, der sich nicht selbst widerspricht.
Schritt 1: Legen Sie die Figur fest, nicht das Preset
Notieren Sie Alter, Status, Körperlichkeit und eine Regel, die die Figur niemals bricht. Erzeugen Sie einen gut aussprechbaren Namen und anschließend eine 150-Wörter-Figurenbibel. Wenn zwei Figuren Zeilen austauschen können, ohne dass es jemand bemerkt, haben Sie noch keine zwei Stimmen.
„Erstelle eine Figurenbibel für Ryn Calder, 17, Flusskurierin, immer höflich zu Fracht und unhöflich zu Kapitänen. Kurze Sätze. Kein Slang, der nach dem Brand ihres Dorfes entstanden ist. Gib mir drei Zeilen, die sie niemals sagen würde.“
Schritt 2: Schreiben Sie Zeilen für Atempausen, nicht für die Seite
Verschieben Sie die Szene in den Writing Assistant oder den Film Screenwriter. Kürzen Sie Verschachtelungen. Schreiben Sie schwierige Namen in eckigen Klammern phonetisch aus. Ergänzen Sie eine Performance-Notiz, die das Modell ausführen kann.
„Schreibe diesen Hintergrundabsatz als sechs gesprochene Zeilen für Ryn um, maximal zwölf Wörter pro Zeile, mit einer markierten Pause vor der letzten Zeile.“
Schritt 3: Machen Sie aus der Bibel einen Generator-Prompt
Übergeben Sie dieselben Einschränkungen an den Prompt Generator. Legen Sie Aufnahmeumgebung, Mikrofonabstand, Emotion auf einer Skala von 1–5 und zu vermeidende Eigenschaften fest. Speichern Sie einen Block pro Figur, damit Episode vier nicht abdriftet.
„Wandle Ryns Bibel in einen Prompt für ein Stimmmodell um: jugendlicher Alt, trocken, Hall eines Innenlagers, Tempo 1.05x, kein Lächeln, kein Moderatorenton am Satzende. Füge einen Negativ-Prompt hinzu.“
Schritt 4: Stimmen Sie Gesicht, Panel und Musik ab
Geben Sie dieselbe Bibel an visuelle und musikalische Agenten weiter, damit Bild und musikalisches Fundament zur Stimme passen. Ein helles Cartoon-Gesicht über einer grabesernsten Sprechweise ist der Grund, warum das Publikum das Audio für künstlich hält — selbst wenn das Modell präzise arbeitet.
Schritt 5: Proben Sie auf dem Smartphone, dann rendern Sie
Jenova bietet vollständige Funktionsparität auf Web, iOS und Android. Lesen Sie die Zeile unterwegs laut vor, markieren Sie jede Stolperstelle, überarbeiten Sie sie und fügen Sie sie erst dann in Ihren Generator für Charakterstimmen ein. Die günstigste Nachaufnahme ist die, die Sie nie aufnehmen mussten.
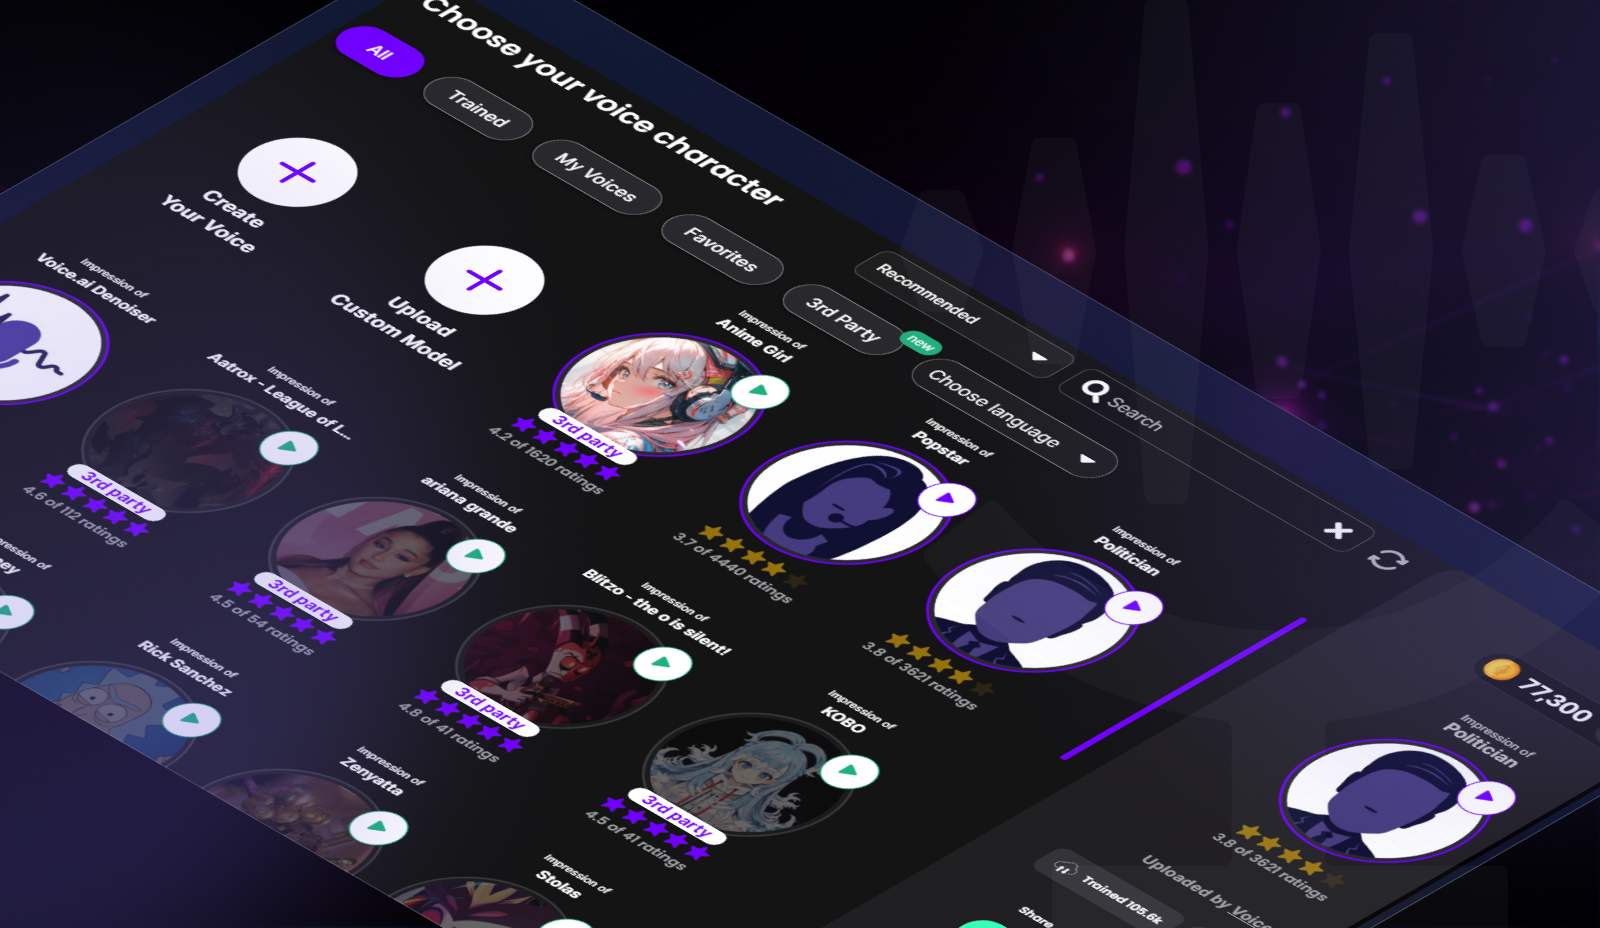
Ergebnisse und Anwendungsfälle
🎮 NPCs in Indie-Spielen ohne Studiobudget
Szenario: Ein 12-Stunden-RPG benötigt 4.000 Zeilen für Nebenrollen sowie die Aussprache des Spielernamens.
Traditioneller Ansatz: Tarifgebundene Studiosessions für Hauptrollen, Stille oder wiederverwendete Ausrufe für alle anderen, Lokalisierung auf „irgendwann“ verschoben.
Jenova: Szenen der Hauptfiguren bleiben menschlich gesprochen. Für die große Menge an Nebeninhalten erhalten Sie Bibeln, gut sprechbare Zeilen und stabile Prompts, sodass Ihr Generator für Charakterstimmen Begrüßungsfiguren, Händler und Gerüchte-NPCs besetzen kann, ohne eine Berühmtheit zu klonen.
- Figurenprofile, die verhindern, dass ein Schmied wie ein Zauberer klingt
- Lokalisierungsfertige Kurzzeilen
- Prompt-Blöcke, die Sie wie Code versionieren können
🎬 Webtoon- und Comic-Synchronisation
Szenario: Eine wöchentliche vertikale Serie möchte Audioepisoden veröffentlichen, ohne auf eine vollständige Besetzung zu warten.
Traditioneller Ansatz: Fan-Synchronisationen mit unterschiedlichen Mikrofonen oder ein einzelner Erzähler, der jede Rolle spricht.
Jenova: Webtoon Creator und Comic Creator sichern die visuelle Kontinuität, während der Drehbuchautor Stimmen nach Panels aufteilt. Jede Rolle erhält einen eigenen Prompt, damit der Generator nicht raten muss.
- Auf Panels getaktete Zeilen statt Prosa-Blöcken
- Unterschiedliche Besetzungen für Hauptrollen und Menge
- Musik-Cues, die Raum für Sprache lassen
📱 Sprachpraxis, die wie eine echte Person klingt
Szenario: Sie pendeln und möchten Unterhaltung statt einer Lehrbuchstimme.
Traditioneller Ansatz: Übungen in einer App mit einem synthetischen Tutor, der sich nicht an Ihre Fehler erinnert.
Jenova: Learn English Through Roleplay versetzt Sie in eine Szene mit einer konsistenten Figur. Später können Sie dieselben Zeilen in einem Generator für Hörübungen vertonen — weiterhin mit originären Figuren, nicht mit Imitationen.
- Speicher, der verhindert, dass der Barista in jeder Sitzung zurückgesetzt wird
- Redewendungen in Situationen, die Sie tatsächlich wiederverwenden werden
- Mobile Sitzungen, die in eine Zugfahrt passen
🎙️ Marken-Podcasts und Social-Media-Besetzungen
Szenario: Ein Produktkanal benötigt jede Woche einen Host, einen skeptischen Sidekick und einen ohne Vorbereitung einzusprechenden Hinweistext.
Traditioneller Ansatz: Dieselbe Gründerstimme für jedes Segment oder ein Freelancer, der am Donnerstag nicht verfügbar ist.
Jenova: Der Social Media Content Generator erstellt plattformgerechte Skripte; die Schreib- und Prompt-Agenten sorgen dafür, dass Host und Sidekick nicht ineinander übergehen. Sie rendern mit Ihrem lizenzierten Stimmtool, nicht mit einem unautorisierten Klon einer öffentlichen Person.
- Wiederkehrende Elemente mit stabiler Diktion
- Hinweistexte, die zum Sprechen geschrieben sind, nicht zum Überfliegen
- Aufhänger in passender Länge für Shorts, Reels und vollständige Episoden
FAQ
Was ist ein Generator für Charakterstimmen?
Ein Generator für Charakterstimmen ist Software, die Text mit einer gewählten Identität — Alter, Tonhöhe, Akzent und Emotion — in Sprache umwandelt, damit verschiedene Rollen nicht denselben Rhythmus teilen. Das Audiomodell liefert die Klangfarbe. Figurenarbeit, Regieanweisungen und Prompts liefern die Person. Die Tools auf Jenova arbeiten auf dieser Schreibseite: Bibeln, Dialoge und modellfertige Anweisungen, die Sie in jedes lizenzierte Sprachsystem einfügen können.
Sind Generatoren für Charakterstimmen kostenlos nutzbar?
Viele Sprach-Apps bieten eine eingeschränkte kostenlose Stufe und berechnen Gebühren für längere Clips, kommerzielle Rechte oder geklonte Stimmen. Jenova bietet einen kostenlosen Tarif mit Kernfunktionen sowie kostenpflichtige Stufen, wenn Sie mehr Nutzung benötigen. Planen Sie zwei Kostenarten ein: die kreative Arbeit — Skripte, Prompts und Kontinuität — sowie den Renderer — Audiominuten und Stimmenlizenzen. Einwilligung und kommerzielle Bedingungen für geklonte Stimmen sind von Abonnementpreisen getrennt; lesen Sie beides, bevor Sie veröffentlichen.
Wie mache ich AI-Charakterstimmen einzigartig?
Geben Sie jeder Rolle eine Regel, eine Wortschatzgrenze und eine körperliche Gewohnheit, und schreiben Sie Zeilen, die sie nicht austauschen würden. Setzen Sie diese Einschränkungen jedes Mal in den Prompt: Raum, Tempo, Emotion und einen Negativ-Prompt gegen Moderationsrhythmus. Der Prompt Generator wurde für genau dieses Briefing entwickelt. Wenn zwei Figuren nach einem guten Prompt noch immer identisch klingen, liegt das Problem bei der Bibel, nicht beim Regler.
Ist es legal, die Stimme einer realen Person zu klonen?
Nicht standardmäßig und nicht als scherzhaftes Preset. Sie benötigen eine klare, dokumentierte Einwilligung für die tatsächlich beabsichtigte Nutzung sowie die in Ihrer Rechtsordnung geltenden Persönlichkeits- und Urheberrechte. Die FTC behandelt täuschendes AI-Stimmklonen als Verbraucherschutzproblem, nicht als Neuheit. Vereinbarungen in Spielen und Unterhaltung verlangen zunehmend schriftliche Einwilligung und Nutzungsberichte. Entwickeln Sie originäre Figuren oder lizenzierte Repliken. Extrahieren Sie nicht die Stimme eines Politikers, Schauspielers oder Sängers, nur weil ein Dashboard es einfach macht.
Kann ich diesen Workflow auf dem Smartphone nutzen?
Ja. Jenova ist für Web, iOS und Android mit denselben Kernfunktionen entwickelt, einschließlich Spracherkennung, wenn Sie unterwegs lieber eine Notiz einsprechen als tippen möchten. Entwerfen Sie eine Zeile im Zug, straffen Sie sie, generieren Sie den Prompt und rendern Sie anschließend in Ihrem Desktop-Stimmtool, falls dort Ihre lizenzierten Modelle verfügbar sind.
Wie unterscheidet sich das von einfacher Text-to-Speech-Technologie?
Einfache TTS liest Wörter vor. Ein Generator für Charakterstimmen versucht, eine Rolle zu performen. Performance hängt weiterhin vom Schreiben ab: Identität, Konflikt und Regie. Jenova ersetzt nicht Ihren lizenzierten Audio-Renderer. Über Agenten wie den Roleplay Game Master und den Film Screenwriter erstellt es die Figurenarbeit, die dieser Renderer benötigt, damit Sie nicht dafür bezahlen, denselben hilfsbereiten Praktikanten in sechs Kostümen zu hören.
Fazit
Ein Generator für Charakterstimmen ist nur so gut wie die Person, die Sie ihn darstellen lassen. Die Märkte für AI-Sprache wachsen schnell, Modelle können eine Klangfarbe in Sekunden festlegen, und Regulierungsbehörden haben die Vorstellung bereits zurückgewiesen, dass „die AI es getan hat“ eine Verteidigung sei. Der praktikable Weg ist enger und besser: originäre Figuren, Repliken mit Einwilligung, gut sprechbares Schreiben und reproduzierbare Prompts.
Entwickeln Sie die Rolle, schreiben Sie für den Atem, dann generieren Sie die Aufnahme. Beginnen Sie mit Jenova — und bringen Sie diese Zeilen anschließend zu dem Sprachtool, dem Sie bereits vertrauen.
Entdecken Sie mit dem Roleplay Game Master, dem Writing Assistant und dem Prompt Generator weitere Elemente desselben Workflows. Wenn die Figur klar ist, hat die Stimme ein Ziel.
Für Entwickler: Jeder Agent in diesem Artikel ist programmatisch über die Jenova API verfügbar — integrieren Sie Figurenbibeln, Dialoggenerierung und Prompts für Stimmmodelle mit einer einzigen Integration in Ihre App. Vollständige Dokumentation →