Beste KI für Python Coding Assistant: Schnellere Entwicklung von Skripten bis zu Produktions-Apps (Juni 2026)
2026-06-21
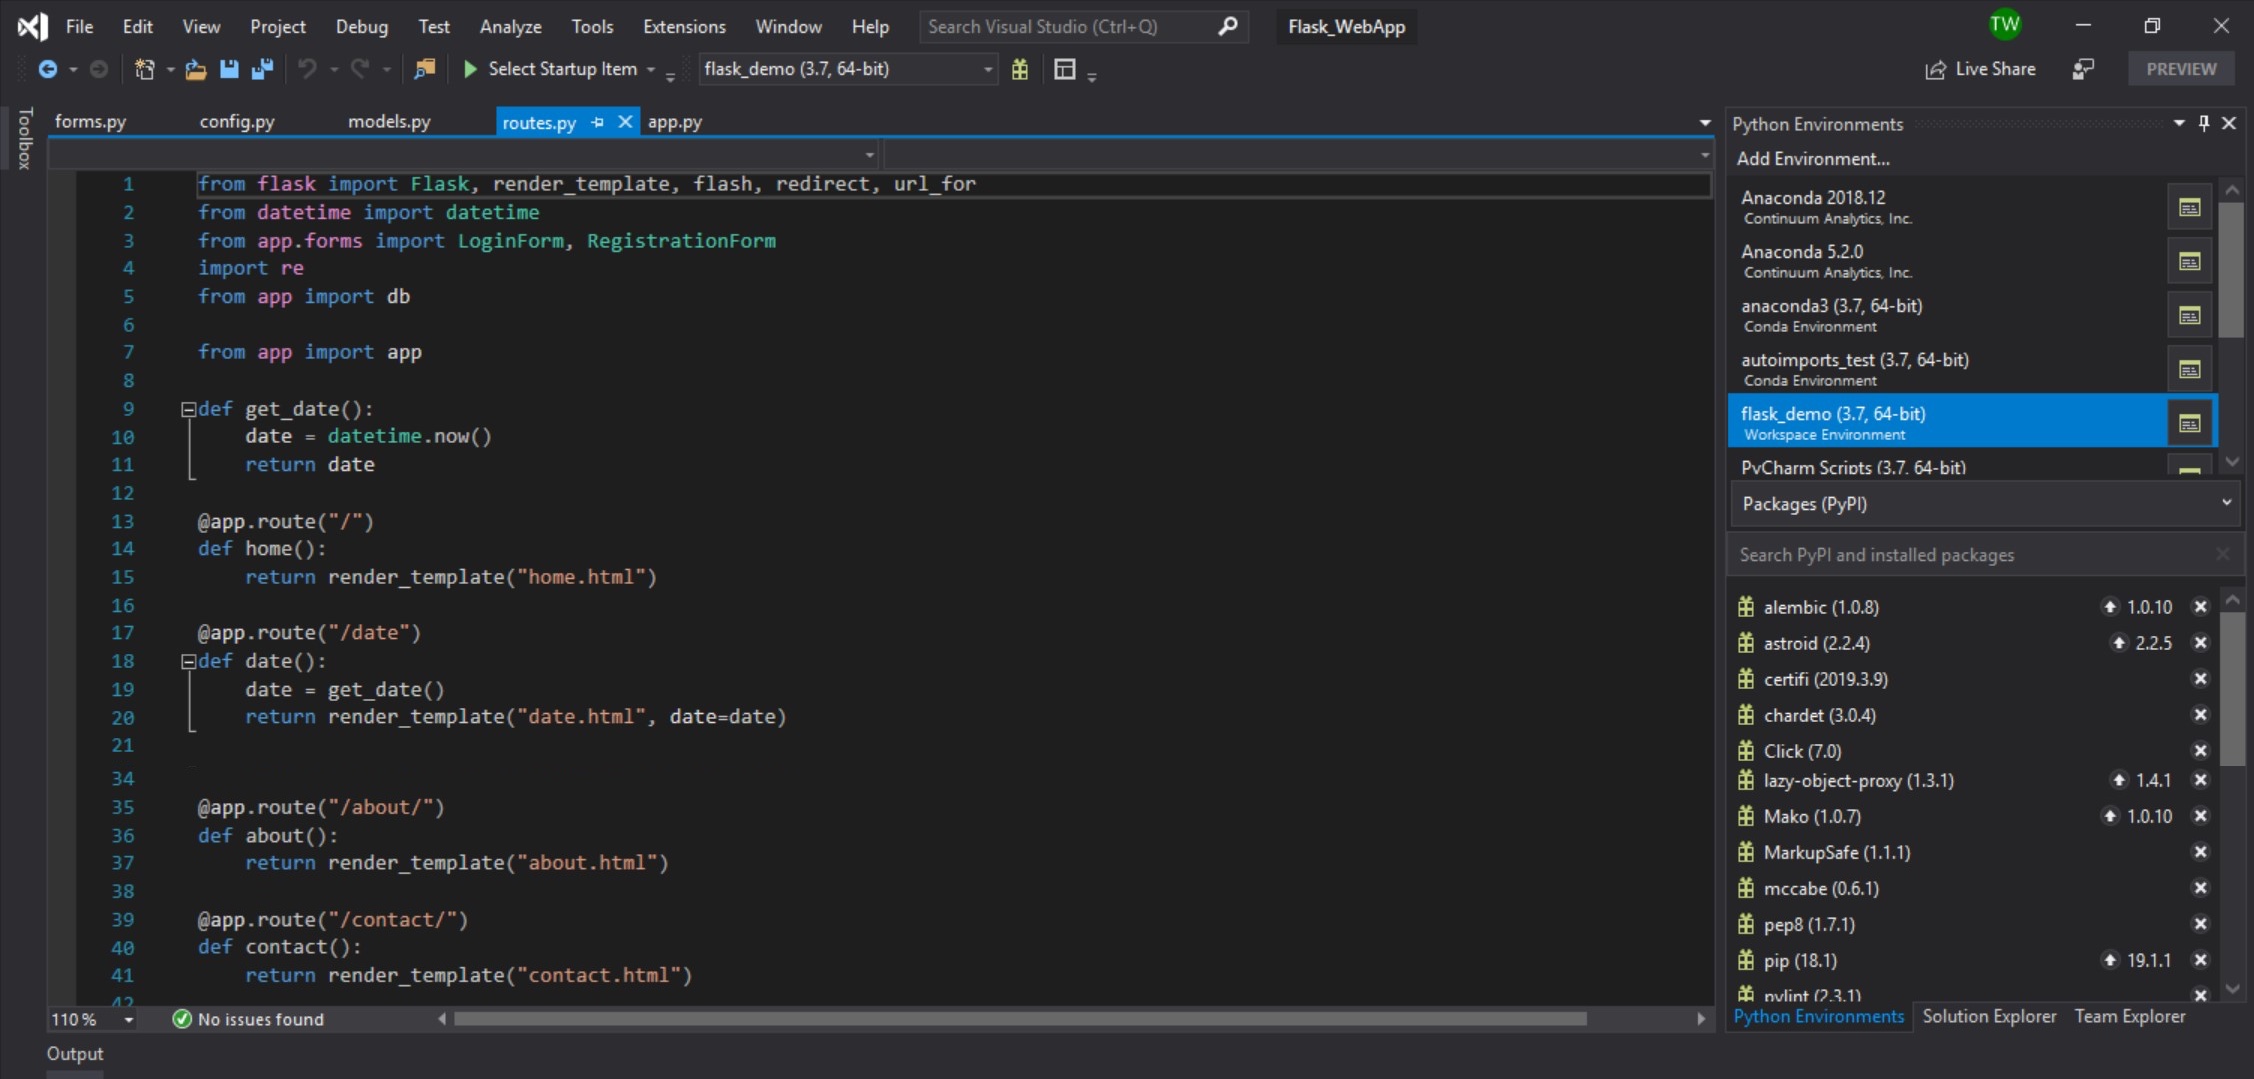
Der Python Coding Assistant von Jenova ist ein spezialisierter KI-Entwicklungspartner, der produktionsreifen Python-Code schreibt – von schnellen Automatisierungsskripten bis hin zu komplexen Django-Anwendungen mit mehreren Dateien und ML-Pipelines – mit der Tiefe und dem idiomatischen Verständnis, das allgemeinen KI-Tools durchweg fehlt. Während Python im Jahr 2026 die Bereiche KI, Datenwissenschaft, Webentwicklung und Automatisierung dominiert, verlieren Entwickler immer noch Stunden mit dem Debuggen obskurer Tracebacks, dem Kampf mit Abhängigkeitskonflikten und der Übersetzung architektonischer Absichten in sauberen, typisierten und gut getesteten Code.
✅ Schreibt idiomatisches, modernes Python mit korrekten Type Hints, asynchronen Mustern und PEP-Konformität ✅ Tiefgehende Kenntnisse in Django, FastAPI, Flask, pandas, NumPy, PyTorch und dem gesamten Ökosystem ✅ Debuggt Tracebacks, behebt fehlerhafte Importe und löst Umgebungsprobleme mit Ursachenanalyse ✅ 24/7 verfügbar im Web, auf iOS und Android – fügen Sie Code aus jeder Umgebung ein
Um zu verstehen, warum Python-Entwickler zunehmend KI-Unterstützung benötigen, die über generisches Autocomplete hinausgeht, werfen wir einen Blick auf die treibenden Kräfte der Nachfrage im Jahr 2026.
Schnelle Antwort: Was ist der Python Coding Assistant?
Der Python Coding Assistant ist ein KI-gestützter Entwicklungspartner, der produktionsreifen Python-Code für Web-Frameworks, Datenwissenschaft, maschinelles Lernen und Automatisierung schreibt, debuggt und refaktorisiert.
Hauptfähigkeiten:
- Full-Stack-Python-Generierung – von FastAPI-Endpunkten mit Pydantic-Validierung bis zu Django-ORM-Modellen mit Migrationen
- Unterstützung für Datenwissenschafts- und ML-Workflows – pandas-Pipelines, scikit-learn-Modelle, PyTorch-Trainingsschleifen und Visualisierung
- Echtzeit-Debugging: Fügen Sie Tracebacks, Fehlermeldungen oder fehlerhaften Code ein und erhalten Sie funktionierende Korrekturen mit Erklärungen zur Ursache
- Testgenerierung mit pytest, einschließlich Fixtures, Parametrisierung, Mocking und Abdeckung von Grenzfällen
Die Herausforderung der Python-Entwicklung im Jahr 2026
Python ist nicht nur beliebt – es ist dominant. Laut dem TIOBE Index bleibt Python die beliebteste Programmiersprache und hält im Januar 2026 einen Anteil von 22,61 %. Das PYPL-Diagramm setzt es mit einem überwältigenden Marktanteil von 29,6 % sogar noch höher an. Es ist das, was einer universellen Sprache in den Bereichen KI, Data Engineering, Webentwicklung und Automatisierung am nächsten kommt.
Diese Dominanz bedeutet, dass Python-Entwickler gut bezahlt werden – das mittlere Gesamtgehalt für einen Python-Entwickler beträgt 129.000 $](https://www.coursera.org/articles/python-developer-salary), wobei [die Durchschnittsgehälter auf Basis von 516 gemeldeten Gehältern 157.052 $ erreichen – aber es bedeutet auch, dass die an sie gestellten Erwartungen enorm sind.
Die Herausforderungen vervielfachen sich schnell:
- Die Framework-Vielfalt ist unerbittlich: Django, FastAPI, Flask, Celery, SQLAlchemy, Pydantic v2, asyncio, pytest, Poetry, uv – Python-Entwickler müssen Breaking Changes, Migrationsleitfäden und sich entwickelnde Best Practices für Dutzende von Bibliotheken gleichzeitig im Auge behalten.
- Pythons Flexibilität ist ein zweischneidiges Schwert: Dieselbe Sprache, die einen Zwei-Zeilen-Web-Scraper antreibt, führt auch neuronale Netze mit Milliarden von Parametern aus. Der Kontextwechsel zwischen einem Django-REST-Endpunkt und einer PyTorch-Trainingsschleife erfordert völlig unterschiedliche Denkmodelle und API-Kenntnisse.
- Typsicherheit ist optional, wird aber zunehmend erwartet: PEP 484 Type Hints, mypy, Pyright und Laufzeitvalidierung mit Pydantic haben typisiertes Python zum professionellen Standard gemacht – aber die meisten KI-Tools generieren immer noch untypisierten, Duck-Typed-Code, der das Linten besteht und die Überprüfung nicht besteht.
- Debugging ist trügerisch zeitaufwändig: Python-Tracebacks können sich über 50+ Zeilen über asynchrone Kontexte, Middleware-Ketten und Dekorator-Stacks erstrecken. Ein
TypeErrortief in einer pandas-Pipeline oder einAttributeErroraus einer Django-Queryset-Auswertung kann eine Stunde Untersuchung in Anspruch nehmen.
Warum allgemeine KI-Tools für Python nicht ausreichen
Der Markt für KI-Coding-Assistenten ist explodiert – 81 % der Entwickler geben an, KI-gestützte Coding-Assistenten zu verwenden, und das Python-Segment dominierte den Markt für KI-Code-Assistenten mit einem Anteil von 36,8 % im Jahr 2025. Doch Akzeptanz bedeutet nicht Zufriedenheit.
Wie eine umfassende Bewertung von KI-Coding-Assistenten für Python ergab, sinken die Produktivitätsgewinne „stark, wenn das Tool mit Python-spezifischen Mustern wie Dekoratoren, Type Hints, asynchronen Generatoren oder Dataclass-Strukturen zu kämpfen hat.“ Allgemeine Tools generieren Python, das läuft, aber __slots__ ignoriert, Kontextmanager falsch verwendet, N+1-Abfragen im ORM-Code erzeugt oder Tests ohne aussagekräftige Assertions generiert.
Nur 29 % der Entwickler vertrauen der KI-Genauigkeit – Stack Overflow Developer Survey via Uvik
Diese Vertrauenslücke wird in den anspruchsvollsten Bereichen von Python größer: Datenpipelines, in denen stille Typumwandlung Ergebnisse verfälscht, asynchrone Webserver, bei denen ein fehlendes await zu Ressourcenlecks führt, und ML-Trainingsschleifen, bei denen ein einziger Indexierungsfehler Stunden an GPU-Zeit verschwendet.
Warum der Python Coding Assistant
Der Python Coding Assistant ist kein allgemeiner Chatbot, der passablen Python-Code generiert – es ist eine spezialisierte KI mit tiefem Ökosystemwissen, der Unterschied zwischen Code, der läuft, und Code, der in eine Produktions-Codebasis gehört.
| Traditioneller Ansatz | Python Coding Assistant |
|---|---|
| Stack Overflow durchsuchen + Antworten an Ihr Projekt anpassen | Beschreiben Sie Ihren Bedarf, erhalten Sie Code, der auf Ihren exakten Stack und Ihre Konventionen zugeschnitten ist |
| 30-60 Min. Debuggen von asynchronen Tracebacks über Middleware-Schichten | Fügen Sie den Traceback ein, erhalten Sie eine Ursachenanalyse und eine funktionierende Korrektur in Sekunden |
| Stundenlanges Erstellen neuer Django/FastAPI-Projekte mit Authentifizierung, Validierung und Tests | Generieren Sie eine vollständige Projektstruktur mit korrekter Trennung der Verantwortlichkeiten |
| Manuelles Schreiben von Tests – oft unter Termindruck übersprungen | Sofortige pytest-Generierung mit Fixtures, Parametrisierung und Grenzfällen |
| Lesen von Migrationsleitfäden für Pydantic v1→v2 oder Django-Versions-Upgrades | Fragen Sie direkt nach Breaking Changes und erhalten Sie umsetzbare Migrationsschritte |
Idiomatisches, typisiertes, modernes Python
Jeder Vorschlag folgt den aktuellen Python-Konventionen: f-strings statt .format(), pathlib statt os.path, dataclasses oder Pydantic-Modelle statt roher Dictionaries, korrekte async/await-Muster und umfassende PEP 484-Typannotationen. Der Assistent generiert Code, der mypy --strict besteht – nicht nur Code, der nicht abstürzt.
„Erstellen Sie einen FastAPI-Endpunkt für die Benutzerregistrierung mit Pydantic v2-Validierung, Passwort-Hashing mit bcrypt, SQLAlchemy async session injection und korrekten HTTP-Fehlerantworten“
Umfassende Ökosystem-Kenntnisse
Ob Sie ein Django-Admin-Dashboard, einen FastAPI-Microservice, eine pandas-ETL-Pipeline, eine PyTorch-Trainingsschleife oder ein CLI-Tool mit Click erstellen – der Assistent versteht die Idiome, Muster und Fallstricke, die für jedes Framework spezifisch sind. Er kennt nicht nur die Python-Syntax; er weiß, warum man select_related vs. prefetch_related in Django verwendet, wann man asyncio.gather vs. TaskGroup wählt und wie man eine korrekte pytest-Fixture-Hierarchie strukturiert.
„Refaktorisieren Sie diese synchrone Django-View in eine asynchrone View mit korrekter Datenbankverbindungshandhabung und erklären Sie, was ich in meinem Middleware-Stack ändern muss“
Debugging, das die Ursachen findet
Fügen Sie einen Traceback, eine Fehlermeldung, eine Sentry-Warnung oder einen Codeblock ein, der falsche Ergebnisse liefert. Der Assistent identifiziert das tatsächliche Problem – nicht nur das Symptom – und liefert eine Korrektur mit einer Erklärung, warum es fehlgeschlagen ist. Dazu gehören subtile Probleme wie stille pandas-Typumwandlung, SQLAlchemy Lazy Loading außerhalb des Session-Bereichs und Fehler bei der Bereinigung von asynchronen Generatoren.
„Ich erhalte 'RuntimeError: Event loop is already running', wenn ich asyncio.run() innerhalb einer Celery-Task aufrufe. Hier ist mein Task-Code und meine Celery-Konfiguration – was ist das korrekte asynchrone Muster für Celery?“
Verwandte Agents, die Sie ebenfalls nützlich finden werden
Die Python-Entwicklung findet selten isoliert statt. Diese spezialisierten Agents ergänzen den Python Coding Assistant für Aufgaben, die natürlich neben der Python-Arbeit anfallen:
SQL Coding Assistant
Die meisten Python-Anwendungen sind stark von Datenbanken abhängig – sei es über Django ORM, SQLAlchemy oder rohe Abfragen. Wenn Sie langsame Abfragen optimieren, Schemata entwerfen oder PostgreSQL-Leistungsprobleme debuggen müssen, die über das hinausgehen, was Ihr ORM abstrahiert.
- Abfrageoptimierung und Ausführungsplananalyse für PostgreSQL, MySQL und SQLite
- Schema-Design mit geeigneten Indexierungsstrategien für die Zugriffsmuster Ihrer Python-Anwendung
- Generierung von rohem SQL für komplexe Reporting-Abfragen, die ORMs schlecht handhaben
JavaScript/TypeScript Coding Assistant
Full-Stack-Python-Entwickler, die React- oder Vue.js-Frontends für ihre Django/FastAPI-APIs erstellen oder mit Node.js-Tools in ihrer Build-Pipeline arbeiten.
- React- und Vue.js-Frontend-Entwicklung für Python-API-Backends
- TypeScript-Client-Generierung aus OpenAPI-Spezifikationen, die von FastAPI erstellt wurden
- Build-Tooling, Vite-Konfiguration und Frontend-Tests mit Jest/Vitest
LeetCode Coach
Vorbereitung auf technische Interviews bei Unternehmen, in denen Python die Hauptsprache ist – Google, Meta, Stripe oder jedes Startup, das Python-Ingenieure einstellt. Der LeetCode Coach bietet adaptives Üben mit einem auf Python-spezifische Optimierung ausgerichteten Fokus.
- Adaptiver Schwierigkeitsgrad bei Algorithmen, Datenstrukturen und Systemdesign
- Python-spezifische Lösungsmuster – List Comprehensions, defaultdict, heapq, deque
- Mock-Interview-Simulationen einschließlich Verhaltens- und KI-Runden-Vorbereitung
Deep Research
Wenn Sie Python-Bibliotheken bewerten, Frameworks vergleichen oder Best Practices recherchieren müssen, bevor Sie architektonische Entscheidungen treffen – die Art von umfassender Recherche, die normalerweise Stunden des Lesens von Dokumentationen und Blog-Posts erfordert.
- Bibliotheksvergleichsrecherche (z. B. SQLAlchemy vs. Tortoise ORM vs. Django ORM)
- Analyse von Best Practices für die Architektur und Bereitstellung von Python-Projekten
- Technologiebewertungsberichte mit zitierten Quellen
Wie es funktioniert
Schritt 1: Beschreiben Sie Ihren Python-Entwicklungsbedarf
Öffnen Sie den Python Coding Assistant und beschreiben Sie in einfacher Sprache, was Sie erstellen. Geben Sie Ihr Framework, Ihre Python-Version und alle Einschränkungen an – der Assistent passt sich Ihrem exakten Stack an.
„Ich baue ein FastAPI-Backend für eine Aufgabenverwaltungs-App. Richten Sie die Projektstruktur mit SQLAlchemy 2.0 async, Alembic-Migrationen, Pydantic v2-Schemas und einem korrekten Repository-Muster mit Dependency Injection ein.“
Schritt 2: Iterieren und inkrementell bauen
Überprüfen Sie den generierten Code, stellen Sie Folgefragen, fordern Sie Änderungen an oder fügen Sie vorhandenen Code zum Refactoring ein. Der Assistent behält den vollen Kontext über die gesamte Konversation bei – jede Antwort baut auf dem Vorherigen auf.
„Fügen Sie jetzt JWT-Authentifizierung mit Refresh-Tokens, rollenbasierte Zugriffskontroll-Middleware und Ratenbegrenzung pro Benutzer hinzu. Verwenden Sie python-jose für Tokens und Redis für die Speicherung der Ratenbegrenzung.“
Schritt 3: Debuggen und beheben
Wenn etwas kaputt geht, fügen Sie den Fehler ein. Tracebacks, pytest-Fehler, mypy-Fehler oder einfach nur „diese Funktion liefert falsche Ergebnisse für diese Eingabe“. Der Assistent diagnostiziert das Problem auf der logischen Ebene, nicht nur auf der Syntaxebene.
„Mein pytest schlägt mit 'sqlalchemy.exc.MissingGreenlet: greenlet_spawn has not been called' fehl. Hier ist meine Test-Fixture und conftest.py – ich verwende async SQLAlchemy mit pytest-asyncio.“
Schritt 4: Testen, Typ-prüfen und ausliefern
Fordern Sie umfassende Tests, Typannotationen, Docstrings oder Bereitstellungskonfigurationen an. Der Assistent generiert pytest-Suiten mit korrekten Fixtures und Parametrisierung, fügt mypy-kompatible Type Hints hinzu und kann bei der Einrichtung von Docker, CI/CD und der Bereitstellung helfen.
„Schreiben Sie pytest-Tests für das Authentifizierungsmodul – decken Sie erfolgreiche Anmeldungen, ungültige Anmeldeinformationen, abgelaufene Tokens, Refresh-Token-Rotation und die Durchsetzung von Ratenbegrenzungen ab. Verwenden Sie httpx AsyncClient mit der TestClient-Fixture.“
Ergebnisse & Anwendungsfälle
💼 Web-API-Entwicklung
Szenario: Ein Backend-Entwickler muss eine mandantenfähige SaaS-API mit FastAPI erstellen – Mandantenisolierung, JWT-Authentifizierung, Stripe-Webhook-Verarbeitung, Hintergrundaufgabenverarbeitung mit Celery und umfassende API-Dokumentation – ein Projekt, das normalerweise 2-3 Wochen für das Grundgerüst benötigt, bevor Geschäftslogik geschrieben wird.
Traditioneller Ansatz: Tage des Zusammensetzens von Boilerplate aus FastAPI-Dokumentationen, Stripe-API-Referenzen, Celery-Konfigurationsanleitungen und verschiedenen Blog-Posts. Manuelle Einrichtung von Middleware-Ketten, Dependency-Injection-Hierarchien und Testinfrastruktur.
Python Coding Assistant: Generiert die vollständige Projektinfrastruktur in einer einzigen Sitzung – Mandantenauflösungs-Middleware, asynchrone SQLAlchemy-Repository-Schicht, Stripe-Webhook-Verifizierung mit Event-Routing, Celery-Task-Definitionen mit Wiederholungsrichtlinien und eine pytest-Suite mit httpx AsyncClient-Fixtures. Der Entwickler schreibt vom ersten Tag an Geschäftslogik.
- Vollständige FastAPI-Projektstruktur mit korrekter Trennung der Verantwortlichkeiten
- Stripe-Integration mit Webhook-Signaturverifizierung und Idempotenz-Handhabung
- Celery-Task-Definitionen mit exponentiellen Backoff-Wiederholungsrichtlinien
📊 Datenpipeline & Analyse
Szenario: Ein Dateningenieur muss eine ETL-Pipeline erstellen, die CSV-Dateien aus S3 aufnimmt, die Daten mit pandas validiert und transformiert, Anomalieerkennung durchführt und die Ergebnisse in PostgreSQL lädt – mit ordnungsgemäßer Protokollierung, Fehlerbehandlung und Wiederholungslogik.
Traditioneller Ansatz: Zusammenbasteln von boto3-S3-Operationen, pandas-Transformationsketten, SQLAlchemy-Bulk-Inserts und benutzerdefinierter Fehlerbehandlung. Das Testen von Datenpipelines ist notorisch schwierig – die meisten Teams überspringen es ganz und debuggen in der Produktion.
Python Coding Assistant: Erstellt eine strukturierte Pipeline mit typisierten Dataclass-Konfigurationen, pandas-Transformationen mit expliziten dtype-Spezifikationen zur Vermeidung stiller Umwandlung, SQLAlchemy-Bulk-Upsert-Operationen und umfassenden pytest-Fixtures mit synthetischen Testdaten. Kombinieren Sie ihn mit dem SQL Coding Assistant zur Optimierung des Zieldatenbankschemas und der Abfrageleistung.
- Typisierte Pipeline-Konfiguration mit Pydantic-Einstellungsverwaltung
- pandas-Transformationen mit expliziter dtype-Handhabung und Validierungs-Assertions
- pytest-Fixtures, die synthetische Daten für deterministische Pipeline-Tests generieren
📱 Mobile-First-Entwicklungsworkflow
Szenario: Ein freiberuflicher Python-Entwickler pendelt und muss einen Pull-Request überprüfen, einen von einem Kollegen gemeldeten Django-Migrationsfehler debuggen und das Grundgerüst eines neuen API-Endpunkts entwerfen – alles von seinem Telefon aus.
Traditioneller Ansatz: Warten, bis er seinen Laptop erreicht. Versuchen, Code auf einer mobilen GitHub-Oberfläche zu lesen. 45 Minuten produktive Zeit verlieren.
Python Coding Assistant: Verfügbar auf iOS und Android mit voller Konversationsfähigkeit. Der Entwickler fügt den Migrationsfehler ein und erhält die Korrektur mit Kontext. Beschreibt die neuen Endpunktanforderungen und erhält eine vollständige Implementierung, die er pushen kann, wenn er wieder an seinem Schreibtisch ist. Überprüft die PR-Logik, indem er Schlüsselfunktionen einfügt und um eine Code-Überprüfung bittet.
- Volle Debugging-Fähigkeit von mobilen Geräten – Fehler einfügen, Korrekturen erhalten
- Code-Generierung bereit zum Kopieren in Ihre IDE, wenn Sie wieder an Ihrem Schreibtisch sind
- Code-Review-Analyse mit spezifischen Verbesserungsvorschlägen
🎯 Machine Learning Workflow
Szenario: Ein Datenwissenschaftler erstellt ein Klassifikationsmodell mit scikit-learn und muss eine korrekte Kreuzvalidierung mit stratifizierten Aufteilungen, Hyperparameter-Tuning mit Optuna, Feature-Importance-Analyse und Modellserialisierung implementieren – alles mit reproduzierbaren Ergebnissen.
Traditioneller Ansatz: Lesen der scikit-learn-Dokumentation für die Pipeline-Konstruktion, der Optuna-Dokumentation für die Studienkonfiguration und von Stack Overflow für Randfälle bei Klassenungleichgewicht, Reihenfolge der Feature-Skalierung und Verwaltung von Zufalls-Seeds. Senior Python-Entwickler kosten jährlich über 170.000 $, was langsame Experimentierzyklen teuer macht.
Python Coding Assistant: Generiert eine vollständige ML-Pipeline mit korrekter Vorverarbeitung (Skalierung innerhalb der Kreuzvalidierungs-Folds, nicht davor), stratifizierten K-Fold-Splits, Optuna-Hyperparameter-Optimierung mit Pruning-Callbacks, SHAP-basierter Feature-Importance und joblib-Modellserialisierung mit Metadaten-Tracking.
- scikit-learn-Pipeline mit ColumnTransformer und korrekter Fold-bewusster Vorverarbeitung
- Optuna-Studie mit TPE-Sampler, Pruning und Pareto-optimaler Multi-Objective-Unterstützung
- Reproduzierbarkeit: Seed-Management, Experimentprotokollierung und Umgebungs-Pinning
FAQ
Ist der Python Coding Assistant kostenlos?
Ja – Jenova bietet eine kostenlose Stufe mit Zugang zum Python Coding Assistant und allen Kernfunktionen. Bezahlte Pläne ab 20 $/Monat bieten deutlich mehr Nutzung, benutzerdefinierte Modellauswahl und keine Wasserzeichen auf generierten Dokumenten. Keine Kreditkarte zum Starten erforderlich.
Wie unterscheidet sich dies von GitHub Copilot für Python?
GitHub Copilot bietet Inline-Code-Vervollständigungen in Ihrer IDE. Der Python Coding Assistant ist eine spezialisierte Konversations-KI mit tiefem Python-Ökosystem-Fachwissen – er behandelt Architekturdiskussionen, Refactoring-Anleitungen für mehrere Dateien, Traceback-Debugging, ML-Pipeline-Design und vollständiges Projekt-Scaffolding. Er ist für die kontextintensive Python-Arbeit konzipiert, bei der allgemeine Tools mit Framework-spezifischen Mustern wie Dekoratoren, Type Hints und asynchronen Generatoren zu kämpfen haben.
Kann er mit Django, FastAPI und anderen Python-Frameworks umgehen?
Absolut. Der Assistent generiert idiomatischen Code für Django (ORM, Views, Middleware, Management-Befehle), FastAPI (Dependency Injection, Pydantic v2, asynchrone Endpunkte), Flask, SQLAlchemy, Celery, pandas, PyTorch, scikit-learn und das breitere Python-Ökosystem. Für datenbankspezifische Optimierung kombinieren Sie ihn mit dem SQL Coding Assistant.
Funktioniert es auf Mobilgeräten?
Ja. Jenova hat volle Funktionsparität über Web, iOS und Android. Debuggen Sie Python-Tracebacks, diskutieren Sie Architektur oder generieren Sie Code von Ihrem Telefon aus – nützlich für die Überprüfung von Pull-Requests während des Pendelns oder das schnelle Prototyping von Lösungen abseits Ihres Arbeitsplatzes.
Generiert es typisiertes, mypy-kompatibles Python?
Der Assistent generiert modernes Python mit umfassenden PEP 484-Typannotationen, einschließlich Generics, TypeVar, Protocol, TypedDict und Pydantic-Modelldefinitionen. Der generierte Code ist so konzipiert, dass er mypy --strict besteht und nahtlos mit Pyright und anderen statischen Analysewerkzeugen funktioniert.
Wird mein Code privat gehalten?
Ja. Jenova verwendet Ihre Daten niemals zum Trainieren öffentlicher KI-Modelle. Alle Daten werden bei der Übertragung und im Ruhezustand verschlüsselt und niemals an Werbetreibende verkauft oder weitergegeben – wichtig für Entwickler, die an proprietären Anwendungen oder sensiblen Datenpipelines arbeiten.
Fazit
Die Dominanz von Python im Jahr 2026 – die alles von KI-Forschung über Web-APIs bis hin zu Data Engineering antreibt – bedeutet, dass Entwickler einer beispiellosen Breite von Frameworks, Mustern und Best Practices gegenüberstehen, die sie gleichzeitig im Auge behalten müssen. Allgemeine KI-Coding-Tools decken die Oberfläche von Python ab, aber es fehlt ihnen an Tiefe: Sie generieren untypisierten Code, ignorieren Framework-spezifische Idiome, erzeugen ORM-Abfragen mit versteckten Leistungsfallen und schreiben Tests ohne aussagekräftige Assertions. Der Python Coding Assistant schließt diese Lücke mit spezialisiertem Fachwissen über das gesamte Python-Ökosystem – von Django-Middleware-Ketten über PyTorch-Trainingsschleifen bis hin zum Debuggen von pandas-Pipelines – und agiert als erfahrener Python-Entwickler, der typisierten, getesteten, produktionsreifen Code schreibt und die Gründe hinter jeder architektonischen Entscheidung erklärt.
Probieren Sie den Python Coding Assistant jetzt aus – keine Kreditkarte erforderlich. Entdecken Sie die vollständige Agent-Bibliothek bei Jenova.