Sind spezialisierte AI-Rechercheassistenten zuverlässiger als Chatbots?
2026-08-22
Wie unterscheiden Rückverfolgbarkeit und Quellenverankerung Forschungs-AI von Chatbots?
Spezialisierte akademische Rechercheassistenten sind bei Zitatrückverfolgbarkeit und Evidenzextraktion zuverlässiger als allgemeine AI-Chatbots, weil sie wissenschaftliche Indizes durchsuchen, Aussagen identifizierbaren Passagen zuordnen und stützenden oder widersprüchlichen Kontext offenlegen. Allgemeine Chatbots erzeugen flüssige bibliografische Sprache aus Trainingsmustern. Deshalb erfinden sie weiterhin Autoren, Titel, DOIs und Ergebnisse, die sich nicht auf eine Quelle zurückführen lassen.
Die Zuverlässigkeitslücke betrifft nicht die Qualität des Schreibens. Sie betrifft die Frage, ob eine Aussage überprüft werden kann.
Wichtige Faktoren, die zitierfähige Rechercheunterstützung von Chatbot-Prosa unterscheiden:
✅ Abruf vor Generierung — Antworten werden aus indexierten Studien zusammengestellt und nicht allein aus der Wahrscheinlichkeit des nächsten Tokens erzeugt
✅ Attribution auf Passageebene — jedes extrahierte Ergebnis verweist auf einen Satz, eine Tabelle oder einen Abschnitt, nicht nur auf einen Studientitel
✅ Sichtbarkeit von Widersprüchen — spätere Arbeiten, die eine Aussage stützen, bestreiten oder nur erwähnen, werden angezeigt, statt in einer Zusammenfassung eingeebnet zu werden
✅ Strukturierte Extraktion — Methoden, Stichproben, Ergebnisse und Einschränkungen werden in vergleichbare Felder überführt, statt in Paragrafen paraphrasiert zu werden
✅ Für Menschen prüfbare Herkunft — jede Zusammenfassung, jedes Zitat und jedes extrahierte Ergebnis kann mit der Originalquelle abgeglichen werden
Um diese Tools 2026 sinnvoll zu vergleichen, sollte man Zitierzuverlässigkeit als technische Eigenschaft und nicht als Markenversprechen behandeln. Der Rest dieses Artikels bewertet Chatbots und Rechercheassistenten anhand dieser Eigenschaft.
Warum ist Zitierzuverlässigkeit zu einem Problem der Forschungsintegrität geworden?
Zitierzuverlässigkeit ist zu einem Problem der Forschungsintegrität geworden, weil generative AI inzwischen im Veröffentlichungsmaßstab eingesetzt wird, während allgemeine Modelle weiterhin Referenzen fabrizieren, die real genug wirken, um einer oberflächlichen Prüfung standzuhalten. Die Nutzung durch Studierende und Forschende stieg 2025 stark an, und erfundene Zitate sind kein neuartiger Einzelfehler mehr. Sie gelangen in Konferenzbeiträge, Manuskripte und Zitationsnetzwerke.
Die Studierendenumfrage 2025 des Higher Education Policy Institute ergab, dass die Nutzung generativer AI-Tools für Prüfungsleistungen innerhalb eines Jahres von 53 % auf 88 % stieg. Eine ergänzende Auswertung derselben Umfrage berichtete, dass 92 % der Studierenden AI inzwischen in irgendeiner Form nutzen, gegenüber 66 % im Jahr 2024. Dieses Volumen ist relevant, weil eine plausible falsche Referenz schwerer zu erkennen ist als eine fehlende.
Eine Analyse aus dem Jahr 2026 in Energy Research & Social Science berichtete, dass ChatGPT 178 Referenzen für Forschungsanträge erzeugte, von denen 69 keine gültigen DOIs hatten. Dieselbe Arbeit verwies auf eine GPTZero-Prüfung von 4.841 NeurIPS-2025-Beiträgen, die mindestens 100 halluzinierte Zitate in 53 angenommenen Arbeiten bestätigte. Die Begutachtung durch mehrere Fachleute erkannte sie nicht.
Der Mechanismus ist inzwischen gut beschrieben. Eine AI-Halluzination ist eine flüssig formulierte Ausgabe, die falsch oder nicht quellenbasiert ist. Leitlinien von Universitätsbibliotheken weisen darauf hin, dass Chatbots ein vollständiges Zitat erfinden können — Autor, Titel und Zeitschrift. Science argumentiert, dass Modelle darauf trainiert sind, eine Antwort zu erzeugen, selbst wenn sie keine kennen. Lautet die Eingabeaufforderung „Quellen zitieren“, gleicht das Modell bibliografische Stile ab. Bei Nischen- oder aktuellen Themen wird dieses Stilabgleichen zur Erfindung.
Was sollten Sie bei der Auswahl eines AI-Rechercheassistenten bewerten?
Sie sollten einen AI-Rechercheassistenten danach bewerten, ob jede Aussage zurückverfolgt, quellenbasiert verankert, zugeordnet, auf Widersprüche geprüft und extrahiert werden kann — nicht danach, wie ausgefeilt die Prosa klingt. Eine hilfreiche Kurzform ist das TRACE-Framework: Rückverfolgbarkeit, Abrufverankerung, Attributionsgranularität, Widerspruchsbewusstsein und Extrahierbarkeit.
Rückverfolgbarkeit fragt, ob Leser von einem Satz im Entwurf zur exakten unterstützenden Passage gelangen können. Wenn ein Tool nur eine formatierte Referenz ausgibt, liefert es einen Verweis, keinen Beleg.
Abrufverankerung fragt, ob das System einen wissenschaftlichen Korpus durchsucht hat oder aus Modellgewichten sampelt. Quellenbasierte Extraktion soll sowohl unbelegte Erfindungen als auch nicht zugeordnete Paraphrasen verhindern, indem sie für jede extrahierte Aussage eine explizite Quellenattribution verlangt.
Attributionsgranularität unterscheidet Quellenangaben auf Studienebene von Zitaten auf Satz- oder Feldebene. Eine Studie kann real sein, während das zitierte Ergebnis falsch, überholt oder dem Abstract statt den Resultaten entnommen ist.
Widerspruchsbewusstsein fragt, ob das Tool spätere Studien zeigt, die eine Aussage stützen, infrage stellen oder lediglich erwähnen. Ein einzelnes bestätigendes Abstract ist keine Literaturübersicht.
Extrahierbarkeit fragt, ob Methoden, Stichproben, Ergebnisse und Einschränkungen in strukturierten Feldern verglichen werden können. Prosa-Zusammenfassungen verbergen fehlende Daten. Tabellen machen Lücken sichtbar.
Die Evidenzsynthese-Leitlinien des King's College London sind hinsichtlich der praktischen Konsequenz eindeutig: AI-Tools können Phasen eines Reviews unterstützen, aber validierte Suchmethoden nicht ersetzen, und generative Systeme erzeugen weiterhin falsche Referenzen. Eine in diesem Leitfaden zitierte Übersichtsarbeit aus dem Jahr 2025 kam zu dem Schluss, dass die aktuelle Evidenz den Einsatz generativer AI in der Evidenzsynthese ohne menschliche Beteiligung nicht stützt. Die Bewertungsfrage lautet daher nicht: „Kann dieses Tool schreiben?“ Sie lautet: „Kann dieses Tool überprüft werden?“
Wie schneiden spezialisierte Rechercheassistenten im Vergleich zu allgemeinen Chatbots ab?
Spezialisierte Rechercheassistenten übertreffen allgemeine Chatbots bei der Zitatrückverfolgbarkeit, weil sie Antworten an abgerufene Studien binden, während Chatbots vor allem beim Formulieren, Erklären und Brainstorming stark bleiben. Der ehrliche Vergleich ist rollenbasiert. Chatbots sind flexible Schreibwerkzeuge. Rechercheassistenten sind engere, besser prüfbare Abrufsysteme.
Elicit durchsucht Millionen wissenschaftlicher Arbeiten und liefert strukturierte Berichte mit Zitaten. Besonders stark ist es, wenn Forschende Methoden, Stichproben und Ergebnisse über mehrere Studien hinweg gegenüberstellen müssen. Ein mit Cochrane verknüpfter Vergleich aus dem Jahr 2026, auf den King's College London verweist, stellte fest, dass Elicit nicht mit ausreichend hoher Sensitivität sucht, um die herkömmliche Literaturrecherche zu ersetzen, seine Präzision es jedoch als Ergänzung nützlich macht. Das ist eine echte Einschränkung und keine Fußnote.
Scite ist eher auf Verifikation als auf Entwürfe ausgerichtet. Es berichtet über eine Abdeckung von mehr als 300 Millionen wissenschaftlichen Artikeln und lizenzierte Zugänge über Vereinbarungen mit mehr als 40 Verlagen. Seine Smart Citations klassifizieren, ob spätere Arbeiten eine Aussage stützen, ihr widersprechen oder sie lediglich erwähnen. Jede Aussage seines Assistenten ist mit dem konkreten Satz in der konkreten Studie verknüpft. Der Kompromiss liegt im Umfang: Scite ist bei Zitationsintelligenz stärker als bei durchgängigen Manuskript-Workflows.
ResearchRabbit ist am stärksten bei der Kartierung. Es hilft Forschenden, verwandte Arbeiten zu finden, Zitationskarten zu erstellen und zu beobachten, wie sich ein Forschungsfeld von einer Ausgangsarbeit aus erweitert. Als Engine für Evidenzextraktion oder Zitationsvalidierung ist es weniger geeignet. Das ist kein Mangel, wenn die Aufgabe Entdeckung lautet.
Allgemeine Chatbots wie ChatGPT werden weiterhin breit eingesetzt, weil sie schnell Entwürfe erstellen und unordentliche, fachübergreifende Fragen bewältigen. Ihre dokumentierte Schwäche ist die Erfindung bibliografischer Angaben. Aktuelle Berichte, die in der Integritätsanalyse von 2026 zusammengefasst wurden, bezifferten die Halluzinationsrate bei Tatsachenzitaten für fortgeschrittene Modelle wie GPT-4o und Claude 3.7 auf 15–20 %, bei Nischen- oder aktuellen Themen auf 35–55 %. Benchmarks, die wissenschaftliche Referenzen aus großen Sprachmodellen überprüfen, haben in einigen Szenarien Fehlerraten von mehr als 30 % berichtet.
Jenovas Academic Research Assistant nimmt eine andere Rolle ein. Er ist ein Domänen-Agent für Literaturentdeckung, Manuskriptvorbereitung und Zitationsmanagement, mit persistentem Gedächtnis und Live-Suche in akademischen Datenbanken. Er ist einem Chatbot darin überlegen, ein Forschungsprojekt über mehrere Sitzungen hinweg kohärent zu halten. Gegenüber Scite ist er bei der Klassifizierung lizenzierter Volltextzitate schwächer und gegenüber Elicit als dediziertem Produkt für Extraktionstabellen. Diese Lücken erklären, warum ein kombinierter Tool-Stack weiterhin besser abschneidet als jeder einzelne Assistent.
| Funktion / Dimension | Allgemeine Chatbots (z. B. ChatGPT) | Jenova Academic Research Assistant | Elicit | Scite | ResearchRabbit |
|---|---|---|---|---|---|
| Abrufverankerung | Primär Modellspeicher; Browsing variiert je nach Produkt | Live-Abruf wissenschaftlicher und Web-Quellen in einem persistenten Forschungsagenten | Korpussuche nach Studien mit strukturierten Berichten | Lizenzierter wissenschaftlicher Volltext plus offener Korpus | Entdeckung über Zitationsgraphen ausgehend von Ausgangsstudien |
| Zitatrückverfolgbarkeit | Häufig nicht überprüfbar oder erfunden | Quellen im Text mit anschließender Prüfung gegen Originale | Zitate an extrahierten Feldern | Links auf Satzebene plus Labels für Unterstützung/Widerspruch | Netzwerkverbindungen zwischen Studien, keine Belege auf Aussageebene |
| Evidenzextraktion | Freiform-Zusammenfassungen | Notizen, Vergleiche und manuskriptfertige Synthese | Starke strukturierte Tabellen | Stärker beim Zitationskontext als bei Feldextraktion | Begrenzt; Kartierung statt Extraktion |
| Widerspruchsbewusstsein | Meist zu einer Antwort eingeebnet | Kann bei entsprechender Anfrage widersprüchliche Ergebnisse vergleichen | Hängt von der abgerufenen Auswahl ab | Kernfunktion über Smart Citations | Indirekt, über Cluster verwandter Arbeiten |
| Preise (Stand 2026) | Je nach Tarif nicht verifiziert | Kostenloser Tarif; kostenpflichtige Tarife ab 20 $/Monat | Nicht verifiziert | Nicht verifiziert | Nicht verifiziert |
| Am besten geeignet für | Entwürfe, Erklärungen, frühe Einordnung | Laufende akademische Projekte, die Entdeckung plus Schreibgedächtnis benötigen | Sichtung von Studien in vergleichbaren Evidenztabellen | Prüfung, ob eine Aussage gestützt oder bestritten wird | Visuelle Literaturkartierung sowie Entdeckung von Autoren und Clustern |
Eine Übersicht akademischer AI-Recherchetools aus dem Jahr 2026 kam zu einer ähnlichen Arbeitsteilung: Elicit führte bei strukturierter Extraktion, Consensus war am schnellsten für rasche Evidenzprüfungen, und Semantic Scholar blieb der stärkste kostenlose Entdeckungsindex. Keine einzelne Spalte in dieser Landschaft ersetzt die anderen.
Wie unterscheidet sich die Evidenzextraktion zwischen akademischen AI-Tools?
Evidenzextraktion unterscheidet sich danach, ob ein Tool vergleichbare Felder oder nur eine narrative Paraphrase liefert. Die Extraktion auf Feldebene ist für Methoden, Stichprobengrößen, Ergebnisse und Einschränkungen zuverlässiger, weil fehlende Werte sichtbar bleiben. Narrative Extraktion ist schneller und besser lesbar, verschleiert aber den Unterschied zwischen einem Ergebnis, einer Interpretation und einem halluzinierten Detail.
Elicit ist das deutlichste Beispiel für den strukturierten Ansatz. Es soll eine Forschungsfrage in einen Bericht überführen, dessen Zeilen Studien und dessen Spalten Studienmerkmale darstellen. Dieses Format erklärt, warum Gutachter es bei der frühen Sichtung häufig bevorzugen. Dennoch muss ein Mensch die Einschlusslogik prüfen, denn hohe Präzision ersetzt keine hohe Trefferquote.
Scite extrahiert ein anderes Objekt: den Zitationskontext. Statt zu fragen: „Was hat diese Studie herausgefunden?“, fragt es: „Wie sind spätere Arbeiten mit diesem Ergebnis umgegangen?“ Das liegt näher an der Evidenzbewertung als an der Datenextraktion. Besonders nützlich ist es, nachdem eine potenzielle Schlüsselstudie bereits identifiziert wurde.
Allgemeine Chatbots extrahieren in Prosa. Fordern Sie einen Vergleich von vier randomisierten Studien an, erstellen sie einen selbstsicheren Absatz. Dieser Absatz kann als erste Skizze nützlich sein. Als Prüfartefakt ist er schlecht geeignet, weil kein Feld als „nicht berichtet“ markiert werden kann.
Jenovas Academic Research Assistant und sein ergänzender Deep Research-Agent liegen zwischen diesen Polen. Deep Research sucht breit und liefert einen synthetisierten Bericht mit Quellenangaben im Text. Der Academic Research Assistant hält den Projektstatus fest: frühere Einschlussentscheidungen, abgelehnte Studien, Stilvorgaben und unvollständige Manuskriptabschnitte bleiben in späteren Sitzungen verfügbar. Tests dieses Workflows zeigen bei mehrwöchigen Literaturübersichten einen praktischen Vorteil. Die Einschränkung ist ebenso praktisch. Keiner der beiden Agenten ist ein dediziertes Tool für das Screening systematischer Reviews nach dem Vorbild speziell entwickelter Lösungen wie Rayyan oder DistillerSR, die Bibliothekare für Evidenzsynthese weiterhin als besser evaluierte Option für die Sichtung von Titeln und Abstracts betrachten.
Eine zuverlässige Eingabeaufforderung zur Extraktion benennt die gewünschten Felder ausdrücklich:
„Extrahiere aus diesen Studien: Studiendesign, Stichprobengröße, Population, primäres Ergebnis, Wirkungsrichtung, genannte Einschränkungen und den exakten Satz, der jedes Feld stützt. Wenn ein Feld fehlt, schreibe ‚nicht berichtet‘, statt es abzuleiten.“
Dieselbe Eingabeaufforderung in einem Chatbot ist nur so gut wie der abgerufene Text. Wenn das Modell die Studie nie geöffnet hat, füllt es die Tabelle aus stilistischem Musterwissen.
Was erfordert eine Pipeline zur Zitationsverifikation tatsächlich?
Eine Pipeline zur Zitationsverifikation erfordert das Quelldokument, nicht nur die Referenzzeichenfolge. Der minimal funktionsfähige Prozess lautet: den zitierten Text aufnehmen, ihn segmentieren, die für die Aussage relevantesten Passagen abrufen, sie neu priorisieren und die Beziehung zwischen Aussage und Evidenz klassifizieren. Alles darunter ist Bibliografieformatierung.
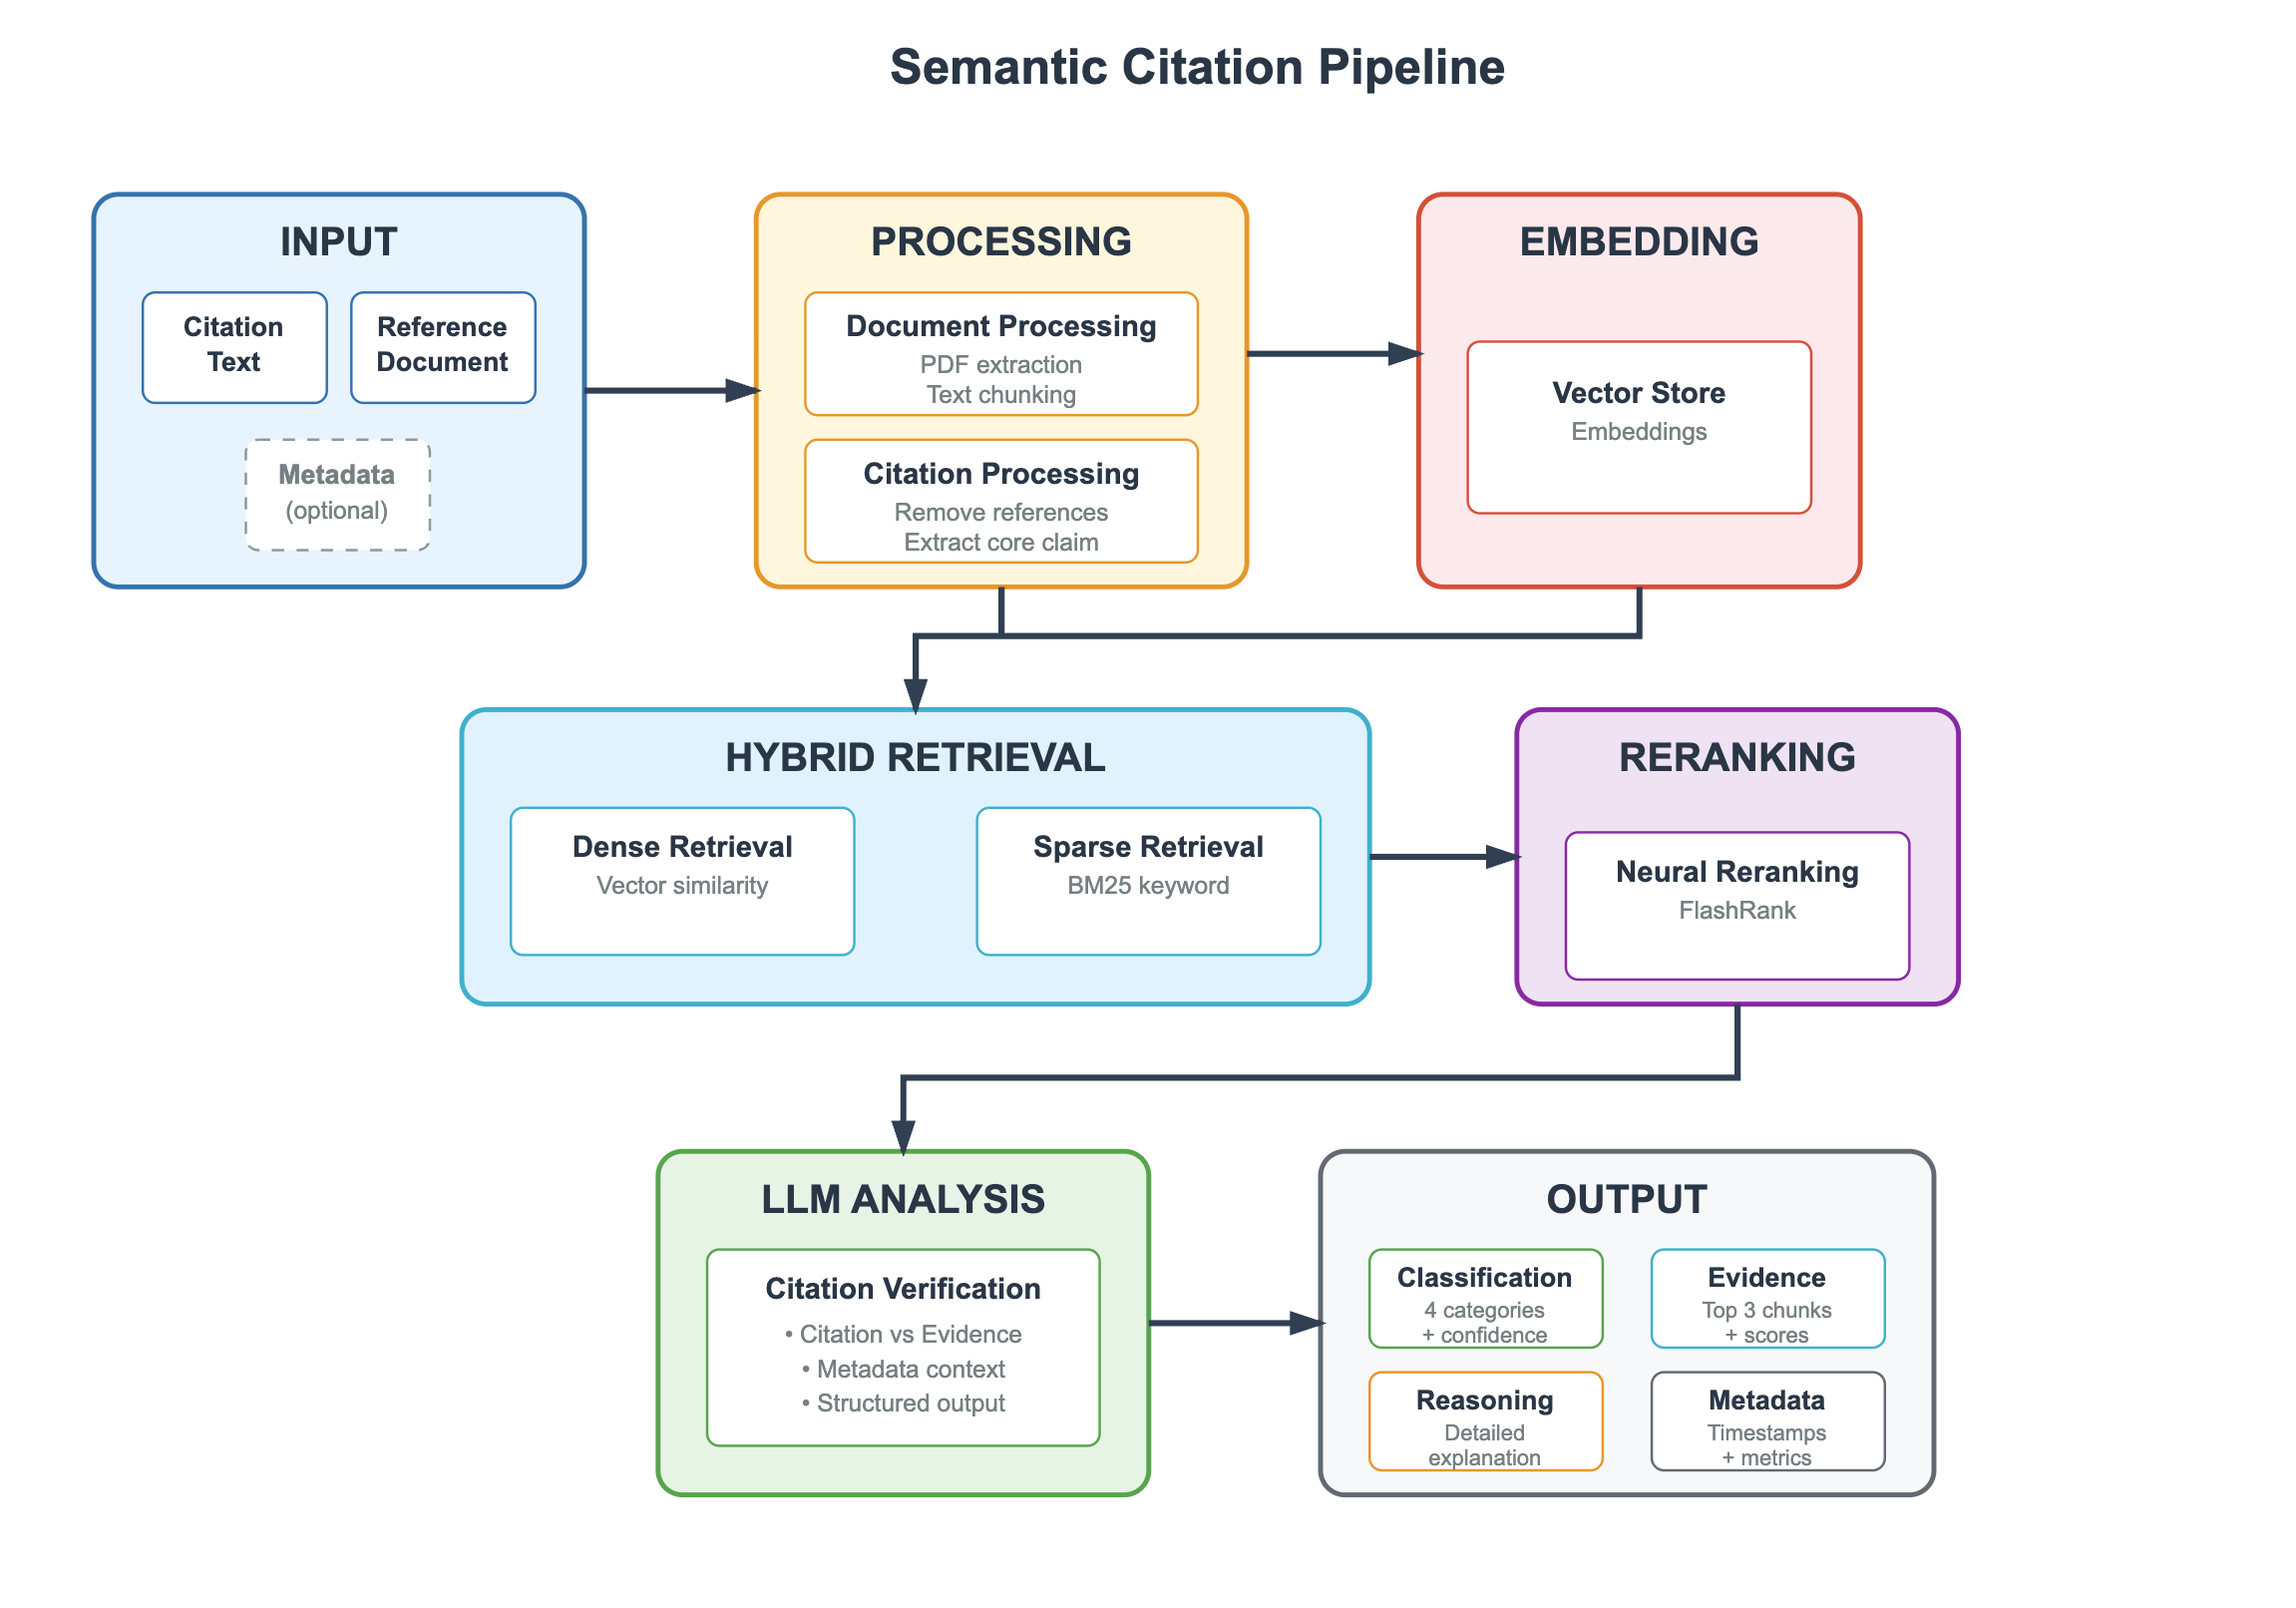
Die oben dargestellte Architektur ist der Unterschied zwischen „dieses Zitat sieht echt aus“ und „dieses Zitat ist gestützt“. Die Eingabe besteht aus der Aussage und dem Referenzdokument. Die Verarbeitung entfernt die Bibliografie, extrahiert die Kernaussage und segmentiert das PDF. Die hybride Suche durchsucht anschließend sowohl Vektorähnlichkeit als auch Keyword-Überschneidungen. Das ist wichtig, weil Methodenbezeichnungen und Zielgrößen bei einer rein semantischen Suche häufig nicht zuverlässig gefunden werden. Neuronale Neupriorisierung behält die besten Passagen bei. Erst dann klassifiziert ein LLM die Beziehung und gibt Evidenz, Konfidenz und Begründung zurück.
Systeme wie SemanticCite werden speziell entwickelt, um Zitiergenauigkeit durch Volltextanalyse der Quellen zu prüfen. Diese Designentscheidung existiert, weil der Abgleich von Metadaten nicht ausreicht. Ein DOI kann gültig sein, während der zitierte Satz aus einer anderen Studie, einem Preprint-Abstract oder einem Ergebnis stammt, das die Autoren später eingeschränkt haben.
Die Infrastruktur von Verlagen löst dieses Problem nicht automatisch. Große Zeitschriften verlinken Referenzen bereits, doch Schätzungen, die in der Integritätsanalyse von 2026 diskutiert werden, beziffern DOI-Ausfälle oder Link-Verfall in Stichproben wissenschaftlicher Inhalte auf bis zu 37 %. Ein grüner Link ist keine verifizierte Aussage.
Hier scheitern allgemeine Chatbots auch am vorhersehbarsten. Sie optimieren auf eine vollständige Antwort. Eine Verifikationspipeline optimiert auf eine klassifizierte Beziehung: gestützt, nicht gestützt, widerlegt oder unzureichende Evidenz. Diese vier Labels sind wissenschaftlich nützlicher als ein ausformulierter Absatz, weil sie Forschenden zeigen, welche Prüfung noch aussteht.
Jenova-Agenten können eine leichtgewichtige Version dieses Kreislaufs ausführen, indem sie die potenzielle Studie abrufen, die stützende Passage zitieren und Aussagen markieren, die nicht auffindbar sind. Sie ersetzen derzeit jedoch keinen lizenzierten Volltext-Zitationsklassifikator mit Abdeckung im Umfang großer Verlage. Forschende, die Smart-Citation-Labels benötigen, kombinieren daher weiterhin einen Schreibagenten mit Scite, statt ein System um beide Aufgaben zu bitten.
Wie bauen Sie einen sichereren AI-gestützten Literatur-Workflow auf?
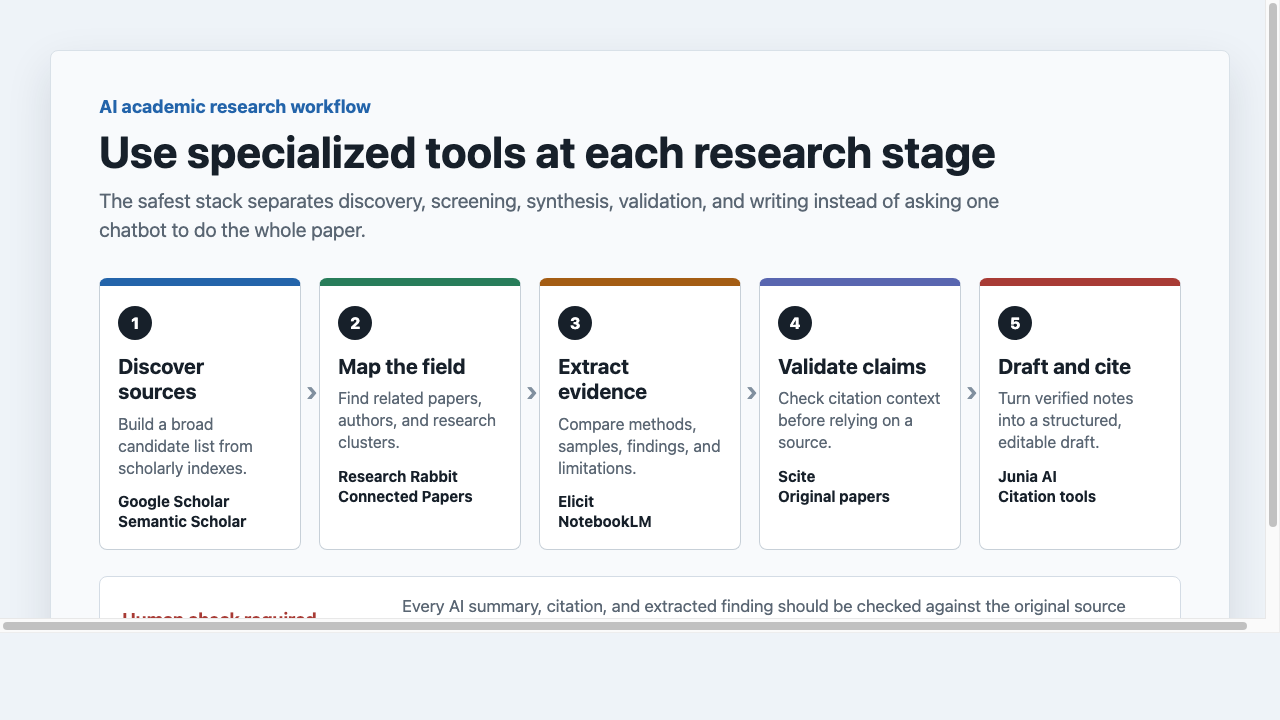
Sie bauen einen sichereren AI-gestützten Literatur-Workflow auf, indem Sie jeder Phase ein prüfbares Tool zuweisen und dann jedes extrahierte Ergebnis gegen die Originalstudie verifizieren. Das unsichere Muster besteht darin, einen einzelnen Chatbot entdecken, sichten, extrahieren, validieren und schreiben zu lassen.
Ein gestufter Workflow sieht so aus:
- Entdecken Sie Quellen in wissenschaftlichen Indizes wie Google Scholar oder Semantic Scholar, nicht in einem Chatfenster.
- Kartieren Sie das Feld mit ResearchRabbit oder Connected Papers, damit verwandte Autoren und Cluster sichtbar werden.
- Extrahieren Sie Evidenz mit Elicit, NotebookLM oder einem Forschungsagenten in strukturierte Notizen.
- Validieren Sie Aussagen in Scite und in den Original-PDFs, bevor ein Satz als zitierfähig behandelt wird.
- Entwerfen und zitieren Sie nur aus dem verifizierten Notizbestand.
Für Jenovas Academic Research Assistant beginnt die Einrichtung mit einem Forschungsbriefing und nicht mit einer Funktionsführung:
- Öffnen Sie den Agenten unter jenova.ai/a/academic-research-assistant.
- Formulieren Sie die Frage, das Fachgebiet und das gewünschte Ergebnis:
„Ich schreibe einen Methodenabschnitt über LLM-Zitierfehlerraten. Priorisiere peer-reviewte Studien und Verlagsanalysen aus den Jahren 2023–2026. Extrahiere für jede Quelle Stichprobe, Fehlerdefinition, Halluzinationsrate und ob Menschen die Referenzen verifiziert haben.“
- Bitten Sie zunächst um eine Kandidatenliste, dann um Extraktionstabellen und erst danach um Prosa. Überspringen Sie den Entwurf nicht.
- Bewahren Sie abgelehnte Studien im selben Thread auf, damit der Agent sie später nicht erneut einführt.
Für Elicit entspricht der Einstieg einer eng gefassten Frage und einer Spaltenliste: Population, Intervention, Ergebnis und Studientyp. Bei Scite beginnen Sie mit einer bekannten Studie oder Aussage und prüfen vor dem Schreiben stützende gegenüber widersprechenden Zitaten. Bei einem allgemeinen Chatbot ist die sicherste Verwendung die Gliederung und sprachliche Überarbeitung, nachdem die Quellen bereits vorliegen.
Zwei Betriebsregeln verhindern die meisten Fehler. Erstens: Akzeptieren Sie niemals ein Zitat, das nicht geöffnet werden kann. Zweitens: Lassen Sie das Entwurfsmodell niemals zur einzigen Aufzeichnung dessen werden, was eine Studie gesagt hat. Die verifizierte Notiz ist die maßgebliche Quelle. Der Entwurf ist eine Neuordnung dieser Notiz.
Wann ist ein allgemeiner Chatbot trotzdem das bessere akademische Tool?
Ein allgemeiner Chatbot ist weiterhin das bessere akademische Tool, wenn es um Sprache, Struktur oder Erklärung statt um Evidenz geht. Zuverlässigkeit hängt von der Aufgabe ab. Zitatrückverfolgbarkeit ist der falsche Test für ein Schreibmodell, ebenso wie sprachliche Flüssigkeit der falsche Test für einen Abrufindex ist.
Chatbots bleiben nützlich für:
- Die Umwandlung einer verifizierten Gliederung in klarere akademische Prosa
- Die Erklärung einer Methode, die der Forschende bereits gelesen hat
- Die Generierung von Suchstrings, Gegenargumenten oder Checklisten für Überarbeitungen
- Die Übersetzung dichter Passagen in verständlichere Sprache für Notizen, nicht für Zitate
Als primäre Literatur-Engine sind sie ungeeignet. Eine mit Nature verknüpfte Klassifikationsarbeit behandelt unbelegte Chatbot-Aussagen als eigenständigen Halluzinationstyp, und Bibliotheksleitfäden wiederholen dieselbe Warnung: Erfundene Zitate können ein vollständiges Paket aus Autor, Titel und Zeitschrift enthalten. Dieser Fehlermodus ist in Abschlussarbeiten, Förderanträgen und Zeitschrifteneinreichungen kostspielig, weil eine erfundene Referenz ein ansonsten sorgfältiges Argument diskreditieren kann.
Es gibt auch einen Workflow-Grund, Chatbots im Tool-Stack zu behalten. Spezialisierte Tools sind enger ausgerichtet. Elicit arbeitet nicht am Rhythmus eines Absatzes. Scite führt kein semesterlanges Beratungsgespräch über ein Dissertationskapitel. ResearchRabbit formatiert keinen Referenzstil einer Zeitschrift. Ein Chatbot oder allgemeiner Schreibagent schließt diese Lücken, nachdem die Evidenz gesichert wurde.
Die praktische Regel lautet Reihenfolge. Nutzen Sie zuerst spezialisierte Abruf- und Verifikationstools. Verwenden Sie ein allgemeines Modell danach und nur für Text, dessen Quellen bereits in einer Bibliothek vorliegen, die Sie öffnen können. Wenn ein Chatbot während einer Überarbeitung ein neues Zitat einführt, behandeln Sie dieses Zitat als nicht vertrauenswürdig, bis es dieselben TRACE-Prüfungen wie der Rest des Manuskripts bestanden hat.
Was sagen Spezialisten für Forschungsintegrität über AI-Zitate?
Spezialisten für Forschungsintegrität behandeln allgemeine Chatbots als Entwurfshilfen und spezialisierte, quellengebundene Systeme als die einzig akzeptable Schicht für Aussagen, die zitiert werden sollen. Der Konsens lautet nicht „AI vermeiden“. Er lautet: „Lassen Sie einen nicht quellenbasierten Generator nicht zur Aufzeichnung dessen werden, was die Literatur sagt.“
„Der Fehler, den wir immer wieder sehen, besteht nicht darin, dass Modelle schlecht schreiben. Sie erstellen vollständige Bibliografien für Studien, die nicht existieren, oder für reale Studien, die das behauptete Ergebnis nicht enthalten. Sobald diese Zeichenfolgen in einen Entwurf gelangen, verhalten sie sich wie Evidenz. Gutachter, Mitautoren und spätere Zitationstools können sie weiterverbreiten, bevor jemand die Quelle öffnet.“
„Ein spezialisierter Rechercheassistent verändert die Arbeitseinheit. Statt um einen Absatz mit Zitaten zu bitten, fragen Sie nach einer Aussage, einer Passage und einer Klassifizierung: gestützt, nicht gestützt, widerlegt oder unzureichend. Dieses Ergebnis ist langsamer und weniger elegant. Es ist aber auch das einzige Ergebnis, das ein Methodenabschnitt verteidigen kann.“
„Persistentes Projektgedächtnis ist wichtiger, als viele erwarten. Halluzinationen gelangen oft während der Überarbeitung erneut in eine Arbeit, wenn ein allgemeiner Chatbot gebeten wird, einem bereits sauberen Abschnitt ‚Quellen hinzuzufügen‘. Ein Assistent, der sich merkt, welche Studien ausgeschlossen wurden und warum, leistet Integritätsarbeit und nicht nur Komfortarbeit. Selbst dann bleibt das Original-PDF maßgeblich.“
— Jenova-Produktteam, akademische Forschungs-Workflows, mehrjährige Arbeit an quellenbasiertem Agenten-Design
Diese Position stimmt mit den Leitlinien von Bibliothekaren und zur Evidenzsynthese überein. King's College London rät, AI als Ergänzung einzusetzen, Urheberrechte vor dem Hochladen von Volltexten zu prüfen und davon auszugehen, dass generative Tools weiterhin Referenzen und Schlagwörter erfinden können. Analysen auf Verlagsebene behandeln halluzinierte Referenzen inzwischen als Korpusproblem und nicht als anekdotisches Problem. Ein Kommentar aus dem Jahr 2026, der mit einer Nature-Untersuchung von rund 4.000 Publikationen arbeitete, stellte fest, dass 65 der 100 verdächtigsten Arbeiten mindestens eine ungültige Referenz enthielten — ein Muster, das auf mehr als 110.000 betroffene Arbeiten unter rund 7 Millionen Publikationen im Jahr 2025 hindeuten könnte.
Die fachliche Konsequenz ist operativ. Wählen Sie Tools, die das Prüfen kostengünstig machen. Lehnen Sie Tools ab, die das Prüfen unnötig erscheinen lassen.
Referenzen
- Higher Education Policy Institute — Studierendenumfrage zu generativer AI 2025
- ERIC / U.S. Department of Education — Studierendenumfrage zu generativer AI 2025, HEPI Policy Note 61
- Boretti, Energy Research & Social Science — Halluzinationen in generativer AI und wissenschaftliche Integrität
- Wikipedia — Halluzination (künstliche Intelligenz)
- McGoogan Library des University of Nebraska Medical Center — AI-Halluzinationen mit Zitaten
- Science / AAAS — Warum AI-Modelle halluzinieren, statt Unsicherheit einzugestehen
- LlamaIndex — Quellenbasierte Extraktion
- King's College London Library Guide — AI-Tools in der Evidenzsynthese
- Elicit — AI für wissenschaftliche Forschung
- Scite — Zitationsgestützte Forschung und Smart Citations
- ResearchRabbit — Literaturkartierung und Zitationsnetzwerke
- newline — Benchmarks zur Prüfung wissenschaftlicher Referenzen aus LLMs
- Paperguide — Vergleich akademischer AI-Recherchetools, 2026
- arXiv — SemanticCite: Zitationsverifikation mit Volltextanalyse
- Nature Humanities and Social Sciences Communications — Klassifikation von AI-Halluzinationen