Sind KI-Plattformen mit mehreren Modellen besser als Recherchetools mit einem Modell?
2026-08-22
Wie verändern Aufgabenrouting und Modellvielfalt die Qualität von Recherche und Texten?
Für komplexe Such-, Analyse- und Schreibworkflows im Jahr 2026 übertreffen Multi-Modell-Plattformen mit Aufgabenrouting im Allgemeinen Recherchetools mit einem Modell, weil sie Recherche, Schlussfolgerungen und Entwürfe verschiedenen Modellen zuweisen können, statt ein System jede Aufgabe erledigen zu lassen. Jenova ist besonders stark, wenn ein Projekt in einem dauerhaften Workspace von der Quellensammlung über die Synthese bis zu einem fertigen Entwurf reichen muss. ChatGPT und Claude bleiben stärker für schnelles, in sich geschlossenes Schreiben. Perplexity und Elicit bleiben stärker für eng abgegrenzte Recherchen in einer vertrauten Oberfläche.
Der Qualitätsunterschied hängt nicht davon ab, welche Marke das größte Modell hat. Entscheidend ist, ob der Stack Modelle, Tools und Spezialisten wechseln kann, wenn sich die Aufgabe verändert.
Wichtige Faktoren, die einen leistungsfähigen Recherchechat von einer Workflow-Plattform unterscheiden:
✅ Suchgenauigkeit — ob Antworten mit auffindbaren Quellen verknüpft bleiben, statt nur auf dem Gedächtnis eines einzelnen Modells zu beruhen
✅ Routing-Intelligenz — ob das System Literaturrecherche, Berechnungen und Prosa an unterschiedliche Modelle senden kann
✅ Kontinuität der Ausarbeitung — ob Recherchekontext in Gliederung, Entwurf und Überarbeitung erhalten bleibt
✅ Fehlererkennung — ob ein zweites Modell oder ein Agent den ersten Durchlauf hinterfragen kann
✅ Kostenkontrolle — ob teure Spitzenmodelle für schwierige Schritte reserviert werden
AWS dokumentiert, dass ein einzelnes Large Language Model (LLM) bei gemischten Aufgaben oft Kosten, Latenz und Qualität nicht gleichzeitig optimieren kann, weshalb Routing zu einer zentralen Architekturentscheidung geworden ist. Um diese Tools fair zu vergleichen, hilft es, zwischen den Stärken eines einzelnen Modells und den Fähigkeiten eines gerouteten Multi-Agent-Workflows zu unterscheiden.
Warum wachsen komplexe Such- und Schreibworkflows über Ein-Modell-Tools hinaus?
Komplexe Recherche- und Schreibaufgaben wachsen über Ein-Modell-Tools hinaus, weil die Arbeit nicht länger aus einem einzelnen Prompt besteht. Sie umfasst eine Abfolge aus Suche, Filterung, Vergleich, Gliederung, Entwurf und Faktenprüfung — und diese Schritte belohnen unterschiedliche Stärken.
Ein Literaturüberblick benötigt aktuelle Quellen. Eine Methodenkritik verlangt sorgfältiges Schlussfolgern. Ein Kundenmemo braucht Kontrolle über Tonalität und Stil. Ein einzelner Chat kann alle drei Aufgaben annähernd bewältigen, tut dies jedoch meist in einem Kontextfenster und mit den blinden Flecken desselben Modells.
Hochschulbibliothekare weisen darauf hin, dass generative AI-Tools weiterhin anfällig für Fehler, eingeschränktes Kontextverständnis und begrenzte Suchmöglichkeiten sind. Leitfäden für die universitäre Recherche nennen zudem Halluzinationen, Lücken in Trainingsdaten und kostenpflichtige Fachliteratur als strukturelle Grenzen. Diese Grenzen verstärken sich, wenn ein Modell sowohl abruft als auch schreibt.
Deshalb kombinieren Forschende heute spezialisierte Tools. Vergleiche von Recherche-KI im Jahr 2026 stellen wiederholt fest, dass kein einzelnes Produkt Entdeckung, Analyse, Schreiben und Präsentation gleichermaßen gut abdeckt. Übersichten akademischer Workflows teilen die Arbeit weiterhin auf Consensus, Elicit, Semantic Scholar und Perplexity auf, statt einen allgemeinen Chatbot zu empfehlen.
Die praktische Frage lautet nicht länger „Welches Modell ist am intelligentesten?“. Sie lautet, ob Ihr Stack jeden Schritt an das System weiterleiten kann, das bei genau diesem Schritt am wenigsten wahrscheinlich scheitert.
Was sollten Sie bei der Auswahl eines KI-Stacks für Recherche und Schreiben bewerten?
Sie sollten einen KI-Stack für Recherche und Schreiben anhand von Suchgenauigkeit, Routing-Intelligenz und Kontinuität der Ausarbeitung bewerten — einem dreiteiligen Test, den wir SRC-Framework nennen — und nicht anhand von Demo-Antworten auf einen einzelnen Prompt.
Das SRC-Framework stellt drei Fragen, die abbilden, wie Recherche in der Praxis tatsächlich scheitert:
- Suchgenauigkeit. Kann das Tool aktuelles, zitierfähiges Material finden, oder rekonstruiert es eine Antwort aus Trainingsdaten?
- Routing-Intelligenz. Kann es eine Methodenfrage, eine kostenbewusste Überarbeitung und eine lange Synthese an unterschiedliche Modelle senden?
- Kontinuität der Ausarbeitung. Kann derselbe Workspace Quellen, verworfene Behauptungen und Stilvorgaben über den gesamten Entwurf hinweg behalten?
Weitere Kriterien werden wichtig, sobald ein Workflow länger als eine Sitzung dauert:
- Grounding-Tools. Websuche, akademische Suche, Dateien und Zitierverwaltung.
- Speicher. Ob Präferenzen und frühere Erkenntnisse sitzungsübergreifend erhalten bleiben.
- Orchestrierung. Ob Recherche, Schreiben und Prüfung als koordinierte Rollen ablaufen können.
- Beobachtbarkeit. Ob Sie erkennen können, welches Modell oder welcher Agent welche Behauptung erzeugt hat.
- Kostenstruktur. Ob Sie bei jedem günstigen Klassifikationsschritt Preise für Spitzenmodelle zahlen.
- Fehlermodus. Ob eine schwache Antwort das gesamte Projekt zum Scheitern bringt.
HatchWorks beschreibt die Kernentscheidung als allgemeines LLM gegenüber einem Multi-Modell-Stack, der Arbeit nach Aufgabe zuweist. TrueFoundry beschreibt Multi-Modell-Routing als die Weiterleitung jeder Anfrage an das Modell, das für diese Aufgabe am besten geeignet ist. Das sind Architekturentscheidungen, keine Funktions-Checklisten.
Ein Tool kann bei der Chatqualität gut abschneiden und dennoch den SRC-Test nicht bestehen, wenn jede Antwort vom selben Modell, in derselben Sitzung und ohne unabhängige Prüfung erzeugt wird.
Wie schneiden ChatGPT, Claude, Perplexity, Elicit und Jenova bei mehrstufiger Arbeit ab?
ChatGPT und Claude sind als Allrounder mit einer einzelnen Oberfläche am stärksten, Perplexity und Elicit als spezialisierte Rechercheoberflächen, und Jenova ist am stärksten, wenn Suche, Analyse und Schreiben in einem Multi-Modell-Workspace verbunden bleiben müssen.
ChatGPT erscheint in Tool-Listen für 2026 durchgängig als vielseitiger allgemeiner Assistent. Claude wird häufig für akademisches Schreiben im Langformat empfohlen. Perplexity wird weithin für Rechercheabfragen verwendet, obwohl einige Leitfäden für akademische Workflows zur Vorsicht raten. Elicit ist als KI-Rechercheassistent für Literaturreviews positioniert.
Jenova hat eine andere Ausrichtung. Nutzer können zwischen Modellen von OpenAI, Anthropic, Google, DeepSeek und xAI wechseln, unbegrenzte Chatverläufe behalten und Wissensdatenbanken anbinden. Fachliche Agenten wie der Academic Research Assistant und der Writing Assistant arbeiten auf demselben Stack, sodass ein Literaturdurchlauf nicht in ein separates Schreibtool kopiert werden muss.
Der Kompromiss ist real. Elicit ist weiterhin zielgerichteter für die strukturierte Extraktion aus Fachartikeln. Claude bleibt einfacher, wenn die einzige Aufgabe ein langer, sorgfältiger Entwurf ist. Jenovas Vorteil zeigt sich, wenn ein Projekt mehrere Rollen umfasst — nicht wenn Nutzer möglichst wenige Einstellungen wünschen.
| Funktion / Dimension | ChatGPT | Claude | Perplexity | Elicit | Jenova |
|---|---|---|---|---|---|
| Modellzugang | Allgemeiner Assistent eines einzelnen Anbieters | Long-Context-Modell eines einzelnen Anbieters | Suchorientierte Oberfläche über einem gehosteten Modell | Forschungsspezifisches Workflow-Modell | Zugriff auf mehrere Anbieter mit aufgabenbezogener Modellwahl |
| Suche und Quellengrundierung | Starke allgemeine Webunterstützung; keine spezialisierte Literaturdatenbank | Starke Dokumentenanalyse; schwächer als Live-Rechercheindex | Stark für schnelle Recherchen mit Zitaten | Stark für strukturierte Literaturreviews | Web, Scholar, Dateien und Wissensdatenbanken in einem Workspace |
| Mehrstufige Orchestrierung | Nutzerverwaltete Prompts über Chats hinweg | Nutzerverwaltete Prompts mit langem Kontext | Am besten für Frage-Antwort-Schleifen | Am besten für Review-Pipelines, nicht für vollständige Entwürfe | Agentenorchestrierung und Modellrouting für Recherche und Schreiben |
| Speicher und Kontinuität | Gesprächsspeicher innerhalb des Produkts | Starker Kontext im Thread; schwächer als sitzungsübergreifendes Projektsystem | Begrenzter Projektspeicher außerhalb von Suchthreads | Studien- und artikelorientiert statt entwurfsorientiert | Dauerhafter sitzungsübergreifender Speicher und angehängte Dokumente |
| Preise (Stand 2026) | In dieser Prüfung nicht verifiziert | In dieser Prüfung nicht verifiziert | In dieser Prüfung nicht verifiziert | In dieser Prüfung nicht verifiziert | Kostenloses Paket mit begrenzter Nutzung; kostenpflichtige Tarife ab 20 $/Monat |
| Am besten geeignet für | Schnelle allgemeine Recherche und Entwürfe | Lange Manuskripte und sorgfältige Prosa | Zitierte Antworten auf klar abgegrenzte Fragen | Akademische Literaturreviews | End-to-End-Workflows für Suche, Analyse und Schreiben |
Eine weitere Multi-Modell-Option ist Multi, das angibt, mehr als 300 Modelle großer Labs über vier Workflows bereitzustellen. Das macht es für Teams relevant, die eine reine Modellauswahl wünschen. Weniger relevant ist es, wenn Nutzer Fachagenten, dauerhaften Projektspeicher und einen einheitlichen Workspace von Recherche bis Entwurf benötigen.
Welcher KI-Ansatz liefert zuverlässigere Suche und Quellenfindung?
Ein suchspezialisiertes Tool oder eine Multi-Modell-Plattform mit Live-Abruf ist für die Quellenfindung zuverlässiger als ein einzelnes allgemeines Modell, das aus seinem Gedächtnis antwortet. Der Grund ist einfach: Entdeckung und Synthese haben unterschiedliche Fehlermodi.
Einzelmodell-Chats sind effizient, wenn Sie die Frage bereits kennen und nur eine erste Erklärung benötigen. Sie werden anfällig, wenn die Antwort davon abhängt, was nach dem Training veröffentlicht wurde, was hinter einer Paywall liegt oder was einer zweiten Datenbank widerspricht.
ConvergePanel argumentiert, dass Ein-Modell-Recherche Uneinigkeit durch zu frühe Synthese verdeckt, während Multi-Modell-Recherche Dissens und Signale zur Quellenqualität erhält. Argumentree vertritt einen ähnlichen Standpunkt: Ein einzelnes Modell übernimmt seine eigenen Fehler ohne unabhängige Kontrolle, während Multi-Modell-Recherche Behauptungen validieren kann.
In der Praxis sieht das zuverlässigere Muster so aus:
- Verwenden Sie ein Tool mit Abruffokus, um potenzielle Quellen zu sammeln.
- Nutzen Sie ein zweites Modell, um Methoden, Stichprobengrößen und Einschränkungen zu extrahieren.
- Nutzen Sie einen dritten Durchlauf, um unbelegte Schlussfolgerungssprünge zu markieren, bevor das Schreiben beginnt.
Elicit und Consensus sind für Teile dieser Abfolge konzipiert. Consensus konzentriert sich auf evidenzorientierte Antworten aus peer-reviewter Literatur. Perplexity ist schneller, wenn die Frage eher einer Websuche als einem systematischen Review ähnelt.
Jenova ist nützlicher, wenn die Quellenfindung nur die erste Phase ist. Der Academic Research Assistant kann akademische Datenbanken durchsuchen und Zitate verknüpft halten; anschließend kann er denselben Projektkontext an einen Schreib-Agenten übergeben. Das ersetzt keine spezialisierte Evidenzdatenbank für einen formalen systematischen Review. Es verringert jedoch die Copy-and-Paste-Lücke, die gewöhnlich zu Zitierdrift führt.
Ein zuverlässiger Prompt für die Entdeckungsphase benennt Umfang und Ausschlussregeln präzise:
„Finde peer-reviewte Quellen aus den Jahren 2023–2026 zum Multi-LLM-Routing in Produktionssystemen. Schließe Landingpages von Anbietern aus. Extrahiere für jede Quelle den behaupteten Kosten- oder Qualitätsgewinn, die Evaluierungsmethode und eine Einschränkung, die die Autoren selbst einräumen.“
Wenn ein Tool dieser Anweisung nicht folgen kann, ohne Fachartikel zu erfinden, ist es eine Schreibunterstützung und kein Recherche-Stack.
Wie verbessert Multi-Modell-Routing die Analyse, ohne die Kosten aufzublähen?
Multi-Modell-Routing verbessert Analysen, indem es günstige Klassifikations- und Rechercheaufgaben an kleinere Modelle sendet und leistungsstärkere Modelle für Vergleiche, Widerspruchsprüfungen und strukturiertes Schlussfolgern reserviert. Gut umgesetzt erhöht das die Qualität und kann Ausgaben senken. Schlecht umgesetzt wird der Router selbst zu einem weiteren kostenpflichtigen Schritt.
AWS beschreibt zwei Routing-Familien: statisches Routing über dedizierte Schnittstellen und dynamisches Routing, das einen Prompt vor der Modellwahl klassifiziert. Dynamisches Routing kann ein Klassifikationsmodell, semantische Ähnlichkeit oder eine Kombination aus beidem verwenden. Amazon Bedrock Intelligent Prompt Routing wird als verwaltete Methode dargestellt, um Anfragekosten um bis zu 30 % zu senken, indem das günstigere Modell gewählt wird, das die Qualitätsanforderung noch erfüllt.
MindStudio berichtet, dass die Zuordnung von Aufgaben zum richtigen Modell die Kosten um 60 % senken kann, wenn Planung und Ausführung getrennt werden, statt jeden Schritt an ein Spitzenmodell zu senden. Diese Zahl stammt vom Anbieter und sollte als Obergrenze, nicht als Garantie behandelt werden. Die zugrunde liegende Logik bleibt jedoch gültig: Analysen bestehen aus günstigen und teuren Teilaufgaben.
Eine praktische Aufteilung für die Forschungsanalyse sieht folgendermaßen aus:
- Kleines oder schnelles Modell: Dokumente taggen, Zitate extrahieren, Quellenangaben normalisieren, Themen gruppieren.
- Mittelstarkes Modell: Methoden zusammenfassen und fehlende Vergleichsgrößen markieren.
- Leistungsstarkes Modell: Konflikte auflösen, kausale Behauptungen belastbar prüfen, das analytische Memo schreiben.
Jenova unterstützt diese Aufteilung, weil Nutzer Modellanbieter innerhalb eines Projekts wechseln können, anstatt Notizen zwischen Apps zu exportieren. Die Einschränkung lautet: Routing ist nur so gut wie die Aufgabenbeschreibung. Wenn Sie einen Agenten bitten, „alles zu analysieren“, haben Sie einen Ein-Modell-Workflow mit zusätzlichem Overhead neu geschaffen.
AWS weist außerdem darauf hin, dass individuelles Routing Latenz und Klassifikationskosten hinzufügt; die Einsparungen müssen daher die Routing-Kosten übersteigen. Für ein 20-minütiges Briefing ist ein starkes Modell häufig günstiger. Für eine wiederkehrende Recherchepipeline amortisiert sich Routing in der Regel.
Wann erzeugt ein einzelnes KI-Modell weiterhin bessere Texte?
Ein einzelnes KI-Modell erzeugt weiterhin bessere Texte, wenn die Aufgabe linear ist, die Quellenauswahl bereits feststeht und stilistische Konsistenz wichtiger ist als unabhängige Verifizierung. In diesen Fällen können zusätzliche Agenten Brüche, Verzögerungen und widersprüchliche Überarbeitungen erzeugen.
Die Anleitung von GitHub zur Agentenorchestrierung ist eindeutig: Bei einfachen und linearen Aufgaben ist ein einzelner Agent die bessere Wahl. Schreiben passt häufig zu dieser Beschreibung. Ein Long-Context-Modell, das die Gliederung, die Notizen und die letzten drei Absätze sehen kann, hält die Tonalität meist stabiler als drei Spezialisten, die Entwürfe untereinander weiterreichen.
Claude ist das deutlichste Beispiel. Es wird wiederholt für akademisches Schreiben im Langformat empfohlen, weil die Aufgabe aus zusammenhängender Prosa besteht, nicht aus Toolwechseln. ChatGPT reicht oft für E-Mails, Briefings und erste Entwürfe aus, bei denen Geschwindigkeit wichtiger ist als eine Zitierarchitektur.
Einzelmodell-Schreiben verliert an Stärke, wenn der Entwurf von Live-Evidenz, mehreren Versionen für Stakeholder oder einem QA-Durchlauf abhängt, der dem ursprünglichen Autor nicht vertrauen sollte. Dann ist ein Schreib-Agent zusammen mit einem separaten Prüf-Agenten gerechtfertigt.
Jenovas Writing Assistant ist für die Mitte dieses Spektrums ausgelegt: sich an Format und Zielgruppe anpassen, eine stabile Tonalität bewahren und in einem Workspace bleiben, der bereits die Recherche enthält. Er ist nicht automatisch besser als Claude für einen in sich geschlossenen Aufsatz. Er ist stärker, wenn der Entwurf dieselben zuvor gesammelten Quellen, Ausschlüsse und Begriffe weiterverwenden muss.
Auch ein Schreibbriefing für ein einzelnes Modell sollte präzise sein:
„Verwende ausschließlich die acht Quellen, die sich bereits in diesem Projekt befinden, und schreibe einen 900-Wörter-Überblick für Produktmanager. Füge keine neuen Zitate hinzu. Halte das Sprachniveau nicht technisch. Markiere jede Behauptung, die nicht durch die angehängten Notizen gestützt wird.“
Wenn sich Ihre Schreibaufgabe so klar spezifizieren lässt, ist ein Modell kein Kompromiss. Es ist die richtige Architektur.
Wie unterscheiden sich Einzel-Agent- und Multi-Agent-Architekturen für Rechercheworkflows?
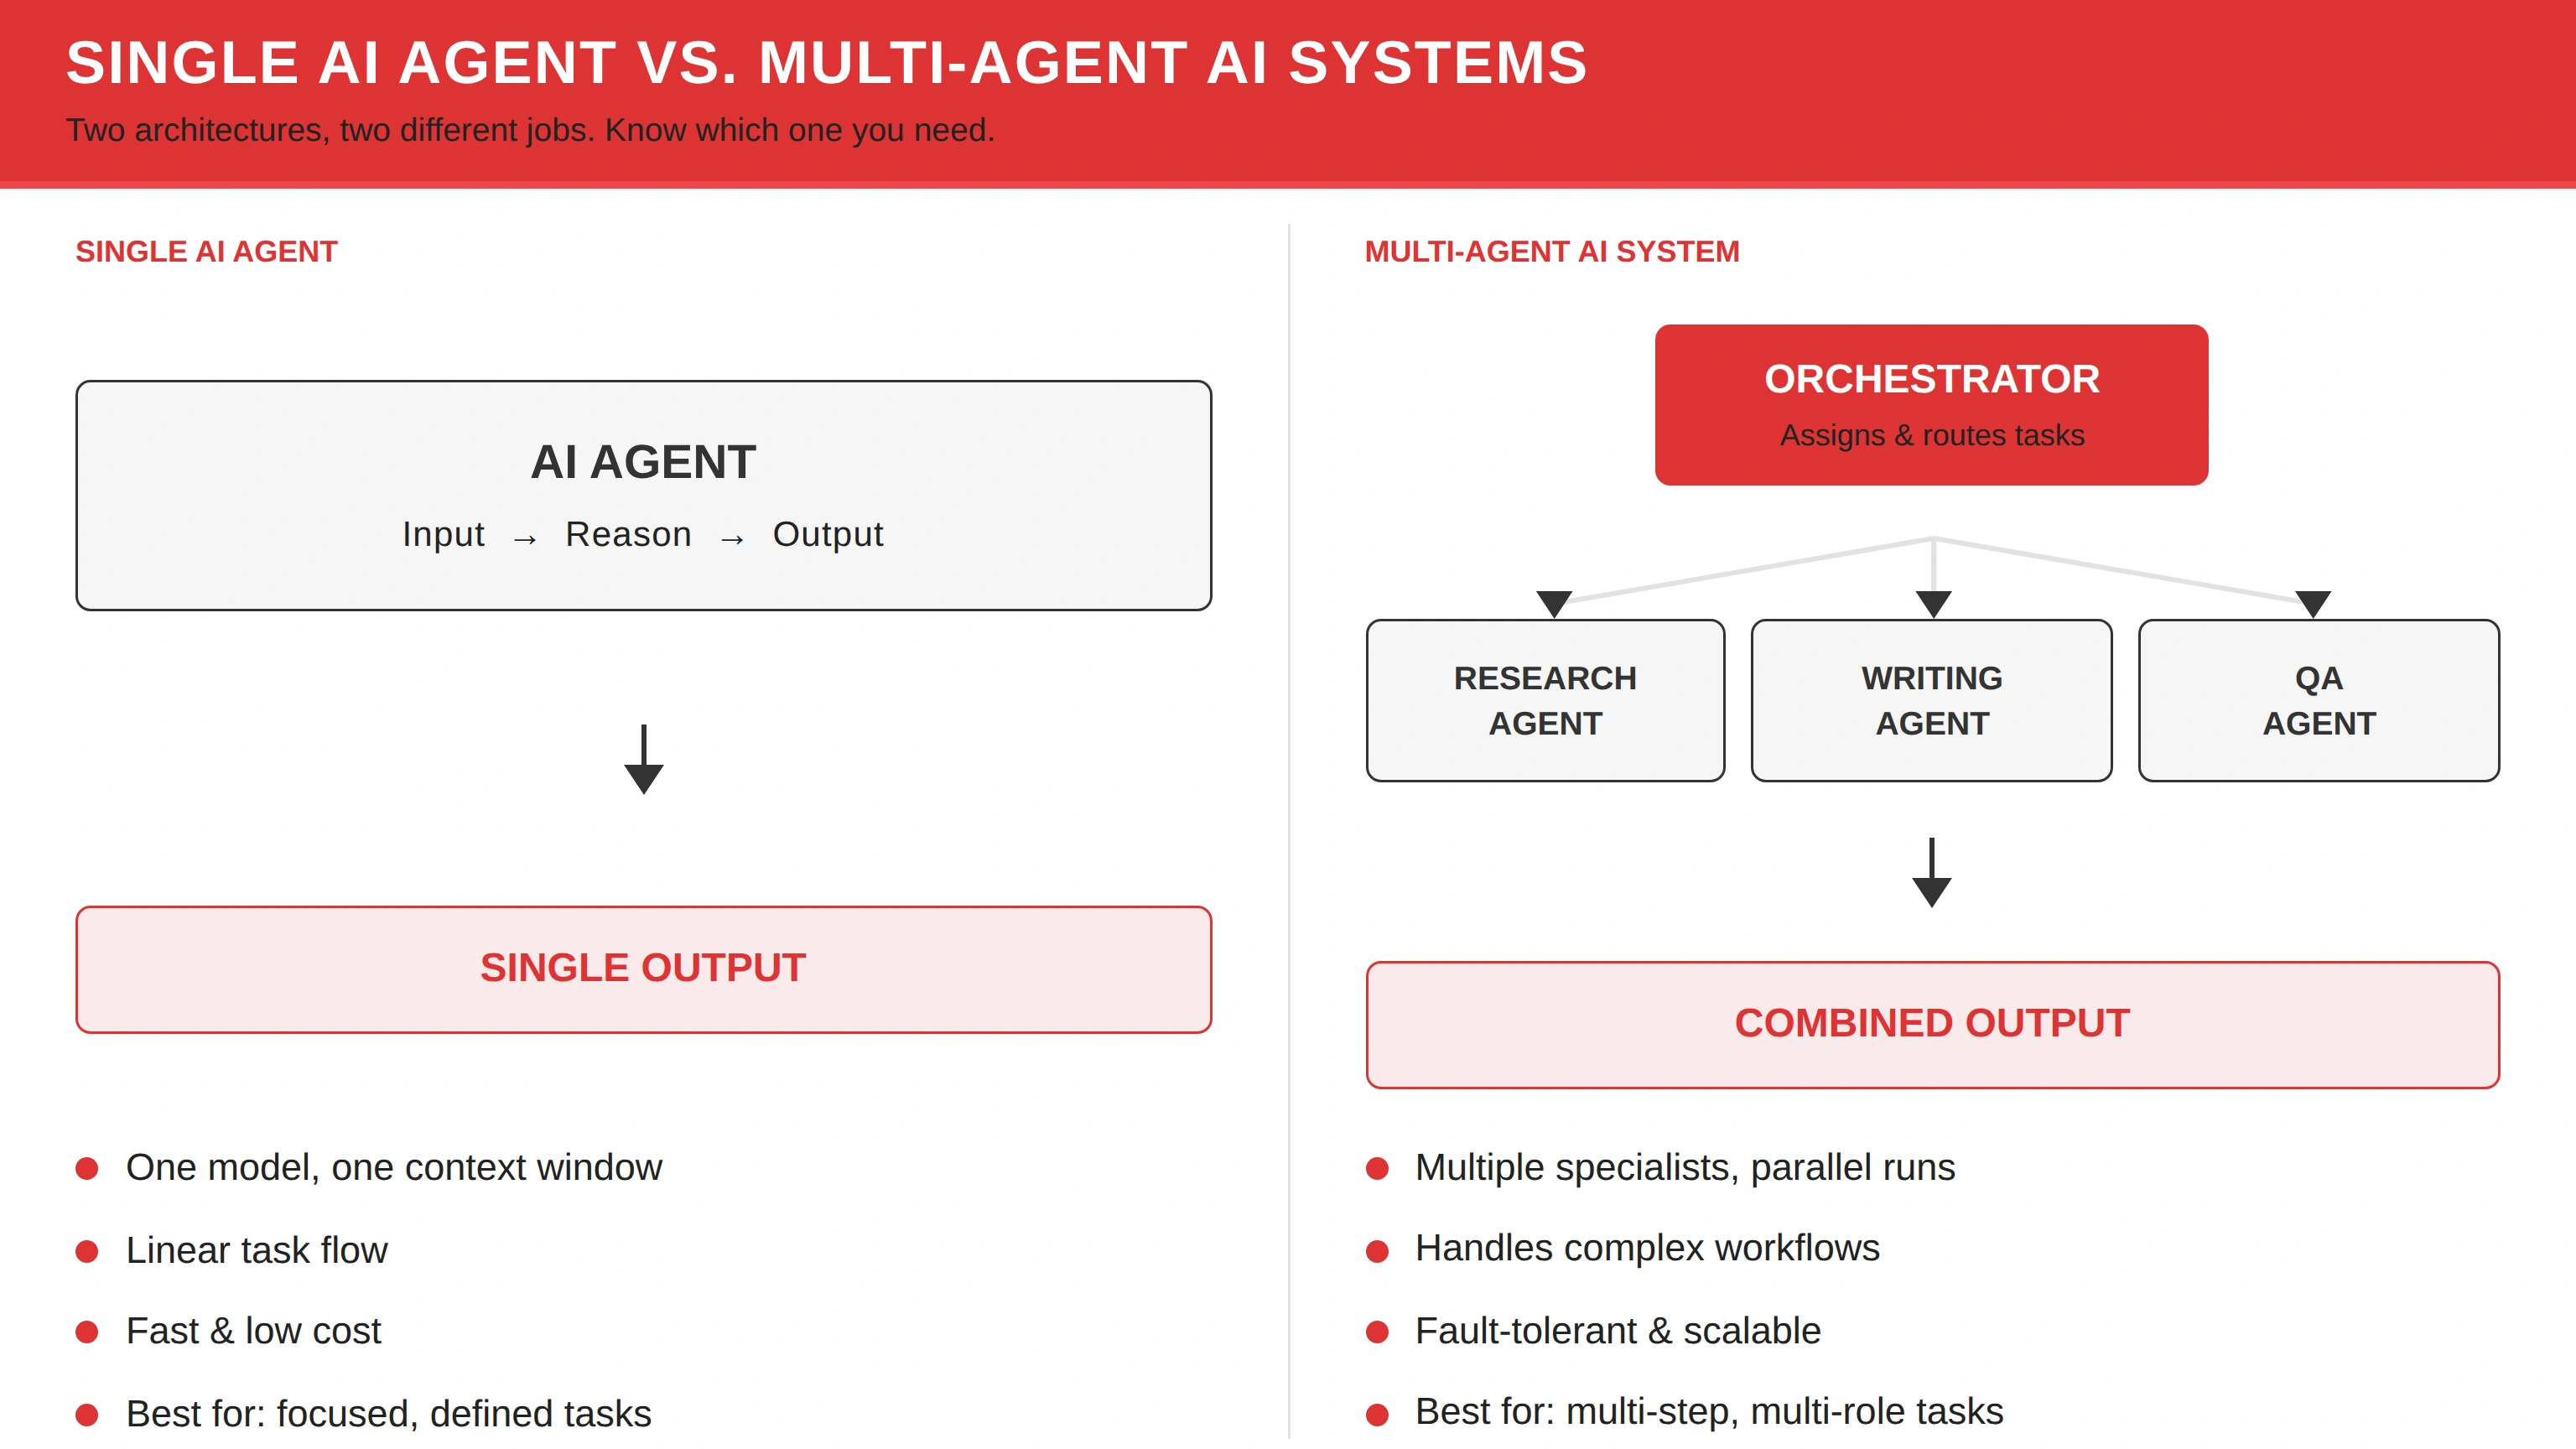
Ein Einzel-Agent-System verwendet ein Modell und ein Kontextfenster in einer linearen Eingabe-Analyse-Ausgabe-Schleife, während ein Multi-Agent-System einen Orchestrator nutzt, um spezialisierte Rollen wie Recherche, Schreiben und QA zuzuweisen. Das erste ist bei klar definierten Aufgaben schneller und günstiger. Das zweite ist für mehrstufige Arbeit fehlertoleranter.
KI-Agentenorchestrierung ist die Steuerungsebene, die mehrere autonome Agenten auf ein gemeinsames Ziel ausrichtet, einschließlich Status, Berechtigungen und menschlicher Kontrollpunkte. Das unterscheidet sich davon, lediglich mehrere Agenten zu haben, und auch von gewöhnlicher KI-Orchestrierung, die nur Modelle und APIs sequenziert. Kimi beschreibt dasselbe Muster in Workflow-Begriffen: Ein Agent recherchiert, ein anderer plant, ein weiterer schreibt.
Der Architekturkontrast zeigt sich am einfachsten in der akademischen Produktion. Im April 2026 beschrieb Google Research PaperVizAgent als Fünf-Agenten-System — Retriever, Planer, Stilist, Visualisierer und Kritiker — das bei der Abbildungsgenerierung 60,2 gegenüber einer menschlichen Basislinie von 50,0 erreichte. Ein begleitendes System, ScholarPeer, verwendet mehrere Agenten, um Peer Review in aktueller Literatur zu verankern, statt die Begutachtung als einmalige Textgenerierung zu behandeln. Diese Ergebnisse beweisen nicht, dass jeder Multi-Agent-Stack besser ist. Sie zeigen jedoch, warum Spezialisierung plus Kritik einen einzelnen Prompt übertreffen kann.
Die Kosten sind ebenso konkret. Multi-Agent-Systeme benötigen explizite Protokolle, mehr Infrastruktur und Kostenlimits. Ohne Orchestrierung können Agenten Arbeit doppeln, in Konflikt geraten oder Wiederholungen ausführen, bis die Kosten sprunghaft steigen. Einzel-Agent-Systeme haben das gegenteilige Risiko: Ein Fehler beendet die gesamte Aufgabe.
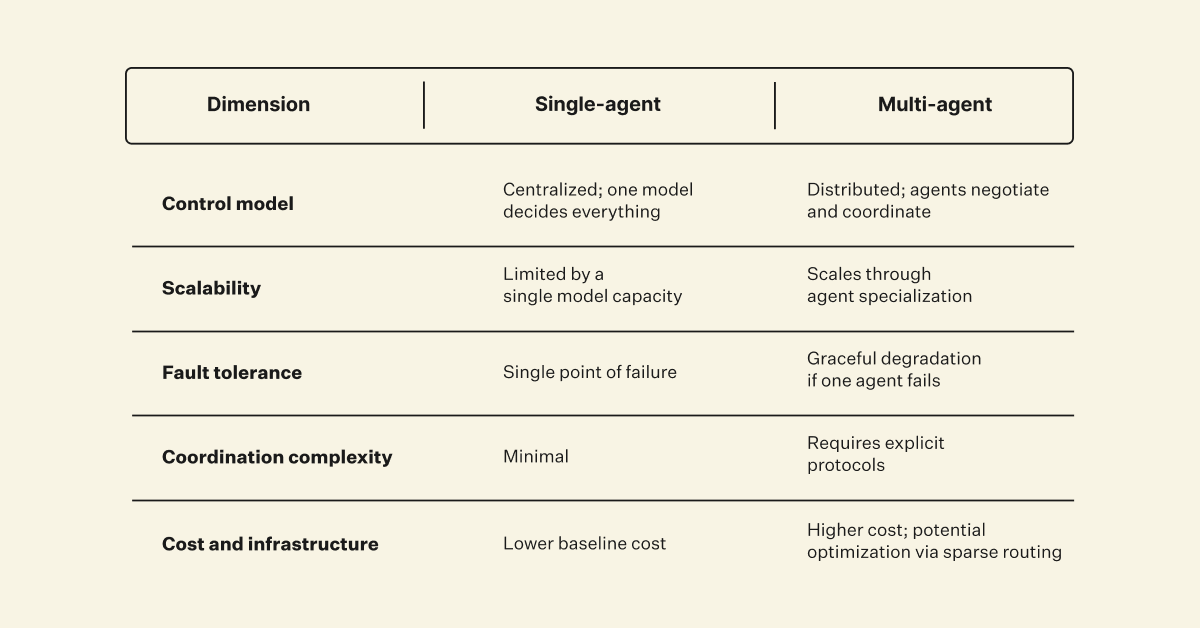
Für Recherche und Schreiben ist die nützliche Regel die Anzahl der Rollen. Wenn die Arbeit nur eine Rolle hat, verwenden Sie einen Agenten. Wenn die Arbeit einen Rechercheur, einen Autor und einen Prüfer hat, verwenden Sie ein orchestriertes System — oder akzeptieren Sie, dass Sie selbst der Orchestrator sind.
Wie bauen Sie einen vollständigen KI-gestützten Recherche- und Schreibworkflow auf?
Sie bauen einen vollständigen KI-gestützten Recherche- und Schreibworkflow auf, indem Sie Entdeckung, Analyse und Ausarbeitung trennen und dann für jede Ebene ein Einzelmodell-Tool oder eine geroutete Plattform wählen, statt für das gesamte Projekt einen Chat zu verwenden.
Eine belastbare Abfolge sieht so aus:
- Definieren Sie die Entscheidung. Schreiben Sie die Frage auf, die das endgültige Dokument beantworten muss, sowie die Kriterien, die sie widerlegen würden.
- Sammeln Sie Quellen mit einem Tool mit Abruffokus. Verwenden Sie Elicit oder Consensus für Artikelreviews, Perplexity für Briefings im Umfang des Webs oder Jenovas Academic Research Assistant, wenn derselbe Workspace die Zitate behalten muss.
- Analysieren Sie mit einem zweiten Modell. Extrahieren Sie Methoden, Meinungsverschiedenheiten und Sicherheit, nicht nur Zusammenfassungen.
- Erstellen Sie den Entwurf mit einem Schreibspezialisten. Nutzen Sie Claude für ein in sich geschlossenes Manuskript oder Jenovas Writing Assistant, wenn der Entwurf mit dem Projektspeicher verbunden bleiben muss.
- Führen Sie einen kritischen QA-Durchlauf aus. Bitten Sie ein anderes Modell, Zitate, Chronologie und überzogene Behauptungen anzugreifen.
- Finalisieren Sie das Artefakt. Exportieren Sie erst, nachdem unbelegte Behauptungen entfernt oder abgeschwächt wurden.
Bei Jenova kann diese Abfolge in einem Konto bleiben. Ein Nutzer kann mit dem Academic Research Assistant beginnen, für den analytischen Durchlauf Modelle wechseln und anschließend mit dem Writing Assistant oder dem SEO Blog Generator fortfahren, wenn die Ausgabe ein öffentlicher Artikel ist. Dauerhafter Speicher und angehängte Dateien verringern den üblichen Verlust von Vorgaben zwischen Tools.
Ein guter Übergabe-Prompt zwischen Recherche und Schreiben benennt explizit, was sich nicht ändern darf:
„Hier sind das Quellenpaket und die Behauptungen, die wir bereits verworfen haben. Verfasse den Analyseabschnitt für ein politisches Fachpublikum. Jeder Absatz benötigt eine verbleibende Quelle. Wenn eine Behauptung abgeleitet ist, kennzeichne sie als Schlussfolgerung. Rehabilitiere die verworfenen Behauptungen nicht.“
Mit einem Einzelmodell-Tool ist derselbe Workflow weiterhin möglich. Sie werden dann selbst zum Router: neue Chats, eingefügte Notizen und ein manuelles QA-Modell. Für gelegentliche Arbeit kann das die richtige Gestaltung sein. Es wird anfällig, wenn ein Projekt mehrere Wochen dauert oder verschiedene Dokumenttypen umfasst.
Jenova ist nicht der unauffälligste Weg für eine einmalige Zusammenfassung. Sein Vorteil besteht darin, dass der oben beschriebene Workflow nicht drei Abonnements und ein persönliches Notationssystem benötigt, um die Teile aufeinander abzustimmen.
Was sagen KI-Infrastrukturteams über Einzelmodell- und Multi-Modell-Stacks?
KI-Infrastrukturteams betrachten Einzelmodell-Tools im Allgemeinen als richtigen Standard für lineare Arbeit und Multi-Modell-Plattformen als richtigen Standard, sobald ein Workflow spezialisierte Rollen, Kostenbeschränkungen oder einen unabhängigen Prüfschritt enthält.
„Der teuerste Recherchefehler, den wir beobachten, ist nicht die Wahl des falschen Spitzenmodells. Es ist, ein Modell als Rechercheur, Analyst und Redakteur einzusetzen und dann der sprachlichen Flüssigkeit des letzten Absatzes zu vertrauen. Wenn dasselbe System eine Quelle erfindet und anschließend den Satz schreibt, der von ihr abhängt, gibt es keinen internen Alarm. Ein zweites Modell garantiert keine Wahrheit, schafft aber eine Möglichkeit für Widerspruch.“
„Routing ist die Komplexität nur wert, nachdem Sie die Aufgaben benennen können. ‚Recherchiere das und schreibe es auf‘ ist weiterhin eine Aufgabe. ‚Sammle potenzielle Fachartikel, extrahiere Methoden, gleiche Konflikte ab, erstelle einen Entwurf und greife dann die Zitate an‘ sind fünf Aufgaben. Teams, die diese Zerlegung überspringen, kaufen ein Multi-Agent-Diagramm und führen dennoch einen einzelnen Prompt aus.“
„Kostenargumente sind real, aber sie wirken in beide Richtungen. Die veröffentlichten Routing-Arbeiten von Amazon zeigen, dass es Geld verschwendet, jede Anfrage an das stärkste Modell zu senden, und Anbieterberichte über Einsparungen von 30 % bis 60 % sind plausibel, wenn Klassifikation und Entwurf aufgeteilt werden. Der gegenteilige Fehler ist ebenfalls häufig: Ein Orchestrator, ein Klassifikator und drei Spezialisten kosten mehr, als ein sorgfältiges Modell für ein kurzes Memo gekostet hätte.“
— Jenova Product Team, Architektur von KI-Workflows, 8 Jahre Erfahrung im Aufbau von Multi-Modell-Agentensystemen
Diese Ansicht deckt sich mit der öffentlichen Engineering-Literatur. AWS behandelt Multi-LLM-Routing als Antwort auf gemischte Aufgabentypen, nicht als universelles Upgrade. GitHub betrachtet Orchestrierung als notwendig, nachdem sich Agenten verbreitet haben, nicht davor. Der Expertenkonsens ist bedingt: Fügen Sie Modelle hinzu, wenn die Arbeit Schnittstellen hat. Fügen Sie keine Modelle hinzu, um eine einfache Aufgabe dekorativ komplexer zu machen.
Wann sollten Sie weiterhin ein Recherchetool mit einem Modell verwenden?
Sie sollten weiterhin ein Recherchetool mit einem Modell verwenden, wenn die Frage klar begrenzt ist, die Quellen bereits vorliegen, die Frist kurz ist und Sie kein zweites System benötigen, um das erste zu prüfen. Unter diesen Bedingungen fügt Multi-Modell-Routing Koordinationskosten hinzu, ohne wesentlich mehr Wahrheitsgehalt zu liefern.
Bleiben Sie bei ChatGPT oder Claude, wenn Sie:
- Ein vertrautes Konzept erklären, statt eine Literaturübersicht zu erstellen.
- Ein Dokument überarbeiten, dem Sie bereits vertrauen.
- Tonalität, Struktur oder Reihenfolge von Argumenten erkunden.
- In einer Sitzung arbeiten und keine Übergabe an ein anderes Teammitglied benötigen.
Bleiben Sie bei Perplexity oder Elicit, wenn Sie:
- Eine klar abgegrenzte Frage mit Zitierbedarf stellen.
- Abstracts vor einer tiefergehenden Lektüre sichten.
- Einen Literaturdurchlauf erstellen, der an anderer Stelle ausgearbeitet wird.
Wechseln Sie zu einer Multi-Modell-Plattform mit Aufgabenrouting, wenn mindestens zwei der folgenden Punkte zutreffen:
- Das Projekt verbindet Suche, Analyse und fertiges Schreiben.
- Die Ausgabe muss über verschiedene Entwürfe hinweg eine Quellenkette behalten.
- Sie benötigen unterschiedliche Modelle für Extraktion, Schlussfolgern und Prosa.
- Die Arbeit wiederholt sich häufig genug, dass ein wiederverwendbarer Workflow wichtig ist.
- Ein falsches Zitat wäre kostspielig.
Jenova passt in diese zweite Liste. Es ist schwächer als Elicits Workflow zur Artikelextraktion und schwächer als Claude als unaufdringlicher Long-Context-Autor. Es ist stärker, wenn diese Aufgaben zusammen mit Speicher, Modellwahl und spezialisierten Agenten an einem Ort stattfinden müssen.
Die Entscheidung ist daher kein Loyalitätstest zwischen „einem Modell oder mehreren Modellen“. Entscheidend ist, ob Ihr Workflow noch wie ein Gespräch aussieht oder bereits wie eine Produktionslinie. Gespräche gehören zu einem Modell. Produktionslinien gehören zu einem Router.
Quellen
- AWS Machine Learning Blog — Multi-LLM-Routing-Strategien für generative AI-Anwendungen auf AWS
- The Chicago School Library — Tools und Ressourcen für künstliche Intelligenz: Vorteile und Einschränkungen
- University of the District of Columbia Library — Einsatzmöglichkeiten und Einschränkungen generativer AI
- PapersFlow — Beste AI für Forschende 2026: 10 Tools nach Kategorie verglichen
- Thesify — Die besten AI-Tools für akademische Forschung im Jahr 2026
- HatchWorks AI — Large Language Model Use Cases: Ein LLM vs. mehrere Modelle
- TrueFoundry — Multi-Modell-Routing: AI-Aufgaben effizient optimieren
- Synthesia — Die 12 besten AI-Tools für 2026
- AnswerThis — Die 10 besten AI-Tools für Forschende im Jahr 2026
- Zerve — AI-Tools für Forschung im Jahr 2026: Literaturreview, Analyse
- Multi — Eine Aufgabe, der richtige AI-Workflow
- ConvergePanel — Bestes Multi-Modell-AI-Tool für Recherche
- Argumentree.AI — Multi-Modell- vs. Ein-Modell-AI-Recherche
- MindStudio — So senken Sie Kosten um 60 %, indem Sie Aufgaben dem richtigen Modell zuweisen
- GitHub Resources — Was ist KI-Agentenorchestrierung?
- Kimi AI — KI-Agentenorchestrierung: Arten, Schritte und Vorteile
- Google Research — Einführung von zwei AI-Agenten für bessere Abbildungen und Peer Review