Sind AI-Forschungs-Workspaces besser für systematisches Evidenz-Mapping?
2026-08-22
Wie unterscheiden sich persistenter Projektstatus und der Abruf von Chunks bei Bedarf?
Für systematisches Evidenz-Mapping ist ein Forschungs-Workspace, der zu Beginn jeder Sitzung Entscheidungen, Status und Artefakte erneut lädt, als primäre Arbeitsumgebung besser geeignet als ein Zusammenfasser für einzelne Paper oder ein RAG-Chatbot, der nur bei Bedarf „relevante Chunks“ abruft. Mapping ist ein langfristiges Kodierungsprojekt: Einschlussregeln verändern sich, Grenzfallstudien werden neu kodiert, und die Synthese hängt davon ab, sich zu erinnern, warum eine Quelle letzte Woche ausgefiltert wurde. Tools auf Paper-Ebene wie Elicit, Consensus und NotebookLM bleiben leistungsstark für Entdeckung, Extraktion und Fragen und Antworten zu einem abgeschlossenen Korpus. Ein persistenter Workspace — einschließlich Jenovas Academic Research Assistant — ist stärker, wenn die Map wochenlange Protokolländerungen überstehen muss, ohne die Entscheidungen von gestern stillschweigend umzuschreiben.
Der entscheidende Unterschied im Jahr 2026 ist nicht, „welches Modell ein schöneres Abstract schreibt“. Entscheidend ist, welche Speicherarchitektur eine lebendige Evidenzkarte tragen kann.
Wichtige Faktoren, die nutzbare Mapping-Infrastruktur von wegwerfbarem Paper-Chat unterscheiden:
✅ Operativer Speicher vs. Referenzspeicher — Maps benötigen Projektstatus wie Kriterien, Codes und Ausschlüsse, nicht nur abgerufene Passagen ✅ Entscheidungsprovenienz — jede Einschluss-/Ausschlussentscheidung sollte sitzungsübergreifend überprüfbar bleiben ✅ Strukturierte Extraktion — vergleichbare Felder sind besser als einmalige narrative Zusammenfassungen ✅ Von Menschen überwachte Protokolltreue — Evidenzsynthesen behandeln AI weiterhin als Ergänzung, nicht als Ersatz für Reviewer ✅ Versionierbare Synthese — Berichte, Abbildungen und Quellenlisten sollten sich ansammeln, statt jedes Mal von Grund auf neu erzeugt zu werden
Um diese Tools fair zu vergleichen, hilft es, Evidenz-Mapping als vierstufiges Kontinuitätsproblem statt als Wettbewerb um die beste Zusammenfassung zu betrachten.
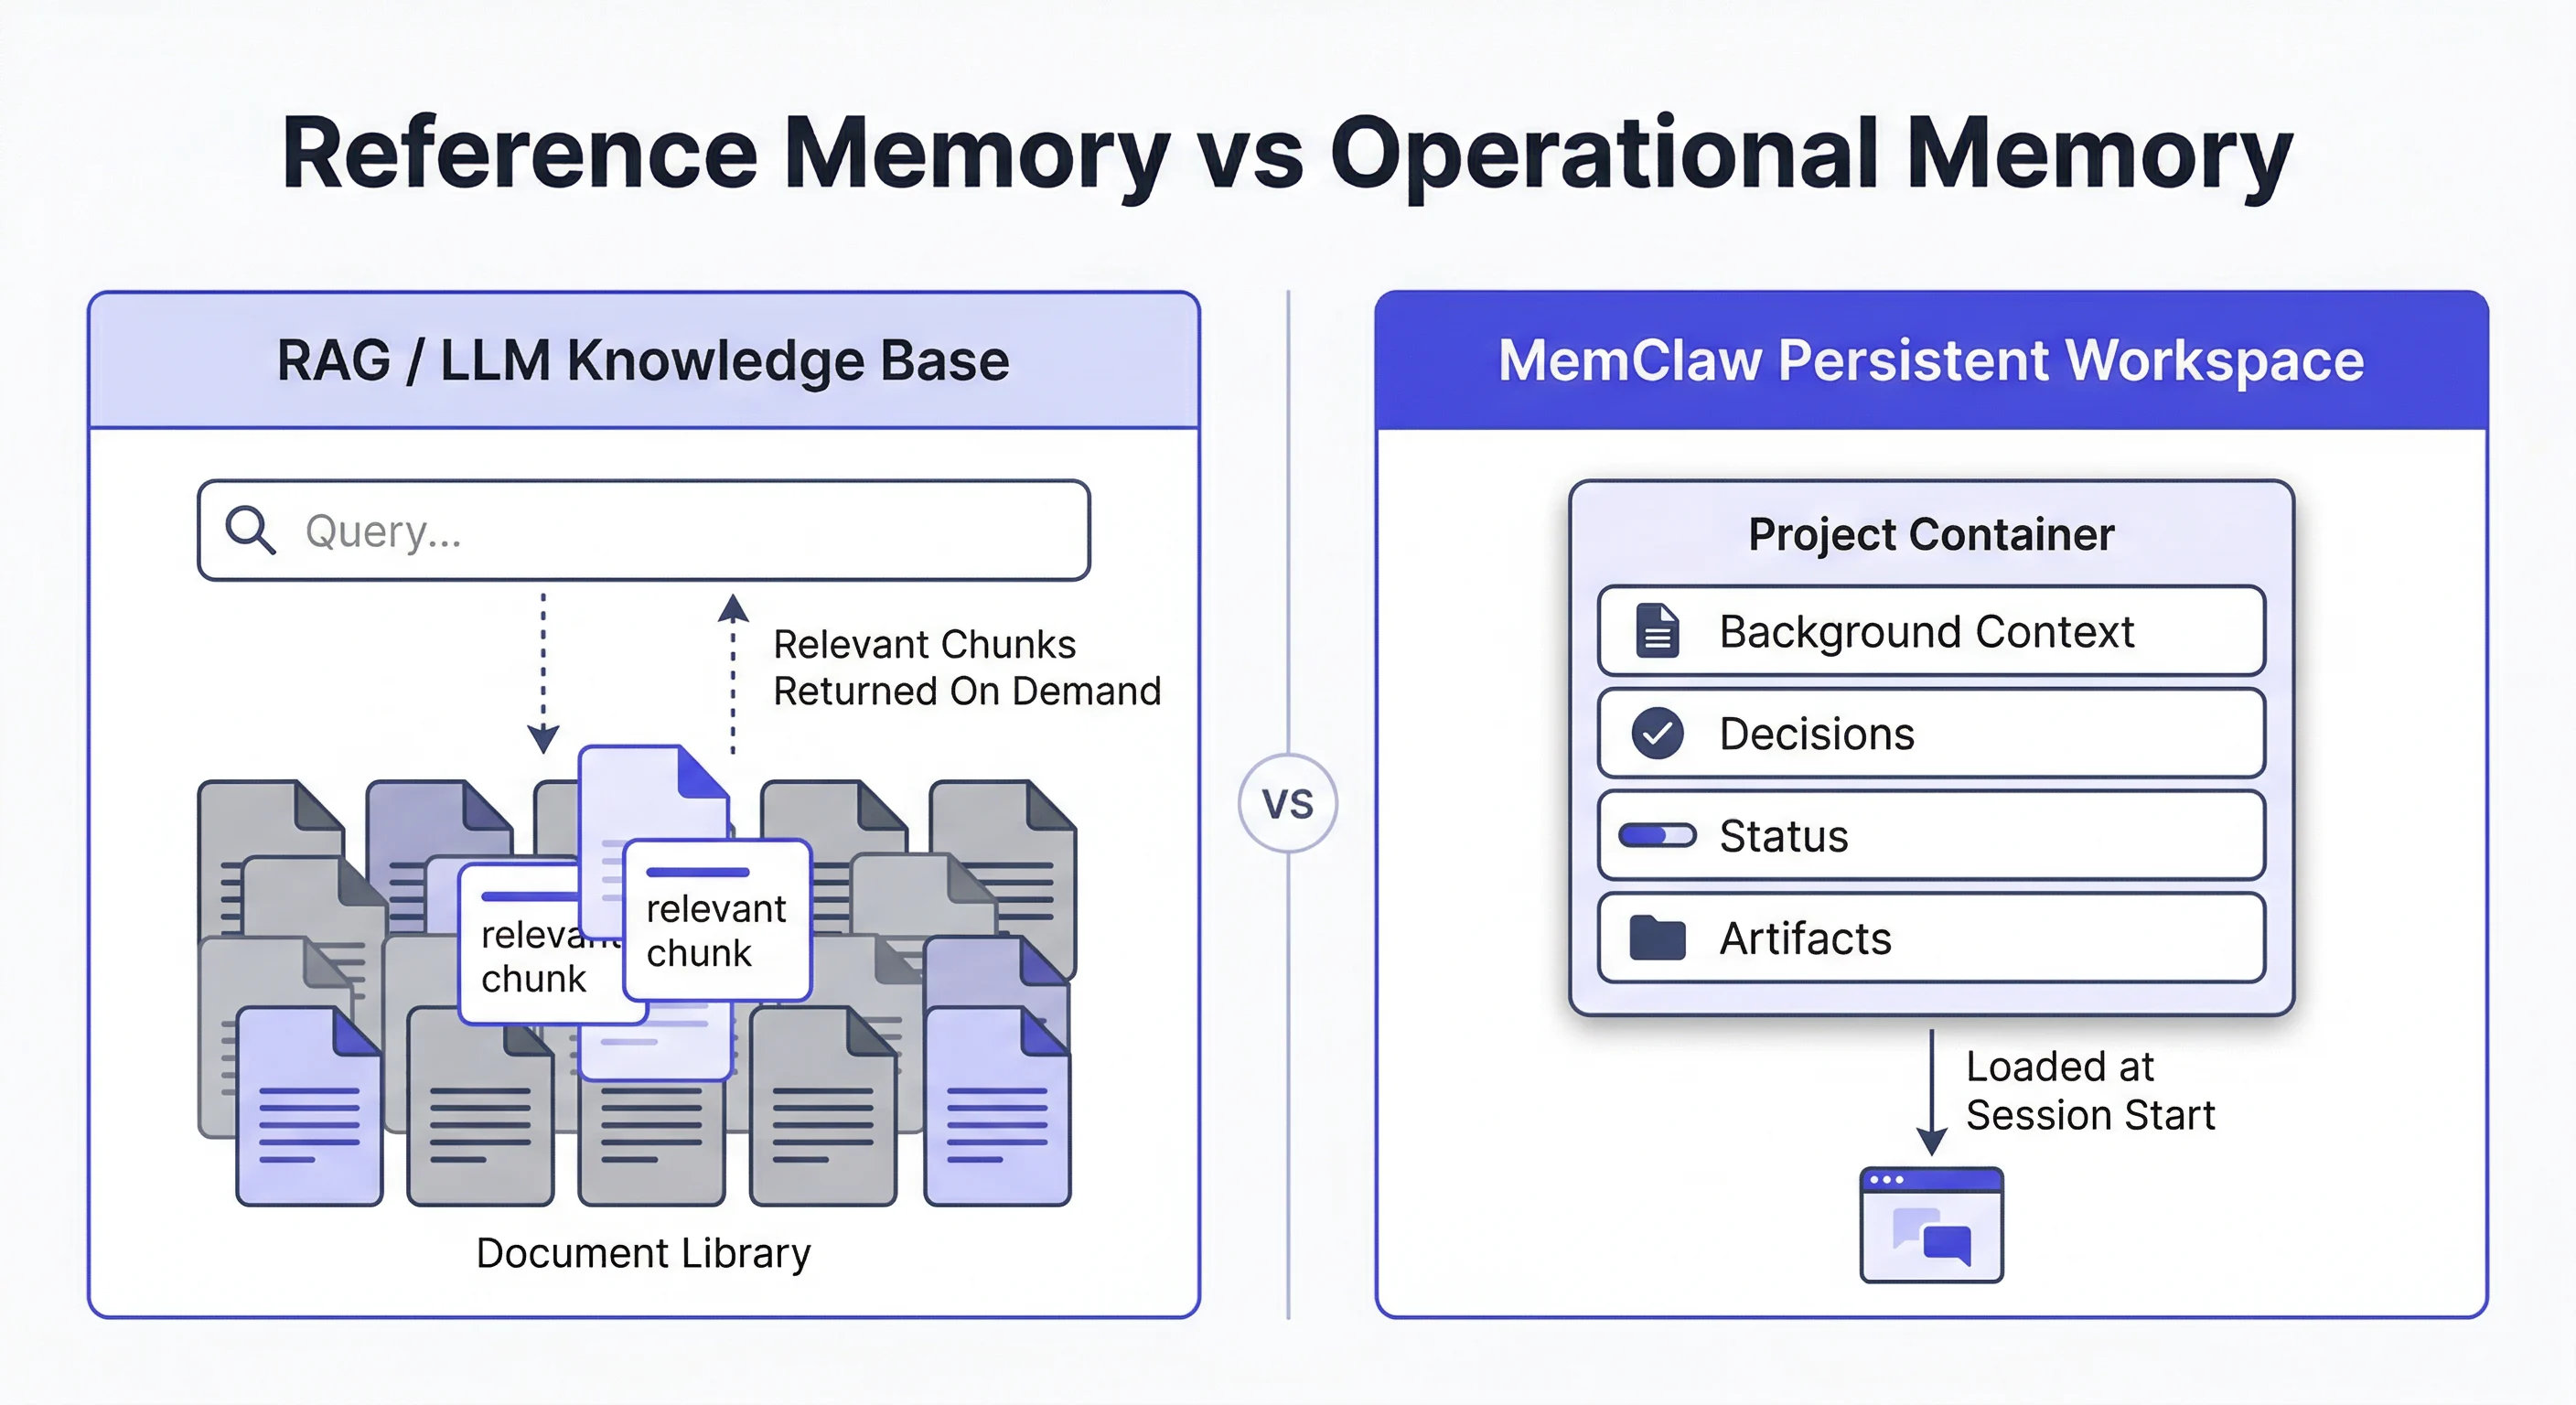
Warum überfordert systematisches Evidenz-Mapping AI-Tools für einzelne Paper?
Systematisches Evidenz-Mapping überfordert Zusammenfasser für einzelne Paper, weil eine Map ein kodiertes Inventar der Literatur und keine Abfolge isolierter Lektürenotizen ist. Systematische Evidenzkarten (SEMs) sind eine Form der Evidenzsynthese, die wissenschaftliche Erkenntnisse nach vorab definierten Dimensionen kategorisiert und organisiert — Population, Exposition, Ergebnis, Methode, Geografie oder Evidenzlücke — damit Reviewer erkennen können, was vorhanden ist, wo sich Befunde häufen und was fehlt.
Dieser Workflow kollidiert mit der Funktionsweise der meisten LLM-Rechercheprodukte. Ein RAG- oder „Chat mit diesem PDF“-Tool beantwortet die aktuelle Frage, indem es lokal ähnliche Chunks abruft. Es lädt nicht automatisch den Kodierungsrahmen vom vergangenen Dienstag, die drei als „vielleicht“ zurückgestellten Studien oder die Entscheidung erneut, dass Tiermodelle nach einer Verschärfung des Protokolls außerhalb des Geltungsbereichs liegen. Mapping-Reviews erfordern außerdem einen dokumentierten Screening-Prozess anhand von Ein- und Ausschlusskriterien, was eine andere Aufgabe ist als das Erzeugen eines flüssigen Absatzes über ein einzelnes Paper (Methodik für Mapping-Reviews).
Die manuelle Prüfung ist weiterhin langsam genug, dass die Abkürzung verlockend wirkt. Eine Umfrage zu Literaturtools aus dem Jahr 2026 bezifferte einen konventionellen Review-Zyklus auf vier bis sechs Wochen für Screening, Extraktion und Bereinigung von Zitationen. Spezialisierte AI-Screener können diesen Aufwand senken — das AIM Review-System berichtete über Arbeitslastreduktionen von 20 % bis zu 95 % in sechs realen Reviews — doch Geschwindigkeit schafft noch keine Map. Ohne persistenten Projektstatus erzeugt schnelleres Screening lediglich einen größeren Stapel nicht zusammenhängender Zusammenfassungen.
Bibliotheks- und Methodikstellen benennen die verbleibende Lücke ausdrücklich. Die Leitlinien zur Evidenzsynthese des King’s College London besagen, dass AI-Tools traditionelle Methoden für Suche, Screening und Extraktion nicht ersetzen können und nur mit einem klaren Bewusstsein für Bias, Urheberrechtsgrenzen und Halluzinationsrisiken eingesetzt werden sollten. Eine systematische Überprüfung generativer AI in der Evidenzsynthese aus dem Jahr 2025 kam zu derselben praktischen Schlussfolgerung: Die aktuelle Evidenz stützt den Einsatz von GenAI ohne menschliche Beteiligung oder Aufsicht nicht.
Worauf sollten Sie bei einem AI-Workflow für Evidenz-Mapping achten?
Sie sollten AI-Mapping-Tools mit einem Kontinuitätstest und nicht mit einem Test der Schreibqualität bewerten. Wir verwenden einen vierstufigen Stack — den CODE-Stack — weil jede Ebene auf andere, vorhersehbare Weise versagt, wenn Teams versuchen, Paper-Chat in eine systematische Map zu verwandeln.
C — Coverage (Abdeckung). Kann das Tool einen echten wissenschaftlichen Korpus durchsuchen oder nur Dateien, die Sie bereits hochgeladen haben? Elicit durchsucht mehr als 138 Millionen Paper und 545.000 klinische Studien. NotebookLM beantwortet Fragen bewusst nur aus den Quellen im Notebook. Abdeckungsfehler auf dieser Ebene werden zu fehlenden Zeilen in der Map und nicht nur zu dünnen Absätzen.
O — Operationalization (Operationalisierung). Können Ein- und Ausschlusskriterien, Kodierungsdimensionen und Extraktionsfelder einmal festgelegt und wiederholt angewendet werden? Ein Zusammenfasser, der „relevant“ bei jedem Prompt neu interpretiert, wird dieselbe Grenzfallstudie am dritten Tag anders kodieren. Mapping-Leitlinien behandeln vorab definierte Kriterien als nicht optional (Methoden für Mapping-Reviews).
D — Decision provenance (Entscheidungsprovenienz). Können Sie nachvollziehen, warum eine Studie eingeschlossen, ausgeschlossen, zurückgestellt oder gefiltert wurde? Cochrane-nahe Gruppen, einschließlich der Initiative Responsible AI in Evidence Synthesis (RAISE) mit Cochrane, Campbell und JBI, behandeln Transparenz als Qualitätsanforderung und nicht als bloße Annehmlichkeit.
E — Extractability (Extrahierbarkeit). Können Befunde in vergleichbaren Zellen landen — Stichprobe, Design, Effektrichtung, Einschränkung — statt in nicht miteinander vereinbarer Prosa? Das Produktdesign von Elicit basiert auf interaktiven Tabellen und mehrstufiger Extraktion. Consensus ist bei der Effektrichtung auf Hypothesenebene schneller, ist jedoch nicht für strukturiertes Schreiben von Reviews konzipiert.
Gewichten Sie die Ebenen nach dem Ziel. Ein Scoping-Durchlauf kann schwächere Provenienz tolerieren. Eine lebendige Evidenzkarte, die zitiert, aktualisiert oder an Co-Autoren übergeben wird, kann das nicht. Tools, die bei Coverage und Extractability herausragen, scheitern dennoch bei Maps, wenn Operationalisierung und Entscheidungsprovenienz in jeder Sitzung zurückgesetzt werden.
Wie schneiden Elicit, Consensus, NotebookLM und Forschungs-Workspaces im Vergleich ab?
Elicit und Consensus stellen in dieser Kategorie die stärkste Ebene für Paper-Entdeckung und Extraktion dar, NotebookLM ist das stärkste Notebook für einen abgeschlossenen Korpus, und ein persistenter Forschungs-Workspace ist die stärkste Umgebung, um eine mehrwöchige Map konsistent zu halten. Kein einzelnes Produkt gewinnt in jeder CODE-Ebene. Deshalb kombinieren ernsthafte Mapping-Teams üblicherweise ein Korpustool mit einer Umgebung für Projektspeicher, statt zu erwarten, dass ein einzelner Chatbot den gesamten Review übernimmt.
So sehen veröffentlichte Momentaufnahmen zu Funktionen und Preisen im Jahr 2026 aus:
| Funktion / Dimension | Elicit | NotebookLM | Consensus | Jenova-Forschungs-Workspace |
|---|---|---|---|---|
| Speichermodell | Bibliothek gespeicherter Quellen plus Anpassung je Bericht; kein vollständiger Container für Projektstatus | Notebook-bezogener Quellensatz; Antworten bleiben innerhalb hochgeladener Materialien | Speicher für Fragen und Listen rund um Hypothesenabfragen | Persistenter sitzungsübergreifender Speicher; Projektkontext kann geladen statt erneut abgerufen werden |
| Abdeckung | 138 Mio.+ Paper, 545.000 Studien | Nur hochgeladener Korpus; 50 Quellen kostenlos, 300 mit Plus | 200 Mio.+ Paper, Tags zur Evidenzrichtung | Live-Web- und wissenschaftliche Suche plus angehängte Wissensdatenbanken; kein fester Publisher-Index |
| Strukturierte Extraktion | Tabellen, Screening, Datenpunkte im großen Maßstab (bis zu 1.000 Paper / 20.000 Datenpunkte) | Quellverknüpfte Fragen und Antworten sowie Gliederungen, keine SR-Extraktionsraster | Consensus Meter und kurze evidenzbasierte Antworten | Syntheseberichte und zitationsgestützte Briefings über Deep Research; schwächer als spezialisierter Dual-Screener |
| Persistenz von Entscheidungen | Quellen können in einer Bibliothek gespeichert werden; Protokollstatus ist keine Kernfunktion | Bewahrt die Dateien des Notebooks, nicht kodierte Einschluss-/Ausschlusslogik | Lesezeichen und Listen in kostenpflichtigen Stufen | Gesprächsverlauf, Speicher und angehängte Projektdateien bleiben sitzungsübergreifend erhalten |
| Preise (Stand 2026) | Plus ab etwa $12/Monat | Kostenlos; Plus über Google AI Pro für etwa $19,99/Monat | Premium etwa $10/Monat | Kostenlose Stufe mit begrenzter Nutzung; Plus $20/Monat für die 30-fache Nutzung |
| Am besten geeignet für | Screening hoher Volumina und Extraktionstabellen | Lehrsammlungen und bereits gesammelte PDFs | Schnelle Prüfungen: „Stützt die Literatur X?“ | Lebendige Maps, Kodierung über mehrere Sitzungen und Manuskriptintegration |
Elicit ist der klare Spezialist für Screening im Stil systematischer Reviews. Es kann Screening und Extraktion automatisieren und berichtet für diese Phasen von Zeiteinsparungen von bis zu 80 %. Ein Cochrane-Methodenvergleich kam dennoch zu dem Ergebnis, dass die Suchsensitivität von Elicit nicht hoch genug war, um traditionelle Literatursuchen zu ersetzen. Daher funktioniert es am besten als hochpräzise Ergänzung. Zudem endet der Workflow häufig bei Berichten und Tabellen; Schreiben, Versionierung und die Arbeit an lebendigen Manuskripten verlagern sich meist an andere Orte.
NotebookLM ist der klare Spezialist für fundiertes Lesen einer festen Sammlung. Jede Antwort kann anhand einer zitierten Passage geprüft werden, und Google hat Deep Research sowie breitere Dateitypen hinzugefügt. Es kann keine Paper entdecken, die Sie noch nicht gesammelt haben, und es kodiert kein Entscheidungsprotokoll im PRISMA-Stil.
Consensus ist der klare Spezialist für Hypothesenrichtungen. Sein Meter sowie die Tags für Unterstützung und Kontrast sind schneller als der Aufbau eines Extraktionsrasters, wenn Sie nur wissen müssen, in welche Richtung die Literatur tendiert (Toolvergleich). Als primäres System für eine kodierte Map ist es die falsche Wahl.
Jenovas Academic Research Assistant ist am stärksten, wenn die Arbeitseinheit das Projekt und nicht das PDF ist. Er kann wissenschaftliche Quellen durchsuchen, Manuskript- und Zitationskontext bewahren und — weil die zugrunde liegende Plattform unbegrenzten Chatverlauf und sitzungsübergreifenden Speicher vorhält — einen Kodierungsrahmen fortführen, ohne dass das Protokoll erneut eingefügt werden muss. Er ist keine validierte Plattform für Dual-Review-Screening im Sinne von Covidence oder Rayyan und veröffentlicht keine Elicit-ähnlichen Zahlen zur Extraktionsgenauigkeit. Teams, die Audit-Trails auf regulatorischem Niveau benötigen, sollten daher weiterhin einen spezialisierten Screener im Stack behalten.
SciSpace und Scite decken engere, benachbarte Aufgaben ab. SciSpace wird wiederholt als die bessere Umgebung für Tiefenanalyse einzelner Paper beschrieben, mit einem sehr großen Korpus, aber einem weniger einheitlichen Review-Workflow. Scites 1,6 Milliarden Smart Citations, die als unterstützend, kontrastierend oder eine Behauptung erwähnend klassifiziert sind, sind für die Prüfung des Zitationskontexts unübertroffen und als eigenständige Datenbank für Entdeckung oder Mapping nahezu nutzlos.
Wie verändert operativer Speicher die Literatursynthese über mehrere Sitzungen?
Operativer Speicher verändert die Synthese, weil er den Projektcontainer — Hintergrund, Entscheidungen, Status, Artefakte — als Objekt behandelt, das zu Beginn einer Sitzung geladen wird, statt die Literatur als Heuhaufen zu behandeln, der erneut abgefragt werden muss. Referenzspeicher fragt: „Welche Chunks ähneln dieser Frage?“ Operativer Speicher fragt: „Was gilt bereits für dieses Projekt, und wofür fehlt noch Evidenz?“
Dieser Unterschied zeigt sich in drei Fehlermodi, die Zusammenfasser gut verbergen:
- Kriteriendrift. Wenn „nur RCTs mit erwachsenen Menschen“ im Prompt statt im Projektstatus steht, wird eine spätere Sitzung mit einer leicht weiter gefassten Frage die bereits abgelehnten pädiatrischen Studien stillschweigend wieder einschließen.
- Verwaiste Vielleicht-Fälle. Grenzfall-Paper, die zur Diskussion mit einem Co-Autor zurückgestellt wurden, verschwinden, sofern ihr Status kein Feld erster Klasse ist.
- Neu erzeugte Synthese. Eine RAG-Antwort kann den heute abgerufenen Chunks lokal treu bleiben und dennoch der Lückentabelle der vergangenen Woche widersprechen, weil nichts die neue Antwort dazu zwingt, die frühere Kodierung zu übernehmen.
Persistente Workspaces kehren die Ladereihenfolge um. Hintergrundkontext, Entscheidungen, Status und Artefakte werden vor der nächsten Anfrage eingebracht. Jenovas Plattform implementiert dieses Muster durch sitzungsübergreifenden Speicher plus anheftbare Wissensdatenbanken: Der Assistent kann sich an Mapping-Dimensionen, die Arbeitsdefinition einer Evidenzlücke und daran erinnern, welche Behauptungen bereits ausreichend gestützt sind. Der Vergleich mit Tools im Notebook-Stil zeigt einen klaren Zielkonflikt. NotebookLMs abgeschlossener Korpus ist besser gegen Erfindungen außerhalb der Quellen abgesichert (quellverknüpfte Antworten). Ein persistenter offener Workspace ist nützlicher, wenn der Korpus noch wächst und der Kodierungsrahmen das knappe Gut ist.
Die praktische Konsequenz für SEMs ist einfach. Wenn Ihr Ergebnis ein Briefing zu 15 PDFs in einer einzigen Sitzung ist, ist operativer Speicher optional. Wenn Ihr Ergebnis eine Lückenmap ist, die nach dem nächsten Konferenzzyklus aktualisiert wird, ist operativer Speicher das Produkt.
Wie sieht eine durchgängige agentische Evidenzpipeline tatsächlich aus?
Eine durchgängige Mapping-Pipeline sieht wie ein gestaffelter Recherche-Sprint mit Gates aus und nicht wie ein einzelner Prompt „Fasse diese Paper zusammen“. Die folgende Abbildung zeigt eine nützliche Referenzarchitektur: Fragestellung, Literatur-Triage, Identifikation von Kandidaten, Hypothesenformalisierung, Validierung aus mehreren Quellen, versioniertes Reporting und ein git-getracktes Paket.
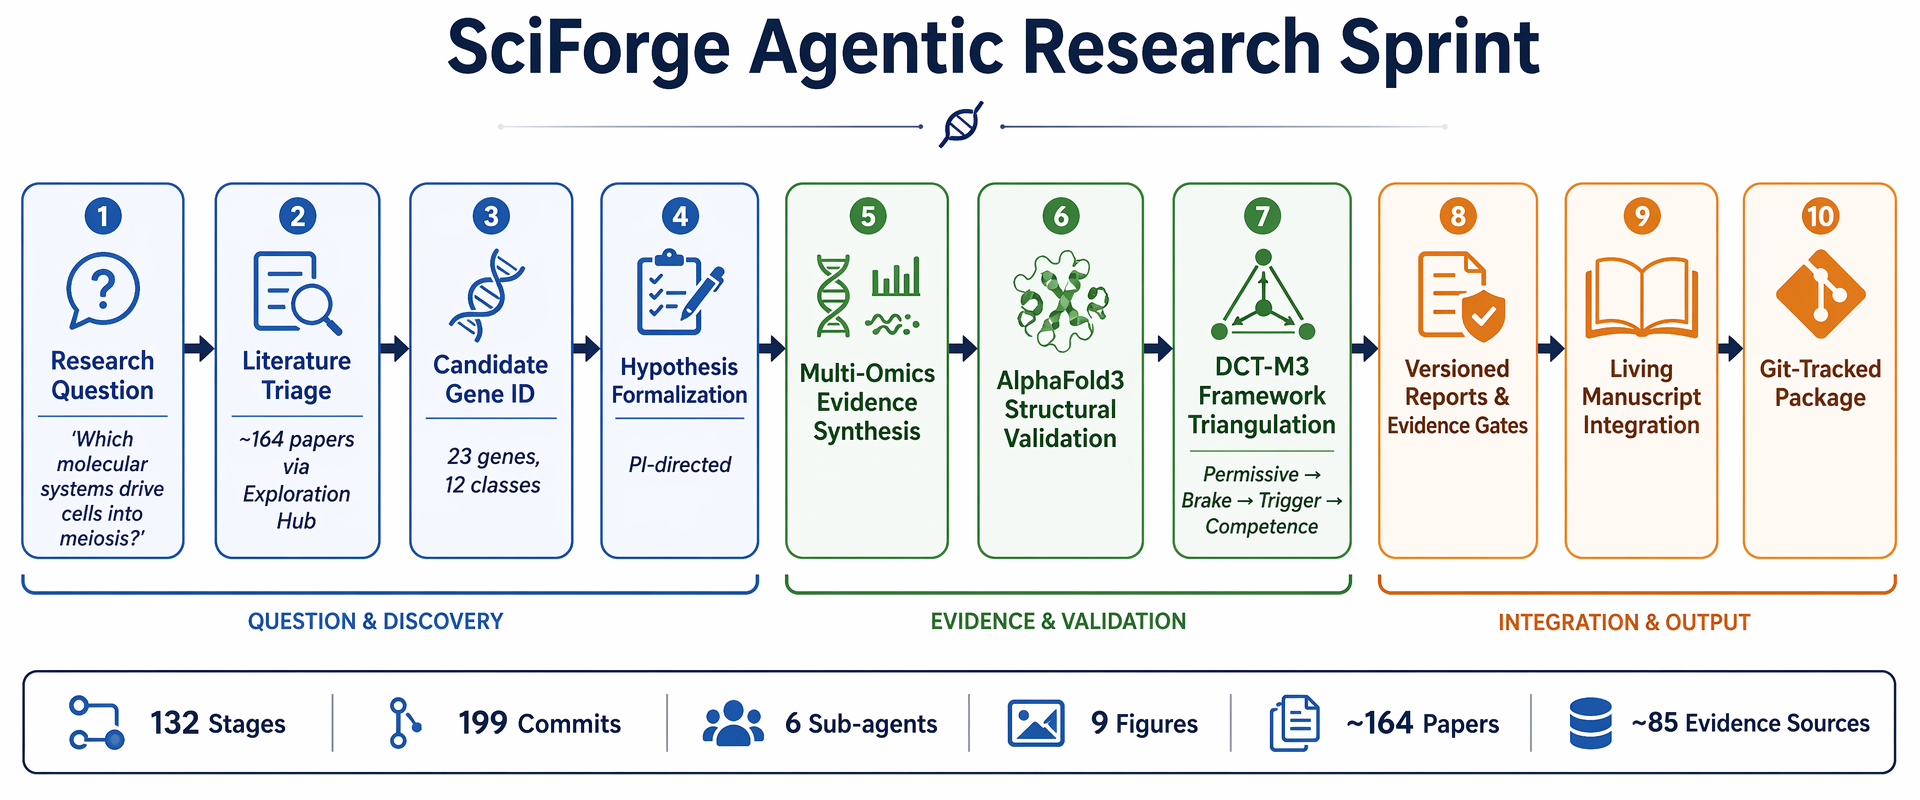
Der beispielhafte Sprint ist bewusst groß angelegt — in der Größenordnung von 164 triagierten Papern, 132 Stufen, 199 Commits, sechs Sub-Agenten und etwa 85 Evidenzquellen — weil Paper-Chat in diesem Maßstab zusammenbricht. Ein Zusammenfasser kann Paper 17 beschreiben. Er kann keine 10-stufige Kette konsistent halten, wenn Stufe 4 die Einschlussregel ändert, die Stufe 2 bereits angewendet hat.
Drei Designentscheidungen dieser Pipeline sind wichtiger als die Domänendetails:
- Entdeckung ist eine Phase, nicht das Produkt. Literatur-Triage führt zu Kandidaten-IDs und einer formalen Hypothese. Bei Zusammenfassungen stehenzubleiben lässt die Map unaufgebaut.
- Validierung ist multimodal. Evidenzsynthese, strukturelle oder quantitative Prüfungen und eine explizite Logik „zulassen → bremsen → auslösen“ zwingen Behauptungen durch Gates, statt sie zu einem Absatz zu mitteln.
- Das Ergebnis ist versioniert. Die Integration in ein lebendiges Manuskript und ein git-getracktes Paket machen die Map zu einem Artefakt mit Historie. Das ist das Gegenteil eines Chat-Transkripts, das Sie nicht reproduzieren können.
Jenova kann dieses Muster annähern, indem es Rollen auf Agenten aufteilt, statt einen einzelnen Chat zugleich als Bibliothekar, Kodierer und Autor einzusetzen. Academic Research Assistant übernimmt wissenschaftliche Entdeckung und Manuskriptkontext. Deep Research erstellt zitationsgestützte Synthesen über viele Quellen hinweg. Real-Time Search ist nützlich, wenn die Map auch Preprints, Repositorien oder nicht in Zeitschriften veröffentlichte graue Literatur enthalten muss. Die Einschränkung ist Orchestrierungsdisziplin: Der Mensch verantwortet weiterhin das Protokoll, die Gates und die Entscheidung, eine Behauptung in das lebendige Manuskript zu übernehmen. Methodengruppen betrachten diese menschliche Rolle weiterhin als nicht verhandelbar (KCL-/RAISE-Leitlinien).
All-in-one-Review-Plattformen im Stil von Paperguide versuchen, Planen–Suchen–Screenen–Extrahieren–Generieren in einem einzigen Anbieter-Workflow zusammenzuführen, einschließlich Extended-Modi, die 200 Kandidaten screenen und aus den besten 50 schreiben. Das kommt einem Workspace näher als Elicit-plus-Word, benötigt aber weiterhin ein externes Entscheidungsprotokoll, wenn Ihnen die Provenienz wichtig ist, nachdem der generierte Review exportiert wurde.
Wie holen Sie das Beste aus einer AI-Evidenzkarte heraus?
Sie holen das Beste aus einer AI-Evidenzkarte heraus, indem Sie das Protokoll vor der Bitte um Prosa in den Workspace schreiben und jede spätere Sitzung dazu zwingen, dieses Protokoll zu übernehmen. Der Aufbau ähnelt sich über Tools hinweg; der Unterschied liegt darin, ob das Tool den Aufbau erinnern kann.
Für eine Jenova-zentrierte Map ist folgende Abfolge praktikabel:
- Öffnen Sie Academic Research Assistant und benennen Sie im ersten Beitrag Projekt, Population und Mapping-Dimensionen.
- Hinterlegen Sie das Protokoll in einer Sprache, die der Assistent wiederverwenden kann:
„Erstellen Sie eine systematische Evidenzkarte zu Studien mit erwachsenen Menschen über X. Schließen Sie nur RCTs und prospektive Kohorten ein. Kodieren Sie jede Studie nach Design, Stichprobe, Intervention, primärem Ergebnis, Effektrichtung und Einschränkungen. Führen Sie Tier- und In-vitro-Paper in einem Ausschlussprotokoll mit einem einzeiligen Grund. Erzeugen Sie bereits entschiedene Kodierungen nicht erneut.“
- Führen Sie Deep Research für den ersten Korpusdurchlauf aus und fügen Sie die Arbeitstabelle anschließend wieder in denselben Projekt-Thread ein oder hängen Sie sie dort an, damit Extraktion und Narrativ einen gemeinsamen Speicher verwenden.
- Bitten Sie nach jeder Sitzung um drei Artefakte und nicht um einen Aufsatz: eine aktualisierte Studientabelle, ein Ausschlussprotokoll und eine Lückenliste. Diese drei Dateien sind die Map.
Beginnen Sie bei Elicit mit der Forschungsfrage, erstellen Sie eine Screening-Tabelle und behandeln Sie die Bibliothek als maßgebliche Quelle (Elicit-Workflow für systematische Reviews). Überspringen Sie keine herkömmliche Datenbanksuche. Die Cochrane-Fallstudien fanden Elicit nützlich für hochpräzise vorläufige Suchen und einzigartige zusätzliche Studien, nicht als alleinige Suchmaschine.
Sammeln Sie für NotebookLM zuerst die PDFs, bleiben Sie innerhalb eines Notebooks und stellen Sie Fragen Dimension für Dimension — etwa „Listen Sie jede Studie auf, die Ergebnis Y mit Stichprobengröße und Nachbeobachtung berichtet“ — damit der abgeschlossene Korpus nicht abschweifen kann. Upload-Limits — 50 Quellen in der kostenlosen Stufe, 300 mit Plus — machen dieses Tool für eine Map mit 400 Datensätzen ungeeignet, sofern Sie nicht zuvor an anderer Stelle vorscreenen.
Zwei Prozessregeln gelten für jeden Stack. Erstens: Laden Sie keine Volltext-PDFs in ein Consumer-Modell hoch, wenn die Urheberrechtsbedingungen dies untersagen; Rechteinhaber verbieten diese Nutzung im Allgemeinen. Zweitens: Lassen Sie bei Einschluss und Ausschluss einen Menschen entscheiden. Screening-Unterstützung ist die AI-Aufgabe mit der stärksten Evidenzbasis; unbeaufsichtigte Synthese ist die Aufgabe mit der schwächsten (Review von Reviews zur AI-Bereitschaft).
Was sagen Spezialisten für Evidenzsynthese über AI-gestütztes Mapping?
Spezialisten akzeptieren AI zunehmend für überwachtes Screening und Extraktion, lehnen AI jedoch weiterhin als unbeaufsichtigten Kartografen eines Forschungsfelds ab. Der nützliche Expertenkonsens im Jahr 2026 ist enger gefasst als die Aussagen von Anbietern: Automatisieren Sie die repetitive Ebene, halten Sie die Entscheidungsebene persistent und lassen Sie Menschen für die Map verantwortlich bleiben.
„Der Fehlermodus, den wir beobachten, besteht nicht darin, dass Modelle ein Paper nicht zusammenfassen können. Vielmehr behandeln Mapping-Teams eine gute Zusammenfassung so, als wäre sie ein kodierter Datensatz. Eine systematische Evidenzkarte ist eine Menge rückverfolgbarer Entscheidungen — eingeschlossen, ausgeschlossen, zurückgestellt, gefiltert — die an stabile Felder gebunden sind. Wenn diese Entscheidungen nur im Prompt der vergangenen Woche stehen, ist die Map bereits korrumpiert, selbst wenn jeder Absatz weiterhin sorgfältig klingt.“
„Referenzabruf und operativer Speicher lösen unterschiedliche Probleme. Abruf ist die Methode, Kandidatenevidenz zu finden. Operativer Speicher verhindert, dass dieselbe Studie dreimal neu kodiert wird. Tools, die bei der ersten Aufgabe ausgezeichnet sind, werden regelmäßig eingesetzt, als erfüllten sie auch die zweite. So entsteht eine flüssige Lückenanalyse, die nicht erklären kann, warum 12 Grenzfallstudien verschwunden sind.“
„Unsere Arbeitsregel ist einfach. Nutzen Sie eine Korpus-Engine, um Zeilen zu füllen. Nutzen Sie einen persistenten Workspace, um Codebuch, Ausschlussprotokoll und Lückentabelle lebendig zu halten. Setzen Sie bei jedem Gate, das die Bedeutung der Map verändert, einen menschlichen Reviewer ein. Alles, was als Ein-Klick-systematische-Map verkauft wird, fordert Sie auf, die einzige Ebene zu überspringen, die Methodengruppen weiterhin für unverzichtbar halten.“
— Jenova Product Team, Design von Recherche-Workflows, 8 Jahre Erfahrung im Aufbau von Wissenssystemen für mehrsitzige analytische Arbeit
Diese Haltung stimmt mit formellen Leitlinien überein. NICE, Cochrane-nahe RAISE-Empfehlungen und universitäre Bibliotheksdienste beschreiben AI durchweg als Ergänzung innerhalb bestehender validierter Methoden. Ein fortlaufend aktualisierter Leitfaden zu AI für Literatursuche und Screening vertritt dieselbe Effizienzargumentation — Screening ist teuer, Automatisierung hilft — ohne zu behaupten, dass Generierung ein Protokoll ersetzen kann.
Wann sind Zusammenfasser für einzelne Paper weiterhin die richtige Wahl?
Zusammenfasser für einzelne Paper sind weiterhin die richtige Wahl, wenn der Korpus klein, bereits gesammelt und nicht in eine wiederverwendbare Map kodiert wird. Wenn Sie 12 PDFs, eine Literaturbesprechung morgen und keinen Bedarf haben, das Inventar in drei Monaten zu aktualisieren, erledigt Paper-Chat im Stil von NotebookLM oder SciSpace die Aufgabe mit weniger Aufwand als ein Projektcontainer.
Sie eignen sich auch besser für drei weitere Aufgaben, die fälschlich als Mapping bezeichnet werden:
- Erklärung von Mechanismen. „Führen Sie mich durch Abbildung 3“ ist eine Leseaufgabe. Ein Notebook mit abgeschlossenem Korpus und anklickbaren Zitaten ist sicherer als ein offener Workspace, der Paper vermischen könnte.
- Prüfung von Zitationskontexten. Wenn die Frage lautet, ob spätere Arbeiten eine Behauptung stützen oder ihr widersprechen, sind Scites klassifizierte Zitationen die dafür entwickelte Ebene (1,6 Mrd.+ Smart Citations).
- Stichprobenprüfungen von Hypothesen. Consensus ist weiterhin der schnellste Weg, um zu erkennen, ob eine Aussage eine sichtbare Aufteilung in Unterstützung und Kontrast aufweist, bevor Sie in eine Map investieren (Überblick Elicit vs Consensus).
Der Fehler besteht darin, diese Stärken als Ersatz für SEM-Infrastruktur zu verwenden. Ein Zusammenfasser kann lokal hervorragend sein und dennoch das falsche System of Record darstellen. Umgekehrt kann ein persistenter Workspace ein unordentliches Codebuch lebendig halten und dennoch das falsche Tool für ein Doppel-Screening mit 5.000 Datensätzen sein, wenn Sie spezialisierte SR-Software benötigen. Institutionelle Leitfäden verweisen Teams für diese Phase weiterhin auf Screening-Plattformen wie Rayyan, Covidence und DistillerSR (CASRAI-Leitfaden zu AI für SR; Leitfaden für systematische Reviews von Stony Brook).
Die Entscheidungsregel, die sich in realen Reviews bewährt, ist daher architektonisch und nicht markenbasiert. Wenn das Arbeitsergebnis aus vergleichbaren, aktualisierbaren und erklärbaren Kodierungsentscheidungen besteht, wählen Sie einen Forschungs-Workspace mit Projektspeicher und nutzen Sie daneben eine Korpus-Engine. Wenn das Arbeitsergebnis darin besteht, die bereits auf Ihrem Schreibtisch liegenden Paper zu verstehen, ist ein Zusammenfasser für einzelne Paper kein Kompromiss. Er ist das passend dimensionierte Tool.
Referenzen
- ScienceDirect — Leitfaden zur Durchführung systematischer Evidenzkarten
- PubMed Central — Methodik für Mapping-Reviews, Evidenzkarten und Lückenkarten
- Paperguide — Die 7 besten AI-Tools für Literatur-Reviews im Jahr 2026
- King’s College London — AI-Tools in der Evidenzsynthese
- Elicit — AI für wissenschaftliche Forschung
- NotebookLM — AI-Recherchetool und Denkpartner
- Google Blog — NotebookLM ergänzt Deep Research, DOCX, Sheets und mehr
- The Drive AI — Elicit vs Consensus vs Semantic Scholar
- Omid Saffari — Beste AI-Recherchetools 2026: Elicit vs Consensus
- Leitfaden zur Nutzung von AI in Literatursuche und Screening
- CASRAI — AI-Tools für systematische Literatur-Reviews
- Stony Brook University Libraries — Leitfaden für systematische Reviews: Künstliche Intelligenz