Sind AI-Rechercheassistenten besser als die Schlüsselwortsuche für verwandte Fachartikel?
2026-08-22
Wann übertrifft semantisches Matching das Keyword-Ranking bei konzeptionell verwandten Fachartikeln?
Semantische AI-Rechercheassistenten übertreffen die traditionelle Schlüsselwortsuche, wenn die benötigten Fachartikel dieselbe Idee mit unterschiedlicher Terminologie beschreiben. Keyword-Suchmaschinen bleiben hingegen stärker, wenn Sie bereits die exakten Formulierungen, Autoren oder den zu untersuchenden Zitiercluster kennen. Die praktische Antwort im Jahr 2026 besteht nicht darin, Google Scholar aufzugeben, sondern lexikalisches Ranking mit bedeutungsbasierter Recherche zu kombinieren – mit Tools wie Elicit, SciSpace, Undermind und Jenovas Academic Research Assistant.
Die wichtigsten Faktoren, die effektive konzeptionelle Entdeckung von Keyword-Matching unterscheiden:
✅ Flexibilität des Vokabulars – ob das System einen Artikel über „Myokardinfarkt“ finden kann, wenn die Suchanfrage „Herzinfarkt“ lautete
✅ Ranking-Signale – zitiergewichtete lexikalische Scores gegenüber Embedding-Ähnlichkeit gegenüber einem LLM, das Relevanz bewertet
✅ Index-Tiefe – Titel-Abstract-Metadaten gegenüber Volltext-Matching über Hunderte Millionen Arbeiten hinweg
✅ Präzisionskontrollen – verschachtelte Boolean-Abfragen, Feldbegrenzungen, Filter für Zeitschriftenqualität und Exportlimits
✅ Zeit bis zur nützlichen Treffermenge – sofortige explorative Listen gegenüber iterativen Suchen, die mehrere Minuten dauern
Um diese Methoden ehrlich zu vergleichen, hilft es, Vokabularmismatch, Ranking-Verzerrungen und Suchkontrolle als getrennte Dimensionen zu behandeln, statt zu fragen, welches Tool universell besser ist.
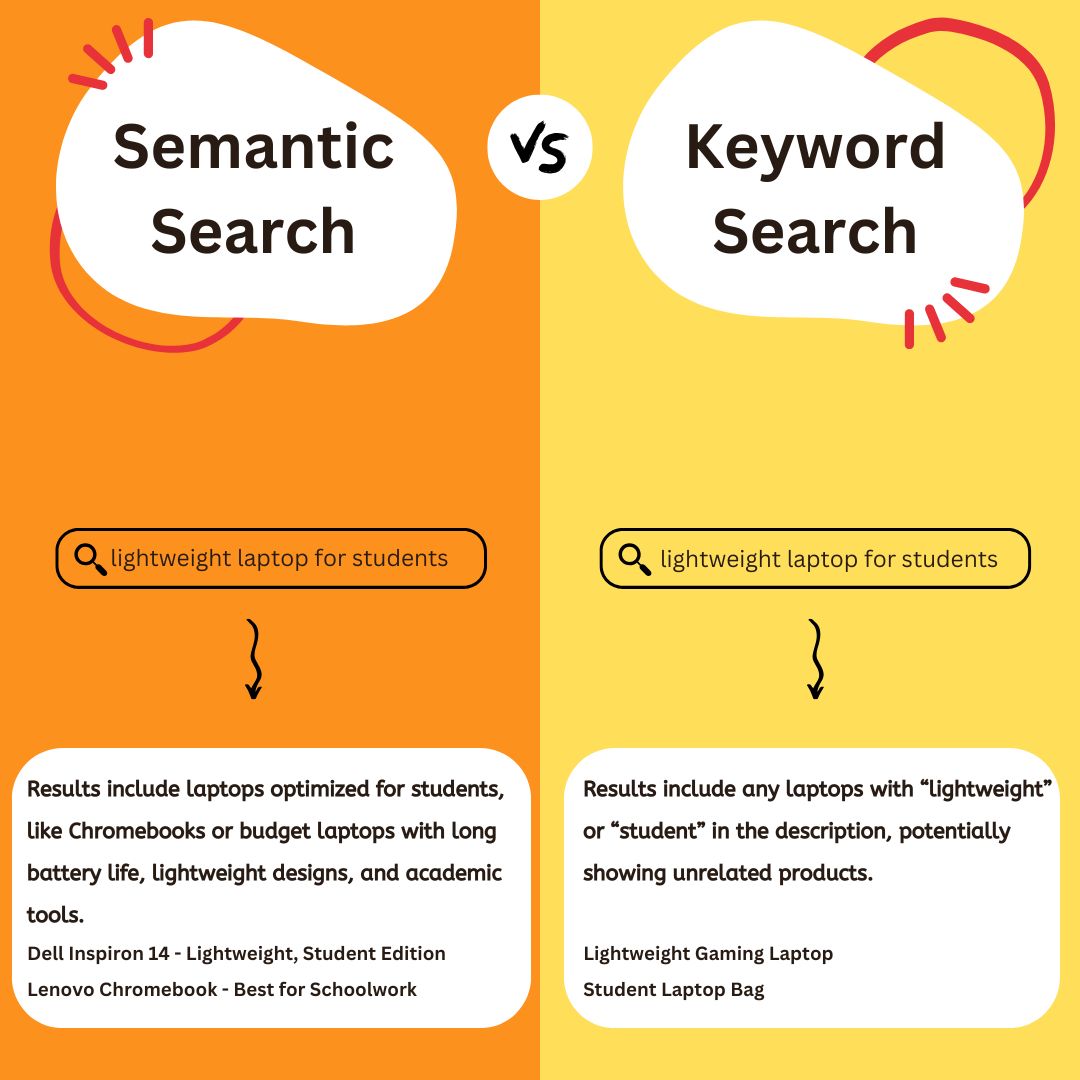
Warum beeinträchtigt Vokabularmismatch die traditionelle akademische Suche auch 2026 noch?
Vokabularmismatch beeinträchtigt die traditionelle akademische Suche weiterhin, weil Autoren, Disziplinen und Zeiträume dasselbe Phänomen unterschiedlich benennen und lexikalische Suchmaschinen nur Dokumente abrufen, die genügend Oberflächenbegriffe mit der Suchanfrage teilen. Ein Public-Health-Artikel kann von „körperlicher Aktivität“ sprechen, ein kardiologischer Artikel von „Belastbarkeit“ und ein soziologischer Artikel von „Freizeitbewegung“. Suchen Sie nur nach einer Formulierung, können die beiden anderen Cluster auf den ersten mehreren Ergebnisseiten verschwinden.
Google Scholar bleibt für die meisten Forschenden der Standard-Einstiegspunkt und ist weiterhin die breiteste verfügbare akademische Suchoberfläche, einschließlich Volltexten von Verlagen und Repositorien. Aaron Tay, wissenschaftlicher Bibliothekar an der Singapore Management University, bezeichnete es als Schweizer Taschenmesser der wissenschaftlichen Suche – als das Tool, das er behalten würde, wenn er nur eines behalten dürfte. Sein Ranking ist jedoch weiterhin lexikalisch. Nach Treffern im Titel gewichtet es stark zitierte Artikel besonders hoch. Das ist hervorragend, um grundlegende Arbeiten zu finden, aber schwach beim Auffinden konzeptionell verwandter Artikel, die andere Formulierungen verwenden oder noch keine Zitationen angesammelt haben.
Das Problem verschärft sich, wenn ein Suchbegriff häufig vorkommt. Da Google Scholar den Volltext durchsucht, kann eine Suche nach einem Tool oder Konzept mit einem alltäglichen Namen in Tausende beiläufige Treffer ausarten. Tay weist darauf hin, dass die Suche nach „Elicit“ in Google Scholar nahezu nutzlos ist, sofern Sie keinen Domain-Workaround hinzufügen, weil das Wort in Methodenteilen ständig erscheint. Semantische Systeme reduzieren diesen Fehlermodus, indem sie Bedeutung statt Zeichenkettenüberschneidung bewerten. Deshalb sind sie eher zu einer ergänzenden Ebene als zu einer bloßen Neuheit geworden.
Was sollten Sie beim Vergleich von Schlüsselwortsuche und semantischen AI-Assistenten bewerten?
Sie sollten Schlüsselwortsuche und semantische AI-Assistenten anhand von sechs Dimensionen bewerten, die dieser Artikel als Mismatch-Recovery-Framework bezeichnet: Flexibilität des Vokabulars, Transparenz des Rankings, Indexabdeckung, Präzisionskontrolle, Autoritätssignale und Zeit bis zur nützlichen Treffermenge. Ein Tool, das in einer Dimension gewinnt, verliert häufig in einer anderen. Daher ist ein einzelnes „Gewinner“-Ranking eher irreführend als hilfreich.
Flexibilität des Vokabulars fragt, ob die Suchmaschine einen Artikel abrufen kann, dessen Abstract Ihre Suchbegriffe nie wiederholt. Dichte Embeddings und hybride Methoden wie SPLADE, das Elicit als Ansatz für gelernte spärliche Embeddings einsetzt, sind dafür ausgelegt. Transparenz des Rankings fragt, ob Sie erklären können, warum ein Artikel erschien. Boolean-plus-BM25-Systeme lassen sich leichter prüfen; die Nächste-Nachbar-Suche mit Embeddings und LLM-Reranker sind schwieriger zu reproduzieren.
Indexabdeckung ist nicht dasselbe wie die „beworbene Anzahl an Artikeln“. OpenAlex meldet 517 Millionen Werkdatensätze und 66 Millionen Volltext-PDFs, während Elicit angibt, dass es Daten aus mehr als 125 Millionen Artikeln durchsucht, zusammenfasst und extrahiert. Google Scholar veröffentlicht keine vergleichbare offizielle Anzahl, wird aber weithin als größter akademischer Volltext-Suchindex angesehen. Präzisionskontrolle umfasst verschachtelte Boolean-Abfragen, Feldbegrenzungen, Näherungsoperatoren und kontrolliertes Vokabular – Funktionen, bei denen The Lens und OpenAlex Google Scholar übertreffen.
Autoritätssignale umfassen Zitationszahlen, Zeitschriftenrang und Hinweise auf Rücknahmen. Google Scholar und in geringerem Umfang Undermind tendieren zu stark zitierten Arbeiten. Elicit und SciSpace ranken im Allgemeinen nach semantischer Ähnlichkeit und gewichten Zitationen nicht, sodass neuere oder weniger zitierte Artikel aufsteigen. Zeit bis zur nützlichen Treffermenge unterscheidet die sofortige Keyword-Suche von iterativen Durchläufen nach Art von Undermind, die mindestens drei Minuten dauern. Bewerten Sie jede Dimension anhand Ihrer tatsächlichen Aufgabe – synonymreiche Entdeckung, systematischer Recall oder eine fünfminütige Orientierung –, bevor Sie eine primäre Suchmaschine auswählen.
Wie schneiden Google Scholar, Elicit, SciSpace, Undermind und Jenova bei der konzeptionellen Entdeckung ab?
Google Scholar ist am stärksten für breite, zitationsgewichtete Exploration; Elicit und SciSpace sind am stärksten, wenn Keywords unklar sind; Undermind ist am stärksten für enge Suchen mit hoher Präzision; und Jenovas Academic Research Assistant ist am stärksten, wenn Entdeckung, Synthese und Zitationsarbeit in einer fortlaufenden Unterhaltung bleiben müssen. Keines dieser Tools dominiert jede Zelle des Mismatch-Recovery-Framework.
| Funktion / Dimension | Google Scholar | Elicit / SciSpace | Undermind | Jenova Academic Research Assistant | Lens.org / OpenAlex |
|---|---|---|---|---|---|
| Matching-Methode | Lexikalisch / Keyword, zitationsgewichtet | Semantisch oder hybrid (Elicit nutzt SPLADE) | Hybride Recherche plus LLM-Relevanzbewertung und iterative Suche | Recherche-Agent in natürlicher Sprache über Live-Quellen aus der Wissenschaft, einschließlich Google Scholar | Strukturierte Suche in wissenschaftlichen Metadaten mit erweiterten Operatoren |
| Wiederfinden bei abweichender Formulierung | Schwach, sofern Sie keine Synonyme ergänzen oder Related articles verwenden | Stark für bedeutungsbasierte Anfragen | Stark für spezifische Briefings in natürlicher Sprache | Stark bei konversationeller Umformulierung über Sitzungen hinweg | Schwach bis moderat; hängt von der Abfragekonstruktion ab |
| Verzerrung durch Autorität | Bevorzugt nach Treffern im Titel stark zitierte Artikel | Geringe Zitationsgewichtung; neuere Artikel steigen auf | Gewisse Tendenz zu grundlegenden Arbeiten durch Zitationssuche | Folgt den verbundenen Quellen und dem von Ihnen bereitgestellten Briefing | Metadatengesteuert; eher für Analyse als für semantisches Ranking konzipiert |
| Präzisionsfunktionen | Keine verschachtelten Boolean-Abfragen, Limit von 256 Zeichen, eingeschränkte Feldsuche | Nachgelagerte Filter für Zeitschriftenqualität, z. B. Scimago-Ränge bei SciSpace | Spezifität in natürlicher Sprache statt Boolean | Konversationelle Eingrenzung; keine Suchmaschine mit Boolean-Syntax | Verschachtelte Boolean-Abfragen, Nähe, Feldsuche, kontrolliertes Vokabular |
| Typische Abfragezeit | Sofort | Schnell genug für Exploration | Mindestens etwa 3 Minuten pro Suche | Interaktiv; Folgeanfragen erfolgen sofort | Sofort bis API-getaktet |
| Preise (Stand 2026) | Kostenlos | Elicit Pro etwa 49 $/Monat; kostenpflichtige SciSpace-Stufen laut Berichten von 12 bis 160 $/Monat | Kostenlose explorative Stufe; kostenpflichtige akademische Pläne | Kostenlose Stufe mit begrenzter Nutzung; Plus ab 20 $/Monat | Kostenlose Websuche; OpenAlex API mit kostenloser Stufe |
| Am besten geeignet für | Grundlegende Arbeiten, Cited by-Verkettung, Volltextsuche | Unklare Keywords und fragenartige Anfragen | Auffinden einer spezifischen Studienklasse mit hohem Recall | End-to-End-Literaturarbeit mit Gedächtnis und Manuskriptunterstützung | Systematische, reproduzierbare Suchen mit hoher Kontrolle |
Google Scholar
Google Scholar ist weiterhin der Generalist. Offizielle Hilfeseiten bestätigen, dass Ergebnisse normalerweise nach Relevanz und nicht nach Datum sortiert werden und dass Forschende über Related articles und Cited by wechseln können, sobald sie einen Ausgangsartikel gefunden haben. Diese beiden Funktionen kommen der konzeptionellen Entdeckung durch Keyword-Suche am nächsten, benötigen aber einen guten Ausgangsartikel. Die Schwächen sind gut dokumentiert: keine verschachtelten Boolean-Abfragen, keine Feldsuche nur in Abstracts, eine Abfragegrenze von 256 Zeichen, eine Obergrenze von 1.000 Ergebnissen und kein Massenexport. Diese Kombination ist der Grund, warum Bibliothekare Google Scholar routinemäßig als primäre Datenbank für systematische Reviews ausschließen.
Elicit und SciSpace
Elicit positioniert sich als AI zum Durchsuchen, Zusammenfassen, Extrahieren und Chatten mit mehr als 125 Millionen Artikeln, mit über 2 Millionen Forschungsnutzern. Sowohl Elicit als auch SciSpace akzeptieren Fragen in natürlicher Sprache und ranken nach semantischer Ähnlichkeit. Deshalb finden sie Artikel, deren Wortlaut von der Anfrage abweicht. Der Kompromiss ist eine Ranking-Verzerrung in die entgegengesetzte Richtung zu Google Scholar: Sie können semantisch nahe, aber qualitativ minderwertige oder wenig zitierte Artikel bevorzugen. SciSpace ist im Allgemeinen schneller und besser für schnelle Erkenntnisse als für tiefe iterative Synthese. Ergebnisse können zudem nicht deterministisch sein, sodass dieselbe Anfrage nicht zweimal dieselbe Menge zurückgeben muss.
Undermind
Undermind ist der Spezialist. Es kombiniert Keyword- und semantische Recherche, nutzt dann ein Frontier-Modell zur Bewertung, ob Titel, Abstract und verfügbare Metadaten das Briefing tatsächlich beantworten, und iteriert mit Zitationssuche. In einem Test gegen die eingeschlossene Menge eines systematischen Reviews fand es 8 von 11 Goldstandard-Artikeln in den Top 10 Ergebnissen wieder (recall@10 von 72,7 %) und 9 von 11 bis Rang 50 (recall@50 von 81,8 %). Diese Qualität kostet Zeit und funktioniert bei vagen Themen schlecht. Außerdem sieht es hauptsächlich Titel und Abstract sowie einige Open-Access-Volltexte, sodass Aussagen übersehen werden können, die ausschließlich in Methoden oder Ergebnissen verborgen sind.
Jenovas Academic Research Assistant
Jenovas Academic Research Assistant ist eher ein fachbewusster Forschungspartner als ein eigenständiger Artikelindex. Er führt Live-Literaturrecherche über wissenschaftliche Quellen hinweg aus und begleitet das Projekt dann durch Synthese, Manuskriptvorbereitung und Zitationsmanagement. Persistentes Gedächtnis bedeutet, dass er sich merken kann, dass Ihr Arbeitsbegriff „kognitive Ermüdung“ lautet, während die Literatur auch „Ego-Depletion“ und „Erholungsbedarf“ verwendet. Zudem kann er diese Synonymcluster sitzungsübergreifend mit demselben Projekt verknüpft halten.
Die ehrliche Einschränkung ist architektonischer Natur. Er liefert keinen proprietären semantischen Index mit 125 Millionen Artikeln und integrierten Extraktionstabellen im Sinne von Elicit aus und ist kein mehrminütiger iterativer Sucher nach Art von Undermind mit veröffentlichtem recall@10-Benchmark. Seine Stärke liegt in der Orchestrierung: Briefing in natürlicher Sprache, Live-Recherche in wissenschaftlichen Quellen, Folgefragen und Schreibunterstützung in einem Thread. Forschende, die einen reproduzierbaren Boolean-Prüfpfad benötigen, sollten The Lens oder OpenAlex weiterhin parallel einsetzen.
Wie findet semantische Suche Artikel, die dieselbe Idee unterschiedlich formulieren?
Semantische Suche findet unterschiedlich formulierte Artikel, indem sie die Anfrage und die Dokumentensammlung in einen gemeinsamen Bedeutungsraum einbettet und dann die nächsten Nachbarn abruft, statt überlappende Tokens zu verlangen. Wenn die Anfrage lautet: „Wie stellen Nachtpflegekräfte nach aufeinanderfolgenden Schichten ihre Aufmerksamkeit wieder her?“, sucht eine lexikalische Suchmaschine nach diesen Wörtern. Eine semantische Suchmaschine kann Studien mit Titeln zu „zirkadianer Störung“, „Erholungsschlaf“ oder „beruflicher Ermüdung“ abrufen, selbst wenn „Pflegekräfte“ oder „Aufmerksamkeit“ nie im Titel erscheinen.
Semantic Scholar, die Literaturmaschine des Allen Institute for AI, war eine frühe öffentliche Demonstration dieser Idee: wissenschaftliche Artikel nach verstandener Bedeutung statt nach Zeichenkettenübereinstimmung zu ranken. Elicit und SciSpace wenden ein ähnliches Prinzip im Maßstab von Web-Apps an. Tay beschreibt einen besonders klaren Test: Fügen Sie einen Zeitungsabsatz ein, der die Ergebnisse einer Studie beschreibt, und eine semantische Suchmaschine kann den zugrunde liegenden Zeitschriftenartikel finden, weil das Embedding des Nachrichtentextes dem Embedding des Artikels nahe liegt. Die Keyword-Suche übersteht diese Paraphrase fast nie.
Es gibt einen zweiten, weniger sichtbaren Mechanismus: die Anfrageerweiterung innerhalb des Assistenten. Ein konversationeller Agent kann Mengen von Synonymen, verwandte MeSH-artige Konzepte, Antonyme und disziplinäre Varianten erzeugen und diese Varianten dann explizit durchsuchen. Das ist keine reine Vektorsuche. Es ist semantisches Verständnis, das eingesetzt wird, um ein besseres lexikalisches Netz zu bauen. In der Praxis nutzen Workflows mit dem höchsten Recall beides – Embeddings für den Recall bei unbekannten Formulierungen und anschließend exakte Phrasen, Autorennamen und Zitationslinks zur Verifizierung, damit die Menge nachvollziehbar bleibt.
Ein Test mit einem aktuellen Briefing zeigt die Lücke meist schnell. Fragen Sie eine Keyword-Suchmaschine nach „teacher noticing“, erhalten Sie vor allem Artikel, die genau diesen Begriff aus der Bildungsforschung verwenden. Fragen Sie einen semantischen Assistenten: „Wie erkennen und interpretieren Lehrkräfte unerwartete Denkprozesse von Schülern im Augenblick?“, erhalten Sie zusätzlich Arbeiten, die unter „professional vision“, „formative assessment“ oder „in-the-moment decision making“ eingeordnet sind. Die zweite Menge ist jene, die Vokabularmismatch verborgen hätte.
Wann sollten Sie weiterhin Schlüsselwortsuche statt eines semantischen AI-Assistenten verwenden?
Sie sollten weiterhin Schlüsselwortsuche nutzen, wenn Sie die Recherche nach einem bekannten Element, die Zitationsverkettung von einem Ausgangsartikel, Volltextsuche nach Phrasen oder eine reproduzierbare Boolean-Strategie für einen systematischen Review benötigen. Semantisches Ranking ist das falsche Instrument, wenn die Aufgabe lautet: „Finde diesen Titel“, „Finde alles, was diese Studie zitiert“, oder „Dokumentiere eine Suchzeichenkette, die ein Gutachter erneut ausführen kann“.
Google Scholar ist für drei alltägliche Aufgaben der richtige erste Schritt. Erstens: Suche nach bekannten Elementen. Setzen Sie den Titel in Anführungszeichen, wie Googles eigene Hilfe und die meisten Bibliotheksleitfäden empfehlen. Zweitens: Kartierung von Autorität. Öffnen Sie einen wegweisenden Artikel und folgen Sie Cited by, um zu sehen, was das Feld danach getan hat, oder nutzen Sie Related articles, um von einem Ausgangsartikel aus weiterzufächern. Drittens: Suche nach Volltextphrasen. Wenn das Konzept ein unverwechselbarer Methodenname, ein Datensatz oder eine Skala ist, findet die lexikalische Volltextsuche Erwähnungen, die semantische Titel-Abstract-Indizes übersehen.
Für systematische oder sehr präzise Suchen sollten Sie sowohl Google Scholar als auch die meisten semantischen Apps als maßgebliches System überspringen. The Lens und OpenAlex unterstützen verschachtelte Boolean-Abfragen, Näherungsoperatoren, feldbasierte Suche und kontrolliertes Vokabular. OpenAlex ist ein offener Katalog mit 517 Millionen Werken, 5,8 Milliarden Graphbeziehungen und einem Public-Domain-Datensatz (CC0). Ein Bibliotheksbriefing von 2026 bezifferte seine Abdeckung auf etwa 474 Millionen Publikationen mit Fokus auf Open Access und Transparenz. Google Scholar kann diese Nachvollziehbarkeit nicht erreichen: Es begrenzt die Anzeige auf 1.000 Ergebnisse und bietet keinen Massenzugriff.
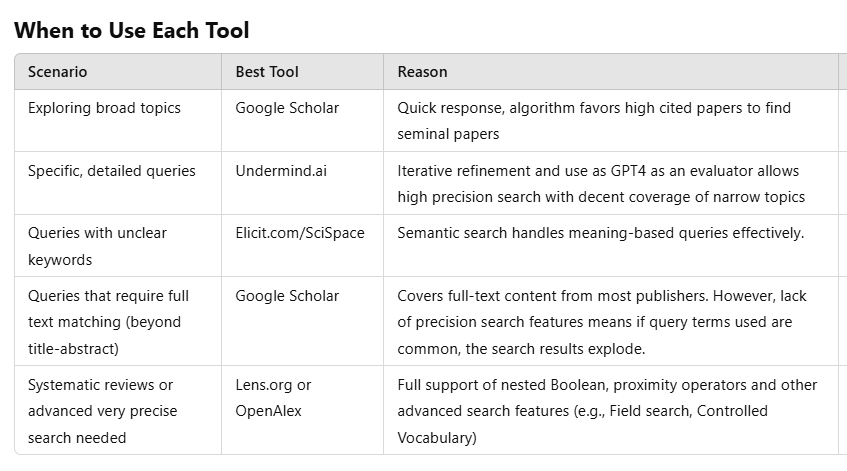
Verwenden Sie die obige Tabelle als Routing-Regel, nicht als Loyalitätstest. Breite Orientierung und die Suche nach grundlegenden Artikeln bleiben bei Google Scholar. Unklare Formulierungen gehen zu Elicit oder SciSpace. Eine hochspezifische Existenzfrage – „Gibt es RCTs, die ein LLM als Titel-Abstract-Screener einsetzen und Precision sowie Recall berichten?“ – ist ein Undermind-Briefing. Reproduzierbare, operatorintensive Suchen gehören in The Lens oder OpenAlex.
Wie führen Sie eine Literatursuche durch, die beide Ansätze kombiniert?
Sie führen eine kombinierte Suche durch, indem Sie mit einem Konzeptbriefing beginnen, semantisch Kandidaten mit vielfältigen Synonymen finden und die Menge anschließend mit lexikalischen Operatoren, Zitationsverkettung und einer Datenbank mit hoher Kontrolle absichern. Die Reihenfolge ist wichtig. Wenn Sie mit einer einzigen Formulierung in Google Scholar beginnen, übernehmen Sie die blinden Flecken dieser Formulierung. Wenn Sie eine semantisch gerankte Liste nie verlassen, übernehmen Sie die Qualitäts- und Reproduzierbarkeitsprobleme dieser Liste.
Eine praktische Abfolge sieht so aus:
- Formulieren Sie den Informationsbedarf so, wie ein Kollege ihn hören würde, einschließlich Populationen, Ergebnissen und Formulierungen, von denen Sie bereits wissen, dass sie instabil sind.
- Führen Sie dieses Briefing in einem semantischen Assistenten aus, um Kandidatenartikel und das tatsächlich verwendete Vokabular zu sammeln.
- Erstellen Sie aus diesen Titeln und Abstracts eine Synonymtabelle.
- Wiederholen Sie die erweiterten Begriffe in Google Scholar mit Anführungszeichen,
author:, Datumsbegrenzungen sowie Cited by / Related articles. - Für alles, was umfassend oder überprüfbar sein muss, bauen Sie die Strategie in The Lens oder OpenAlex mit verschachtelten Boolean-Abfragen und Feldbegrenzungen neu auf.
- Führen Sie ein fortlaufendes Einschlussprotokoll, damit nicht deterministische semantische Wiederholungen die Evidenzbasis nicht unbemerkt verändern.
In Jenovas Academic Research Assistant kann der erste Beitrag eher das Konzeptbriefing als eine Keyword-Zeichenkette sein:
„Ich benötige empirische Artikel darüber, wie ortsunabhängig arbeitende Wissensarbeiter sich von kognitiver Ermüdung erholen. Schließen Sie Studien ein, die statt des Wortes Ermüdung möglicherweise Burnout, Ego-Depletion, Erholungsbedarf, Grübeln nach der Arbeitszeit oder psychologische Distanzierung verwenden. Bevorzugen Sie arbeitspsychologische und HCI-Publikationsorte ab 2018 und nennen Sie das Synonym, das jeder Artikel tatsächlich verwendet.“
Eine Folgeanfrage wandelt die Synonymtabelle des Assistenten dann in eine lexikalische Strategie um, die Sie in Google Scholar oder The Lens einfügen können:
„Wandeln Sie die Synonymcluster in drei Google-Scholar-Abfragen und eine verschachtelte Boolean-Zeichenkette um, die für OpenAlex oder The Lens geeignet ist. Trennen Sie auf Titel beschränkte Anfragen von Volltextanfragen.“
Formulieren Sie die Frage in Elicit oder SciSpace in natürlicher Sprache statt als Keywords – Tay stellt fest, dass Anfragen in natürlicher Sprache in Google Scholar tendenziell schlechter und in diesen semantischen Tools besser funktionieren. Fügen Sie bei Undermind Einschränkungen hinzu, bis das Briefing nur noch zu einem spezifischen Studiendesign passen kann. Sobald die Kandidatenmenge existiert, ist Jenovas Deep Research Agent das bessere Instrument, um Quellen übergreifend zu lesen und eine zitierte Synthese zu erstellen, während der Academic Research Assistant besser dafür geeignet bleibt, innerhalb des wissenschaftlichen Workflows aus Entdeckung, Zitation und Manuskriptunterstützung zu bleiben.
Eine Warnung gilt für jeden AI-gestützten Schritt. Behandeln Sie Ranglisten und generierte Zusammenfassungen als Recherchehilfen, nicht als abgeschlossenes Screening. Semantische Top-10-Listen übersehen Artikel. LLM-Relevanzurteile stimmen oft, aber nicht immer mit denen von Menschen überein. Aussagen im Volltext benötigen weiterhin das PDF.
Was sagen Forschungsbibliothekare und Tool-Evaluatoren über semantische AI-Entdeckung?
Forschungsbibliothekare und unabhängige Evaluatoren behandeln semantische AI-Assistenten im Allgemeinen als Ergänzung zu Google Scholar, nicht als Ersatz. Sie bewerten Tools anhand der Suchqualität für einen definierten Anwendungsfall und nicht anhand von Marketingkategorien. Der nützlichste veröffentlichte Vergleich in diesem Bereich stammt aus praxisbasierter Bewertung, nicht aus Anbieter-Benchmarks.
„Wenn ich im Voraus nicht wüsste, wie mein Anwendungsfall aussehen würde, und nur ein akademisches Suchtool wählen dürfte, wäre die Wahl von Google Scholar völlig eindeutig. Das ist kein Argument gegen AI-Suche. Es ist ein Argument dagegen, so zu tun, als reiche eine einzige Ranking-Funktion aus. Scholar ist weiterhin der Generalist. Die neuen Tools verdienen ihren Platz, wenn die Anfrage semantisch unhandlich oder extrem spezifisch ist.“
„Der Fehler, den ich am häufigsten sehe, ist ein Mismatch zwischen Anfragetyp und Suchmaschine. Menschen geben ein breites Thema in einen iterativen Agenten ein und warten Minuten auf eine enger als benötigte Ergebnismenge. Oder sie geben einen Absatz in natürlicher Sprache in eine lexikalische Suchmaschine ein und schließen daraus, dass die Literatur nicht existiert. Vokabularmismatch ist meist ein Workflow-Fehler, bevor es eine Datenbanklücke ist.“
„Semantisches Ranking verändert auch die Bedeutung von ‚relevant‘. Wenn Sie Zitationen nicht gewichten, sehen Sie neuere und manchmal schwächere Artikel früher. Wenn Sie Zitationen gewichten, entdecken Sie immer wieder denselben Kanon. Forschende, die konzeptionell verwandte Arbeiten mit anderer Formulierung suchen, benötigen das erste Verhalten. Forschende, die die Artikel brauchen, deren Zitation andere von ihnen erwarten, benötigen das zweite. Ein kompetenter Prozess nutzt beides und dokumentiert den Grund dafür.“
— Jenova Product Team, Systeme zur Literaturentdeckung, 8 Jahre Erfahrung in der Gestaltung akademischer Forschungsworkflows
Diese Einordnung entspricht der öffentlichen Evidenz. Universitätsleitfäden erfassen inzwischen AI-Suchtools, die in Literaturreviews eingesetzt werden, und Produktbewertungen unterscheiden den langsameren iterativen Durchlauf von Undermind vom schnelleren semantischen Scan von SciSpace. Der Expertenkonsens ist methodisch, nicht tribal: Wählen Sie das Recherchemodell, das zu dem Mismatch passt, den Sie überwinden möchten.
Welches Tool eignet sich für systematische Reviews im Vergleich zur explorativen Literaturkartierung?
Systematische Reviews benötigen lexikalische Infrastruktur mit hoher Kontrolle; explorative Literaturkartierung benötigt semantischen Recall und schnelle Iteration; die meisten Abschlussarbeiten und Förderanträge benötigen einen hybriden Ansatz mit einem schriftlichen Protokoll für jede Phase. Werden diese Aufgaben vermischt, übersehen Teams entweder konzeptionell verwandte Studien oder erzeugen eine nicht replizierbare Evidenzmenge.
Für explorative Kartierung – „Was wurde unter welchem Namen auch immer über diese Idee geschrieben?“ – beginnen Sie semantisch. Elicit, SciSpace und ein konversationeller Rechercheassistent sind für diese Frage ausgelegt. Google Scholar kann beitragen, sobald Sie Ausgangsartikel haben, über Related articles und Cited by, und bleibt unübertroffen beim schnellen Auffinden von PDFs und Bibliothekslinks. Jenovas Academic Research Assistant passt in diese Phase, wenn die Karte zudem fortbestehen soll: gespeicherte Synonymentscheidungen, ausgeschlossene Richtungen und Zitationsformatierung für die spätere Ausarbeitung.
Für systematische oder Scoping-Reviews sollten Sie keine semantisch gerankte Liste zur offiziellen Suche machen. Nutzen Sie The Lens oder OpenAlex als reproduzierbares Rückgrat, dokumentieren Sie jeden Operator und behandeln Sie Elicit, Undermind oder Jenova als ergänzende Hilfen zur Zitationsentdeckung und zum Screening. OpenAlex bietet zusätzlich eine API, eine auf systematische Reviews ausgerichtete Abfragesprache und einen vollständigen Snapshot unter einer CC0-Lizenz, was das Gegenteil eines geschlossenen Relevanzrankings ist. Die Obergrenze von 1.000 Ergebnissen und der fehlende Massenzugriff von Google Scholar schließen es als primäre dokumentierte Suche aus, auch wenn es weiterhin nützlich ist, um zu prüfen, ob ein bekannter einzuschließender Artikel überhaupt indexiert wurde.
Für enge Existenzfragen – „Existiert ein Artikel wie dieser?“ – ist Undermind der Spezialist, vorausgesetzt, Sie können warten und die Evidenz aus Titel und Abstract reicht aus. Für die Manuskripterstellung nach Abschluss der Zusammenstellung ist Jenovas Kombination aus Literaturentdeckung und Zitationsmanagement relevanter als eine weitere reine Entdeckungsoberfläche, mit der Einschränkung, dass extraktionsintensive Meta-Analysen weiterhin in ein dediziertes Extraktionstool wie Elicit gehören.
Die Entscheidungsregel ist einfach genug, um sie wiederzuverwenden. Wenn die Formulierung variiert und Sie den Fachjargon des Feldes noch nicht kennen, verwenden Sie zuerst einen semantischen AI-Rechercheassistenten. Wenn Sie die Suchzeichenkette verteidigen müssen, verwenden Sie Keyword-Infrastruktur mit erweiterten Operatoren. Wenn Sie beides tun müssen – was die normale Bedingung ist, um konzeptionell verwandte Artikel mit unterschiedlicher Formulierung zu finden –, nutzen Sie semantischen Recall, um die Sprache zu entdecken, und anschließend lexikalische Kontrolle, um sie zu erfassen und zu dokumentieren.
Referenzen
- Aaron Tay – Google Scholar im Vergleich zu anderen AI-Suchtools (Undermind, Elicit, SciSpace)
- Google Scholar – Offizielle Suchhilfe
- Elicit – AI für wissenschaftliche Forschung
- OpenAlex – Offener Katalog des globalen Forschungssystems
- Paperguide – Vergleich von Preisen und Funktionen von Elicit und SciSpace (2026)
- Undermind – AI-Co-Forscher für Literatur
- University of Alberta / JCHLA – Produktbewertung von Undermind.ai
- Paperpile – So verwenden Sie Google Scholar
- TUHH – OpenAlex als offene Alternative für akademische Forschung
- Semantic Scholar – AI-gestütztes Recherchetool
- UBC Wiki – AI-Suchtools für Literaturreviews und umfassende Recherchen
- SciSpace – Vergleich von Elicit und SciSpace
- The Lens – Release 8.5 und OpenAlex-Integration
- PMC / NIH – Funktionen von OpenAlex und Potenzial für Evidenzsynthese