KI-Ebenenextraktor: Jedes Bild in Sekunden in bearbeitbare Ebenen trennen (April 2026)
2026-04-22
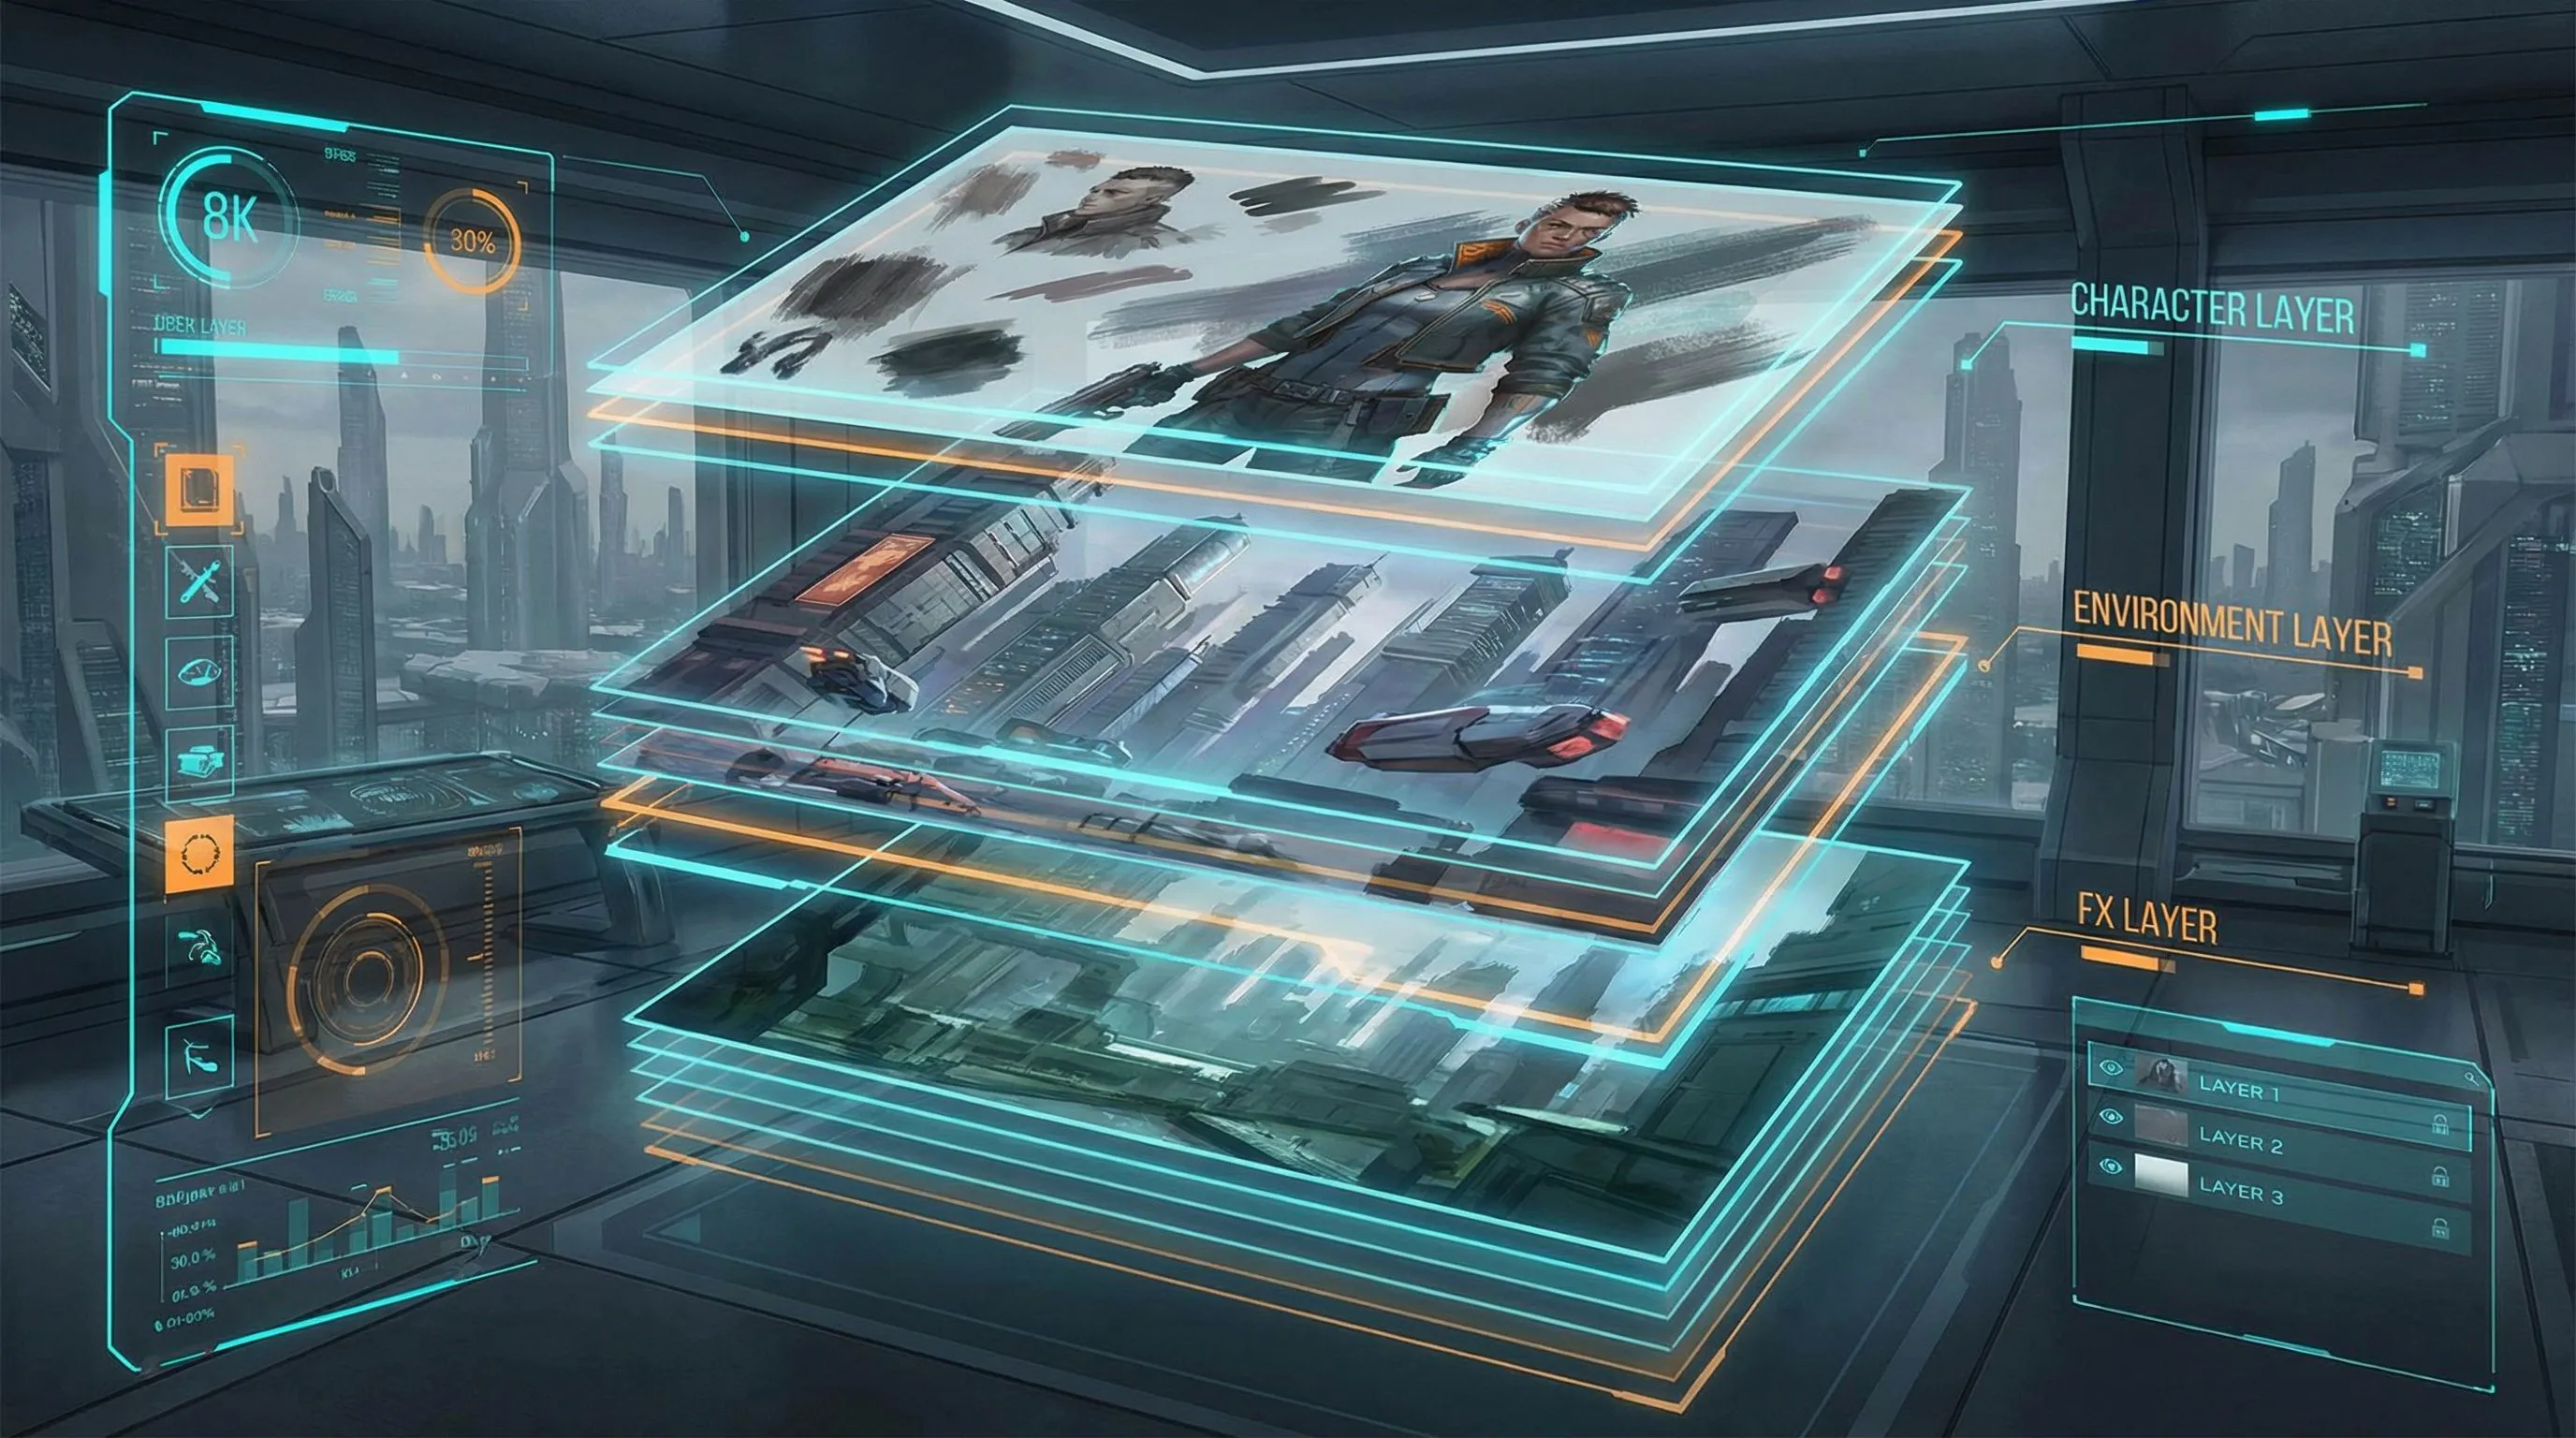
Der KI-Ebenenextraktor hat sich im Jahr 2026 von einer Forschungskuriosität zu einem produktionswichtigen Werkzeug entwickelt. Der Markt für KI-Bildbearbeitungsprogramme wurde 2025 auf 6 Milliarden US-Dollar geschätzt und soll von 2026 bis 2033 mit einer jährlichen Wachstumsrate (CAGR) von 11,51 % wachsen, während der Markt für KI-Fotobearbeitungsprogramme 2024 2,1 Milliarden US-Dollar erreichte und bis 2034 voraussichtlich auf 8,9 Milliarden US-Dollar anwachsen wird, was einer CAGR von 15,7 % entspricht. Die KI-Bildbearbeitung war die am schnellsten wachsende Softwarekategorie des Jahres 2024 mit einem Wachstum von 441 % im Vergleich zum Vorjahr – und die Ebenenextraktion ist die Fähigkeit, die die nächste Welle antreibt.
Das Konzept ist einfach, aber transformativ: Laden Sie ein flaches Bild hoch, und die KI zerlegt es in separate, bearbeitbare Ebenen – Hintergrund, Vordergrundmotive, Text, Objekte, Schatten – jede mit korrekter Transparenz. Was früher 30–60 Minuten mühsames manuelles Maskieren in Photoshop erforderte, geschieht jetzt in Sekunden.
- Semantische Ebenentrennung identifiziert und isoliert Motive, Hintergründe, Text und Objekte basierend auf ihrer Bedeutung – nicht nur auf Kanten
- Okklusionsrekonstruktion füllt die verborgenen Bereiche hinter Vordergrundelementen auf und erzeugt vollständige, nutzbare Hintergrundebenen
- Variable Ebenenkontrolle lässt Sie festlegen, wie viele Ebenen Sie möchten – von 2 (einfacher Vordergrund/Hintergrund) bis 8+ (feinkörnige Zerlegung)
- Jenovas Photo Editor bewältigt professionelle Ebenenextraktion, Hintergrundwechsel, Objektisolierung und Compositing durch Anweisungen in natürlicher Sprache
Schnelle Antwort: Was ist ein KI-Ebenenextraktor?
Ein KI-Ebenenextraktor ist ein Werkzeug, das künstliche Intelligenz verwendet, um ein flaches Bild in mehrere unabhängige, bearbeitbare Ebenen zu zerlegen – dabei werden Vordergrundmotive, Hintergründe, Text, Objekte und andere visuelle Elemente in transparente RGBA-Ausgaben getrennt, die einzeln bearbeitet, verschoben oder ersetzt werden können.
- 🎨 Mehrschichtige Zerlegung in 2–8+ unabhängige RGBA-Ebenen mit korrekter Transparenz – der Photo Editor übernimmt die Extraktion durch dialogorientierte Anweisungen
- 🧠 Semantisches Verständnis, das ein Produkt von seinem Schatten und von der Oberfläche, auf der es steht, unterscheidet – nicht nur Kantenerkennung
- 🔄 Hintergrundrekonstruktion, die Bereiche hinter Vordergrundobjekten auffüllt und so vollständige, für das Compositing bereite Ebenen erzeugt
- ✂️ Saubere Alphakanäle mit weichen Kanten und sanften Übergängen für professionelle Ausgabequalität
Das Problem: Warum die Extraktion von Bildebenen so mühsam war
Jeder Designer, Fotograf und Content Creator kennt die Frustration: Man hat ein fertiges Bild, muss aber ein Element ändern. Den Hintergrund austauschen. Ein Objekt entfernen. Den Text bearbeiten. Ein Produkt verschieben. In traditionellen Arbeitsabläufen ist ein gerendertes Bild das, was Canva-Mitbegründer Cameron Adams als "einen verschlossenen Tresor aus Pixeln" bezeichnet – und in diesen Tresor zu gelangen, erforderte bisher teure Software, fortgeschrittene Fähigkeiten und enorm viel Zeit.
Manuelles Maskieren ist der größte Engpass in kreativen Arbeitsabläufen
Wie die Analyse von WaveSpeedAI dokumentierte: „Was früher 30-60 Minuten mühsames manuelles Maskieren in traditioneller Software erforderte, kann jetzt in Sekunden mit intelligenter, semantisch bewusster Ebenentrennung erreicht werden.“
Präzise Masken für jedes Objekt in einem Bild zu erstellen, ist zeitaufwändig, fehleranfällig und erfordert viel Geschick. Haare, Fell, halbtransparente Objekte und komplexe Kanten machen die manuelle Trennung zu einem Albtraum. Wie der Ebenen-Splitter-Leitfaden von LlamaGen bestätigte: „Die Umwandlung eines flachen Bildes in Ebenen für Animation, Compositing oder Bearbeitung erfordert präzises Maskieren. Dies manuell Pixel für Pixel zu tun, ist langsam und frustrierend.“
Hintergrundentfernung ≠ Ebenenextraktion
Traditionelle Werkzeuge zur Hintergrundentfernung trennen lediglich den Vordergrund vom Hintergrund – eine binäre Aufteilung. Echte kreative Arbeitsabläufe erfordern jedoch eine mehrschichtige Zerlegung. Ein Produktfoto benötigt möglicherweise das Produkt, seinen Schatten, die Oberfläche und den Hintergrund als vier separate Ebenen. Eine Marketinggrafik benötigt möglicherweise den Überschriftentext, das Hauptbild, das Logo und das Hintergrundmuster als unabhängige Elemente. Wie der technische Leitfaden von DataCamp erklärte: „SAM und ähnliche Segmentierungsmodelle geben Masken aus: binäre Karten, welche Pixel zu welchem Objekt gehören. Nützlich, aber eine Maske sagt einem nur, wo etwas ist. Das Extrahieren des Objekts hinterlässt immer noch ein Loch im Originalbild.“
Das Problem der Werkzeugvielfalt
Laut Andreessen Horowitz's State of Generative Media 2026 verwenden Unternehmensproduktionen im Median 14 verschiedene Modelle für Bild-Workflows – und „die Erstellung eines einzigen polierten Assets ist selten ein einziger Inferenzaufruf.“
Designer jonglieren derzeit mit separaten Werkzeugen für Hintergrundentfernung, Objektisolierung, Bildbearbeitung, Compositing und Formatkonvertierung. Jedes Werkzeug hat eine andere Benutzeroberfläche, unterschiedliche Preise und eine andere Ausgabequalität. Wie der Statistikbericht von autophoto.ai bestätigte: „Teams, die 5-10 verschiedene KI-Tools verwalten, stellen fest, dass die bei der Bearbeitung gesparte Zeit durch das Erlernen von Benutzeroberflächen, das Verschieben von Dateien zwischen Plattformen und die Fehlerbehebung bei Inkonsistenzen aufgebraucht wird.“
Genau dafür wurde der Photo Editor entwickelt – eine einheitliche, dialogorientierte Benutzeroberfläche, die Ebenenextraktion, Hintergrundwechsel, Objektentfernung und Compositing ohne Werkzeugwechsel ermöglicht.
Warum der Photo Editor der beste KI-Ebenenextraktor ist
Im Gegensatz zu eigenständigen Ebenenextraktionswerkzeugen, die rohe RGBA-Dateien ausgeben, die Sie dann in separater Software zusammenfügen müssen, ist Jenovas Photo Editor ein kompletter Bildbearbeitungspartner. Sie beschreiben in einfacher Sprache, was Sie möchten – „trenne das Produkt vom Hintergrund“, „entferne die Person links“, „tausche den Himmel gegen einen Sonnenuntergang aus“ – und die KI übernimmt die Extraktion, Bearbeitung und das Compositing in einem einzigen Arbeitsablauf.
| Herausforderung | Eigenständige Ebenen-Tools | Photo Editor |
|---|---|---|
| Ebenenextraktion | Hochladen → rohe Ebenen herunterladen → in Photoshop zusammenfügen | Dialogorientiert: „trenne dies in Ebenen“ → fertig |
| Hintergrundwechsel | Extrahieren → neuen Hintergrund finden → manuell zusammensetzen | „Tausche den Hintergrund gegen eine Strandszene aus“ → fertig |
| Objektentfernung | Maskieren → extrahieren → Loch füllen → Kanten säubern | „Entferne die Kaffeetasse vom Tisch“ → fertig |
| Textbearbeitung | Keine Texterkennung | Versteht Text als bearbeitbare Elemente |
| Iterative Verfeinerung | Jedes Mal von vorne anfangen | Persistenter Speicher über Sitzungen hinweg |
| Modellflexibilität | An ein Modell gebunden | Wechsel zwischen GPT-5.4, Claude Opus 4.6, Gemini 3.1 Pro Preview |
Wie die KI-Ebenenextraktion tatsächlich funktioniert
Die Technologie hinter modernen KI-Ebenenextraktoren stellt einen fundamentalen Wandel gegenüber der traditionellen Bildsegmentierung dar. Wie der Praxisleitfaden von DataCamp erklärte, verwenden die neuesten Modelle eine generative diffusionsbasierte Architektur anstelle der traditionellen Kantenerkennung:
- Semantische Analyse – Die KI versteht konzeptionell, was im Bild ist: Sie kann ein Produkt von seinem Schatten und von der Oberfläche, auf der es steht, unterscheiden, nicht nur Kanten erkennen
- Tiefenordnung – Elemente werden nach Tiefe getrennt: Hintergrund (Ebene 0), Motive im Mittelgrund, Objekte im Vordergrund und Überlagerungen wie Text
- Okklusionsrekonstruktion – Wenn eine Person vor einem Gebäude steht, schneidet die KI nicht nur um die Person herum – sie füllt intelligent die zuvor verdeckten Hintergrundbereiche auf
- RGBA-Ausgabe – Jede Ebene enthält eine korrekte Alpha-Transparenz für nahtloses Compositing
Der Canva Magic Layers Benchmark
Im März 2026 startete Canva Magic Layers – eine Funktion, die Fast Company als „einen fundamentalen Wandel im Umgang mit digitalen Assets“ bezeichnete. Das Werkzeug verwendet Canvas proprietäres KI-Designmodell, um flache Bilder in bearbeitbare Komponenten zurückzuentwickeln. Wie Canva CPO Cameron Adams erklärte: „Das Modell identifiziert alles im Bild und wandelt es in native Canva-Objekte um.“ Text wird zu bearbeitbaren Textfeldern. Visuelle Objekte werden zu unabhängigen Elementen, die Sie verschieben, in der Größe ändern oder löschen können.
Dies bestätigt die Marktnachfrage – aber die Implementierung von Canva ist an das Canva-Ökosystem gebunden. Der Photo Editor bietet die gleiche Ebenenextraktionsfähigkeit über eine dialogorientierte Benutzeroberfläche, die mit jedem Ausgabeformat funktioniert und sich in jeden nachgelagerten Arbeitsablauf integrieren lässt.
Was Sie nach der Extraktion tun können
Sobald Ihr Bild in Ebenen zerlegt ist, vervielfachen sich die kreativen Möglichkeiten:
„Trenne dieses Produktfoto in Ebenen – ich möchte das Produkt, den Schatten und den Hintergrund als drei unabhängige Elemente. Tausche dann den Hintergrund gegen eine warme Holztextur aus und passe die Deckkraft des Schattens auf 60 % an.“
„Extrahiere die Person aus diesem Foto, entferne den Hintergrund und platziere sie auf einem Verlauf von Marineblau zu Schwarz. Behalte die ursprüngliche Beleuchtung des Motivs bei.“
„Nimm diesen Marketing-Banner und trenne den Überschriftentext, das Produktbild und das Hintergrundmuster. Ich muss die Überschrift ins Spanische übersetzen und die Hintergrundfarbe an unsere Q2-Kampagnenpalette anpassen.“
Testen Sie den Photo Editor kostenlos – keine Kreditkarte erforderlich.
Verwandte Agents, die Ihnen auch gefallen werden
🖌️ Graphic Designer – Ebenenbasierte Produktion von Design-Assets
Für Kreative, die extrahierte Ebenen zu fertigen Marketingmaterialien, Social-Media-Grafiken oder Marken-Assets zusammenfügen müssen. Der Graphic Designer versteht Komposition, Typografie und Markenkonsistenz – und verwandelt Ihre getrennten Ebenen in ausgefeilte, veröffentlichungsreife Designs.
- Social-Media-Vorlagen mit ebenenbasiertem Compositing
- Markenkonsistente Marketingmaterialien aus extrahierten Elementen
- Druckfertige Illustrationen und Infografiken
🏠 Real Estate Image Editor – Ebenenextraktion für Immobilienfotografie
Für Immobilienprofis, die Himmel austauschen, leere Räume einrichten oder Immobilienfotos verbessern müssen. Die Ebenenextraktion ist die Grundlage des virtuellen Stagings – die Trennung der Raumstruktur vom leeren Raum und das anschließende Compositing von Möbeln und Dekor in die Szene.
- Virtuelles Staging in über 8 Designstilen mit ebenenbewusstem Compositing
- Himmelsaustausch mit angepasster Beleuchtung und Reflexionen
- Entrümpelung und Renovierungsvisualisierung
🎨 Prompt Generator – Optimierte Prompts für die Bildgenerierung und -bearbeitung
Für Kreative, die neue Bilder mit spezifischen Ebenenstrukturen erstellen oder präzise Bearbeitungsanweisungen für jedes KI-Bildwerkzeug formulieren möchten. Der Prompt Generator erstellt strukturierte Prompts, die bessere Ergebnisse von jedem Bildgenerierungs- oder Bearbeitungsmodell liefern.
- Prompts, die für die ebenenbewusste Bildgenerierung optimiert sind
- Vorlagen für Bearbeitungsanweisungen für Hintergrundwechsel, Objektentfernung und Compositing
- Multi-Modell-Syntax, die auf die Stärken jedes KI-Tools zugeschnitten ist
So funktioniert es: Vom flachen Bild zu bearbeitbaren Ebenen
Schritt 1: Laden Sie Ihr Bild hoch
Öffnen Sie den Photo Editor und laden Sie das Bild hoch, das Sie zerlegen möchten. Die KI akzeptiert jedes Standard-Bildformat – JPG, PNG, WEBP – und arbeitet mit Fotos, Illustrationen, Marketinggrafiken, Produktaufnahmen und Design-Mockups.
Schritt 2: Beschreiben Sie, was Sie benötigen
Sagen Sie dem Photo Editor in einfacher Sprache, welche Art von Ebenenextraktion Sie wünschen. Sie müssen keine Fachbegriffe kennen – die KI versteht die Absicht.
„Trenne dieses Bild in Ebenen – ich möchte die beiden Personen im Vordergrund als eine Ebene, das Gebäude im Hintergrund als eine weitere und den Himmel als eine dritte.“
Schritt 3: Bearbeiten Sie einzelne Ebenen
Nach der Extraktion können Sie jede Ebene unabhängig voneinander ändern. Ändern Sie den Hintergrund, ohne das Motiv zu beeinflussen. Passen Sie die Beleuchtung eines Elements an. Entfernen Sie ein Objekt und lassen Sie die KI rekonstruieren, was dahinter war. Der Photo Editor erledigt all dies dialogorientiert.
„Ersetze jetzt die Himmelsebene durch einen dramatischen Sonnenuntergang. Behalte die ursprüngliche Beleuchtung des Gebäudes bei, aber füge warme Reflexionen auf den Fenstern hinzu.“
Schritt 4: Zusammensetzen und Exportieren
Setzen Sie Ihre bearbeiteten Ebenen zu einem fertigen Bild zusammen. Der Photo Editor fügt alles mit korrekter Transparenz, Schattenanpassung und Kantenüberblendung zusammen – und erzeugt eine Ausgabe, die natürlich komponiert aussieht, nicht wie ausgeschnitten und eingefügt.
Schritt 5: Iterieren Sie über Sitzungen hinweg
Kehren Sie Tage oder Wochen später zu Ihrem Projekt zurück. Der persistente Speicher des Photo Editors erinnert sich an Ihr Bild, Ihre Ebenen und Ihren Bearbeitungsverlauf. Machen Sie genau dort weiter, wo Sie aufgehört haben, ohne Ihr Projekt erneut hochladen oder erklären zu müssen.
„Geh zurück zu dem Produktfoto, an dem wir letzte Woche gearbeitet haben. Ich brauche die gleiche Ebenentrennung, aber diesmal tausche den Hintergrund gegen unser Feiertagskampagnen-Thema aus.“
Ergebnisse & Anwendungsfälle
📸 E-Commerce-Produktfotografie
Szenario: Ein Online-Händler benötigt dasselbe Produktfoto mit 12 verschiedenen Hintergründen für saisonale Kampagnen, Marktplatz-Listings und soziale Medien.
Traditioneller Ansatz: Das Produkt 12 Mal mit verschiedenen Hintergründen neu fotografieren (200–500 $ pro Setup) oder manuell in Photoshop maskieren und zusammensetzen (30–60 Minuten pro Variante).
Jenova-Lösung: Laden Sie das Produktfoto einmal in den Photo Editor. Extrahieren Sie das Produkt und seinen Schatten als separate Ebenen. Generieren Sie 12 Hintergrundvarianten in Minuten. KI reduziert die Kosten für Produktfotografie um 60–70 % und ermöglicht Markteinführungen 30-mal schneller als traditionelle Arbeitsabläufe.
🎬 Motion Graphics und Animation
Szenario: Ein Motion Designer muss eine 2,5D-Parallaxenanimation aus einer flachen Illustration erstellen – dafür werden Vordergrund, Mittelgrund und Hintergrund als separate Ebenen benötigt.
Traditioneller Ansatz: Jede Tiefenebene manuell in Photoshop maskieren (2–4 Stunden pro Illustration), dann für die Animation in After Effects importieren.
Jenova-Lösung: Laden Sie die Illustration in den Photo Editor und fordern Sie eine tiefenbasierte Ebenentrennung an. Erhalten Sie saubere RGBA-Ebenen in Sekunden. Wie LlamaGen bestätigte: „Die getrennten Ebenen sind perfekt für 2,5D-Animation, Parallaxeneffekte und Motion Graphics.“
💼 Lokalisierung von Marketingkampagnen
Szenario: Eine globale Marke muss einen Haupt-Marketing-Banner für 8 Märkte anpassen – verschiedene Sprachen, verschiedene Farbschemata, gleiches Kernbild.
Traditioneller Ansatz: Die ursprüngliche PSD-Datei von der Designagentur anfordern (falls sie noch existiert), Textebenen manuell bearbeiten, Farben anpassen, 8 Versionen exportieren. Zeitrahmen: 1–2 Wochen.
Jenova-Lösung: Laden Sie das flache Bannerbild in den Photo Editor. Extrahieren Sie Text, Produktbilder und Hintergrund als separate Ebenen. Übersetzen und ersetzen Sie den Text für jeden Markt. Passen Sie die Hintergrundfarben an die regionalen Markenrichtlinien an. Kombinieren Sie es mit dem Graphic Designer für fertige, plattformbereite Assets.
🏠 Virtuelles Staging für Immobilien
Szenario: Ein Immobilienmakler muss einen leeren Raum virtuell einrichten – Möbel, Dekor und Styling hinzufügen, ohne ein physisches Staging-Unternehmen zu beauftragen.
Traditioneller Ansatz: Einen virtuellen Staging-Dienst beauftragen (25–75 $ pro Bild), 24–48 Stunden auf die Lieferung warten, begrenzte Revisionsmöglichkeiten.
Jenova-Lösung: Laden Sie das Foto des leeren Raums in den Real Estate Image Editor. Die KI extrahiert die Raumstruktur – Wände, Böden, Fenster, architektonische Elemente – als Basisebene und fügt dann Möbel und Dekor mit angepasster Beleuchtung, genauen Schatten und korrekter Möbelgröße hinzu. Generieren Sie mehrere Designstile aus demselben Basisfoto.
📱 Social-Media-Inhalte in großem Maßstab
Szenario: Ein Content Creator muss 30 Variationen eines einzigen Hauptbildes für A/B-Tests auf Instagram, TikTok und YouTube-Thumbnails erstellen.
Traditioneller Ansatz: Jede Variation manuell in Canva oder Photoshop bearbeiten. Zeit pro Variation: 10–15 Minuten. Gesamt: 5–7,5 Stunden.
Jenova-Lösung: Extrahieren Sie die Kernelemente einmal mit dem Photo Editor – Motiv, Hintergrund, Textüberlagerung. Generieren Sie dann 30 Variationen, indem Sie Hintergründe austauschen, die Farbkorrektur anpassen und den Text ändern. Gesamtzeit: Minuten, nicht Stunden.
FAQ
Was ist ein KI-Ebenenextraktor?
Ein KI-Ebenenextraktor ist ein Werkzeug, das ein flaches Bild in mehrere unabhängige, bearbeitbare Ebenen zerlegt – dabei werden Vordergrundmotive, Hintergründe, Text, Objekte und andere visuelle Elemente in transparente RGBA-Ausgaben getrennt. Im Gegensatz zur traditionellen Hintergrundentfernung (die eine binäre Vordergrund/Hintergrund-Aufteilung erzeugt), produzieren Ebenenextraktoren vollständige Ebenen mit aufgefüllten Hintergründen, was bedeutet, dass Sie jede Ebene löschen oder verschieben können, ohne Löcher im Bild zu hinterlassen. Jenovas Photo Editor übernimmt die Ebenenextraktion durch Anweisungen in natürlicher Sprache.
Wie unterscheidet sich die KI-Ebenenextraktion von der Hintergrundentfernung?
Die Hintergrundentfernung erzeugt zwei Ausgaben: das Motiv und den Hintergrund. Die KI-Ebenenextraktion erzeugt mehrere Ausgaben – typischerweise 2 bis 8+ Ebenen – und trennt Motive, Objekte, Text, Schatten und Hintergrundelemente unabhängig voneinander. Entscheidend ist, dass moderne Ebenenextraktoren verdeckte Regionen hinter Vordergrundobjekten rekonstruieren und so vollständige, nutzbare Hintergrundebenen erzeugen, anstatt Löcher zu hinterlassen, wo Objekte entfernt wurden.
Welche Arten von Bildern eignen sich am besten für die KI-Ebenenextraktion?
Bilder mit klarer Trennung von Motiv und Hintergrund, guter Beleuchtung und mäßiger Szenenkomplexität liefern die besten Ergebnisse. Produktfotografie, Marketinggrafiken, Porträts und Landschaftskompositionen lassen sich sauber zerlegen. Wie Tests von DataCamp ergaben, „beherrscht die Technologie die Objektisolierung gut, hat aber Schwierigkeiten bei der Hintergrundrekonstruktion, wenn Schatten im Spiel sind.“ Stark verschlungene Motive (wie sich umarmende Menschen) können zu einer gewissen Vermischung zwischen den Ebenen führen.
Kann ich extrahierte Ebenen für kommerzielle Projekte verwenden?
Jenova erlaubt die kommerzielle Nutzung von generierten und bearbeiteten Inhalten in kostenpflichtigen Plänen. Der Photo Editor erzeugt Ausgaben, die für Marketingmaterialien, E-Commerce-Listings, Social-Media-Inhalte und die Druckproduktion geeignet sind. Stellen Sie immer sicher, dass Sie die Rechte am ursprünglichen Quellbild haben, bevor Sie es kommerziell einsetzen.
Wie ist dies im Vergleich zu Photoshop für die Ebenenextraktion?
Photoshop erfordert manuelles Maskieren – das pixelgenaue Auswählen von Objekten mit Werkzeugen wie dem Zeichenstift-Werkzeug, der Schnellauswahl oder Auswählen und Maskieren. Dieser Prozess dauert bei komplexen Szenen 30–60 Minuten pro Bild und erfordert erhebliche Fähigkeiten. Die KI-Ebenenextraktion automatisiert diesen Prozess in Sekunden. Wie Canva CPO Cameron Adams Fast Company sagte: „Die meisten KI-Ausgaben sind feste, wirklich flache Dinge, und sie sind nicht einfach zu bearbeiten. Man muss entweder mit einer 80%-Lösung leben oder Zeit mit erneutem Prompting verbringen.“ Die KI-Ebenenextraktion löst dies, indem sie jedes Bild bearbeitbar macht.
Ist der Photo Editor kostenlos?
Ja – Sie können den Photo Editor kostenlos und ohne Kreditkarte nutzen. Kostenlose Konten beinhalten alle Kernfunktionen mit begrenzter Nutzung. Kostenpflichtige Pläne ab 20 $/Monat erhöhen die Nutzungslimits für hochvolumige Bildbearbeitungs- und Ebenenextraktions-Workflows.
Fazit
Der KI-Ebenenextraktor stellt einen fundamentalen Wandel in unserer Interaktion mit Bildern dar. Jahrzehntelang war ein gerendertes Bild ein verschlossener Tresor – einmal zusammengesetzt, war eine Bearbeitung auf Ebenenebene ohne die ursprüngliche Projektdatei unmöglich. Im Jahr 2026 ist dieser Tresor offen. Der Markt für KI-Bildbearbeitungsprogramme wächst mit einer CAGR von 11,51 % bis 2033, die KI-Bildbearbeitung war die am schnellsten wachsende Softwarekategorie mit einem Wachstum von 441 % im Vergleich zum Vorjahr, und Unternehmensproduktionen verwenden jetzt im Median 14 verschiedene Modelle für Bild-Workflows.
Die Technologie hat sich von Forschungsarbeiten zu Produktionswerkzeugen entwickelt. Canva startete im März 2026 Magic Layers. Das Qwen-Team von Alibaba veröffentlichte Qwen-Image-Layered als Open-Source-Modell. Die Tsinghua-Universität veröffentlichte Controllable Layer Decomposition mit Bounding-Box-geführter Extraktion. Die Infrastruktur ist da – die Frage ist, wie Sie sie nutzen.
Probieren Sie jetzt den Photo Editor aus – laden Sie ein beliebiges Bild hoch und beschreiben Sie die gewünschte Ebenenextraktion in einfacher Sprache. Für die vollständige Erstellung von Marketing-Assets kombinieren Sie ihn mit dem Graphic Designer. Für Immobilienfotografie probieren Sie den Real Estate Image Editor. Durchsuchen Sie die vollständige Agent-Bibliothek bei Jenova.