AI-Agent-Backend: Eine API oder Eigenentwicklung (Juli 2026)
2026-07-24
Jedes Engineering-Team, das 2026 AI-Funktionen bereitstellt, steht an derselben Weggabelung: das Agent-Backend selbst entwickeln oder eines integrieren. Eigenentwicklung bedeutet, Modell-APIs, Orchestrierungs-Frameworks, Vektordatenbanken, Speicher-Systeme und Tool-Server zu einem Stack zu verbinden, der mehrere Quartale Entwicklungszeit beansprucht, bevor die erste Nutzerinteraktion stattfindet. Die Jenova Agent API ist die Alternative: ein vollständig verwaltetes Agent-Backend, bei dem Orchestrierung, Speicher, Storage, RAG und Tools über eine einzige Integration laufen.
- ✅ Ersetzen Sie den gesamten selbst entwickelten Agent-Stack — Modellrouting, Orchestrierung, Speicher, RAG und Tools — durch eine API
- ✅ Erstellen und starten Sie individuelle, produktionsreife Agenten, definiert durch Ihre Anweisungen, Modelle, Wissensbasen und Tools
- ✅ Greifen Sie mit einer einzigen Zugangsdatenkombination auf Modelle von OpenAI, Anthropic, Google, xAI, Qwen und weiteren Anbietern zu
- ✅ Nutzen Sie Infrastruktur, die mit über 30,000 Nutzern in mehr als 70 Ländern im Produktionseinsatz erprobt wurde
Um die Entscheidung zwischen Eigenentwicklung und Integration ehrlich zu treffen, brauchen Sie die echten Zahlen — was ein von Grund auf entwickeltes Agent-Backend 2026 tatsächlich für Entwicklung, Betrieb und Wartung kostet.
Kurzantwort: Was ist ein AI-Agent-Backend?
Ein AI-Agent-Backend ist die Infrastrukturebene, die einen Agenten in Produktion funktionsfähig macht: Orchestrierung über Modelle und Tools hinweg, persistenter Speicher und Kontext, Abruf privater Daten sowie die darunterliegenden Systeme für Rechenleistung, Skalierung und Zuverlässigkeit. Eine Eigenentwicklung bedeutet, fünf oder mehr getrennte Systeme selbst zu verantworten; eine verwaltete Agent API liefert sie alle über eine Integration.
Kernfunktionen eines verwalteten Agent-Backends:
- Agent-Orchestrierung zur Koordination von Modellen, Tools, Speicher und Abruf in mehrstufigen Workflows
- Anbieterübergreifendes Modellrouting — keine Anbieterbindung und keine Schlüsselverwaltung pro Anbieter
- Unbegrenzter Gesprächsspeicher und Kontext, integriert in jede Sitzung
- Vollständig verwalteter relationaler Speicher und Vektorspeicher mit integriertem RAG
- Tool-Integration über plattformnative Tools und jeden Remote-MCP-Server
Das Problem: Was Eigenentwicklung tatsächlich kostet
Der Marktdruck, Agenten bereitzustellen, ist enorm. Enterprise-Software wird voraussichtlich in 33 % der Anwendungen agentische AI enthalten — gegenüber weniger als 1 % im Jahr 2024 (Datagrid) — und 67 % der Führungskräfte auf C-Level erwarten bis 2027 unabhängig arbeitende AI-Agenten innerhalb ihrer Organisationen (VAST Data).
Doch das Backend für einen solchen Agenten aufzubauen, ist extrem teuer und langsam:
- Orchestrierungslogik, die zu einer zweiten Engineering-Disziplin wird
- Zustandslose Modell-APIs ohne Speicher zwischen Aufrufen
- RAG-Pipelines mit dokumentierten, wiederkehrenden Fehlermustern
- Tool-Integrationsaufwand für jede externe Fähigkeit
- Produktionsinfrastruktur, die skalieren, zuverlässig bleiben und Sicherheitsprüfungen bestehen muss
- Gesamtkosten im ersten Jahr, die jede Prototyp-Schätzung in den Schatten stellen
Das echte Budget: Modellaufrufe sind nur 2 % der Kosten
Die Demo eines „$100/Monat-Agenten“ verschleiert die tatsächliche Kostenstruktur. Eine detaillierte Engineering-Analyse beziffert die realistischen Kosten im ersten Jahr für einen kleinen bis mittelgroßen produktionsreifen Agenten auf **$270,000–$690,000** — wobei Modell-API-Aufrufe rund 2 % der Gesamtkosten ausmachen (Particle41).
Der Rest fließt dorthin, wo kein Demovideo hinschaut:
$30,000–$80,000 — allein für anfängliche Prompt-Entwicklung und Verfeinerung, bei 200–400 Engineering-Stunden zu $150–200/Stunde (Particle41)
$1,000–$5,000/Monat — Hosting einer Vektordatenbank, zuzüglich weiterer $1,000–$2,000/Monat für die Generierung von Embeddings (Particle41)
$30,000–$60,000 — Engineering für die Datenintegration, um den Agenten mit nur 4–5 bestehenden Systemen zu verbinden (Particle41)
$6,000–$10,000/Monat pro FTE — menschliche Kontrolle zur Prüfung von Fehlern, denn selbst ein zu 95 % präziser Agent erzeugt bei 10,000 monatlichen Interaktionen 500 Fälle, die manuell überprüft werden müssen (Particle41)
Und damit endet es nicht beim Launch: Im zweiten Jahr fallen weiterhin jährlich $150,000–$300,000 für Betrieb und Verfeinerung an (Particle41). Selbst engere Schätzungen, die nur die Entwicklung berücksichtigen, reichen von $20,000–$60,000 für einfache Aufgaben-Agenten (Biz4Group) bis zu $10,000–$400,000+ für Multi-Agent-Systeme (Azilen).
Orchestrierung wird zu einem eigenen Produkt
Ein produktionsreifer Agent antwortet nicht nur einmal — er plant, ruft Tools auf, beschafft Kontext, bewertet Zwischenergebnisse und erholt sich von Fehlern über mehrstufige Durchläufe hinweg. Diese Koordinationsschleife selbst aufzubauen bedeutet Statusautomaten, Wiederholungslogik, Timeout-Behandlung und Kostenleitplanken, die mit Ihrem eigentlichen Produkt nichts zu tun haben.
Fachleute beschreiben die Lücke unverblümt: Einen Agenten zu entwickeln dauert Tage — ihn produktionsreif zu machen, dauert sechs Monate. Ungesicherte Schleifen lassen API-Rechnungen in die Höhe schnellen, und verlorene Zustände zerstören lang laufende Aufgaben (
). Frameworks wie LangGraph und CrewAI bieten Abstraktionen für diese Ebene (Speakeasy), doch Abstraktionen betreiben sich nicht selbst: Sie müssen weiterhin alles darunter hosten, skalieren, absichern und warten.RAG-Pipelines sind eine dauerhafte Verpflichtung, kein Projekt
Einen Agenten in Ihren privaten Daten zu verankern bedeutet, Datenaufnahme, Segmentierung, Embedding, Indexierung, Reranking und Synthese selbst zu verantworten — und Fachleute warnen durchgängig, dass eine RAG-Pipeline „nicht nur schwieriger ist, als sie aussieht, sondern auch fortlaufende Expertise in LLMs, Retrieval und spezialisiertem MLOps erfordert“ (Vectara).
Eine dokumentierte Fallstudie: Ein „einfaches“ internes RAG-Projekt, das im Januar begann, hatte bis März einen Vollzeit-Entwickler mit dem Debugging von Halluzinationen beschäftigt, einen Vollzeit-Dateningenieur mit Problemen bei der Datenaufnahme und einen DevOps-Ingenieur mit der Infrastruktur — bei verdreifachtem Budget (Towards AI). Derselbe Bericht dokumentiert den typischen achtwöchigen Ablauf: Latenzprobleme, Sonderfälle, eine vollständige Neuentwicklung, neue Halluzinationsprobleme, eine Migration der Vektordatenbank und eine weitere Neuentwicklung.
Legacy-Infrastruktur wurde nicht für Agenten entwickelt
Agent-Workloads erfordern kontinuierlichen Datenzugriff in Echtzeit — und Legacy-Dateninfrastruktur, die für transaktionelle Workloads entwickelt wurde, „kann die kontinuierliche Schlussfolgerungsfindung und Ausführung von Aktionen nicht unterstützen, die autonome AI-Agenten benötigen“ (VAST Data). Infrastruktur für Agenten auf Enterprise-Niveau benötigt eine vereinheitlichte Datenbasis, Hochleistungsspeicher, Vektorisierung in Echtzeit, intelligente Orchestrierung und Zero-Trust-Governance — fünf getrennte Fähigkeitsebenen, bevor Sie überhaupt Produktlogik schreiben.
40 % — der agentischen AI-Projekte scheitern aufgrund unzureichender Infrastrukturgrundlagen (Landbase)
Genau dieses Problem wurde mit der Jenova Agent API beseitigt.
Die Lösung: Die Jenova Agent API
Die Jenova Agent API ist ein vollständig verwalteter Dienst für Agent-Infrastruktur: eine Integration, die den Eigenentwicklungs-Stack aus Modell-APIs, Orchestrierungs-Frameworks, Vektordatenbanken, Speicher-Systemen und Tool-Servern ersetzt. Sie definieren die Anweisungen Ihres Agenten, wählen ein Modell aus, laden eine Wissensbasis hoch und konfigurieren Tools — die API übernimmt Orchestrierung, Speicher, Storage und Skalierung, sodass Sie individuelle, produktionsreife Agenten in Tagen statt Quartalen bereitstellen.
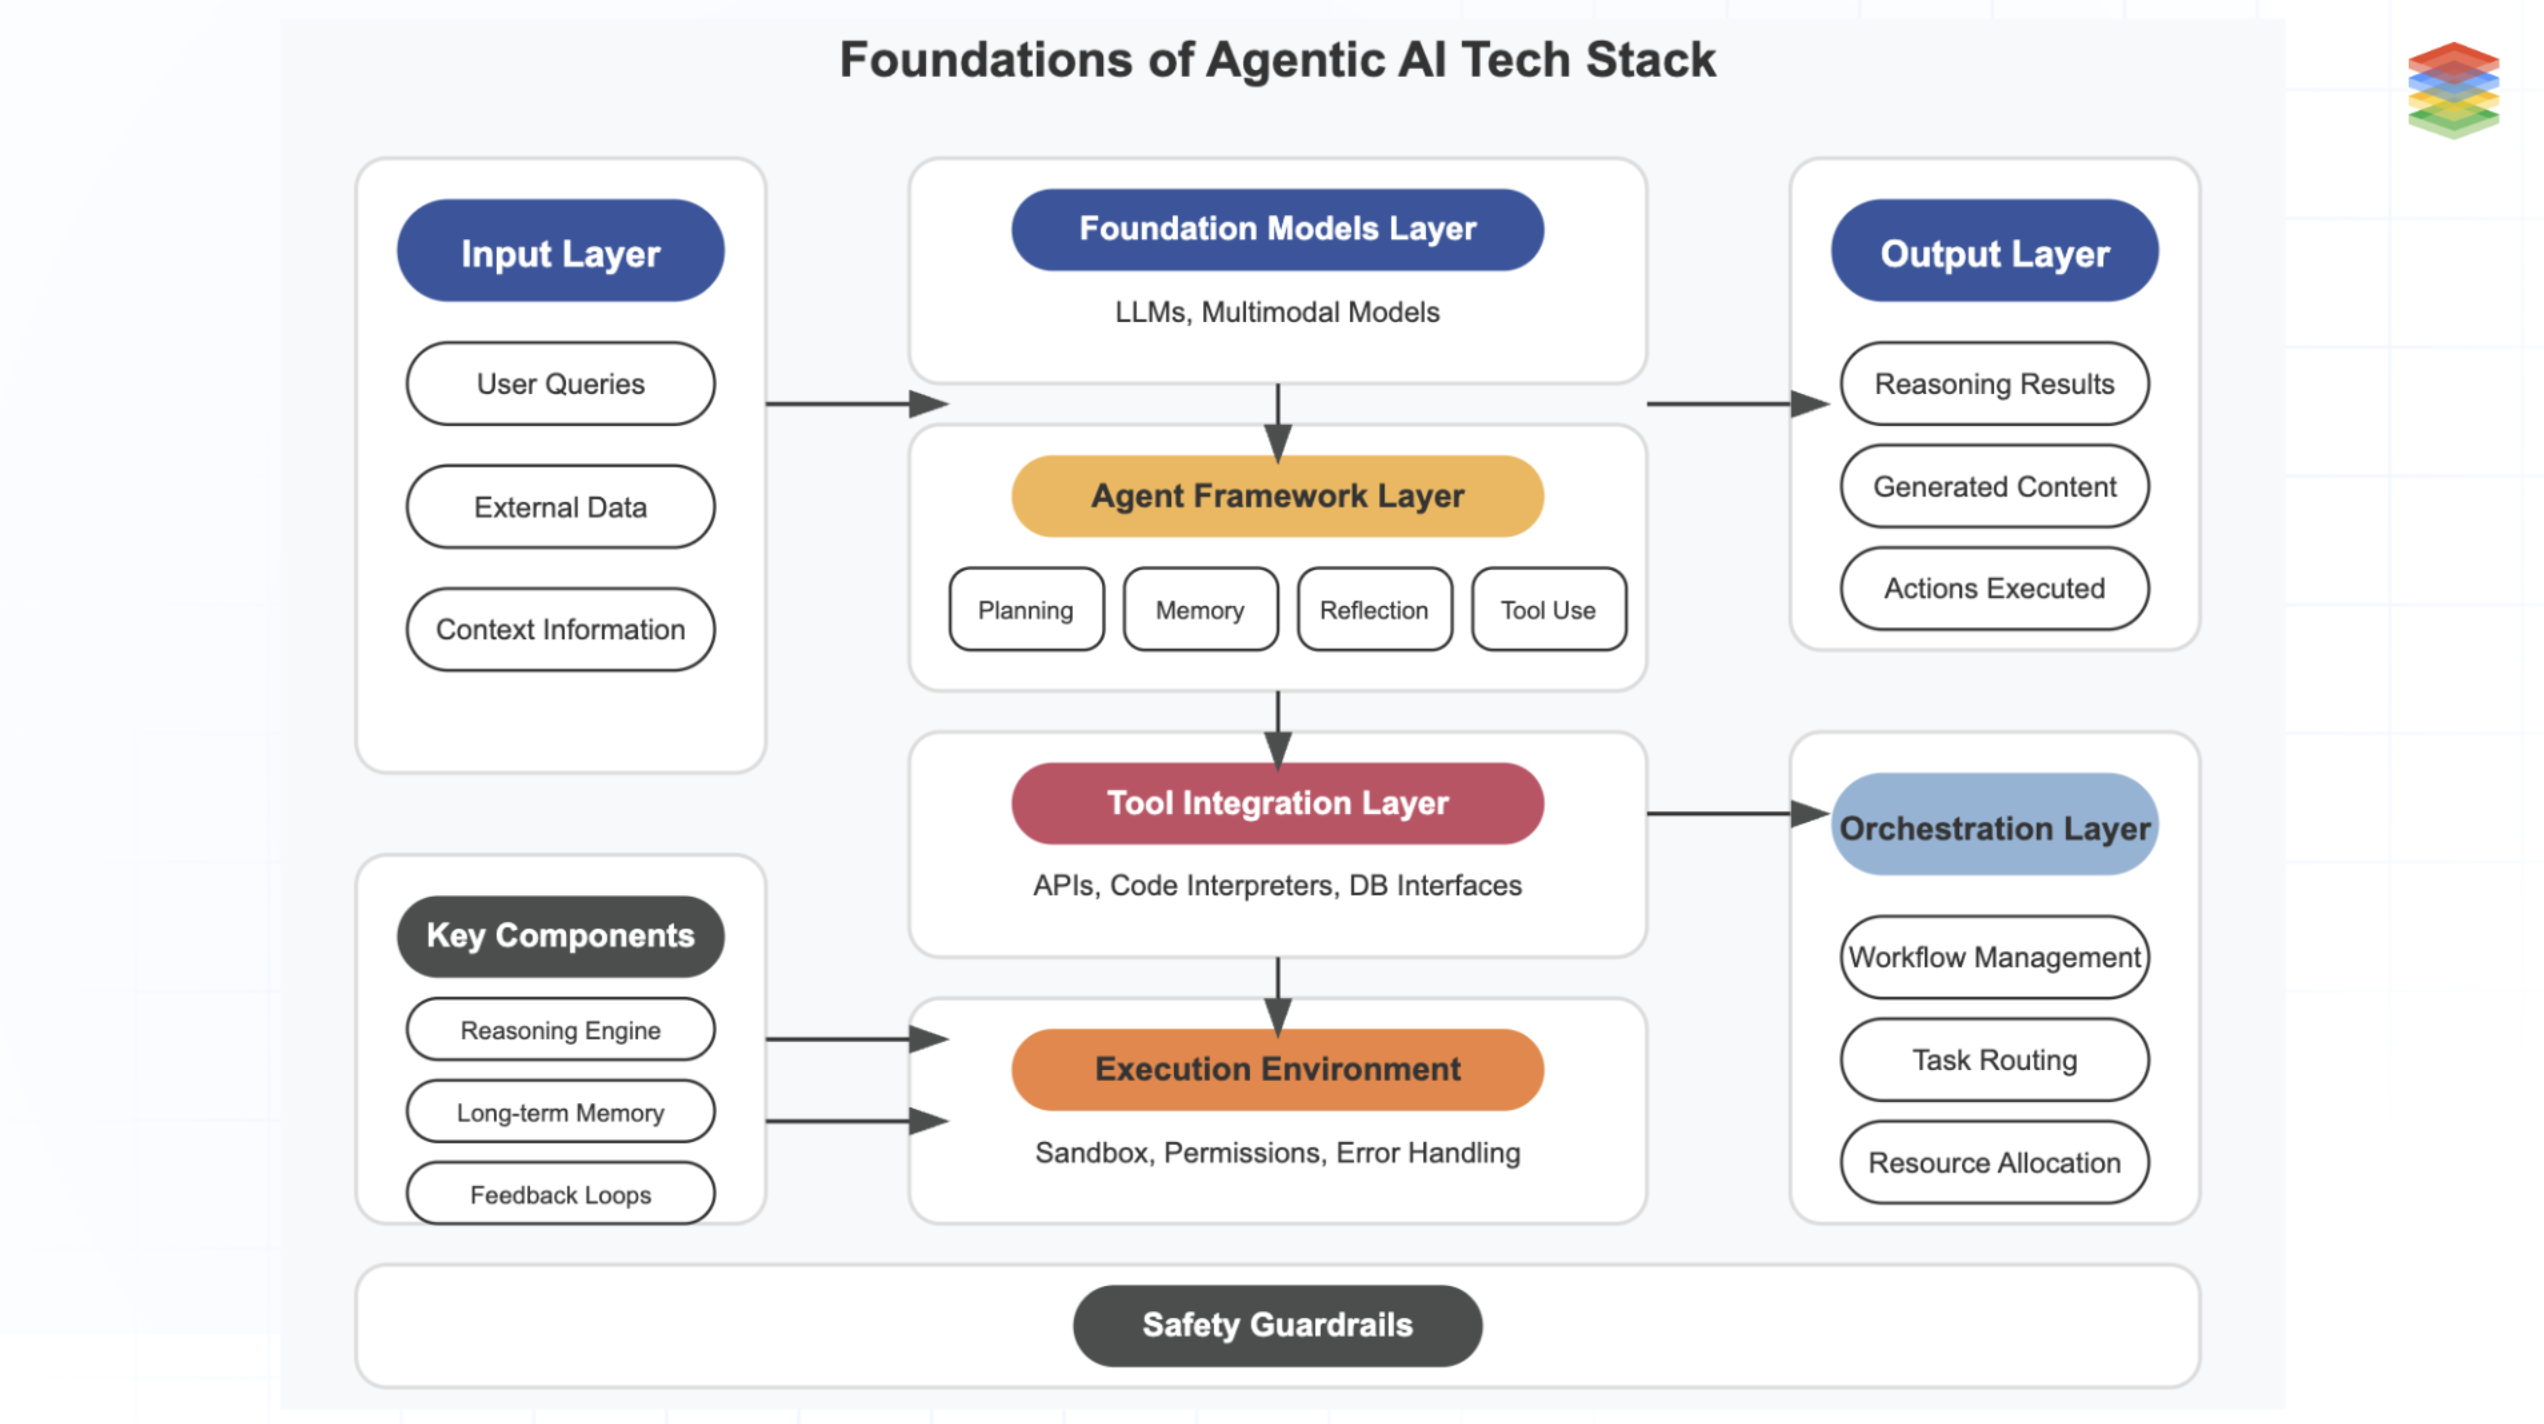
Jede Ebene im obigen Diagramm — Planung, Speicher, Reflexion und Tool-Nutzung des Agent-Frameworks; APIs und Datenbankschnittstellen der Tool-Integrationsebene; Sandboxing und Fehlerbehandlung der Ausführungsumgebung; Workflow-Management und Aufgabenrouting der Orchestrierungsebene — ist Infrastruktur, die Sie beim Weg der Eigenentwicklung selbst bauen müssen. Die Jenova Agent API betreibt all das.
| Selbst entwickeltes Agent-Backend | Jenova Agent API |
|---|---|
| Individuelle Orchestrierungsgraphen, Wiederholungslogik, Zustands-Schemas | Praxiserprobte Orchestrierung, die Modelle, Tools, Speicher und Abruf koordiniert |
| Separate SDKs, Schlüssel und Rate Limits pro Modellanbieter | Jedes führende Modell über eine einzige Integration — keine Anbieterbindung |
| Sitzungsstatus in Redis/Postgres plus individuelle Serialisierung | Unbegrenzter Speicher und Kontext, integriert in jede Sitzung |
| Bereitgestellte Vektordatenbank sowie Segmentierungs- und Embedding-Pipelines ($1,000–$5,000/Monat) | Vollständig verwalteter relationaler Speicher und Vektorspeicher mit integriertem RAG |
| Manuell geschriebene Tool-Wrapper, Authentifizierungsabläufe und Fehler-Standardcode | Plattformnative Tools sowie jeder Remote-MCP-Server, sofort einsatzbereit |
| Server, Container, Skalierungsrichtlinien und Uptime-Monitoring | Produktionsreife verwaltete Infrastruktur mit stabilen APIs |
Agent-Orchestrierung
Mehrstufige Schlussfolgerungsfindung, Tool-Aufrufe, Retrieval und Antwortsynthese laufen innerhalb der Plattform — keine Graphdefinitionen, Zustands-Schemas oder Workflow-DAGs, die Sie entwickeln und warten müssen. Sie definieren, was der Agent erreichen soll; die Infrastruktur entscheidet, wie, mit der begrenzten und kontrollierbaren Ausführung, die Produktionszuverlässigkeit erfordert.
Jedes Modell nutzen
Betreiben Sie Agenten mit Modellen von OpenAI, Anthropic, Google, xAI, Qwen und weiteren Anbietern über eine Zugangsdatenkombination. Nutzen Sie ein Spitzenmodell für komplexe Schlussfolgerungen und ein kosteneffizientes Modell für Sitzungen mit hohem Volumen — wechseln Sie pro Agent frei, ohne Schlüsselverwaltung pro Anbieter und ohne Migrationsaufwand, wenn neue Modellgenerationen erscheinen. Ihre Speicher- und Wissensebenen bleiben bei jedem Wechsel erhalten.
Speicher & Kontext
Unbegrenzter Gesprächsspeicher und Kontext sind in jede Sitzung integriert. Übergeben Sie eine konsistente Sitzungskennung, und Ihr Agent erinnert sich an den Verlauf, die Präferenzen und langfristigen Projekte jedes Nutzers — keine externen Zustands-Speicher, kein Serialisierungscode und kein Engineering für Kontextfenster. Die fehleranfälligste Ebene des Eigenentwicklungs-Stacks existiert für Sie schlicht nicht.
Vollständig verwalteter Storage
Verwaltete relationale Datenbanken und Vektordatenbanken mit integriertem RAG. Laden Sie Dokumente und Wissensbasen hoch; die Plattform übernimmt Segmentierung, Embedding, Indexierung und Abruf. Es gibt keine Vektordatenbank, die Sie bereitstellen, abstimmen oder skalieren müssen — der Kostenposten von $1,000–$5,000/Monat und der Entwickler, der ihn betreut, verschwinden.
Tools & MCP
Unbegrenzte Tool-Integrationen mit plattformnativen Tools und jedem Remote-MCP-Server, sofort einsatzbereit — Suche, E-Mail, Kalender, Dokumente und Ihre eigenen internen APIs. Kein Wrapper-Code, kein Aufwand für Authentifizierungsabläufe und kein Standardcode, den Sie pflegen müssen, wenn sich APIs von Drittanbietern ändern.
Produktionsreif
Vollständig verwaltete Infrastruktur mit stabilen APIs, ausgelegt für Produktionsverkehr — keine Server, Container oder Skalierungsrichtlinien auf Ihrer Seite. Die Plattform wurde mit über 30,000 Nutzern in mehr als 70 Ländern im Produktionseinsatz erprobt, sodass Ihre Agenten Zuverlässigkeit übernehmen, die Ihr Team nie selbst aufbauen muss.
Ein einzelner Aufruf führt den vollständigen Agenten aus:
bashcurl -X POST https://api.jenova.ai/v1/chat \
  -H "Authorization: Bearer YOUR_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "agent_id": "your-support-agent",
    "message": "Summarize this customer'\''s open issues and draft a reply.",
    "session_id": "user-4821-session"
  }'
Orchestrierung, Speicher, Retrieval und Tool-Aufrufe werden alle innerhalb dieser Anfrage ausgeführt. Ihre Anwendung stellt die Antwort dar; die Plattform verantwortet alles dahinter.
Was Sie entwickeln können
Die API ist für Entwickler konzipiert, die individuelle, zustandsbehaftete Agenten als Funktionen in ihren eigenen Produkten bereitstellen. Jedes der folgenden Beispiele ist eine Anwendung, die Sie entwickeln und starten können — definieren Sie die Anweisungen und Wissensbasis des Agenten, und die API übernimmt Orchestrierung, Speicher und Skalierung.
Ein Support-Agent, trainiert auf Ihr Produkt
Erstellen Sie einen Support-Agenten, der auf Ihrem Hilfe-Center, Änderungsprotokoll und Ihrer Ticket-Historie basiert. Der Sitzungsspeicher verfolgt die gesamte Support-Historie jedes Kunden über Interaktionen hinweg — kein „Können Sie Ihre Kontonummer noch einmal nennen?“ mehr.
- Dokumentenindexierung und Retrieval vollständig verwaltet
- Ticketing- und CRM-Systeme über MCP verbunden
- Bereitstellung in Tagen statt eines Quartals für Zustandsverwaltung
Ein eingebetteter Finanzanalyst
Starten Sie einen Portfolio-Berater in Ihrem Fintech-Dashboard, der die Bestände, Risikotoleranz und Ziele jedes Kunden über monatelange Gespräche hinweg kennt.
- Langfristiger Beratungskontext wird automatisch gepflegt
- Marktdaten- und Kontosysteme über MCP verbunden
- Modellwechsel je nach Komplexität der Anfrage zur Kostenoptimierung
Ein personalisierter Tutor für Ihre Lernplattform
Stellen Sie einen adaptiven Tutor bereit, der den Fortschritt, Schwachstellen und Präferenzen jedes Schülers über Sitzungen hinweg verfolgt und auf Ihrem Lehrplan basiert.
- Speicher pro Schüler ohne zu verwaltende Datenbankzeilen pro Nutzer
- Aktualisierungen des Lehrplans werden beim Upload bereitgestellt, ohne Neuentwicklung des Retrievals
- Skalierung auf Tausende gleichzeitige Lernende über verwaltete Infrastruktur
Ein Commerce-Assistent, der Ihren Katalog kennt
Integrieren Sie einen dialogorientierten Einkaufsassistenten, der Ihren Katalog kennt, die Präferenzen und Kaufhistorie jedes Käufers speichert und die Produktsuche über Dialog statt Filter steuert.
- Katalogwissen über verwaltetes RAG — Aktualisierungen werden sofort bereitgestellt
- Präferenzspeicher pro Käufer ohne externe Zustands-Speicher
- Produktionsreife Parallelverarbeitung für Spitzenlasten
Ein interner Ops-Agent für Ihr Team
Erstellen Sie einen Operations-Agenten, der mit Ihrer internen Dokumentation, Ihren Ticketing- und Datensystemen verbunden ist — er beantwortet Mitarbeiterfragen und führt Routine-Workflows mit vollständigem Organisationskontext aus.
- Private Wissensbasis wird automatisch indexiert
- Interne APIs über Remote-MCP-Server verbunden
- Neue Fähigkeiten werden als Konfiguration statt als Code bereitgestellt
Holen Sie sich Ihren API-Schlüssel und starten Sie Ihren ersten Agenten in wenigen Minuten.
So funktioniert es: Vom API-Schlüssel zum Produktions-Agenten in vier Schritten
Schritt 1: Ihren API-Schlüssel erhalten
Erstellen Sie ein Konto und generieren Sie Ihren API-Schlüssel im Plattform-Dashboard. Eine Zugangsdatenkombination deckt jeden Modellanbieter und jeden von Ihnen entwickelten Agenten ab — keine Schlüsselverwaltung pro Anbieter über Entwicklung, Staging und Produktion hinweg.
Schritt 2: Ihren Agenten erstellen oder auswählen
Definieren Sie einen individuellen Agenten mit eigenen Anweisungen, bevorzugtem Modell, Wissensbasis und Tool-Konfiguration — oder starten Sie mit einem vorkonfigurierten Agenten und passen Sie ihn an. Das Erstellen des Agenten ist Konfiguration, kein Code: Sie beschreiben das Verhalten, und die Plattform liefert die Orchestrierung, den Speicher und das Retrieval dahinter.
Schritt 3: Guthaben hinzufügen
Laden Sie Ihr Kontoguthaben auf. Die Nutzung wird bei jedem Aufruf von Ihrem Guthaben abgezogen — keine separaten Infrastrukturrechnungen, Rechnungen für Vektordatenbanken oder Kosten für Speicher-Systeme im Hintergrund.
Schritt 4: Den Aufruf ausführen
Leiten Sie aus Ihrem Backend die Nachricht des Nutzers zusammen mit Ihrer Agent-ID und einer Sitzungskennung weiter. Verwenden Sie dieselbe Sitzungs-ID erneut, und der Agent setzt exakt dort an, wo er bei diesem Nutzer aufgehört hat:
bashcurl -X POST https://api.jenova.ai/v1/chat \
  -H "Authorization: Bearer YOUR_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "agent_id": "your-commerce-assistant",
    "message": "Show me trail running shoes like the pair I bought last spring.",
    "session_id": "shopper-9317"
  }'
json{
  "response": "Based on your purchase last spring — the ridge-trail model in size 10 — here are three current options with similar cushioning and grip...",
  "session_id": "shopper-9317"
}
Kein Speicher-System zum Konfigurieren, keine Retrieval-Pipeline zum Warten, kein Orchestrierungsgraph zum Debuggen. Vollständige Endpunktspezifikationen, Anfrage- und Antwortschemata sowie Integrationsdetails finden Sie in der API-Dokumentation.
Ergebnisse & Anwendungsfälle
💼 SaaS-Startup: Ein Sprint statt $270K–$690K
Szenario: Ein B2B-SaaS-Unternehmen mit 3,000 Kunden möchte einen In-App-Support-Agenten, der seine Dokumentation kennt und die Historie jedes Kontos speichert — mit einem dreiköpfigen Engineering-Team.
Traditioneller Ansatz: Der Weg der Eigenentwicklung kostet im ersten Jahr $270,000–$690,000 (Particle41): Auswahl eines Orchestrierungs-Frameworks, Bereitstellung einer Vektordatenbank, mandantenbezogener Speicher in Redis oder Postgres, Tool-Wrapper für das Ticketing-System sowie Hosting, Skalierung und Monitoring — bevor die erste kundenorientierte Antwort erfolgt.
Jenova Agent API: Definieren Sie Support-Anweisungen und Eskalationsregeln, laden Sie das Hilfe-Center hoch und verbinden Sie Ticketing über MCP. Persistenter Sitzungsspeicher verschafft jedem Konto vom ersten Tag an eine durchgängige Support-Historie.
- ✅ Tage bis zur Produktion statt Monate
- ✅ Sechsstellige Infrastrukturkosten werden in Produktentwicklung umgeleitet
- ✅ Kein Speicher-System und keine Vektordatenbank zum Bereitstellen oder Warten
📊 Fintech: Eine Beratungsfunktion ohne Backend-Team
Szenario: Ein Fintech möchte einen AI-Portfolioanalysten als Premium-Funktion im Dashboard anbieten. Seine zwei Backend-Entwickler haben noch nie Agent-Infrastruktur aufgebaut.
Traditioneller Ansatz: Ein Orchestrierungs-Framework erlernen, zustandsbehaftete Beratungs-Workflows entwickeln, persistenten Speicher für fortlaufende Kundenbeziehungen implementieren, RAG für Finanzdokumente bereitstellen — genau die vier- bis sechsmonatige Produktionslücke, die Fachleute zwischen Prototyp und Launch beschreiben (
).Jenova Agent API: Konfigurieren Sie einen Finanzanalyst-Agenten mit Domänenanweisungen, verbinden Sie Marktdaten über MCP und lassen Sie den integrierten Speicher den Portfolio-Kontext über jedes Beratungsgespräch hinweg bewahren.
- ✅ Kein Framework zum Erlernen, Hosten oder Warten
- ✅ Langfristiger Kundenspeicher sofort verfügbar
- ✅ Modellwechsel zur Kostenoptimierung ohne Codeänderungen
📱 Mobile EdTech: Nachhilfe für 30,000 gleichzeitig aktive Schüler
Szenario: Eine mobile Bildungs-App mit 30,000 Schülern benötigt personalisierte Tutoren für vier Fächer, jeweils mit Lehrplanwissen und Fortschrittsverfolgung pro Schüler.
Traditioneller Ansatz: Agent-Konfigurationen pro Fach, persistenter Speicher pro Schüler in externen Datenbanken, Vektorspeicher für Lehrpläne — sowie Infrastruktur, die Zehntausende gleichzeitiger zustandsbehafteter Sitzungen ohne Kontextverlust trägt. Genau bei diesem Workload versagt Legacy-Infrastruktur (VAST Data).
Jenova Agent API: Erstellen Sie pro Fach einen Tutor-Agenten mit fachspezifischen Anweisungen und Materialien. Der Sitzungsspeicher bewahrt den Fortschritt jedes Schülers automatisch; RAG indexiert den Lehrplan beim Upload.
- ✅ Persistenter, personalisierter Lernkontext ohne externe Zustands-Speicher
- ✅ Lehrplan-Updates ohne Neuentwicklung des Retrievals
- ✅ Produktionsreife Parallelverarbeitung vom ersten Tag an
🎯 Produktagentur: Vier Kunden, eine Integration
Szenario: Eine Entwicklungsagentur entwickelt AI-Funktionen für vier Kunden — Erstaufnahme im Gesundheitswesen, Prüfung juristischer Dokumente, Commerce-Entdeckung und Enterprise-Suche. Der Eigenentwicklungsweg bedeutet, Speicher-Systeme, RAG-Pipelines und Hosting für jeden Kunden zu duplizieren.
Traditioneller Ansatz: Vier getrennte Agent-Stacks — vier Retrieval-Pipelines, vier Skalierungskonfigurationen, vier Wartungsverpflichtungen. Da 40 % der agentischen Projekte an unzureichenden Grundlagen scheitern (Landbase), ist es ein Risiko auf Portfolioebene, die risikoreichste Ebene viermal zu replizieren.
Jenova Agent API: Eine Integration und ein API-Schlüssel für alle vier Kunden. Individuelle Agenten pro Projekt — Domänenanweisungen, Modelle, Wissensbasen und Tools — laufen alle auf demselben verwalteten Backend.
- ✅ Eine einzige Integration skaliert über unbegrenzt viele Kundenprojekte
- ✅ Modellauswahl pro Kunde ohne anbieterspezifische Verwaltung pro Kunde
- ✅ Engineering-Zeit fließt in Produktlogik statt in die Replikation von Infrastruktur
FAQ
Wie viel kostet es, ein AI-Agent-Backend von Grund auf zu entwickeln?
Engineering-Analysen beziffern die realistischen Kosten im ersten Jahr für einen Produktions-Agenten auf $270,000–$690,000, wenn Infrastruktur, Prompt-Entwicklung, Tests, Datenintegration, Vektordatenbanken und menschliche Kontrolle einbezogen werden — Modell-API-Aufrufe machen dabei rund 2 % der Gesamtkosten aus (Particle41). Der laufende Betrieb kostet danach jährlich $150,000–$300,000.
Wie funktionieren Preise und Guthaben bei der Jenova Agent API?
Die Nutzung erfolgt über Guthaben: Sie fügen Ihrem Konto Guthaben hinzu, und jeder API-Aufruf wird von Ihrem Saldo abgezogen. Es gibt keine separaten Kosten für Infrastruktur, Datenbanken oder Speicher-Systeme — der verwaltete Stack ist in der Nutzung enthalten und bündelt, was sonst fünf oder sechs Anbieterrechnungen wären, in einer Lösung. Die aktuellen Preise finden Sie auf der Plattformseite.
Welche Modelle kann ich über die API nutzen?
Agenten können über eine einzige Integration mit Modellen von OpenAI, Anthropic, Google, xAI, Qwen und weiteren Anbietern betrieben werden. Sie wählen das Modell pro Agent aus und können frei wechseln — es gibt keine Anbieterbindung und keinen Migrationsaufwand, wenn neue Modellgenerationen erscheinen. Speicher und Wissen bleiben über Modellwechsel hinweg erhalten.
Wie schwierig ist die Integration im Vergleich zur Entwicklung mit LangChain oder reinen Modell-APIs?
Die Integration folgt einem Ablauf mit vier Schritten: API-Schlüssel erhalten, Agenten erstellen oder auswählen, Guthaben hinzufügen und den ersten Aufruf ausführen. Eine POST-Anfrage führt den vollständigen Agenten aus — inklusive Orchestrierung, Speicher, RAG und Tools. Reine Modell-APIs liefern nur Inferenz, und Frameworks wie LangChain liefern Abstraktionen, die Sie weiterhin selbst hosten, skalieren und warten; die Jenova Agent API ist das verwaltete Backend selbst. Vollständige Schemata finden Sie in der API-Dokumentation.
Kann ich individuelle Agenten mit eigenen Daten und Tools entwickeln?
Ja. Sie definieren eigene Anweisungen, laden eine private Wissensbasis hoch, die über verwaltetes RAG automatisch indexiert wird, wählen Ihr Modell aus und konfigurieren Tools — einschließlich jedes Remote-MCP-Servers, wodurch die meisten internen APIs abgedeckt sind. Der Agent verhält sich wie eine proprietäre Funktion Ihres Produkts, nicht wie ein allgemeiner Assistent.
Ist eine verwaltete Agent API für echten Produktionsverkehr geeignet?
Ja. Die Infrastruktur ist vollständig verwaltet und verfügt über stabile APIs für Produktionsverkehr — Sie benötigen weder Server noch Skalierungsrichtlinien. Die Plattform wurde mit über 30,000 Nutzern in mehr als 70 Ländern im Produktionseinsatz erprobt, und die Nutzung skaliert mit Ihrem Guthaben statt mit Infrastruktur, die Sie selbst bereitstellen.
Fazit
Der Weg der Eigenentwicklung für ein AI-Agent-Backend ist 2026 gut dokumentiert: $270,000–$690,000 Kosten im ersten Jahr, Monate für Orchestrierungs- und RAG-Engineering, eine Vektordatenbank und Speicherebene, die dauerhaft gewartet werden müssen, sowie eine Produktionslücke, durch die 40 % der Projekte scheitern, bevor sie starten. Der Modellaufruf war nie der schwierige Teil — alles darum herum ist es.
Die Jenova Agent API ersetzt diesen gesamten Stack durch eine Integration: individuelle Agenten, definiert durch Ihre Anweisungen, Modelle, Wissensbasen und Tools, betrieben auf vollständig verwalteter, produktionsreifer Infrastruktur mit integrierter Orchestrierung, Speicher, Storage und MCP-Tools. Definieren Sie Ihren Agenten, führen Sie den Aufruf aus und liefern Sie in Tagen aus, was der Eigenentwicklungsweg in Quartalen plant. Starten Sie mit der API-Dokumentation, holen Sie sich Ihren API-Schlüssel auf der Jenova Agent API Plattform und entdecken Sie die umfassendere Plattform auf Jenova.